


零基础怎么学Python?先掌握这5个核心语法不迷路
面向零基础自学者的Python学习路径指南。精选变量与数据类型、条件判断、循环控制、函数定义与容器操作5大核心语法,配合原理图解与实用示例,帮助初学者避开死记硬背误区,快速掌握编程基本逻辑。
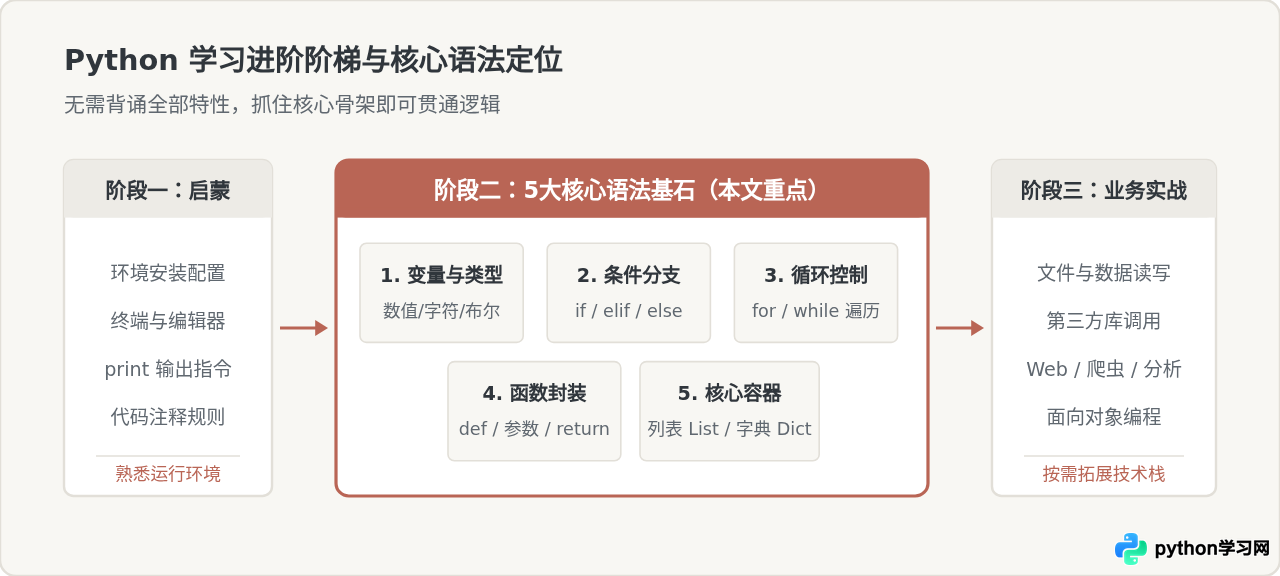
很多零基础初学者学 Python 时,往往一头扎进厚厚的参考书或官方参考手册中,试图按顺序把几百个内置函数、模块和高级特性挨个背下来。这种学习方式不仅极其枯燥,而且极易陷入“看书都懂、合上书写不出三行代码”的困境。实际上,计算机程序的本质就是对数据的组织与流转处理。在实际开发中,80% 以上的代码逻辑都由 5 个最基础的语法结构构建而成。零基础学 Python,先牢牢掌握这 5 个核心语法,便能搭建起清晰的编程认知骨架,彻底告别盲目迷路。
一、变量与基础数据类型:数据的存储与命名标签
编写程序首先要解决的是“如何保存数据”。在 Python 中,变量就是给计算机内存中的数据贴上一个标签。与其他部分严格语言不同,Python 是一门动态类型语言,定义变量时无需显式声明类型,直接使用赋值符号 = 即可。
初学者必须熟练掌握以下 4 种最常用的基本数据类型:
- 整数(int):表示没有小数部分的数字,例如
count = 10、age = -5。 - 浮点数(float):包含小数点的数字,例如
price = 19.9、pi = 3.14159。 - 字符串(str):用单引号
'...'或双引号"..."包裹的文本字符,例如username = "Alice"。 - 布尔值(bool):仅有两个可能值:
True(真)与False(假),通常用于条件状态的标记。
完整示例代码
# 变量赋值与基础类型定义
product_name = "无线机械键盘"  # str 字符串类型
original_price = 299.0          # float 浮点数类型
quantity = 2                   # int 整数类型
is_in_stock = True              # bool 布尔值

# 基础运算与动态计算
total_price = original_price * quantity

# 使用推荐的 f-string 进行字符串格式化拼接
info_message = f"商品: {product_name} | 总价: {total_price}元 | 库存状态: {is_in_stock}"
print(info_message)常见易错提醒:不同类型之间不能随意隐式相加。例如将字符串 "100" 与数字 50 直接相加,Python 会抛出 TypeError: can only concatenate str to str。若要计算,需使用 int("100") 或 float("100") 显式转换类型。
二、条件分支结构:让代码拥有决策判断能力
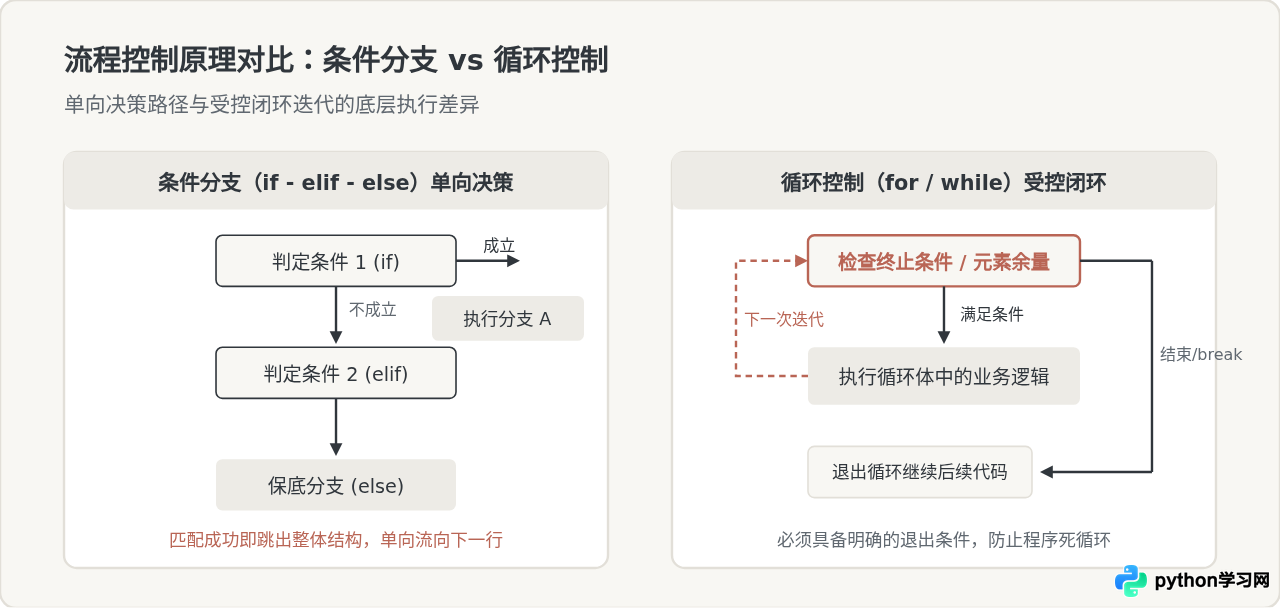
真实世界中的业务逻辑充满各种条件分支,例如“用户输入密码是否正确”、“购物车金额是否达到免邮门槛”。Python 使用 if、elif 和 else 关键字构建决策分支。
掌握条件分支时,有两点至关重要:
- 缩进代表代码块:Python 依靠缩进(标准规范为 4 个空格)来确定哪一段代码属于该分支。每个判断条件结尾必须带上英文冒号
:。 - 逻辑运算符组合:使用
and(与)、or(或)、not(非)将多个比较条件组合在一起。
完整示例代码
# 模拟用户权限与积分折扣判定
user_role = "vip"
order_amount = 120

if user_role == "admin":
    discount = 0.60
    print("管理员专属通道:享受4折优惠")
elif user_role == "vip" and order_amount >= 100:
    discount = 0.85
    print("VIP满额特权:享受85折优惠")
else:
    discount = 1.00
    print("普通结算:无折扣")

final_pay = order_amount * discount
print(f"最终应付金额: {final_pay:.2f}元")
三、循环控制:批量与重复任务的高效发动机
编程的核心优势之一就是能够以极高的速度处理重复任务。Python 提供了两类循环:
for循环:用于遍历预先已知长度的序列(如序列、列表、字符串)或通过range()生成的数字区间。while循环:在指定条件保持为True时持续运行,适合终止时机无法预知的场景(例如等待用户输入特定退出指令)。
在循环内部,有两个控制流程走向的重要关键字:
break:立即终止并彻底跳出当前循环体。continue:立即跳过本次循环剩余代码,直接进入下一次迭代判断。
完整示例代码
# 场景1:使用 for 循环与 range 统计 1 到 10 内偶数的和
even_sum = 0
for num in range(1, 11):
    if num % 2 != 0:
        continue  # 遇到奇数跳过当前轮次
    even_sum += num

print(f"1到10之间所有偶数的和为: {even_sum}")  # 示例输出:30

# 场景2:使用 while 循环模拟受限重试机制
retry_count = 0
max_retries = 3

while retry_count < max_retries:
    retry_count += 1
    print(f"正在尝试连接服务器... 第 {retry_count} 次")
    if retry_count == 2:
        print("连接成功,提前退出循环。")
        break
四、函数定义:模块化封装与代码复用
当一段相同的计算逻辑在程序中需要执行多次时,若不断复制粘贴,代码会迅速变得臃肿且极难维护。函数的作用就是将具有特定功能的代码块打包封装,并赋予其一个名称。
定义函数使用 def 关键字,核心要素包括:
- 函数名:反映该功能具体动作的动词或短语,如
calculate_tax、send_email。 - 参数(形参):函数运行所需的外部输入数据。支持设置默认值。
- 返回值(return):函数处理完毕后向调用方交付的结果。若省略 return,函数默认返回
None。
完整示例代码
# 定义一个计算含税价格的函数,vat_rate 赋予默认参数 0.13
def calculate_total_price(base_price, quantity, vat_rate=0.13):
    """计算商品含税总价并返回"""
    if base_price < 0 or quantity <= 0:
        return 0.0  # 异常输入防御性保护

    subtotal = base_price * quantity
    total = subtotal * (1 + vat_rate)
    return round(total, 2)

# 调用函数
order_1 = calculate_total_price(100.0, 3)           # 使用默认 13% 税率
order_2 = calculate_total_price(100.0, 3, 0.06)     # 自定义 6% 税率

print(f"订单1金额: {order_1} | 订单2金额: {order_2}")
五、核心容器(列表与字典):多维数据的组织基石
单一的变量只能存储单独一个数值或文本。在实际业务中,我们往往需要处理一组数据(例如全班同学的名单、一个用户的全部档案资料)。Python 内置的 列表(List) 与 字典(Dictionary) 是使用频率最高的两大数据结构。
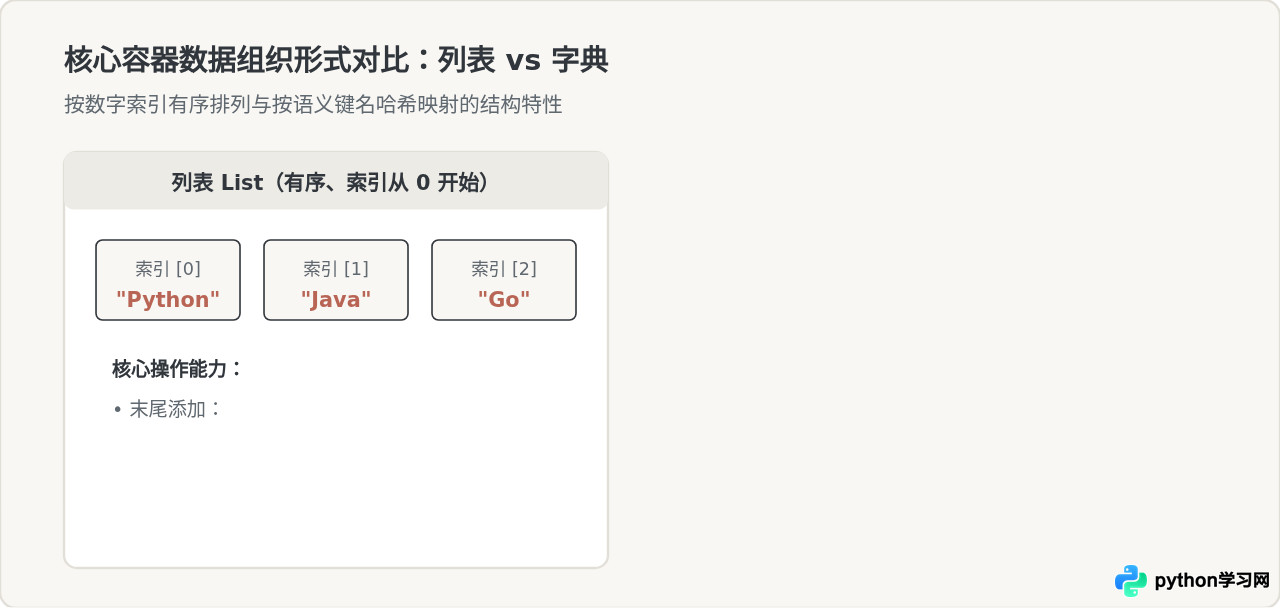
列表与字典关键特性差异表
| 特性维度 | 列表(List) | 字典(Dictionary) |
|---|---|---|
| 表示形式 | 中括号包裹,如 ["apple", "banana"] |
大括号键值对,如 {"item": "apple", "price": 5} |
| 元素获取方式 | 依赖整数序号索引,如 list[0] |
依赖具有业务语义的键名,如 dict["item"] |
| 元素唯一性 | 允许存放完全相同的重复值 | 键名(Key)必须唯一,后赋值的会覆盖前值 |
| 适用场景 | 顺序排列的数据列表、流水作业条目 | 表达一个具体实体的各项属性(用户画像、配置参数) |
完整示例代码
# 组合使用:使用列表存储多个字典对象(最常见的业务数据结构)
students = [
    {"name": "张伟", "score": 88},
    {"name": "李娜", "score": 95},
    {"name": "王芳", "score": 58}
]

# 新增一条记录
students.append({"name": "赵强", "score": 72})

# 访问第二名学生的姓名与分数
target_student = students[1]
print(f"姓名: {target_student['name']}, 成绩: {target_student['score']}")
六、综合实战:将5大核心语法串联成完整程序
单独看每个语法规则往往十分简单,而真正的编程能力建立在“如何将它们组装成自动化处理流水线”之上。下面的综合示例演示了如何在一个成绩统计脚本中,将变量、条件判断、循环、函数与容器无缝串联在一起:
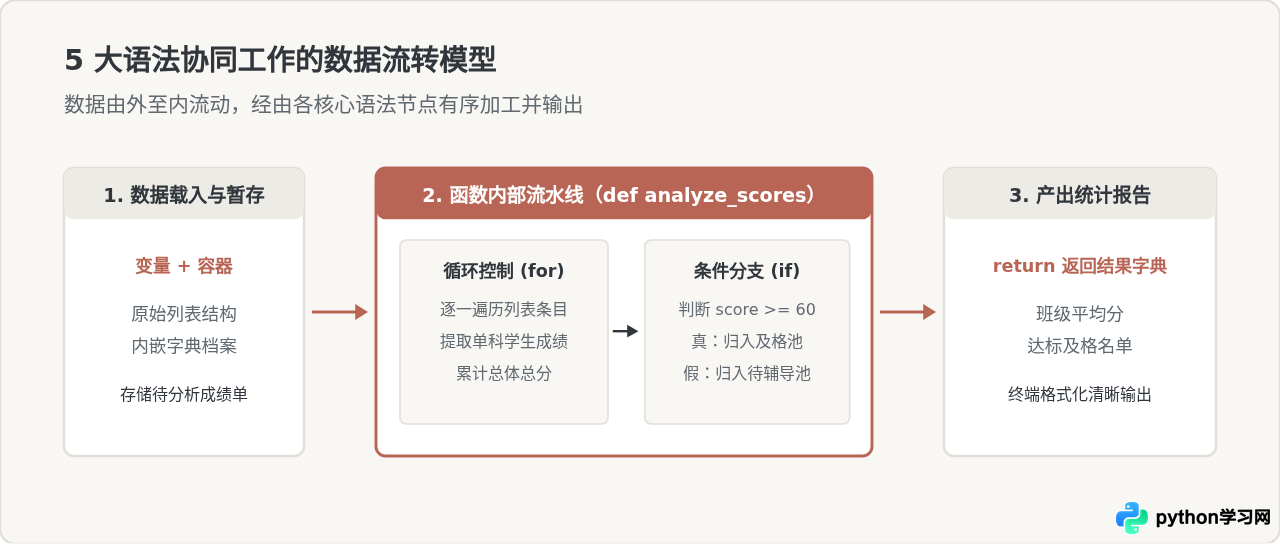
完整实战代码
# 1. 容器与变量:定义待处理的原始数据
exam_records = [
    {"name": "小明", "score": 85},
    {"name": "小红", "score": 52},
    {"name": "小强", "score": 90},
    {"name": "小华", "score": 59}
]

# 2. 函数定义:将统计计算封装起来
def analyze_exam_data(records, pass_line=60):
    total_score = 0
    passed_names = []
    failed_names = []

    # 3. 循环控制:遍历每名学生的成绩数据
    for student in records:
        score = student["score"]
        name = student["name"]
        total_score += score

        # 4. 条件分支:判定是否及格并归档
        if score >= pass_line:
            passed_names.append(name)
        else:
            failed_names.append(name)

    average = total_score / len(records)

    # 返回结构化的分析字典
    return {
        "average": round(average, 1),
        "passed_count": len(passed_names),
        "failed_names": failed_names
    }

# 5. 执行程序并输出展示
report = analyze_exam_data(exam_records, pass_line=60)

print("====== 成绩统计报告 ======")
print(f"班级平均得分: {report['average']}")
print(f"合格达标人数: {report['passed_count']} 人")
print(f"需要辅导名单: {', '.join(report['failed_names'])}")
示例输出结果
====== 成绩统计报告 ======
班级平均得分: 71.5
合格达标人数: 2 人
需要辅导名单: 小红, 小华
七、零基础避坑与高效自学建议
掌握了上述 5 个语法后,初学者的首要目标不是立即学习复杂的面向对象(Class)或深奥的设计模式,而是通过写具体的小脚本固化肌肉记忆:
- 看懂报错的最后一行:Python 的错误提示非常友好。遇到报错时,直接看输出的最后一行信息。例如
NameError: name 'x' is not defined表示变量在使用前忘记定义;IndentationError说明第某行缩进未对齐。学会根据最后一行的错误名称去搜解决方法,能节省大量无效排查时间。 - 小需求驱动,拒绝干看代码:不要对着视频或教程被动浏览。尝试给自己出小题目,比如“计算自己的 BMI 指数”、“批量重命名文件夹中的图片”、“统计一篇英文文章里出现次数最多的单词”。在解决真实小需求的过程中调用这 5 个语法,记忆效果最好。
- 善用终端
print()调试状态:当程序运行结果不符合预期时,不用慌张。在怀疑出错的代码上下方加入print("当前变量值:", 变量名),打印出数据的真实流转情况,逻辑漏洞往往一目了然。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















