


Python排序报错TypeError怎么办?混合类型与None值处理
针对Python在调用sort()或sorted()时因列表包含None值或混合类型触发TypeError报错的问题,本文提供根因解析、元组Key短路机制、统一转换与复杂字典排序的完整解决方案与代码示例。
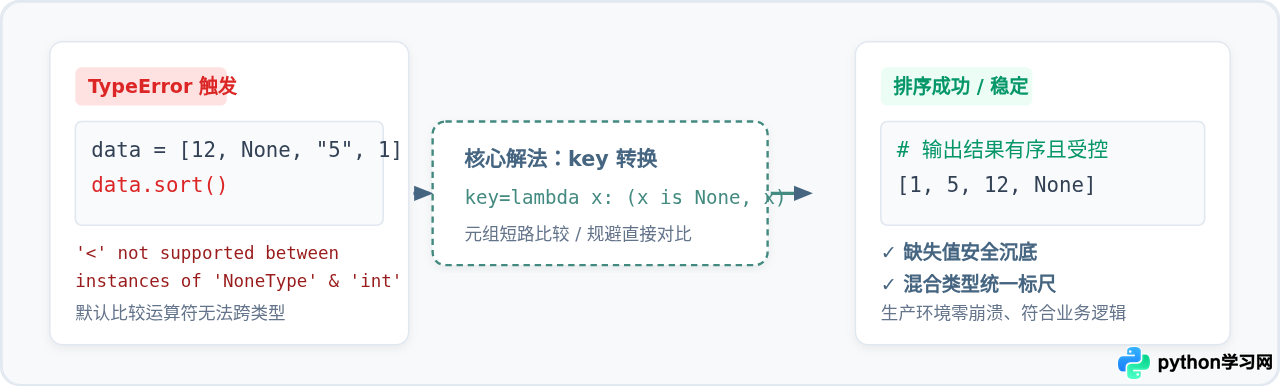
sort() 或 sorted() 时,一旦序列中包含 None 或混合了不同类型(例如整数与字符串),解释器就会抛出类似 TypeError: '<' not supported between instances of 'NoneType' and 'int' 的异常。解决这个问题的核心在于为排序函数传入自定义的 key 参数,通过元组短路比较或类型显式归一,在数据进入底层大小比较前统一比较标尺,从而实现稳妥、零崩溃的排序。
一、问题复现:TypeError 的触发原因与底层机制
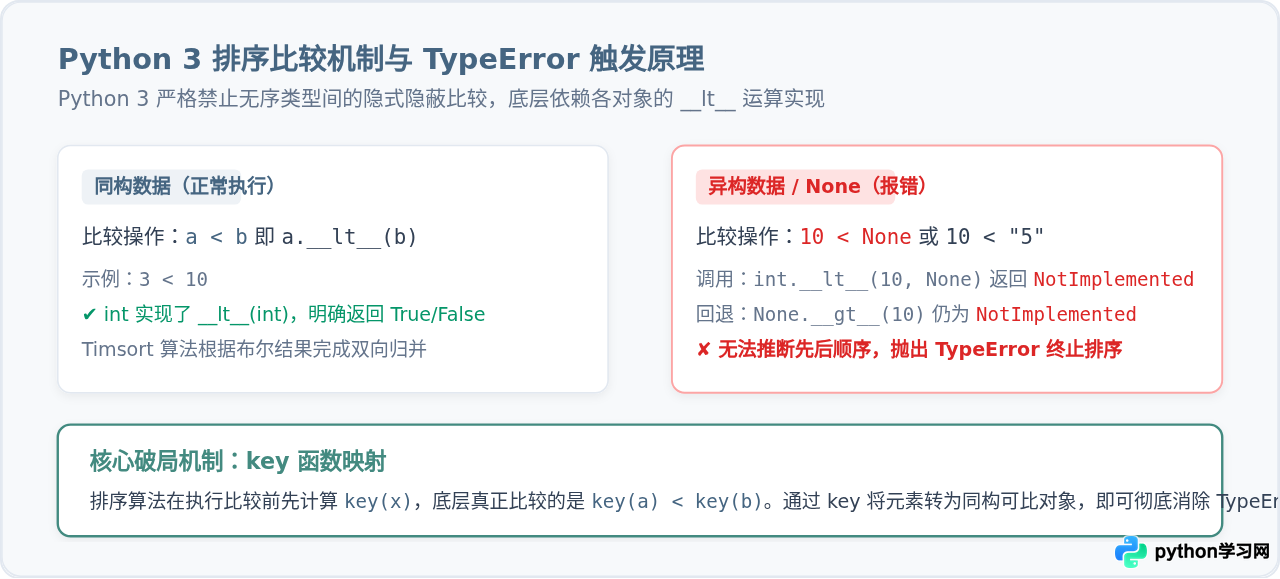
Python 3 与 Python 2 在类型比较的设计上有根本区别。在早期 Python 2 中,跨类型的比较是允许的(例如数字会默认小于字符串),这种设计虽然不会直接崩溃,却常常导致违反数学逻辑的隐蔽错误。Python 3 废除了这种宽松规则,要求参与比较的双方必须明确实现小于运算 __lt__。
当执行列表排序时,Python 内部采用的是高度优化的 Timsort 算法,该算法主要依赖对象的 < 运算符完成元素间的相对次序确定。以下是两种最常见的崩溃场景:
# 场景 1:列表中夹杂 None 缺失值
scores = [85, None, 92, 76]
scores.sort()

# 场景 2:数据源未做类型清洗,数字与文本数字混排
ids = [101, "205", 302, "40"]
ids.sort()TypeError: '<' not supported between instances of 'str' and 'int'
当 Timsort 比较 85 < None 时,Python 会首先调用 int.__lt__(85, None)。由于整数类没有定义与 NoneType 的比较逻辑,该方法返回 NotImplemented。接着 Python 尝试反向比较 None.__gt__(85),同样返回 NotImplemented。由于无法判定双方大小,Python 只能抛出 TypeError 终止排序过程。
二、排查与解决思路流程
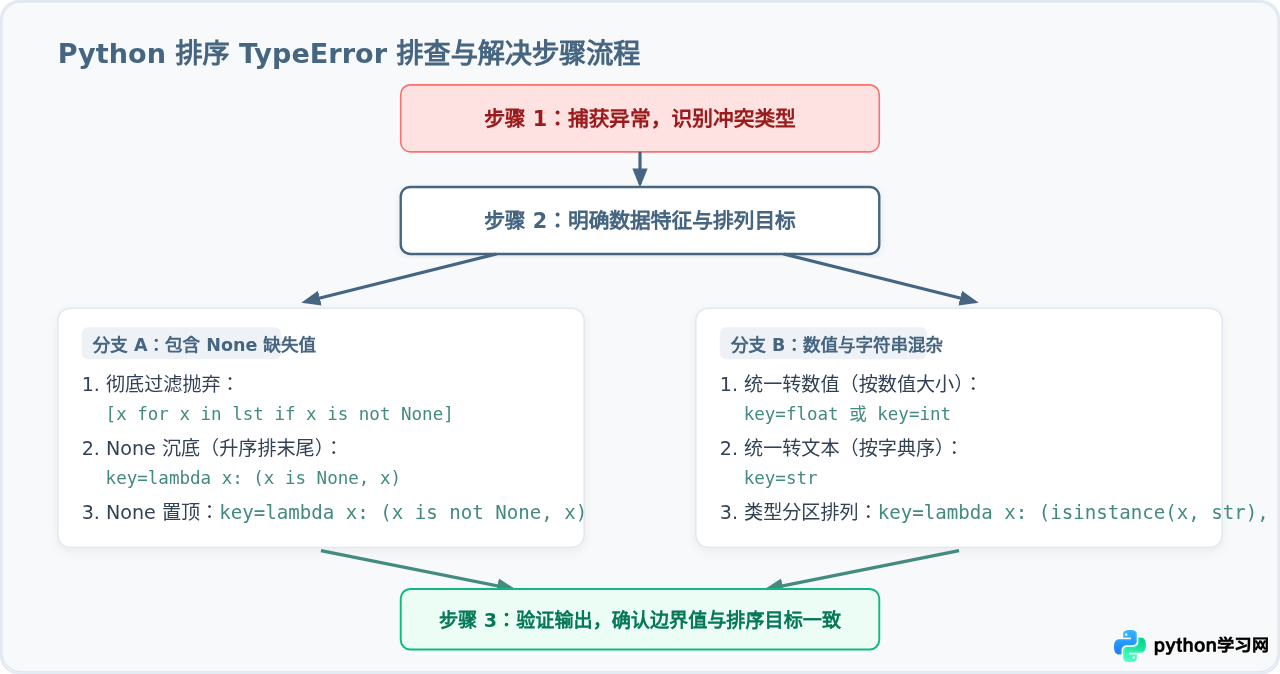
遇到该报错时,无需重写复杂的比较函数,按照“识别数据类型 -> 确定排序归宿 -> 构造针对性 key 函数”的三步法即可迅速解决。
三、包含 None 值的排序处理
真实业务场景(如从数据库或接口读取的记录)中经常存在空值或缺失值。处理包含 None 的数据时,通常有三种需求:沉底到末尾、置顶到开头,或使用默认值填充。
1. 将 None 放置在末尾(最常见)
最优雅且高效的做法是使用双项元组作为键函数:key=lambda x: (x is None, x)。
data = [42, None, 17, 99, None, 5]

# 升序排列,同时让 None 稳定排在最末尾
sorted_data = sorted(data, key=lambda x: (x is None, x))
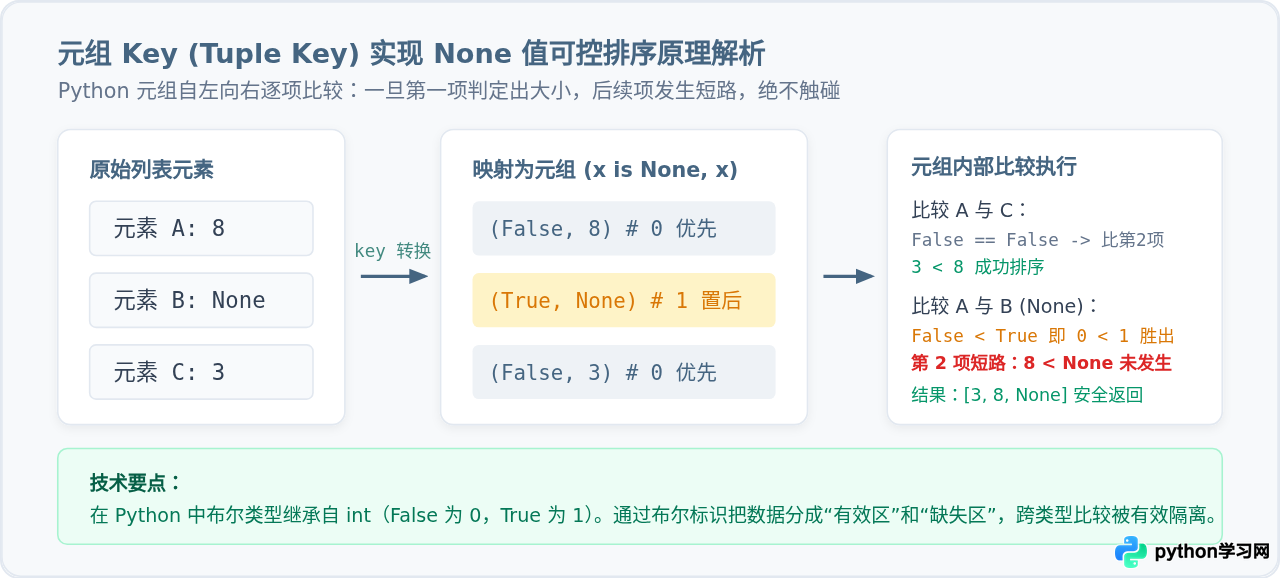
print(sorted_data)为什么这个写法不会报错?关键在于 Python 元组的逐项短路比较特性:
- 在 Python 中,布尔类型
bool是int的子类,False的数值等价于 0,True等价于 1。 - 当元素是普通数值时,
x is None为False(0),生成的元组为(False, 42)。 - 当元素是
None时,x is None为True(1),生成的元组为(True, None)。 - 当比较
(False, 42)与(True, None)时,Python 首先对比第一项:False < True(即0 < 1)直接判定为True!由于第一项已经分出大小,Python 会发生短路,绝不触碰第二项。因此42 < None根本不会被调用,完美绕过了 TypeError。
2. 将 None 放置在列表最开头
如果业务要求将缺失值、待完善项前置展示,只需将条件反转为 x is not None:
data = [42, None, 17, 99, None, 5]

# None 置顶排列
sorted_front = sorted(data, key=lambda x: (x is not None, x))
print(sorted_front)
此时,None 对应的第一项为 False (0),有效数值对应 True (1),因此 None 总是优先排在前面。
3. 降序排序时的注意事项(reverse=True 的陷阱)
key=lambda x: (x is None, x) 基础上添加 reverse=True,第一项也会被一并反转,导致本应沉底的 None 跑到了列表最前端。
如果希望实现“数值降序,但 None 依然保持在最后”,应当保持第一项升序,仅对第二项取负号:
scores = [85, None, 92, 76, None]

# 错误写法:scores_desc = sorted(scores, key=lambda x: (x is None, x), reverse=True)
# 此时 None 会变成排在最前面

# 正确写法:仅对数值取负,保持 None 的权重为 1
scores_desc = sorted(scores, key=lambda x: (x is None, -x if x is not None else 0))
print(scores_desc)4. 替代方案:数值默认值填充与列表过滤
如果业务上允许将 None 视作某个特定的常数(如 0 或无穷大 float('inf')),可以直接使用三元表达式:
# 将 None 视为 0 参与升序排序
data = [10, None, 3, 25]
sorted_filled = sorted(data, key=lambda x: 0 if x is None else x)
print(sorted_filled)

# 若业务完全不需要 None,先用推导式过滤再排序性能更优
cleaned_data = sorted([x for x in data if x is not None])
print(cleaned_data)[3, 10, 25]
四、混合类型(数值与字符串)排序处理
数据录入或跨系统交互时,经常出现数字与字符串形式的数字混在同一列表中的情况,例如 [10, "2", 5, "1"]。处理这类混合类型主要有两种策略。
1. 统一转换标尺(同义数据归一)
若字符串内容均为可解析的数字,可直接将 key 设为 float 或 int。此时排序将完全按照数学大小执行:
raw_mixed = [10, "2", 5, "1.5", 3]

# 按统一数值大小升序
sorted_num = sorted(raw_mixed, key=float)
print(sorted_num)

# 若期望按字符文本字典序排列,则转换为 str
sorted_str = sorted(raw_mixed, key=str)
print(sorted_str)['1.5', '2', 10, 3, 5]
注意:key=float 并不会修改列表原始元素的类型,原列表中的 "2" 仍然保持字符串形态,仅仅是在比较阶段映射为浮点数。
2. 类型分区隔离排序(异构数据各排各的)
如果字符串不能转成数字(如 ["apple", 42, "banana", 10]),我们通常希望“所有数字排在前面按大小排序,所有字符串排在后面按字母排序”。这同样可以通过元组 Key 实现:
items = ["cherry", 100, "apple", 25, "banana", 3]

# 元组第一项为类型等级(数字为0,文本为1),第二项为元素自身
sorted_partitioned = sorted(items, key=lambda x: (1, x) if isinstance(x, str) else (0, x))
print(sorted_partitioned)数字与文本因第一项权重(0 对比 1)直接判定先后,同为数字或同为文本时才对比第二项,同类之间类型一致,不会发生 TypeError。
五、字典列表与复杂对象中的 None 与缺失键
在实际项目开发中,排序对象往往是字典列表或包含多个属性的自定义类对象。当某些记录缺少对应键,或键对应的值为 None 时,必须格外小心。
records = [
    {"id": 1, "name": "张三", "score": 88},
    {"id": 2, "name": "李四", "score": None},
    {"id": 3, "name": "王五"},  # 缺少 score 键
    {"id": 4, "name": "赵六", "score": 95}
]

# 安全获取字段:d.get('score') 既能防止 KeyError,也能取出 None
# 使用元组 Key 将缺失与 None 安全沉底,有效成绩升序排列
safe_sorted = sorted(
    records,
    key=lambda d: (
        d.get("score") is None,
        d.get("score") if d.get("score") is not None else 0
    )
)

for item in safe_sorted:
print(item){'id': 4, 'name': '赵六', 'score': 95}
{'id': 2, 'name': '李四', 'score': None}
{'id': 3, 'name': '王五'}
六、方案全景对比与速查总结
下表和结构图总结了针对各种混合类型与 None 值的处理模式。在编写生产环境代码时,建议优先使用显式元组 Key,逻辑明确且运行效率与原生 C 级比较处于同一量级。
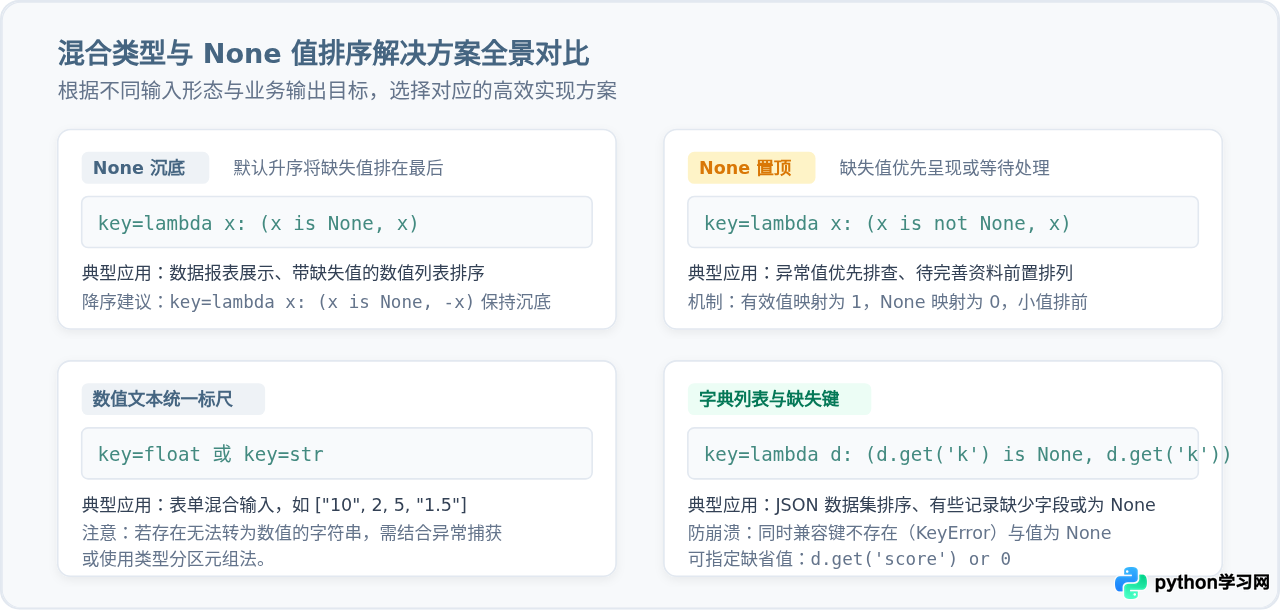
- 排查报错看类型: 识别报错是
NoneType还是str vs int。 - 排序标尺交由 key: 避免在排序前修改原数据,善用
key参数的变换函数。 - None 沉底用元组:
key=lambda x: (x is None, x),借布尔短路隔绝跨类型比较。 - 逆序沉底取负号: 降序排列且 None 沉底时,对第二项取负或单独定义排序元组。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















