


Python截图数据直接传入OpenCV处理的优化方法
深入解析在Python中将屏幕截图数据高效传入OpenCV的核心优化方法,涵盖内存缓冲区直通、色彩通道转换、C连续性保证与性能陷阱规避。
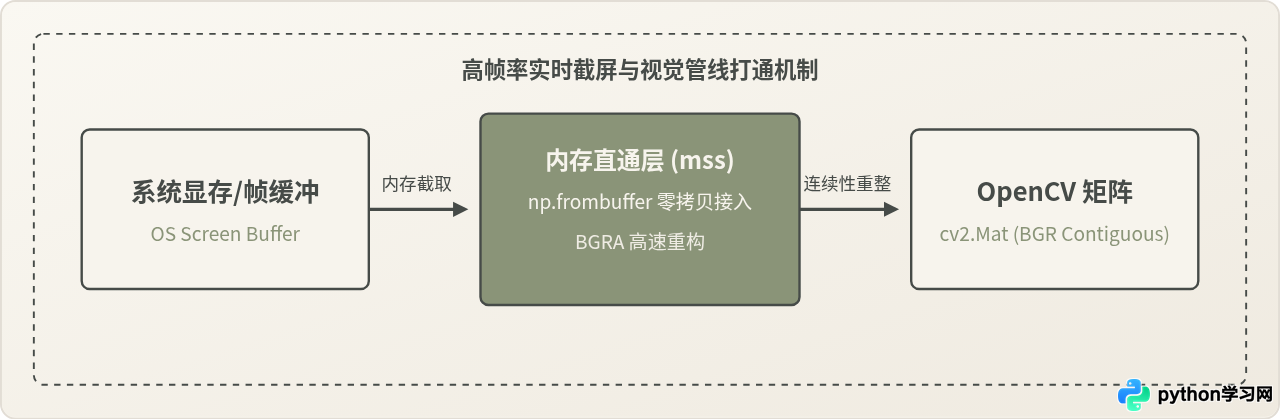
在实时画面分析、自动化操作与桌面视觉算法开发中,将屏幕图像送入 OpenCV 处理是一项基础操作。许多实现为了图省事,先将截图保存为临时图片文件再使用 cv2.imread() 读取,或者借助 PIL.ImageGrab 进行多层封装转换,这导致处理延迟往往高达数十毫秒甚至数百毫秒。优化这个流程的关键在于绕过磁盘 I/O、消除中间对象拷贝,并将系统帧缓冲区中的字节流通过共享内存或直接内存映射(Buffer Protocol)直接转换为符合 OpenCV 底层 C 连续内存布局的 NumPy 数组。本文将针对这一技术路径,详细拆解内存直通的核心逻辑、代码实现、色彩通道修正以及常见的性能误区。
一、为什么传统截图传入方式会成为性能瓶颈
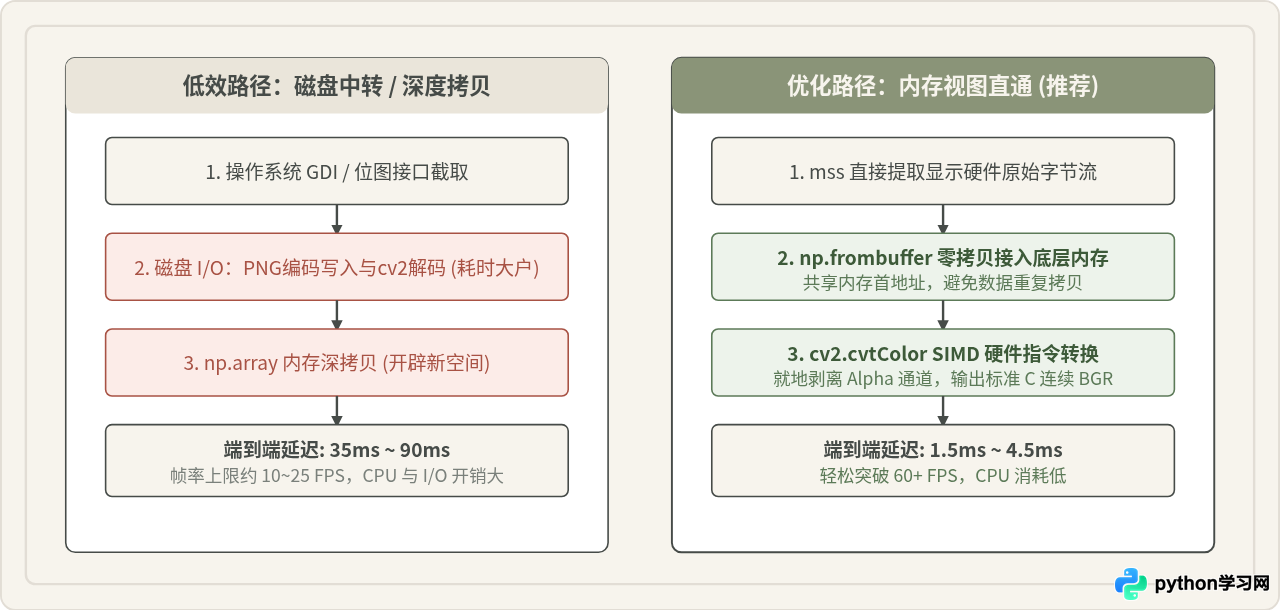
很多初学者在编写屏幕图像处理脚本时,最容易写出的两类低效模式包括:
- 磁盘中转模式:调用截图工具将图片写入临时文件(如
screenshot.png),再用cv2.imread()载入。PNG 格式在写入前需要执行 Deflate 压缩计算,载入时又要执行解压与解码,加上机械硬盘或固态硬盘的写入擦写,单帧耗时通常在 30ms 至 100ms 以上,根本无法满足高刷新率需求。 - 对象反复包装模式:使用
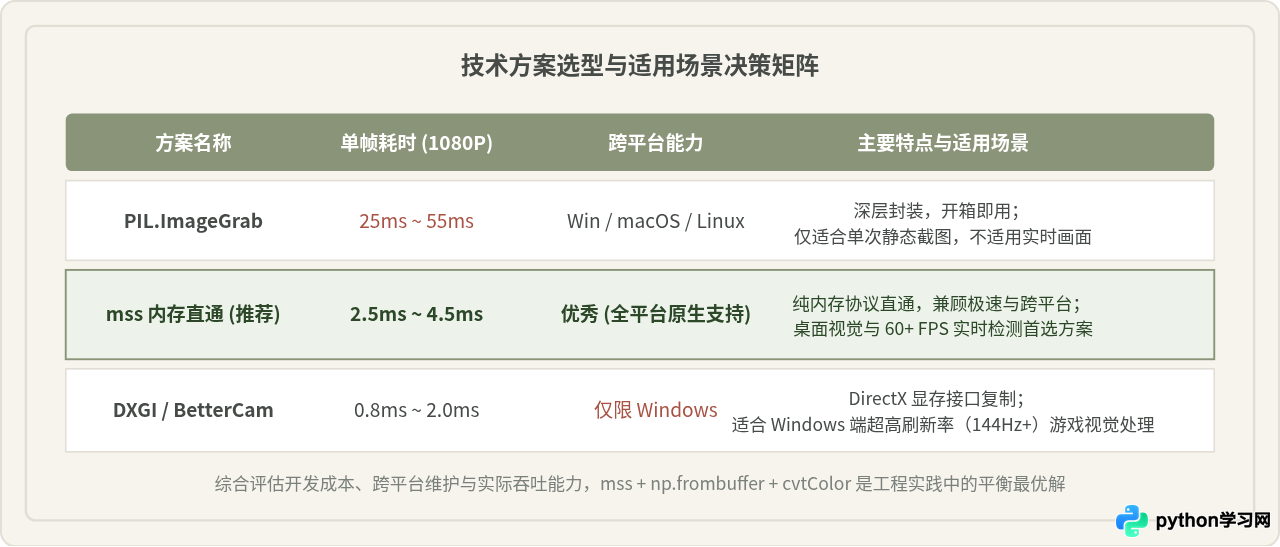
PIL.ImageGrab.grab()截取后,调用np.array(pil_img)生成数组,再通过cv2.cvtColor(img, cv2.COLOR_RGB2BGR)转色。虽然没有走磁盘,但 PIL 内部进行了一次系统 API 的位图打包,随后np.array()又在 Python 堆区重新开辟了一整块内存并执行内存拷贝,帧率通常只能维持在 15~20 帧左右。
二、核心优化原则:内存直通与通道对齐
要让截图速度达到 60 FPS 甚至更高,需要从根本上消除两次冗余操作:数据内存拷贝与重复色彩空间变换。
1. 借助 Buffer 协议直接映射(零拷贝视图)
操作系统捕获屏幕时,无论在 Windows (GDI/DirectX)、macOS (Quartz/CoreGraphics) 还是 Linux (X11/Wayland),最终呈现给 Python 扩展库的都是一段连续的二进制字节缓冲区。成熟的高性能截图库(例如 mss)在截取屏幕后,其底层对象内部会直接保存原始像素字节流属性(.raw)。
如果使用 np.array(sct_img),NumPy 会重新分配等大的内存并将全部像素逐字节复制过去。正确的做法是使用 np.frombuffer(sct_img.raw, dtype=np.uint8)。该函数不会在堆区复制字节,而是基于现有的内存首地址创建一个一维的 NumPy 数组视图,将内存开销与拷贝耗时降至接近于零。
2. 屏幕原始通道格式与 OpenCV 的差异
OpenCV 内部的色彩矩阵默认采用 BGR(蓝-绿-红)三通道排列,而现代操作系统的桌面合成器绝大多数采用 BGRA(蓝-绿-红-透明度)四通道排列(部分库如 PIL 则默认转成 RGB)。
如果忽略通道差异,直接丢给 OpenCV 的级联分类器、模板匹配或形态学滤波,通常会产生通道错位(画面偏蓝变黄)或者因 4 通道不受支持直接抛出异常。因此,我们必须在进入算法前,将内存流快速修剪为 3 通道的 BGR 矩阵。
三、最佳实践:完整代码实现与详解
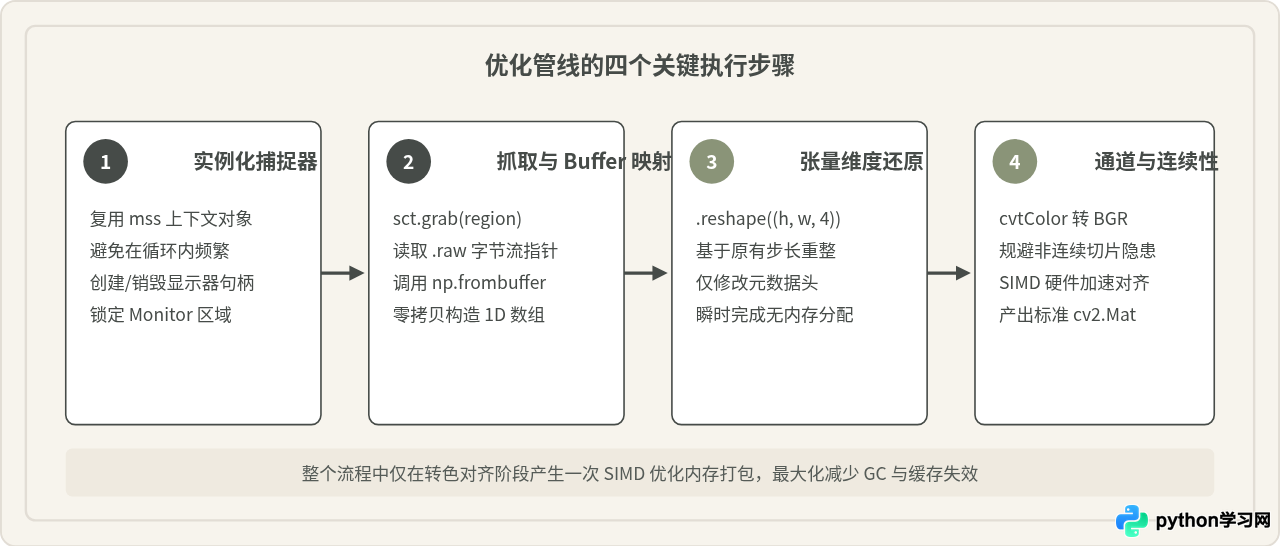
以下是经过性能调优的完整代码实现。环境依赖非常轻量,仅需安装 mss、numpy 和 opencv-python:
pip install mss numpy opencv-python编写运行脚本 fast_screen_opencv.py:
import time
import cv2
import mss
import numpy as np

def capture_direct_to_opencv():
    # 1. 实例化 mss 截图对象。务必在循环外部实例化以复用内部资源与句柄
    with mss.mss() as sct:
        # 指定捕获区域。如需抓取特定主屏幕,可使用 sct.monitors[1]
        # 也可自定义感兴趣区域 (ROI),仅截取必要范围可大幅削减计算负担
        monitor = {"top": 100, "left": 100, "width": 800, "height": 600}

        last_time = time.time()
        frame_count = 0

        while True:
            # 2. 抓取屏幕并直接提取 raw 原始像素字节
            sct_img = sct.grab(monitor)

            # 3. 通过 np.frombuffer 将底层字节流以零拷贝方式包装为 NumPy 一维数组
            # 随后使用 reshape 在常数级时间内设定 (高, 宽, 通道数) 维度
            img_bgra = np.frombuffer(sct_img.raw, dtype=np.uint8).reshape(
                (sct_img.height, sct_img.width, 4)
            )

            # 4. 高速色彩通道修剪与连续性重整 (BGRA -> BGR)
            # 使用 cv2.cvtColor 的 SIMD 指令集不仅消除 Alpha 通道,还能确保内存 C 连续
            frame = cv2.cvtColor(img_bgra, cv2.COLOR_BGRA2BGR)

            # --- 此时 frame 已经是标准的 OpenCV 矩阵,可直接投入后续算法 ---
            # 示例:画一个检测矩形演示处理
            cv2.rectangle(frame, (50, 50), (250, 200), (0, 255, 0), 2)

            # 计算并打印即时帧率
            frame_count += 1
            if time.time() - last_time >= 1.0:
                print(f"当前帧率: {frame_count} FPS")
                frame_count = 0
                last_time = time.time()

            # 实时显示
            cv2.imshow("Optimized Screen Stream", frame)

            # 按 'q' 键退出
            if cv2.waitKey(1) & 0xFF == ord('q'):
                break

        cv2.destroyAllWindows()

if __name__ == "__main__":
    capture_direct_to_opencv()
代码运行说明:
上述代码在 1080P 或自定义尺寸(800x600)屏幕区域抓取时,在普通现代 PC 上通常能在 2ms~4ms 内完成单帧抓取与数据重整。如果仅仅进行显示或轻量检测,画面吞吐率可以稳定在 80~120 FPS 以上。
四、关键细节辨析:切片 [:, :, :3] 真的比 cvtColor 快吗?
在 Python 社区中,流传着一种看似非常有道理的写法:
# 常见“优化”写法:利用数组切片丢弃 Alpha 通道
frame = img_bgra[:, :, :3]这种说法认为:[:, :, :3] 只是对 NumPy 数组的一个视图切片,不需要任何数学计算和数据搬迁,耗时为 0ms,所以一定优于需要逐像素遍历的 cv2.cvtColor(img_bgra, cv2.COLOR_BGRA2BGR)。这个说法看似合理,但在实际送入 OpenCV 处理时往往隐藏严重隐患。
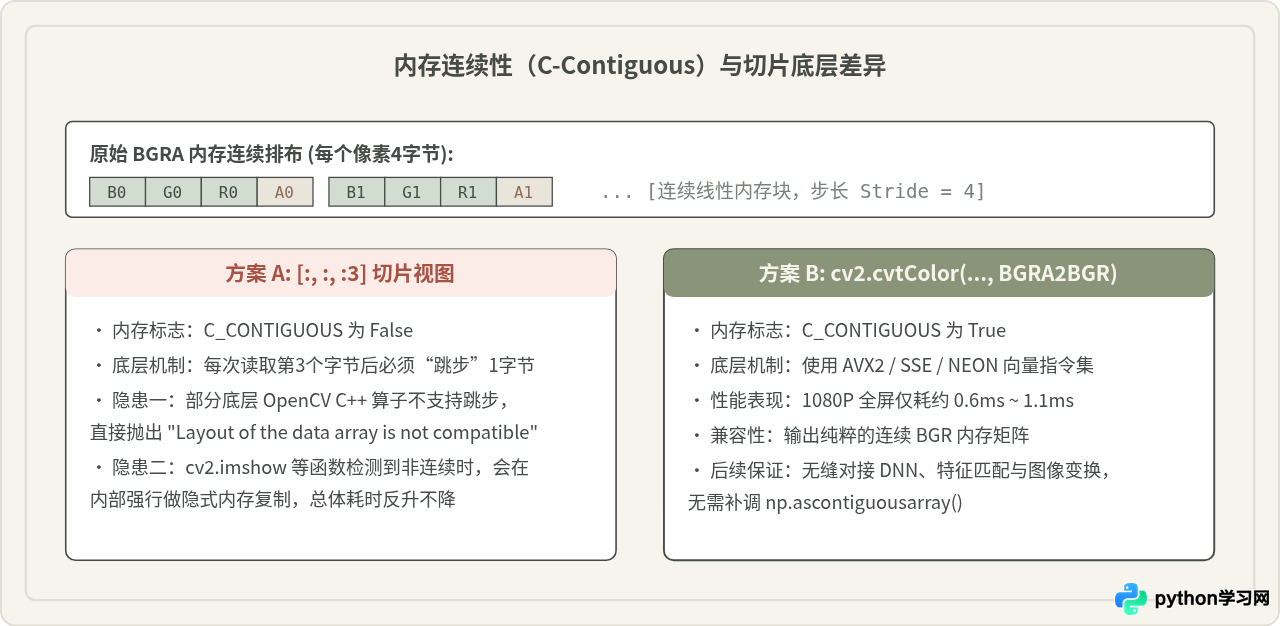
实测与分析:
我们可以打印切片后的 NumPy 标志属性:
sliced = img_bgra[:, :, :3]
print(sliced.flags['C_CONTIGUOUS'])  # 输出 False

converted = cv2.cvtColor(img_bgra, cv2.COLOR_BGRA2BGR)
print(converted.flags['C_CONTIGUOUS'])  # 输出 True
当数组的 C_CONTIGUOUS 为 False 时,由于像素与像素之间存在 1 个被跳过的 Alpha 字节,如果直接将 sliced 传入部分底层封装较深或依赖连续指针遍历的 C/C++ 扩展(如 cv2.matchTemplate 或自定义 Cython/C++ 模块),会由于跨步不匹配导致画面撕裂、崩溃,或者在内部被强制转译一次。而 cv2.cvtColor 是经过 CPU 指令集深度优化的,它将 4 通道转化为连续 3 通道通常仅耗费 0.8ms 左右,不仅完全没有兼容性隐患,而且后续算法计算速度更快。
五、更多进阶优化策略
1. 仅捕获感兴趣区域(ROI),而非全屏
很多视觉脚本只需要识别画面中央的准星、血条或特定的软件窗口。截图开销与截取像素总数呈正比关系。4K 屏幕的原始像素数据约为 33MB/帧,而 400x300 的 ROI 仅为 480KB。通过将 monitor 字典直接限定为局部区域坐标,可以让抓取时间直线下降到 0.5ms 以内。
2. 多显示器与高分屏(DPI 缩放)适配
在 Windows 或 macOS 开启了 125%、150% 或 200%(Retina)缩放的显示设备上,截图库获取的实际物理像素与系统的逻辑点坐标会存在倍率差。使用 sct.monitors 可以获取屏幕的真实物理分辨率。编写自动化点击或坐标回传时,务必将 OpenCV 检测出的像素坐标按缩放比例换算回桌面逻辑坐标。
3. 多线程生产者-消费者架构
如果后续的图像处理计算量较大(如复杂的 YOLO 模型推断),截图和计算放在同一线程中会导致抓取频率受制于推断延迟。推荐使用轻量的 queue.Queue(maxsize=1) 或线程共享变量,一个线程专门负责极速将屏幕数据存入预先分配好的双缓冲区,主线程按需消费最新帧,即可实现帧率的最大化解耦。
六、总结
将 Python 截图数据优化传入 OpenCV 的本质,是将数据在内存中的流转开销降到最低。总结起来包含三项核心操作:
- 复用抓取实例:在外部维持单一截图会话,避免在循环体内重复申请操作系统窗口句柄与底层显存上下文。
- 零拷贝内存映射:使用
np.frombuffer结合.reshape()直接从截图库的.raw二进制缓冲区中构筑 NumPy 多维矩阵,彻底舍弃磁盘与中间变量拷贝。 - 安全高效的通道重排:优先选用
cv2.cvtColor(..., cv2.COLOR_BGRA2BGR)。虽然简单的步长切片[:, :, :3]省去了即时计算,但其破坏了数据连续性(Non-contiguous),不仅无法真正提升全局性能,还会埋下潜在的 OpenCV 算子崩溃隐患。
遵循这套规范,即可让视觉抓取管线稳定跑满常规屏幕刷新率,为后续的模板匹配、目标检测与模型推断留出充足的算力空间。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















