


免费Python在线编译器的常见限制:内存、CPU与存储详解
深入解析免费Python在线编译器在内存配额、CPU算力、执行时长以及磁盘存储上的底层限制机制,提供具体的报错表现识别、排查测试步骤与代码层规避优化方案。
免费Python在线编译器让开发者无需本地配置即可编写和调试代码,但当脚本涉及大规模数据处理、长时间循环或生成本地文件时,常遭遇进程静默中断(Exit Code 137)、执行超时截断或数据保存后丢失的问题。这些现象并非语法错误,而是云端多租户沙箱对内存(RAM)、处理器计算配额(CPU)与临时文件卷(Ephemeral Storage)施加的物理配额保护。本文系统解析这三项关键限制的底层触发机理、识别方法及具体的代码级优化对策。
一、云端沙箱架构:免费环境为何必须严格设限
在线编译器(如 OnlineGDB、Programiz、Replit 免费层、Jupyter 在线平台等)提供的是一种基于共享云计算设施的即用即走服务。当用户在网页前端点击“Run”时,代码并非直接运行在裸机硬件上,而是通过调度系统分发到宿主服务器内隔离的轻量容器(如 Docker、gVisor 或 Firecracker 微虚拟机)中执行。
由于单台物理机通常承载成百上千个并发运行的代码任务,平台必须通过 Linux 内核控制组(cgroups)以及命名空间(Namespaces)对每个容器施加严格的边界控制。一旦放开限制,单个包含死循环或内存泄露的代码将瞬间耗尽宿主机资源,导致整台服务器上的其他用户任务全部瘫痪。
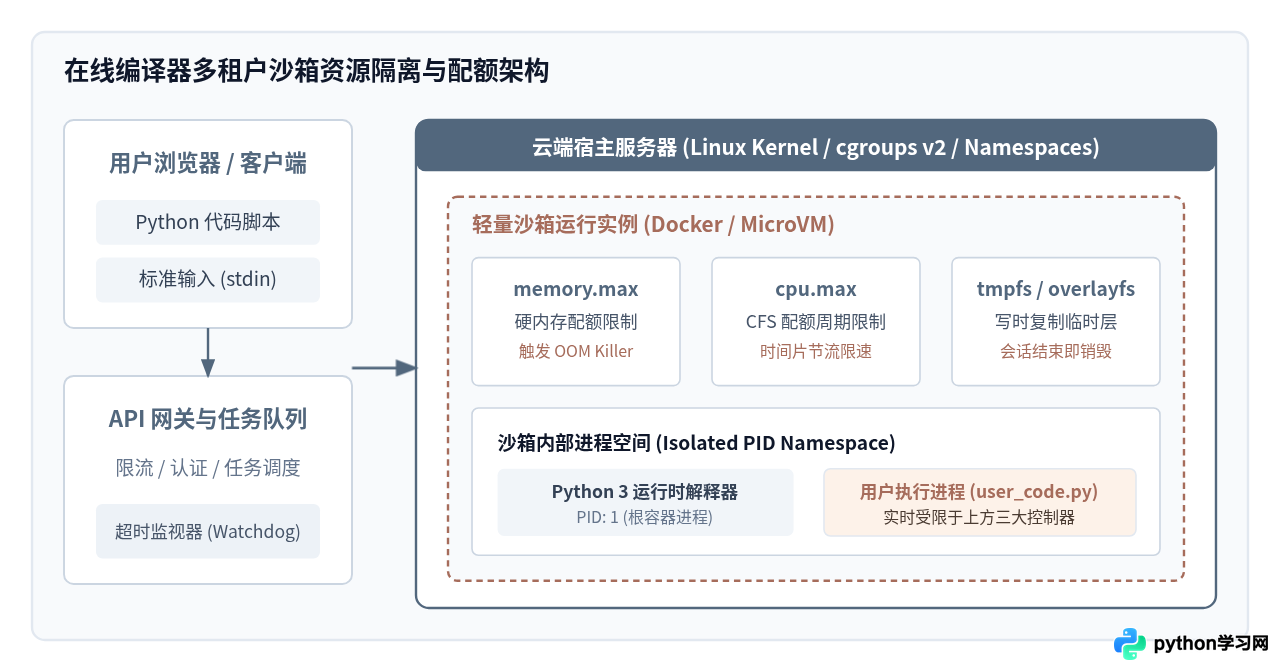
理解了沙箱的本质,就能清楚意识到:免费在线编译器本质上是受到强力监控的受限容器。其资源限制绝不是软性提示,而是来自底层内核的硬性拦截。
二、内存限制(RAM):OOM 杀进程的静默崩溃
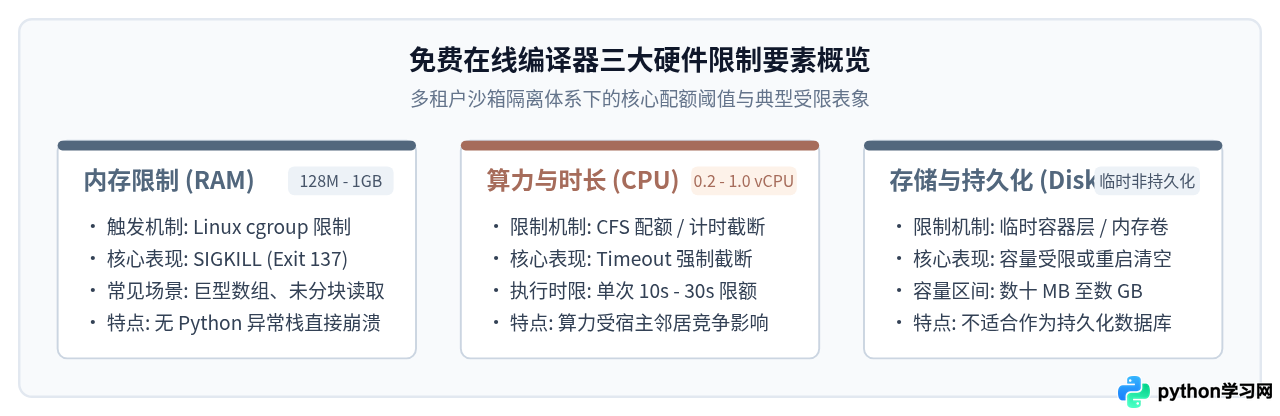
内存限制是日常运行数据处理与分析时最常碰壁的瓶颈。不同免费平台对单个会话的内存分配通常有明确的上限:
- 轻量级即时编译工具(如 OnlineGDB、JDoodle、菜鸟工具):通常仅提供 128MB 至 256MB 的内存上限,只满足基础语法练习与算法刷题。
- 应用沙箱平台(如 Replit 免费版、PythonAnywhere 免费层):通常配置 512MB 内存,超出后直接冻结或杀灭进程。
- 交互式 Notebook 平台(如 Google Colab、Kaggle 免费层):标称提供数 GB 甚至更高,但在免费高负载期间,未分块加载大文件依然会触发瞬时 OOM。
1. 典型受限报错与行为特征
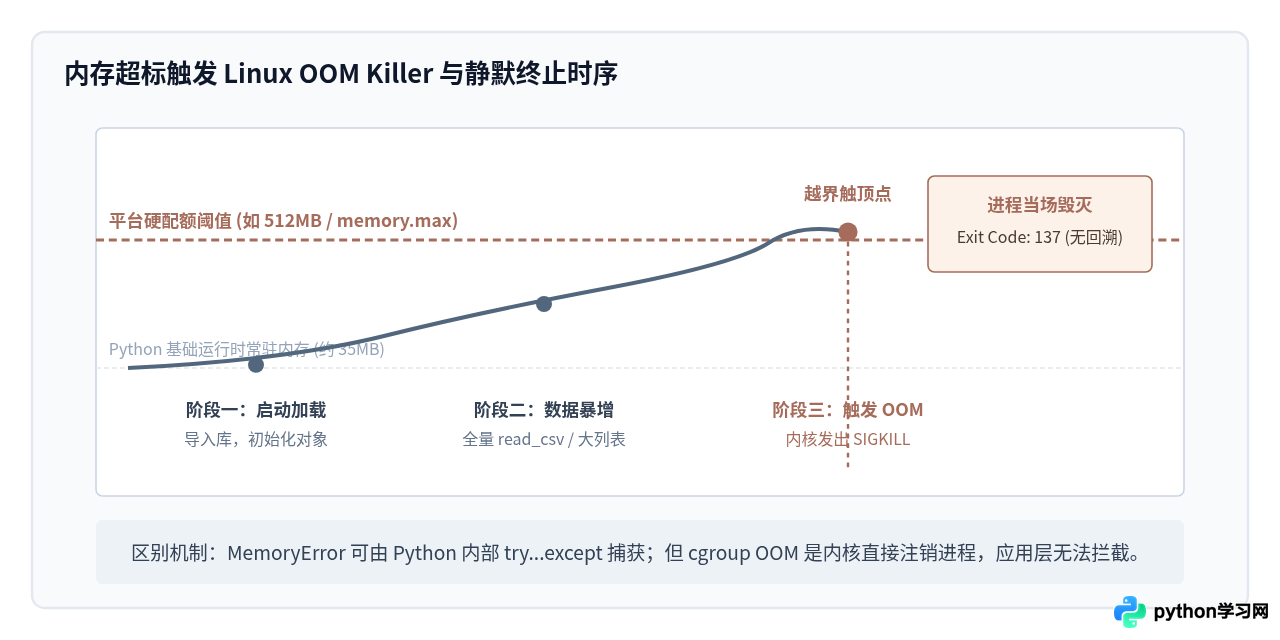
许多初学者感到困惑的是:当内存超标时,往往看不到 Python 的 MemoryError 堆栈跟踪。
这是因为 Python 的 MemoryError 只有在底层 C 库的 malloc() 调用返回 NULL 时才会抛出;但在现代 Linux 系统中,开启了内存过度分配(Overcommit)。当程序申请的物理内存超过 cgroup 的 memory.max 硬限制时,是由 Linux 内核的 OOM Killer(Out of Memory Killer) 直接向进程发送无条件终止信号 SIGKILL(信号编号 9)。
Killed、Terminated、Exit code 137(128 + 9 = 137)或者交互式界面提示“Kernel died, restarting”,100% 属于触发了云端内存硬限制。
2. 规避内存超标的代码编写方案
在受限环境中,应避免将完整数据集一次性载入内存。以下为两种典型场景的优化对比:
# 场景 1:处理大型文本或日志文件
# ❌ 错误做法:一次性 readlines() 会将所有行载入内存,极易 OOM
# with open("large_data.log", "r") as f:
#     lines = f.readlines()

#  正确做法:利用文件对象的迭代生成器,流式逐行解析(内存占用恒定 < 1MB)
with open("large_data.log", "r", encoding="utf-8") as f:
    for line in f:
        if "ERROR" in line:
            # 仅在内存中处理当前行
            process_record(line)

# 场景 2:使用 Pandas 处理大规模表格数据
import pandas as pd

# ❌ 错误做法:直接读取 500MB 的 CSV 文件,展开为 DataFrame 后可能膨胀至 2GB
# df = pd.read_csv("dataset.csv")

#  正确做法:指定 chunksize 进行分块迭代计算,并适时释放引用
chunk_size = 50000  # 每次仅处理 5 万行
aggregated_total = 0

for chunk in pd.read_csv("dataset.csv", chunksize=chunk_size):
    aggregated_total += chunk["amount"].sum()

print("聚合计算总值:", aggregated_total)
三、CPU 与执行时长限制:算力截断与单核竞争
免费平台对算力的限制主要体现在两个维度:虚拟核心数(vCPU)与时间片配额,以及单次脚本的最大挂钟时间(Wall-clock Timeout)。
1. 算力与时限的具体表现
- CFS 配额节流(CPU Throttling):免费沙箱通常只分配 0.2 至 1 个虚拟核心。即使代码使用了
multiprocessing试图启动 8 个进程,所有子进程也只能在一个共享的受限虚拟周期内竞争算力,不仅不会加速,反而会因频繁上下文切换而变得更加缓慢。 - 严格的单次运行时长限制:为了避免恶意矿机或无休止的死循环,平台在任务调度层配置了外挂看门狗(Watchdog)。通常简单交互式编译器单次运行超时设定为 10 秒至 30 秒;在线 Notebook 单单元格最长允许运行通常不超过几分钟到数十分钟;后台运行无操作后会迅速自动休眠。
# 常见截断报错示例(由宿主平台拦截层抛出):
# Output:
# [Execution Timed Out] Process killed after 15.00 seconds.
# 或直接返回:
# TimeoutExpired: Command '['python', 'main.py']' timed out after 20 seconds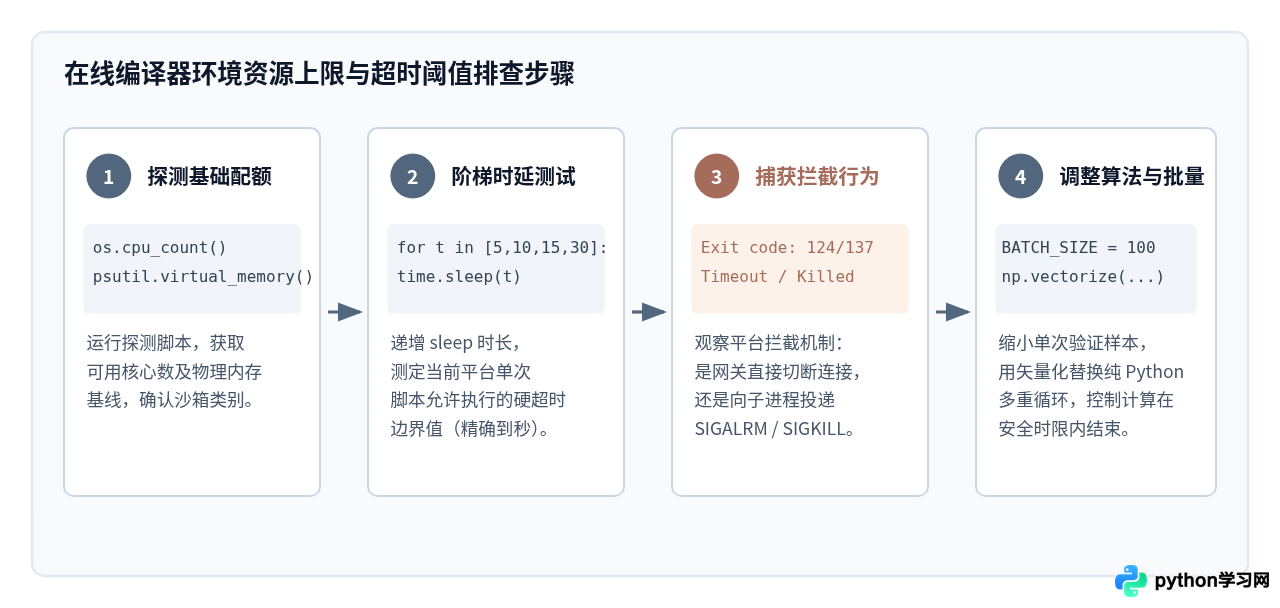
2. 自测环境规格与规避策略
在进行复杂运算前,可先运行以下标准诊断代码,快速摸清当前在线编译器的底层规格:
import os
import sys
import time

def probe_environment():
    # 1. 检查逻辑 CPU 核心数
    cpu_count = os.cpu_count()
    print(f"检测到可用 CPU 核心数: {cpu_count}")

    # 2. 读取 Linux 内存信息(若在类 Unix 沙箱中)
    try:
        with open("/proc/meminfo", "r") as f:
            for _ in range(3):
                print(f.readline().strip())
    except Exception as e:
        print(f"无法直接读取 /proc/meminfo: {e}")

    # 3. 快速基准测试:单核矩阵乘法耗时
    start_t = time.time()
    total = sum(i * i for i in range(2_000_000))
    elapsed = time.time() - start_t
    print(f"200万次循环计算耗时: {elapsed:.3f} 秒 (结果: {total})")

probe_environment()规避建议:在在线环境中运行科学计算或数据分析时,尽量依赖基于 C 语言实现的库(如 NumPy、SciPy)进行底层矢量运算,规避解释器级别的纯 Python 嵌套循环;对于较长批处理,应人为将数据规模缩小至验证集大小(如仅抽取 1000 条样本),确认逻辑无误后再迁移至本地完整环境。
四、存储空间与持久化限制:临时文件随时“蒸发”
很多初学者在在线编译器中写文件,如 open("result.txt", "w"),再次刷新页面或重新打开链接后,发现文件不翼而飞。这也是云端沙箱最容易被误解的一项机制:临时非持久化文件系统(Ephemeral Storage)。
1. 磁盘限额的双重陷阱
- 容量上限小(Disk Quota):免费容器分配的根目录或
/tmp目录通常在 100MB 到 2GB 之间。尝试在脚本中下载大型数据集或解压安装复杂预编译 Wheel 包时,极易直接报出OSError: [Errno 28] No space left on device。 - 无状态瞬态生命周期:轻量编译器通常采用只读基础镜像外挂写时复制层(OverlayFS)或内存文件系统(tmpfs)。一旦当前代码执行完毕、WebSocket 连接断开或页面刷新,整个容器实例随即被调度系统彻底销毁回收。
2. 规避与持久化应对方式
若确实需要在在线环境下导出计算结果,可采用以下标准做法:
- 轻量数据直接输出控制台:对于指标、少量特征矩阵或配置,直接通过
print()输出为 JSON 字符串或 Base64 编码,从网页终端中复制保存。 - 调用外部对象存储 API:在代码最后,通过标准 HTTP 请求(如
requests库)将生成的报表或图片推送到自建的 Webhook、GitHub Gist 或云存储服务中。 - 区分编译型与工作区型平台:若需要长期保留文件,应选用提供挂载持久卷的完整云 IDE(如 GitHub Codespaces、绑定云盘的 Colab),而非单次运行即毁的轻量编译框。
五、三大资源限制综合对比与应对策略全景
下表系统归纳了免费 Python 在线编译器中内存、CPU 与存储三项维度的受限机制与应对方案,帮助开发者在遇到程序异常终止时迅速定位根源:
| 资源维度 | 常见免费阈值 | 底层限制机制 | 典型受限现象 | 代码层规避方案 |
|---|---|---|---|---|
| 内存 (RAM) | 128MB ~ 1GB | Linux cgroups memory.max 硬限额 |
Exit code 137, Killed, 无 Python 异常栈 | 生成器逐行读取、Pandas chunksize 分块、del 及时释放 |
| 算力与时长 (CPU) | 0.2 ~ 1 vCPU 单次 10s ~ 30s |
CFS 周期节流、网关看门狗定时器 | Execution Timed Out, TimeoutExpired | 矢量化运算替代多重循环、缩减验证样本量、避免盲目多进程 |
| 存储与持久化 (Disk) | 数百 MB,会话级重置 | tmpfs / OverlayFS 临时层 | No space left on device, 刷新后文件丢失 | 轻量数据流式输出、API 推送远程存储、选用持久化云工作区 |
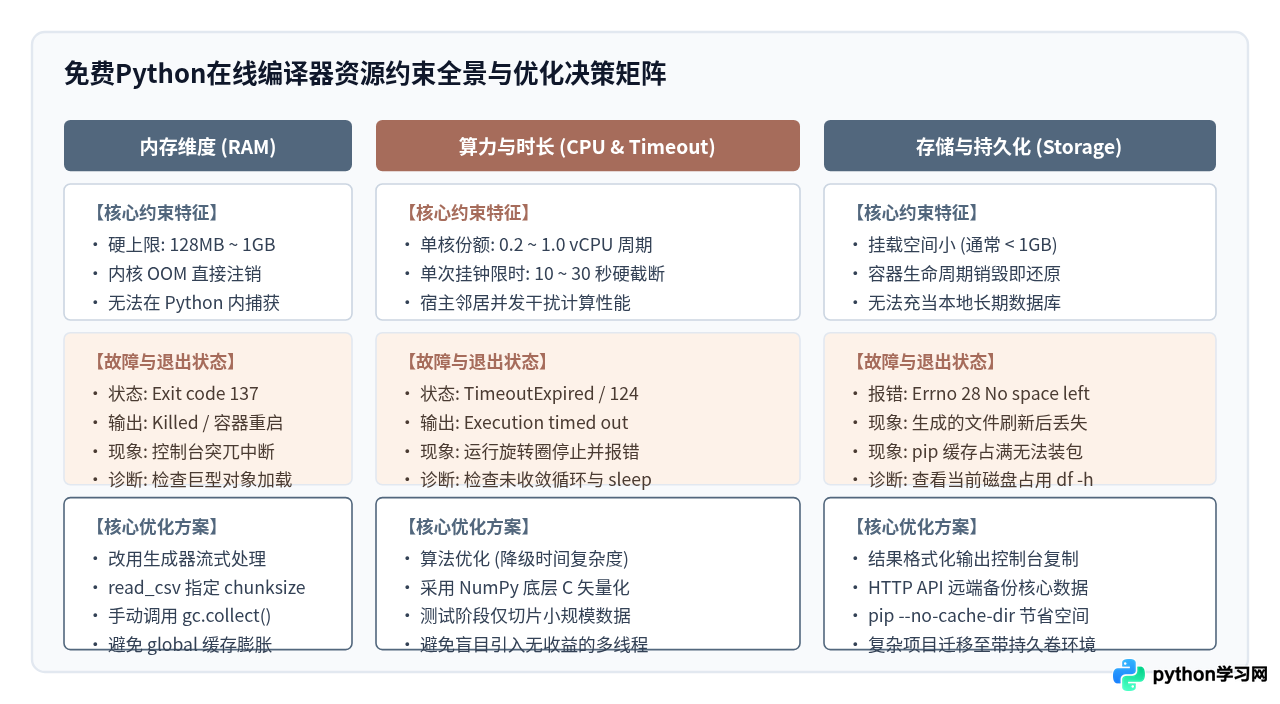
综上所述,免费 Python 在线编译器非常适合算法逻辑校验、基础语法演练以及轻量脚本的原型验证。只要清楚意识到其物理内存受限、单次运算有看门狗拦截、文件属于临时卷的客观环境约束,并主动采用生成器流式处理、分块计算与精简测试数据量等编码技巧,就能在云端沙箱的严格限制下稳定、高效地完成验证任务。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















