


Python列表倒序排序:sort()与sorted()用法详解
深入详解Python中实现列表倒序排序的两种核心方式:list.sort()与sorted()。解析原地修改与新建对象的机制差异、参数用法、内存行为、key函数高级排序及常见陷阱。
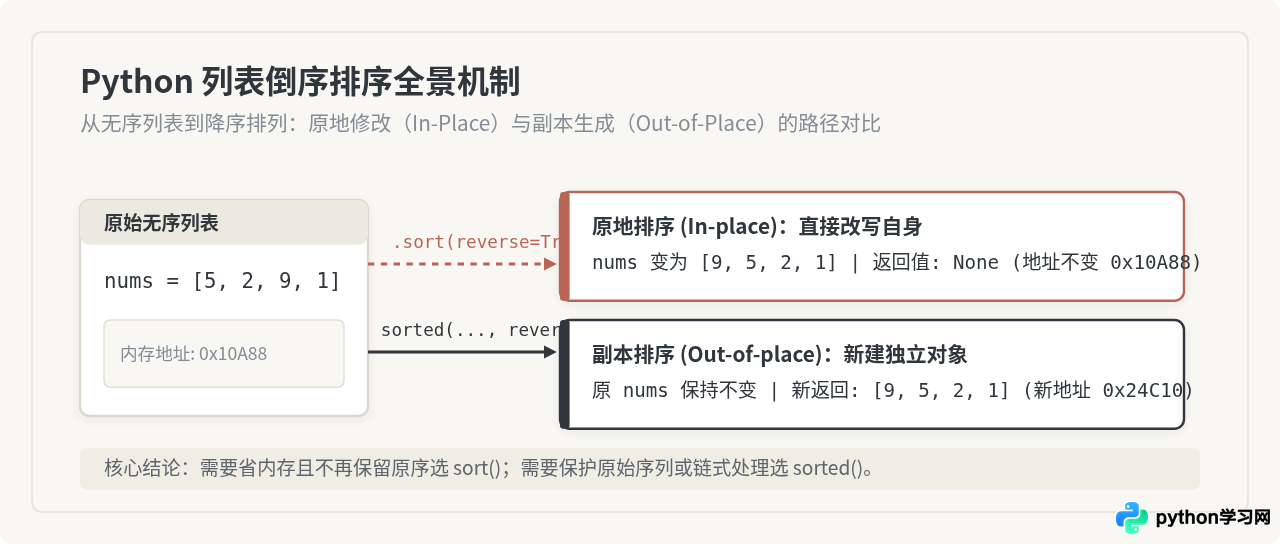
在 Python 中实现列表的倒序排序(即按元素数值或字典序从大到小排列),最直接且标准的方式是使用内置方法 list.sort() 或内置函数 sorted(),并传入关键字参数 reverse=True。虽然两者都能达成“降序输出”的结果,但它们的操作逻辑、内存开销以及返回值机制截然不同:sort() 在原列表上执行就地修改且返回 None,而 sorted() 则绝不改动原对象,而是重新分配内存并返回一个排好序的新列表。本文将具体剖析两者的具体用法、底层原理、关键陷阱以及与“物理翻转”的本质区别。
一、核心用法与快速上手:掌握 reverse=True
Python 默认的排序算法是升序(从低到高、从小到大)。无论调用哪种排序工具,控制排序方向的核心参数都是 reverse,该参数接收一个布尔值,默认为 False。当显式指定 reverse=True 时,算法会在排序比较过程中将顺序反转,直接输出降序结果。
1. list.sort(reverse=True):列表对象的专有方法
sort() 是仅属于 list 类型的成员方法。它直接在原列表所在的内存区域进行重排,不占用额外的列表容器空间。需要特别注意的是,该方法执行后返回值为 None,这意味着不能直接将其赋值给新变量,否则会导致变量丢失对列表的引用。
# 示例:使用 sort(reverse=True) 进行就地倒序排序
scores = [78, 92, 65, 88, 99, 82]
print("排序前原列表:", scores)

# 原地修改,注意不要写成 result = scores.sort(...)
scores.sort(reverse=True)
print("排序后原列表:", scores)排序后原列表: [99, 92, 88, 82, 78, 65]
2. sorted(iterable, reverse=True):通用的内置函数
sorted() 是 Python 的内置全局函数。它接收任何可迭代对象(如列表、元组、集合、字典等),并在内部构建并返回一个全新的列表。原始输入数据在整个执行过程中保持只读,状态完全不会发生改变。
# 示例:使用 sorted(iterable, reverse=True) 获得降序副本
raw_data = [12, 45, 23, 67, 34, 89]
desc_data = sorted(raw_data, reverse=True)

print("原始列表 (未受影响):", raw_data)
print("新生成的倒序列表:", desc_data)新生成的倒序列表: [89, 67, 45, 34, 23, 12]
二、原地修改与生成新列表:内存机制与副作用剖析
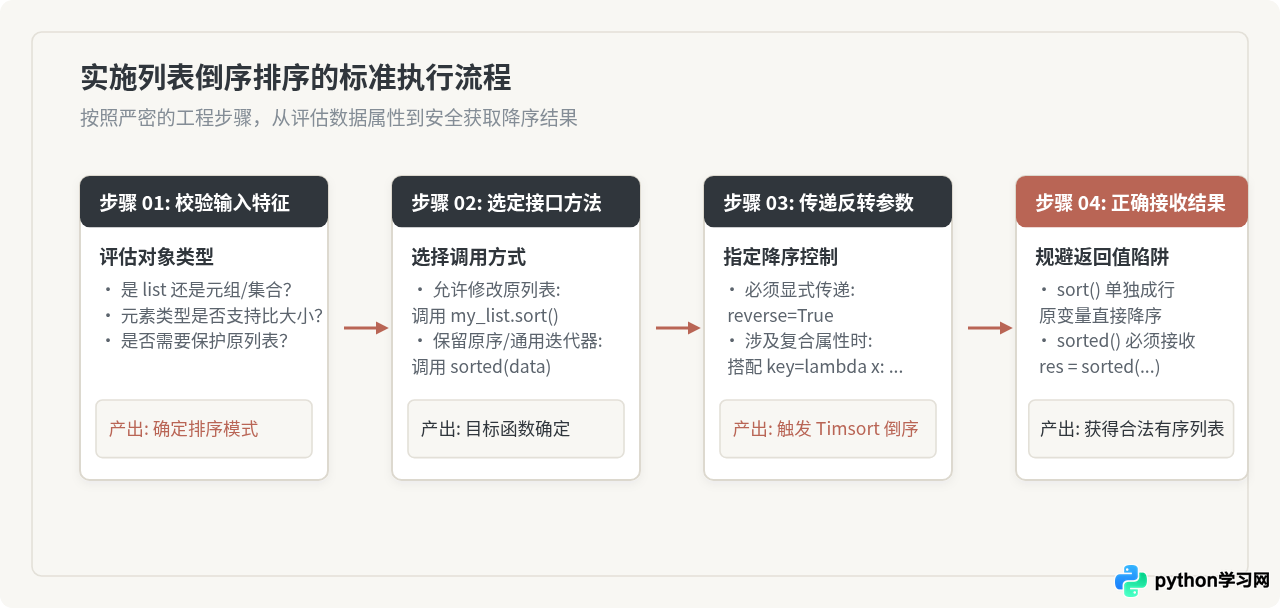
很多开发者在初学阶段最容易犯的一个错误是:写出 result = my_list.sort(reverse=True)。随后在打印 result 时惊讶地发现控制台输出了 None。这是 Python 在 API 设计哲学上的明确约束:所有就地修改可变对象(如列表、字典、集合)的原生方法,均显式返回 None。这一设计的目的是防止开发者误以为系统创建了新副本,从而产生非预期的并发或别名修改副作用。
关键设计警示:my_list.sort() 执行完成后,原列表的内容已经物理变更,其函数返回值严格为 None。如果需要链式调用(例如 sorted(...)[0])或获取新变量,必须使用 sorted()。
性能与内存取舍
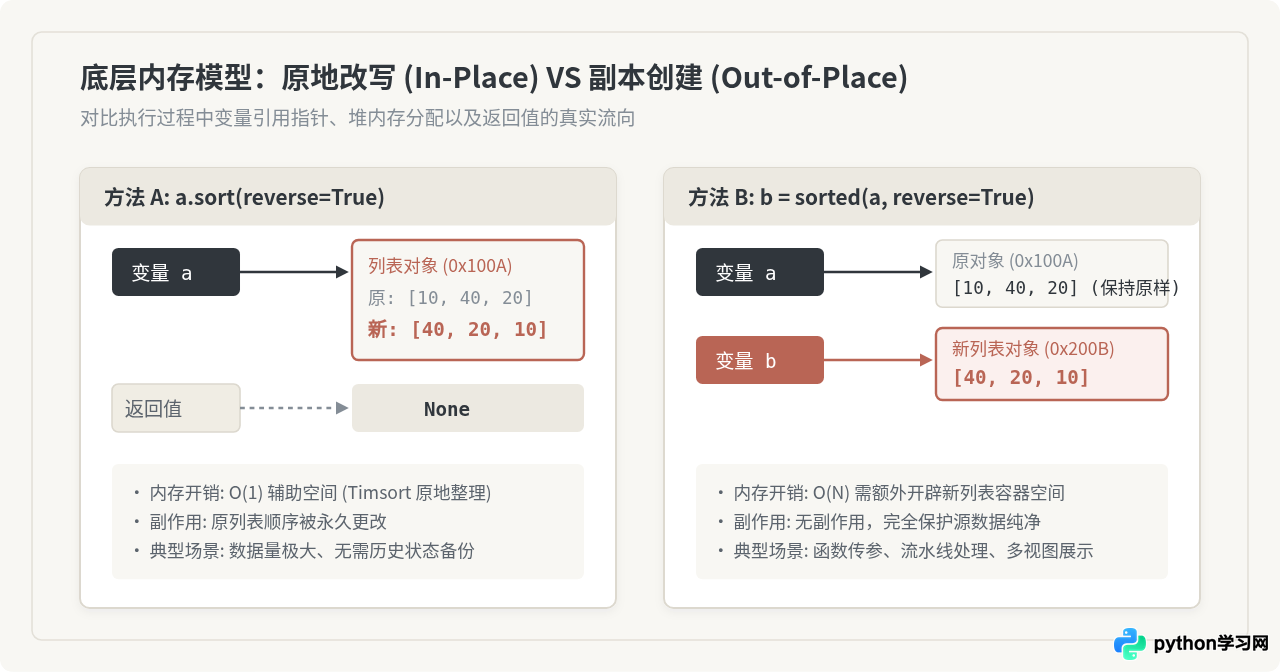
从算法底层来看,Python 的 sort() 和 sorted() 均基于 Timsort 算法(一种结合了归并排序与插入排序的高性能混合排序算法),因此两者的平均和最坏时间复杂度均为 O(N log N)。
然而在空间复杂度方面,存在本质不同:
sort()在列表原数组上进行元素移动,除了 Timsort 执行过程中所需的极少临时合并缓冲区外,不需要重建列表结构指针,因此其空间效率极高。在处理包含千万级元素的大型数据列表时,能显著减轻内存垃圾回收(GC)的压力。sorted()无论如何都会在堆中创建一个新的PyListObject,并复制所有元素的引用指针。如果原列表占用了数吉字节(GB)的物理内存,在内存紧张的环境中调用sorted()可能直接导致内存溢出(OOM)。
三、辨析关键概念:“倒序排序(降序)”与“位置反转(逆序)”
在中文交流与日常提问中,“倒序”一词经常引起概念混淆。部分初学者容易将“把列表头尾颠倒(反转)”与“按元素数值从大到小重新排列(降序)”混为一谈。在编写业务代码前,必须明确两者的定义差异:
- 位置反转(Reverse / Invert):纯粹依据元素的物理索引下标进行首尾倒置,第一个元素跑到最后,最后一个跑到第一,完全不进行任何值的大小比较。使用的工具是
list.reverse()方法或切片语法list[::-1]。其时间复杂度为线性 O(N)。 - 倒序排序(Descending Sort):必须进行大小比较,按照元素的值由大到小重新确定其在列表中的位置。使用的工具是
list.sort(reverse=True)或sorted(list, reverse=True)。其时间复杂度为 O(N log N)。
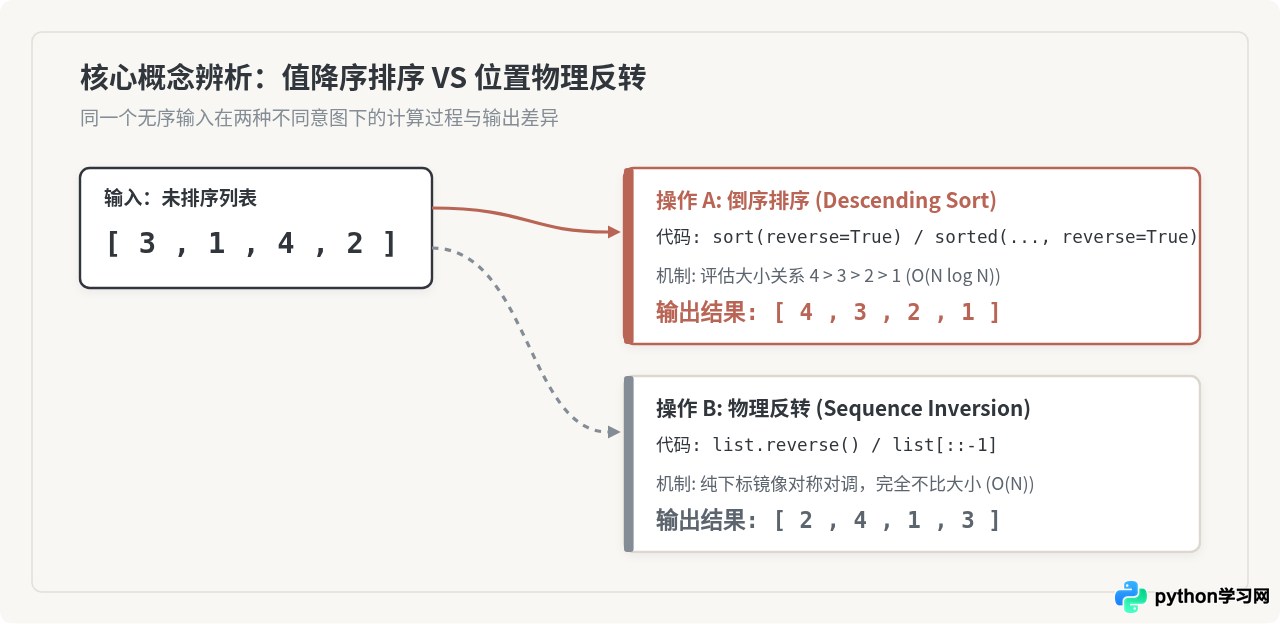
# 代码演示:“位置反转”与“倒序排序”的结果区别
sample = [3, 1, 4, 2]

# 1. 物理位置反转(只翻转索引,不比大小)
rev_list = sample.copy()
rev_list.reverse()
print("物理反转结果:", rev_list)

# 2. 倒序排序(比较大小,由大到小重排)
sorted_list = sorted(sample, reverse=True)
print("倒序排序结果:", sorted_list)倒序排序结果: [4, 3, 2, 1]
四、进阶用法:结合 key 参数实现自定义多维倒序
在真实业务开发中,待排序的列表往往不仅是单纯的整数或浮点数,而是复杂的嵌套字典、类实例对象或包含多字段的元组。sort() 和 sorted() 均支持 key 参数,允许开发者指定一个一元函数,在比较前提取每个元素的特征权重。
1. 字典列表按指定数值字段倒序
假设我们有一组员工信息字典,需要按照年龄(或销售额)从高到低倒序排序:
employees = [
    {"name": "Alice", "age": 28, "sales": 9400},
    {"name": "Bob", "age": 35, "sales": 12800},
    {"name": "Charlie", "age": 24, "sales": 8700},
    {"name": "Diana", "age": 31, "sales": 15600}
]

# 按 sales 销售额从高到低倒序排序
ranked_by_sales = sorted(employees, key=lambda item: item["sales"], reverse=True)

for rank, emp in enumerate(ranked_by_sales, start=1):
print(f"第{rank}名: {emp['name']} - 销售额: {emp['sales']}")第2名: Bob - 销售额: 12800
第3名: Alice - 销售额: 9400
第4名: Charlie - 销售额: 8700
2. 多字段排序:部分升序、部分降序的高级技巧
当需求变得更加复杂,例如:按学生班级升序排列;若班级相同,则按考试成绩降序排列。如果直接传递 reverse=True,会将所有维度一并反转。此时可以利用数值的数学特性(给降序维度加负号 -)来精准控制不同字段的方向:
students = [
    ("一班", "张三", 85),
    ("二班", "李四", 92),
    ("一班", "王五", 95),
    ("二班", "赵六", 88),
    ("一班", "孙七", 95)
]

# 班级升序 (x[0]),若班级相同则成绩倒序 (-x[2])
# 注意:此时外层保持默认 reverse=False,通过 -x[2] 达成局部的倒序效果
students.sort(key=lambda x: (x[0], -x[2]))

for s in students:
print(f"{s[0]} | {s[1]} | 成绩: {s[2]}")一班 | 孙七 | 成绩: 95
一班 | 张三 | 成绩: 85
二班 | 李四 | 成绩: 92
二班 | 赵六 | 成绩: 88
值得注意的是,王五和孙七的成绩同为 95 分。在最终结果中,王五依然排在孙七前面。这得益于 Python 内置 Timsort 算法的稳定性(Stability):当两个元素的排序关键字完全相同时,它们在排序前后的相对顺序绝对不会改变。
五、选型决策指南与常见避坑清单
为了在实际项目中快速、准确地选定最合适的倒序方案,可以参考以下综合决策路径与避坑要点:
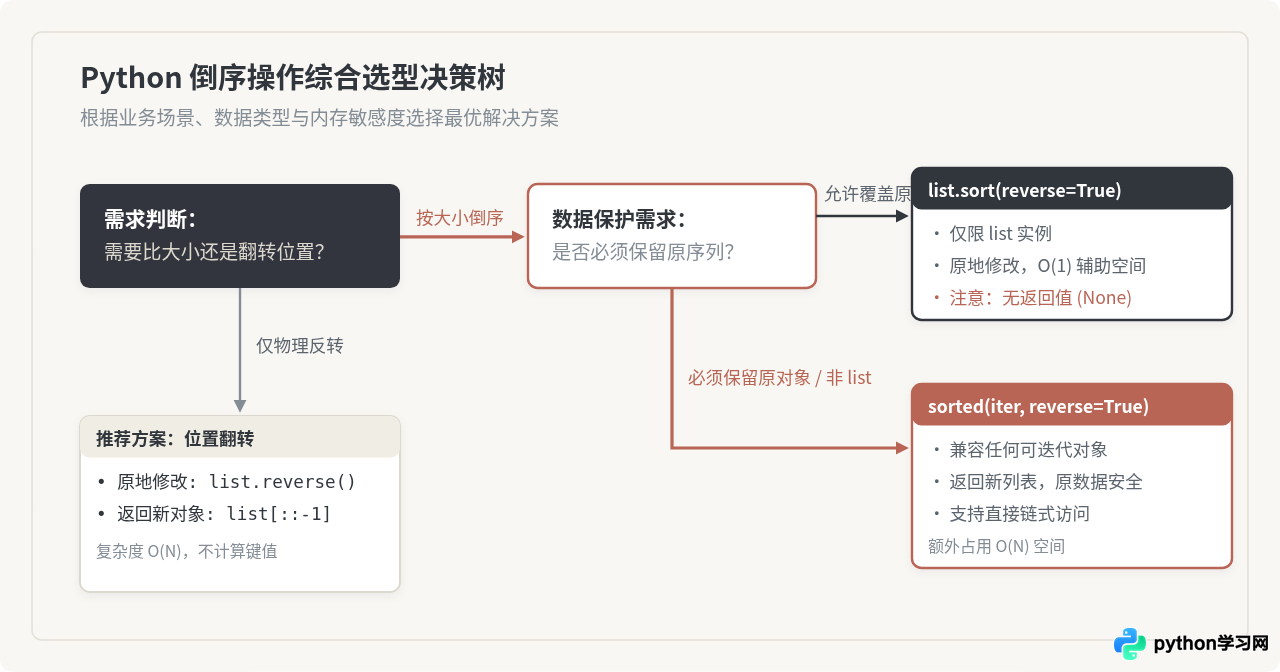
| 对比维度 | list.sort(reverse=True) | sorted(iterable, reverse=True) | list.reverse() |
|---|---|---|---|
| 本质功能 | 按值大小降序重排 | 按值大小降序重排 | 按首尾索引位置逆序 |
| 调用方式 | 列表对象方法 lst.sort() |
内置全局函数 sorted(obj) |
列表对象方法 lst.reverse() |
| 对象适用性 | 仅支持可变列表 list |
支持任何可迭代对象 (元组/集合/字典) | 仅支持可变列表 list |
| 原始对象影响 | 原地覆写,原序丢失 | 无影响,只读访问 | 原地覆写,原序丢失 |
| 返回值 | None |
新建的已排序 list |
None |
| 时间复杂度 | O(N log N) | O(N log N) | O(N) |
| 空间复杂度 | O(1) 额外空间 | O(N) 需新建容器 | O(1) 额外空间 |
开发避坑要点:
- 不可变类型误用
sort():例如对元组tp = (3, 1, 2)执行tp.sort(reverse=True)会直接抛出AttributeError: 'tuple' object has no attribute 'sort'。对于元组、集合、生成器等对象,必须统一使用sorted()。 - Python 3 中的异构类型比较报错:在 Python 2 中,混合类型列表(如
[3, "hello", 1])可以被隐式排序,但在 Python 3 中严禁数字与字符串直接比较,执行时会抛出TypeError: '<' not supported between instances of 'str' and 'int'。进行倒序排序前,请确保列表元素类型一致,或在key中将它们显式转换为可比同类类型。 - 警惕
None的链式调用:常见的严重 Bug 形式如for item in my_list.sort(reverse=True):,这将引发TypeError: 'NoneType' object is not iterable。切记:要原地倒序遍历,先my_list.sort(reverse=True),再for item in my_list:;若要一行写完,请写成for item in sorted(my_list, reverse=True):。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















