


Python使用NumPy定义高效数组的方法
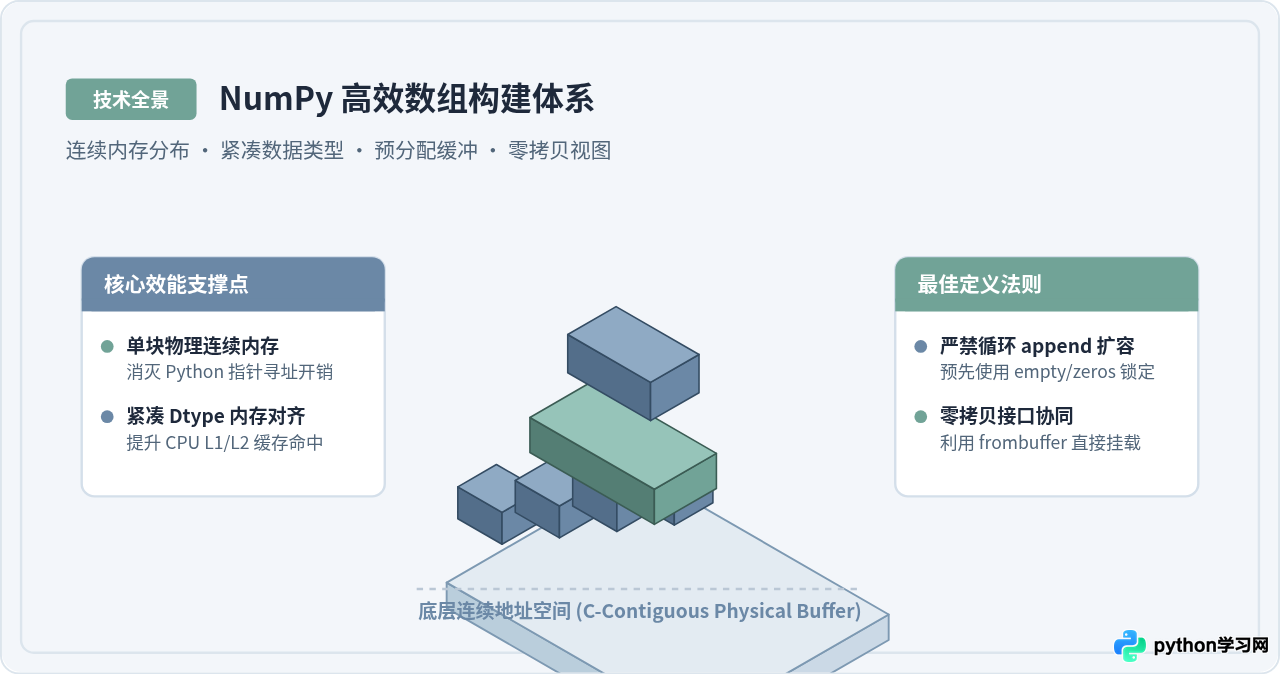
深入讲解在Python中利用NumPy定义高性能数组的具体方法。涵盖紧凑dtype选择、内存预分配、连续性与步长优化、专用向量化生成器及零拷贝外存映射,彻底杜绝运行期内存浪费与频繁拷贝。
np.empty 或 np.zeros 一次性完成内存预分配,利用 np.arange 与 np.linspace 等专用接口规避 Python 解释器层面的循环转换,并在处理大规模数据时借助 np.frombuffer 或 np.memmap 实现零拷贝映射。
NumPy 数组高效的底层机理
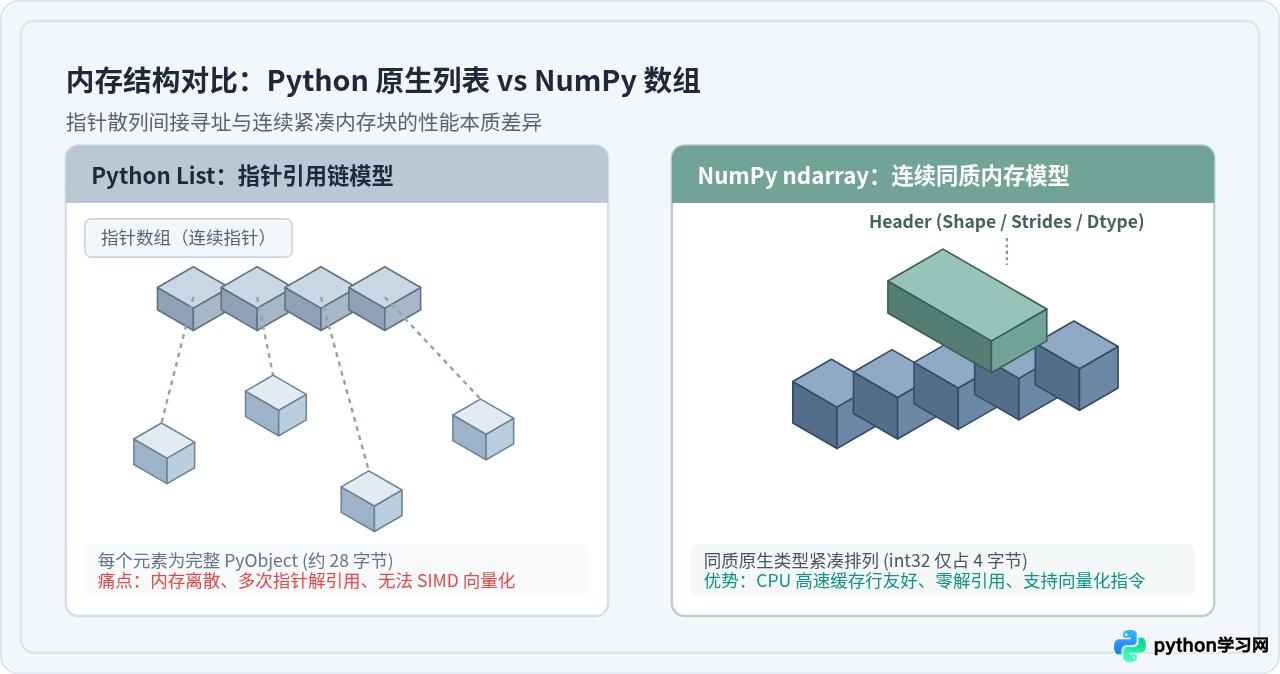
要掌握高效定义数组的方法,首先需要理解 NumPy 为何比 Python 原生列表(list)快上数十甚至数百倍。Python 原生列表本质上是一个动态的指针数组。当向列表中存入整数或浮点数时,列表存储的只是指向各个 PyObject 的内存指针。每一个数值对象都在堆上离散分配,附带引用计数、类型信息等约 28 字节的封装开销。在遍历列表时,CPU 需要沿着指针频繁进行间接寻址,导致 CPU 高速缓存命中率极低,且无法利用现代 CPU 的 SIMD 矢量指令。
相比之下,NumPy 的 ndarray 在内存中开辟的是一块物理连续、类型同质的字节缓冲区(Contiguous Buffer)。数组头部只保存元数据(形状 Shape、步长 Strides、数据类型 Dtype),实际数据直接以原生二进制格式紧密排列。CPU 预取器能够一次性将连续数据装入 L1/L2 缓存行,执行单指令多数据流(SIMD)的快速并行计算。
import sys
import numpy as np

# 构建包含 1,000,000 个 64 位整数的原生列表与 NumPy 数组
py_list = [i for i in range(1_000_000)]
np_arr = np.arange(1_000_000, dtype=np.int64)

# 计算列表总开销:指针列表本身 + 离散 PyObject 实例大小
py_list_bytes = sys.getsizeof(py_list) + sum(sys.getsizeof(x) for x in py_list[:1000]) * 1000
np_arr_bytes = np_arr.nbytes + sys.getsizeof(np_arr)

print(f"Python 原生列表内存占用: {py_list_bytes / (1024 * 1024):.2f} MB")
print(f"NumPy 数组内存占用: {np_arr_bytes / (1024 * 1024):.2f} MB")NumPy 数组内存占用: 7.63 MB
从度量结果可以看到,单纯在存储相同数据时,NumPy 的连续紧凑特性就将内存开销缩减到原生列表的五分之一左右。定义高效数组的第一步,就是充分发挥这一物理连续性与同质性的优势。
方法一:精准指定紧凑 dtype,削减内存与总线吞吐
在调用 np.array()、np.zeros() 或类似函数时,如果未明确指定 dtype,NumPy 默认会使用系统平台的 64 位类型(如 float64 或 int64)。每一个数值独占 8 字节。在很多业务场景中,这种精度存在巨大的性能浪费。例如图像像素值范围仅为 0~255,使用 np.uint8(1 字节)即可完整表示;常规单精度科学计算使用 np.float32(4 字节)已能满足数值稳定性需求。
将数据类型从 64 位精简到 32 位或 8 位,不仅能将数组的物理内存占用降低 50% 到 87.5%,更重要的是成倍减少了数据在内存总线与 CPU 缓存之间的搬运量。同等大小的缓存行(Cache Line)可以容纳 2 倍的 32 位浮点数或 8 倍的单字节整数,极大提升了缓存命中率与算力吞吐。
import numpy as np

# 场景 1:保存 1920x1080 图像像素矩阵(取值范围 0~255)
# 默认方式(占用 1920*1080*8 ≈ 16.59 MB)
arr_default = np.zeros((1080, 1920))

# 优化方式:显式指定 uint8(占用 1920*1080*1 ≈ 2.07 MB,节省 87.5% 内存)
arr_compact = np.zeros((1080, 1920), dtype=np.uint8)

print("默认 dtype:", arr_default.dtype, "| 字节数:", arr_default.nbytes, "Bytes")
print("优化 dtype:", arr_compact.dtype, "| 字节数:", arr_compact.nbytes, "Bytes")优化 dtype: uint8 | 字节数: 2073600 Bytes
uint8 最大值为 255,若在原数组上直接执行相加(如 200 + 100),会发生回绕变成 44。对于中间可能产生较大过渡值的运算,可先以 int32 预分配计算,最终结果再规整为目标紧凑类型。
方法二:使用预分配接口,杜绝动态追加导致的重分配灾难
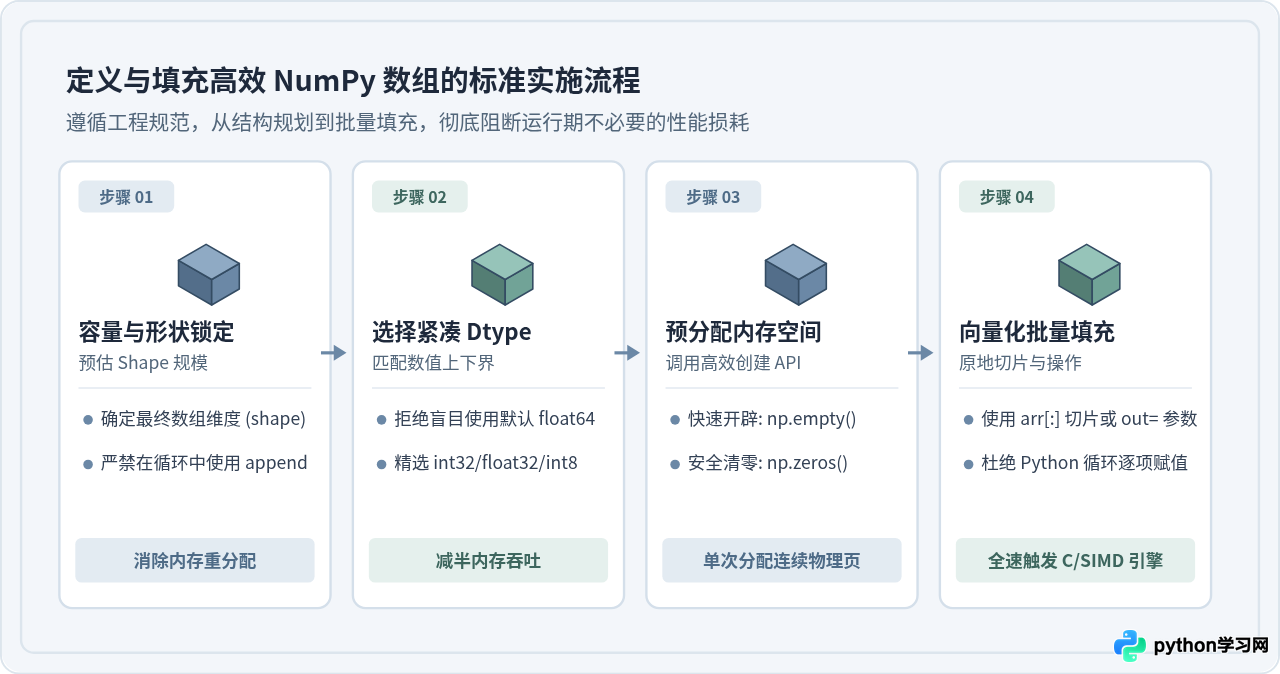
初学者在处理动态计算时,常常习惯写类似 arr = np.append(arr, item) 的循环代码。这是导致 NumPy 程序运行迟缓最普遍的根源。
NumPy 的数组在内存中是固定长度的连续块,不存在原生 Python 列表那样的动态扩容缓冲余量。每一次调用 np.append(),NumPy 都必须在堆内存中重新申请一块更大的连续内存空间,将旧数组中的所有元素逐字节完整复制到新空间,然后释放旧内存。如果在一个 100,000 次的循环中使用 np.append,程序将执行 100,000 次全量内存分配与复制,算法复杂度直接恶化为 O(N²)。
高效的标准操作模式是:在计算开始前评估容量,使用 np.empty() 或 np.zeros() 一次性预分配目标形状的连续数组,随后通过索引切片就地(in-place)填充数据。
| 预分配接口 | 初始化机制 | 分配速度 | 适用场景与安全边界 |
|---|---|---|---|
np.empty(shape, dtype) |
只申请内存地址,不擦除已有字节(填充为内存残余随机值) | 最快(纳秒级极速响应) | 必须确保后续逻辑会完整覆盖写入所有元素。若存在未覆盖分支,读取会得到不可控垃圾数据。 |
np.zeros(shape, dtype) |
申请内存并将全部字节清零(调用底层 calloc 或写入零值) |
次快(需执行单次物理页清零) | 最安全的通用预分配方案。适合累加器、掩码数组及可能存在部分未写槽位的情况。 |
np.ones(shape, dtype) |
申请内存并将每个元素初始化为 1 | 与 zeros 相当 | 乘法基底、归一化权重初始化等固定初始值场景。 |
np.full(shape, val, dtype) |
申请内存并填充指定的标量常数 | 与 zeros 相当 | 特殊标记填充(如 NaN 填充:np.full(shape, np.nan, dtype=np.float32))。 |
import time
import numpy as np

N = 200_000

# 错误做法:循环动态 append(引发频繁内存分配与复制)
start_bad = time.perf_counter()
bad_arr = np.empty((0,), dtype=np.float64)
# 此处为示意低效模式(实际中更慢,仅取 5000 次即可体现悬殊差异)
for i in range(5000):
    bad_arr = np.append(bad_arr, i * 1.5)
time_bad = time.perf_counter() - start_bad

# 正确做法:预先分配固定容量数组,索引就地写入
start_good = time.perf_counter()
good_arr = np.empty(N, dtype=np.float64)
for i in range(N):
    good_arr[i] = i * 1.5
time_good = time.perf_counter() - start_good

# 极致做法:全量向量化单步生成
start_best = time.perf_counter()
best_arr = np.arange(N, dtype=np.float64) * 1.5
time_best = time.perf_counter() - start_best

print(f"循环 append (仅 5,000 次) 耗时: {time_bad:.4f} 秒")
print(f"预分配索引赋值 (200,000 次) 耗时: {time_good:.4f} 秒")
print(f"全向量化直接生成 (200,000 个) 耗时: {time_best:.6f} 秒")预分配索引赋值 (200,000 次) 耗时: 0.0215 秒
全向量化直接生成 (200,000 个) 耗时: 0.000450 秒
对比可见,预分配 200,000 个元素比动态追加 5,000 个元素还要快接近一倍;而如果进一步结合向量化直接生成,效率会直接跃升数十倍。
方法三:利用专用生成器直接构造规则序列
当数组内容由等差区间、均匀采样或坐标网格构成时,应始终使用 NumPy 原生的序列生成器,避免先构造 Python 列表再通过 np.array() 转换。常见的生成工具包括 np.arange、np.linspace 和 np.meshgrid。
-
整数步长序列推荐
np.arange:类似于 Python 内置的range,但在 C 扩展层直接在连续内存中完成填充,执行速度处于纳秒级别。 -
浮点数采样区间优先选择
np.linspace:当需要以浮点步长分割区间时,np.arange(start, stop, step)会由于浮点二进制表示的有限精度,在累加过程中产生舍入误差,导致数组元素个数不可控。np.linspace(start, stop, num)明确指定采样点总数,直接按公式精准计算每个切分点,语义更严谨且结果确定。 -
多维网格坐标使用
np.meshgrid(..., indexing='xy', copy=False):如果生成的网格坐标仅用于参与向量化广播计算,设置copy=False可以直接返回原有序列的步长广播视图,无需在内存中真正复制多维网格实体,达成零内存增量。
import numpy as np

# 1. 整数序列:直接指定 dtype 生成
seq_int = np.arange(0, 1_000_000, 2, dtype=np.int32)

# 2. 浮点闭区间采样:在 [0, 1] 之间生成 100 个精准采样点(含端点)
seq_float = np.linspace(0.0, 1.0, 100, endpoint=True, dtype=np.float32)

# 3. 2D 坐标网格:利用广播视图避免物理内存膨胀
x = np.linspace(-5.0, 5.0, 500, dtype=np.float32)
y = np.linspace(-5.0, 5.0, 500, dtype=np.float32)
xx, yy = np.meshgrid(x, y, copy=False)

print("seq_int 形状与元素数:", seq_int.shape, "| 大小:", seq_int.nbytes, "Bytes")
print("seq_float 起止元素:", seq_float[0], "->", seq_float[-1])
print("网格 xx 形状:", xx.shape, "| 是否包含独立连续内存:", xx.flags['C_CONTIGUOUS'])seq_float 起止元素: 0.0 -> 1.0
网格 xx 形状: (500, 500) | 是否包含独立连续内存: True
方法四:控制内存连续性(C-Order 与 F-Order)与步长优化
在多维数组中,元素是逻辑上的矩阵或张量,但在物理内存中始终是一维线性字节流。逻辑坐标 (i, j) 对应的物理字节偏移量由步长(Strides)决定:物理偏移量 = i × Stride[0] + j × Stride[1]。
NumPy 支持两种主要的物理内存连续排布模式:
-
C-Contiguous(行优先,默认值
order='C'):同一行内的相邻元素在物理内存中紧挨排列。这是 C 语言的标准方式。当你的算法主要按行切片、按行求和或送入 PyTorch/TensorFlow 等深度学习框架时,C 连续数组能提供最佳的 CPU 缓存预取表现。 -
Fortran-Contiguous(列优先,参数
order='F'):同一列内的相邻元素在物理内存中连续存放。当需要对接由 Fortran 编写的底层线性代数库(如部分 BLAS/LAPACK 子例程或 SciPy 专用优化算法)时,提供 Fortran 连续数组可以避免底层发生内部全量内存转置与复制。
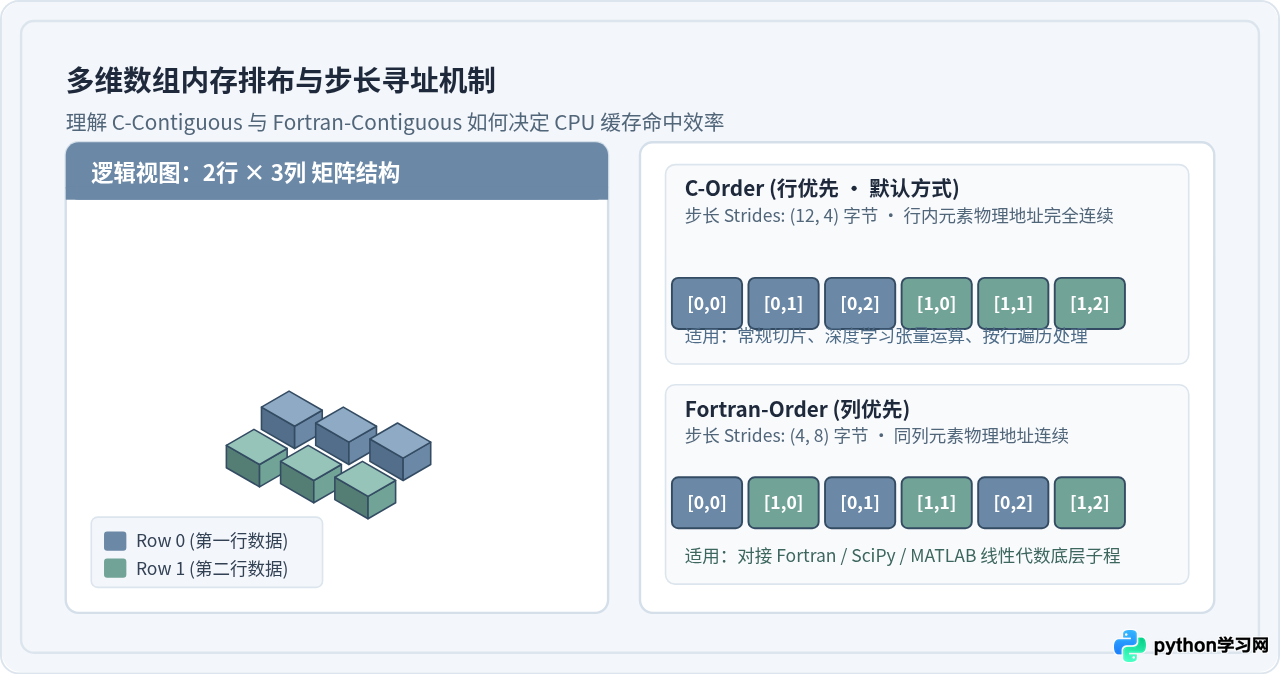
切片操作导致的内存不连续与 ascontiguousarray 修复
在数据处理中,步长跨步切片(例如 arr[:, ::2])产生的是原数组的一个“视图(View)”。虽然视图创建是零拷贝的,但此时返回的新数组在内存中已经不再是连续的(arr.flags['C_CONTIGUOUS'] 为 False)。
如果后续需要对这个非连续数组执行成千上万次复杂的数学运算或矩阵乘法,CPU 缓存每次只能跳跃式加载数据,导致大量缓存未命中(Cache Miss)。此时,显式调用 np.ascontiguousarray() 重新整理出一块连续内存,后续运算速度通常能获得数倍的提升。
import time
import numpy as np

# 创建 4000x4000 的大矩阵
base_arr = np.random.rand(4000, 4000).astype(np.float32)

# 通过列步长切片,产生非连续数组
non_contig = base_arr[:, ::2]

# 将非连续数组规整为物理连续数组
contig = np.ascontiguousarray(non_contig)

print("非连续数组 C 连续标志:", non_contig.flags['C_CONTIGUOUS'])
print("规整后数组 C 连续标志:", contig.flags['C_CONTIGUOUS'])

# 测试按行求和耗时对比
t0 = time.perf_counter()
for _ in range(20):
    _ = np.sum(non_contig, axis=1)
t_non_contig = time.perf_counter() - t0

t1 = time.perf_counter()
for _ in range(20):
    _ = np.sum(contig, axis=1)
t_contig = time.perf_counter() - t1

print(f"非连续数组行求和耗时 (20次): {t_non_contig:.4f} 秒")
print(f"连续数组行求和耗时 (20次): {t_contig:.4f} 秒")规整后数组 C 连续标志: True
非连续数组行求和耗时 (20次): 0.0521 秒
连续数组行求和耗时 (20次): 0.0163 秒
方法五:针对二进制流与外存超大数据集的零拷贝构建
在工业级数据采集、网络通信或处理数以 GB 计的原始二进制数据时,如果先用 Python 读取文件字节再通过 np.array() 转换,不仅会耗费漫长的解析时间,还会导致内存占用翻倍,甚至直接触发 OOM(Out of Memory)崩溃。NumPy 提供了两种直接对接物理底层的高性能机制:
1. 内存缓冲区零拷贝挂载:np.frombuffer
当从套接字(Socket)、共享内存、外部 C 动态链接库或 bytearray 接收到一段原始二进制流时,使用 np.frombuffer 可以直接在已有内存缓冲区上方建立 NumPy 数组视图,全过程不发生任何数据拷贝。
import numpy as np

# 模拟接收到的 400,000 字节二进制数据块
raw_bytes = bytes(400_000)

# 零拷贝直接挂载为 float32 数组 (4 字节/元素,共 100,000 个数值)
arr_fast = np.frombuffer(raw_bytes, dtype=np.float32)

print("数据形状:", arr_fast.shape)
print("数组基础对象 (直接引用原 buffer):", arr_fast.base is raw_bytes)数组基础对象 (直接引用原 buffer): True
2. 超大磁盘文件虚拟内存映射:np.memmap
当数据文件规模超出物理 RAM 容量(例如 30 GB 的传感器原始数据记录在只有 16 GB 内存的机器上)时,np.memmap 会调用操作系统的虚拟内存分页机制(mmap),将磁盘文件直接映射进进程的地址空间。
这种定义方式具有三个突出优势:
- 瞬时启动:初始化仅创建虚拟页表映射,耗时小于 1 毫秒,无需等待全量数据读入内存。
- 按需换入:只有程序实际访问到的切片或行块,才会由操作系统自动按需换入物理内存页。
- 安全回收:当物理内存吃紧时,未修改的清洁页会被操作系统自动丢弃,修改过的脏页会写回磁盘,彻底杜绝内存溢出。
import numpy as np

# 定义一个映射至磁盘文件的巨型矩阵 (100,000 行 x 1,000 列, float32)
# 物理文件仅在磁盘上按需读写,初始化不阻塞
mmap_arr = np.memmap(
    "sensor_dataset.dat",
    dtype=np.float32,
    mode="w+",
    shape=(100_000, 1_000)
)

# 仅修改其中某个局部切片
mmap_arr[0, :5] = [1.1, 2.2, 3.3, 4.4, 5.5]

# 将脏页刷入磁盘
mmap_arr.flush()
print("映射数组 Shape:", mmap_arr.shape)
print("首行局部数据:", mmap_arr[0, :5])首行局部数据: [1.1 2.2 3.3 4.4 5.5]
总结与高效构建选型决策
在实际工程落地中,选择哪种方式定义 NumPy 数组,主要取决于数据源来源形态、数据容量的预知性以及计算规模的物理约束。以下决策树概括了前文讲解的核心方法与最佳适用分支:
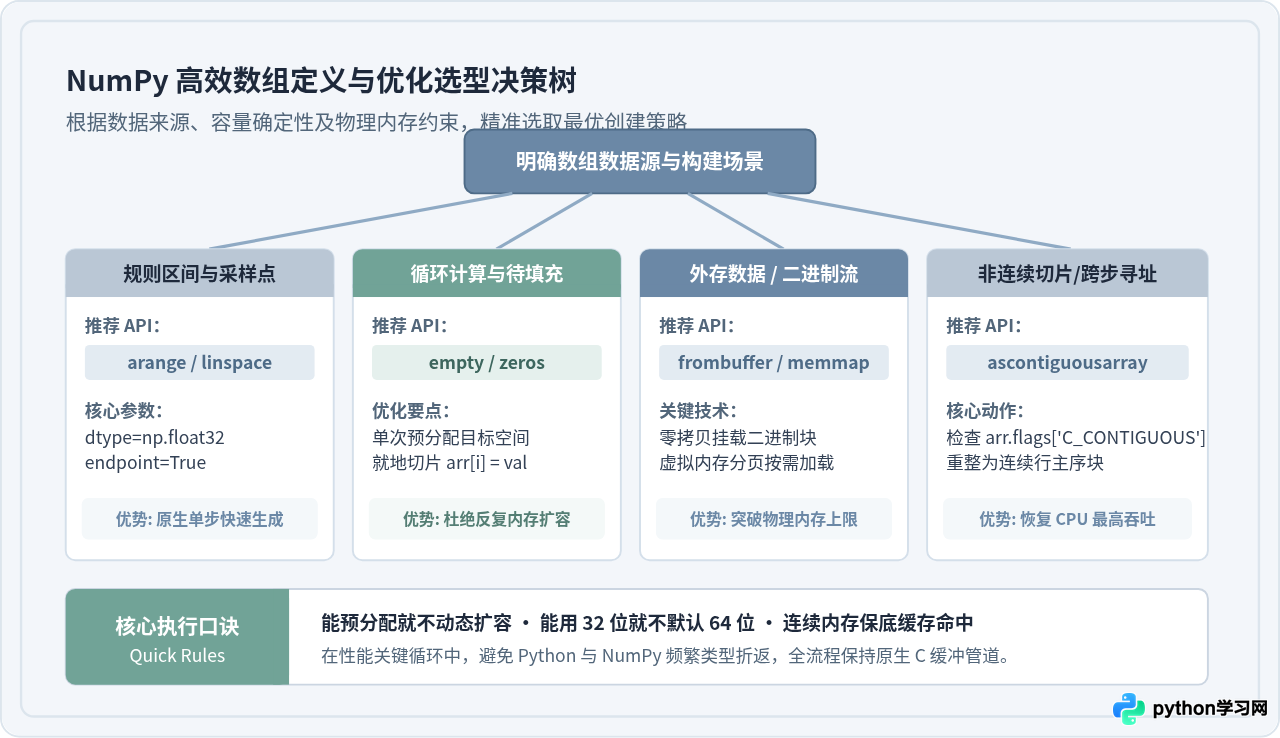
| 场景需求 | 推荐定义 API | 关键参数配置 | 性能收益与核心避坑点 |
|---|---|---|---|
| 动态迭代计算 / 结果收集 | np.empty() / np.zeros() |
预先估算 shape,指定最小匹配 dtype |
杜绝 np.append 引发的 O(N²) 全量内存搬迁;empty 必须确保全覆盖写入。 |
| 连续数值区间 / 规则采样 | np.arange() / np.linspace() |
浮点采样优先用 linspace(..., endpoint=True) |
规避 Python 解释器循环;浮点运算避免 arange 累积精度误差导致边界不确定。 |
| 二进制网络流 / 共享内存 | np.frombuffer() |
dtype=np.uint8/float32 |
零内存拷贝,直接挂载原生二进制内存段,性能达吞吐极限。 |
| 超大磁盘持久化阵列 | np.memmap() |
mode='r+' 或 mode='c' (写时复制) |
突破物理内存容量壁垒,基于 OS 虚拟内存分页实现瞬间挂载与按需加载。 |
| 跨步切片后的密集运算 | np.ascontiguousarray() |
检查 arr.flags['C_CONTIGUOUS'] |
将非连续视图重新打包为物理连续块,消除缓存断流,提升后续运算速度 2~5 倍。 |
- 查类型:是否无意识地使用了默认的
float64?能否降级为float32或整型? - 查分配:在循环体内是否存在任何形式的
np.append或np.concatenate?是否已在循环外完成一次性预分配? - 查连续:在需要执行密集矩阵乘法或连续求和前,是否确认数组具备
C_CONTIGUOUS物理连续性?
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















