


Python 实现周期性定时任务:Timer 递归调用示例
深入讲解在 Python 中利用标准库 threading.Timer 递归调用实现周期性定时任务的完整方案,涵盖底层机制、基础代码、线程安全可取消的面向对象封装、时间漂移分析及技术选型对比。
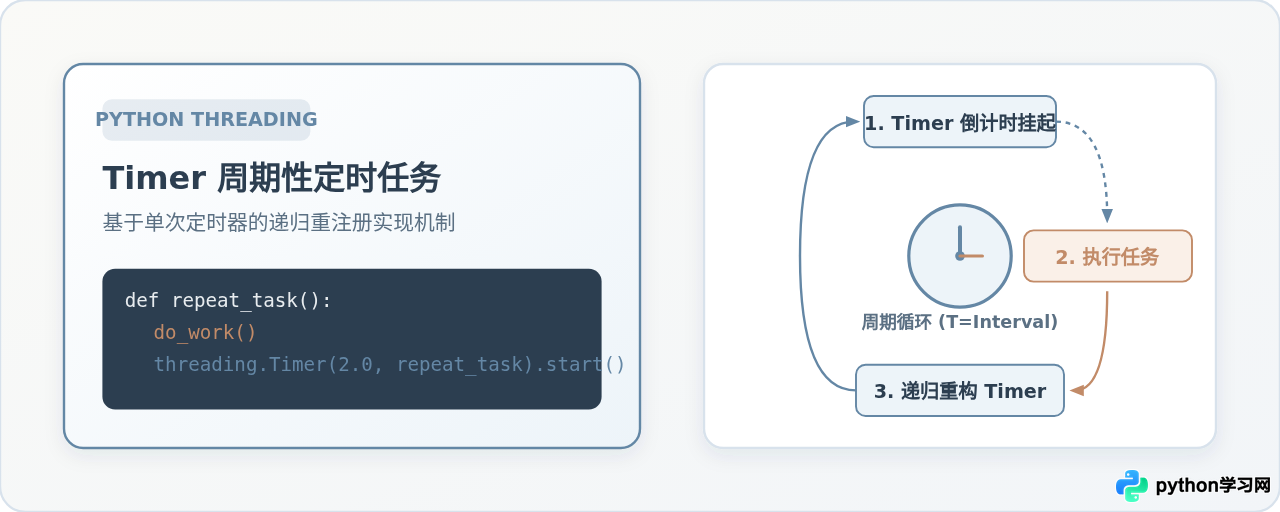
threading.Timer 本质上是一个单次延迟执行的定时器线程。当我们需要在无需引入外部第三方依赖(如 APScheduler 或 Celery)的前提下实现周期性执行逻辑时,最常见且标准的技术路径就是在任务回调函数内部递归创建并启动下一个 Timer 实例。本文通过完整的代码示例、执行生命周期控制以及误差漂移分析,全面梳理该方案的落地细节与工程注意事项。
一、threading.Timer 的运行机制:为什么它默认是单次的?
要正确使用 threading.Timer 实现周期任务,首先必须明确它的内部实现结构。翻阅 Python 源码可知,Timer 是 threading.Thread 的直接子类。在调用 Timer(interval, function) 时,它创建了一个独立的子线程,并在其内部封装了一个 threading.Event 对象。
当执行 timer.start() 时,子线程启动并在其 run() 方法内调用 self.finished.wait(self.interval)。如果在此期间定时器没有被显式取消,等待超时后便会执行传入的目标函数。
关键在于:目标函数一旦执行完毕,该线程的 run() 方法随即执行结束,线程便不可逆地转入终止状态(Dead)。由于 Python 明确规定同一个 Thread 实例无法被重复 start(),再次调用会直接抛出 RuntimeError("threads can only be started once")。因此,想要让任务持续发生,就必须在每一轮触发后实例化一个全新的 Timer 线程,形成链式接力。
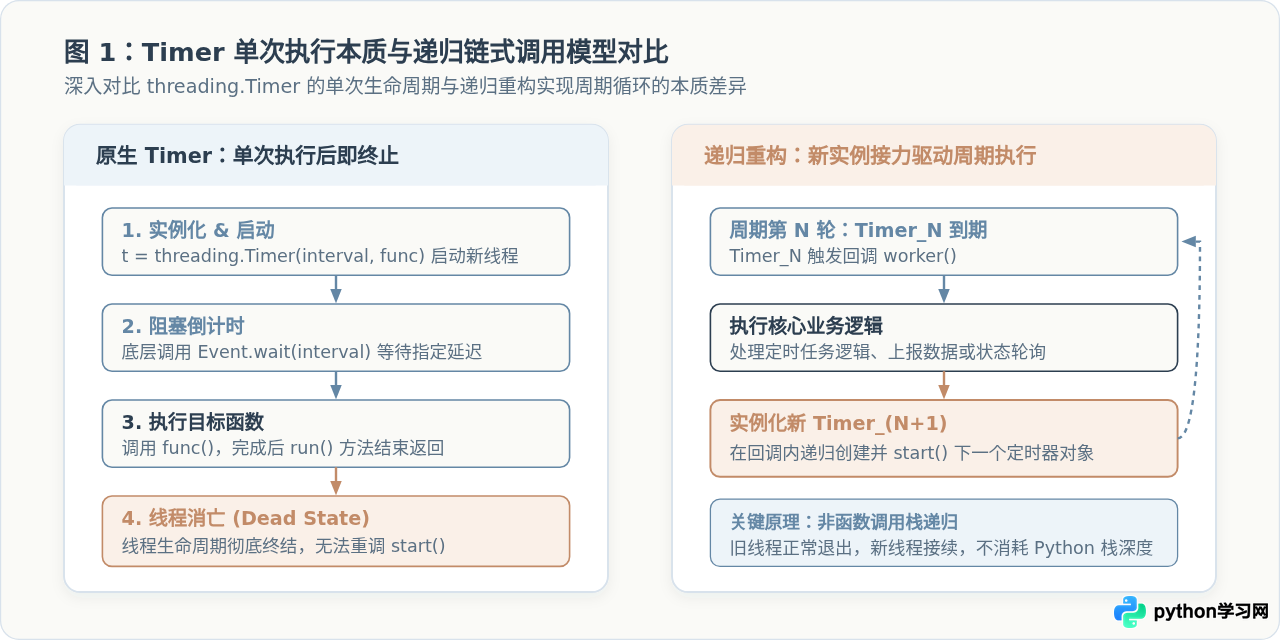
值得强调的是,这里的“递归”并非同一执行栈上的函数深层嵌套,而是“跨线程的对象重新实例化”。当第 N 轮回调触发时,前一个线程已完成使命并正常被垃圾回收器释放,新线程独立启动,因此不会发生普通递归常见的栈溢出(RecursionError)问题。
二、基础递归调用的完整代码与运行剖析
掌握了实例重构的逻辑后,我们可以先编写一个最基础的函数式递归调用示例。该示例每隔 2 秒打印一次当前时间戳与当前活跃线程数:
import threading
import time

def periodic_worker():
    # 打印当前时间与线程信息
    current_time = time.strftime("%H:%M:%S")
    active_threads = threading.active_count()
    print(f"[示例输出] 时间: {current_time} | 正在执行周期任务 | 活跃线程数: {active_threads}")

    # 关键步骤:在函数末尾重新实例化 Timer,并设置 2.0 秒后再次调用自身
    next_timer = threading.Timer(2.0, periodic_worker)
    next_timer.start()

if __name__ == "__main__":
    print("[示例输出] 主程序启动,准备开启定时任务...")
    # 首次触发
    periodic_worker()

    # 主线程继续执行其他非阻塞业务
    print("[示例输出] 主线程已从启动逻辑返回,定时任务在后台子线程持续运转。")
上述脚本在终端运行后的输出过程如下:
[示例输出] 主程序启动,准备开启定时任务...
[示例输出] 时间: 10:20:00 | 正在执行周期任务 | 活跃线程数: 2
[示例输出] 主线程已从启动逻辑返回,定时任务在后台子线程持续运转。
[示例输出] 时间: 10:20:02 | 正在执行周期任务 | 活跃线程数: 2
[示例输出] 时间: 10:20:04 | 正在执行周期任务 | 活跃线程数: 2
[示例输出] 时间: 10:20:06 | 正在执行周期任务 | 活跃线程数: 2
通过输出可以看出,活跃线程数始终保持在 2(主线程 + 唯一的当前活跃 Timer 线程),这印证了上一节的分析:每一轮旧的 Timer 线程都会顺利销毁,不会产生线程泄漏。
next_timer 都是函数局部的局部变量,外部没有持久化的引用句柄,当主程序需要优雅退出时,无法对后台正在倒计时的定时器调用 cancel(),往往会导致进程无法退出或被强制杀掉。
三、生产级封装:面向对象、优雅退出与守护线程
为了解决生命周期控制、线程安全与安全取消的问题,我们需要将递归逻辑封装为一个独立的类。通过结合 threading.Event 状态标记与互斥锁,可以提供标准且安全的 start() 与 stop() 接口。
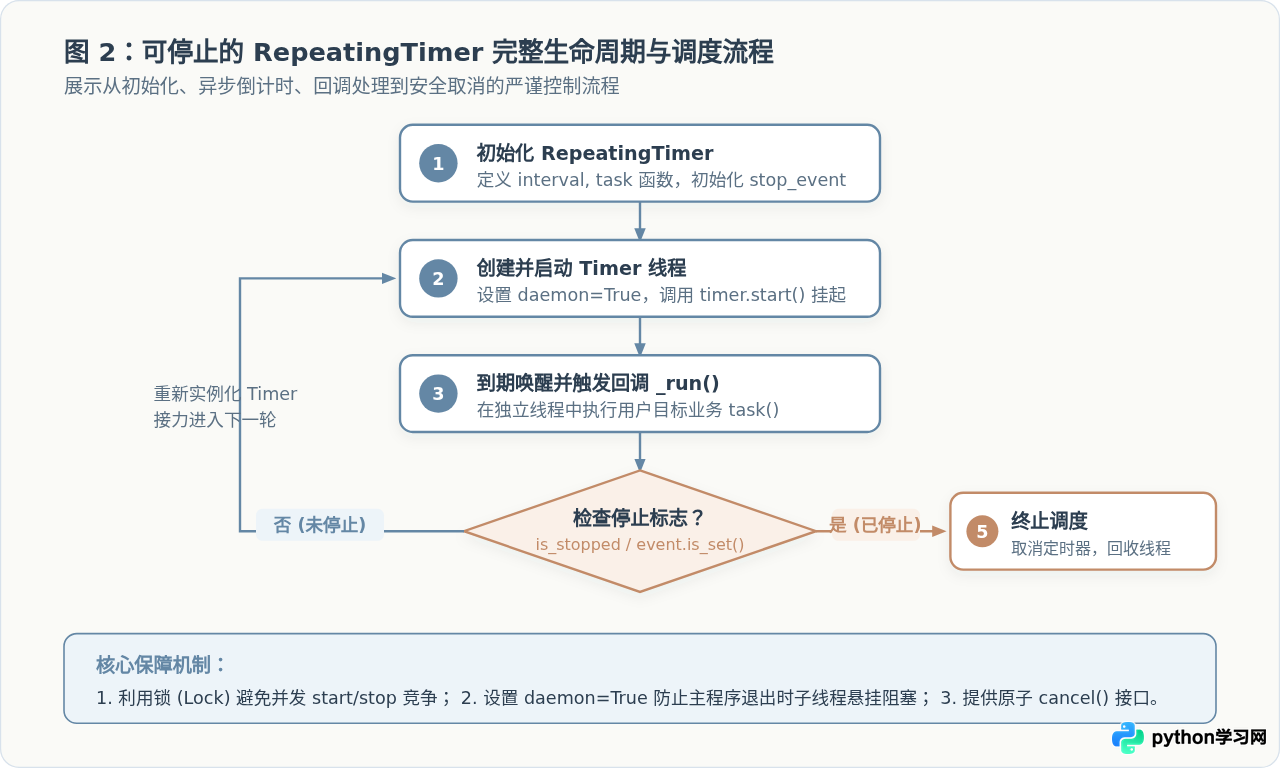
以下为工业级实现代码:
import threading
import time

class RepeatingTimer:
    # 基于 threading.Timer 递归机制的周期性定时器封装
    # 支持安全启停、传参、守护线程及线程安全保护
    def __init__(self, interval, function, *args, **kwargs):
        self.interval = interval
        self.function = function
        self.args = args
        self.kwargs = kwargs
        self.timer = None
        self._is_running = False
        self._lock = threading.Lock()

    def _run(self):
        # 线程安全地判断当前是否仍在运行中
        with self._lock:
            if not self._is_running:
                return
            # 立即规划下一轮定时器(采用前置规划,减少执行时间影响)
            self._schedule_next()

        # 在锁外执行具体的业务函数,防止业务耗时阻塞锁
        try:
            self.function(*self.args, **self.kwargs)
        except Exception as e:
            print(f"[错误提醒] 定时任务执行发生未捕获异常: {e}")

    def _schedule_next(self):
        self.timer = threading.Timer(self.interval, self._run)
        # 设置守护线程,主进程退出时该线程不阻止进程销毁
        self.timer.daemon = True
        self.timer.start()

    def start(self):
        with self._lock:
            if not self._is_running:
                self._is_running = True
                self._schedule_next()

    def stop(self):
        with self._lock:
            self._is_running = False
            if self.timer is not None:
                self.timer.cancel()
                self.timer = None

# 使用验证示例
def sample_task(task_name):
    now = time.strftime("%H:%M:%S")
    print(f"[示例输出] [{now}] 任务「{task_name}」执行完毕")

if __name__ == "__main__":
    print("[示例输出] 初始化周期定时器,间隔为 1.5 秒...")
    timer_worker = RepeatingTimer(1.5, sample_task, "数据心跳同步")
    timer_worker.start()

    # 主程序模拟工作 5 秒后主动停止定时器
    time.sleep(5.0)
    print("[示例输出] 主程序发出停止指令...")
    timer_worker.stop()
    print("[示例输出] 定时器已成功注销,主线程安全结束。")
在上述实现中,包含了三项关键的鲁棒性设计:
- daemon 属性设置:
self.timer.daemon = True确保当主程序收到 SIGINT(如 Ctrl+C)或主线程退出时,不会因为后台存在非守护定时器线程而僵死。 - 互斥锁与状态解耦:在修改
self._is_running与重新创建 Timer 时加锁,杜绝多线程同时调用start()引发的多重实例泛滥;同时在锁外执行self.function(),保证业务逻辑的长耗时不会导致锁争用。 - 异常隔离保护:在
_run()中添加try...except,避免单次业务异常抛出直接击溃调度链条,确保后续周期任务仍能如期进行。
四、关键陷阱分析:执行耗时与时间累积漂移(Time Drift)
在周期性任务的工程落地中,开发者最容易忽视的问题就是时间漂移(Time Drift)。时间漂移是指实际触发时间点随着运行周期的累加,逐渐偏离理论规划时刻的现象。
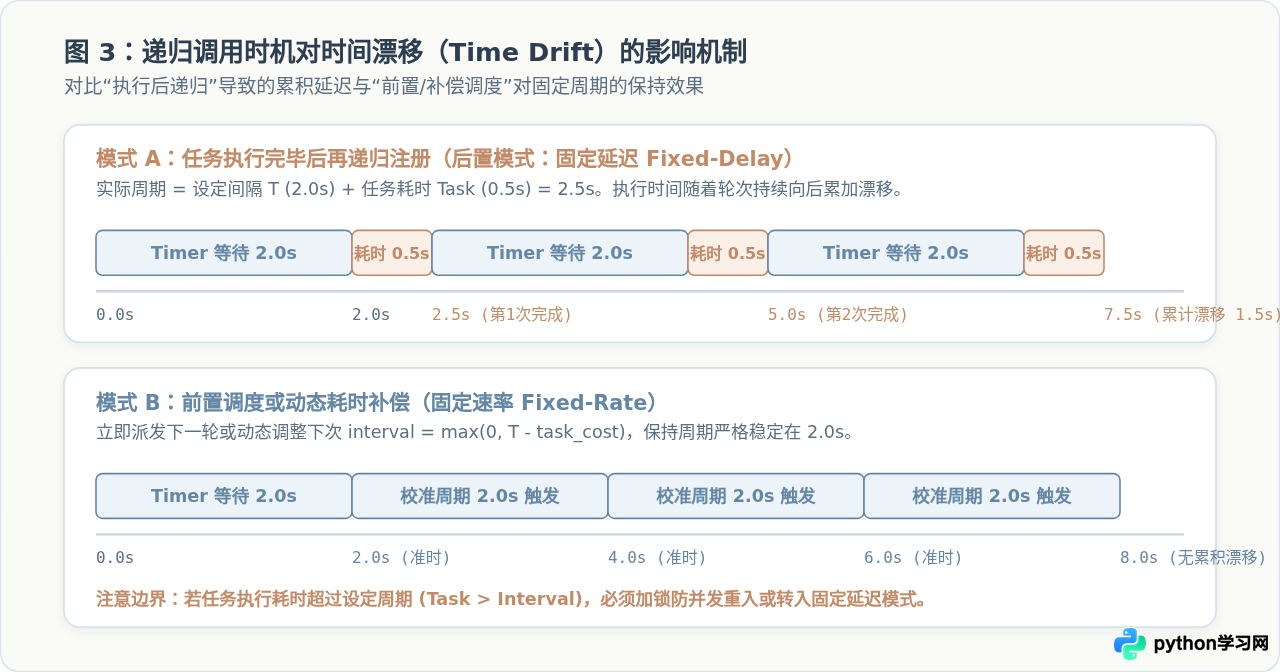
1. 后置注册模式(Fixed-Delay)
若把 threading.Timer(interval, _run).start() 放在目标业务函数执行完成之后,那么每两次任务触发之间的时间差实际为:
实际间隔 = 设定等待时长 (T) + 业务逻辑实际耗时 (T_work)
假设设定周期为 2.0 秒,而业务逻辑耗时 0.5 秒,则实际触发间隔为 2.5 秒。执行 10 轮后,累计时间将比预期落后整整 5 秒。这种模式适用于“必须保证两次操作之间具有固定休眠冷却期”的场景(例如爬虫请求防频控)。
2. 前置注册模式(Fixed-Rate)与防重入边界
若要求尽量贴近“每隔固定时间执行一次”,通常会在触发回调后先调度下一轮 Timer,再执行当前业务代码(如第三节的实现)。但必须注意前置注册的边界限制:
- 如果业务执行耗时
T_work < Interval,下一次触发时当前任务已结束,系统运行平稳且无累积时间漂移; - 但如果遇到网络波动或复杂计算,导致
T_work > Interval,前置调度的下一轮 Timer 线程会在上一轮尚未完成时直接启动,造成并发执行与重入冲突。
因此,若任务耗时波动较大且不能并发执行,应当在业务函数入口添加锁机制(例如 threading.Lock(blocking=False) 尝试加锁,若已被占用则跳过本轮),或者在后置模式下动态测量耗时并计算补偿时间:next_delay = max(0.0, Interval - elapsed_time)。
五、方案边界与技术选型建议
尽管 threading.Timer 递归调用在轻量级脚本中表现优异,但在复杂系统中,Python 提供了多种不同的定时与周期调度方案。了解各方案的适用边界有助于在架构设计时作出准确判断。
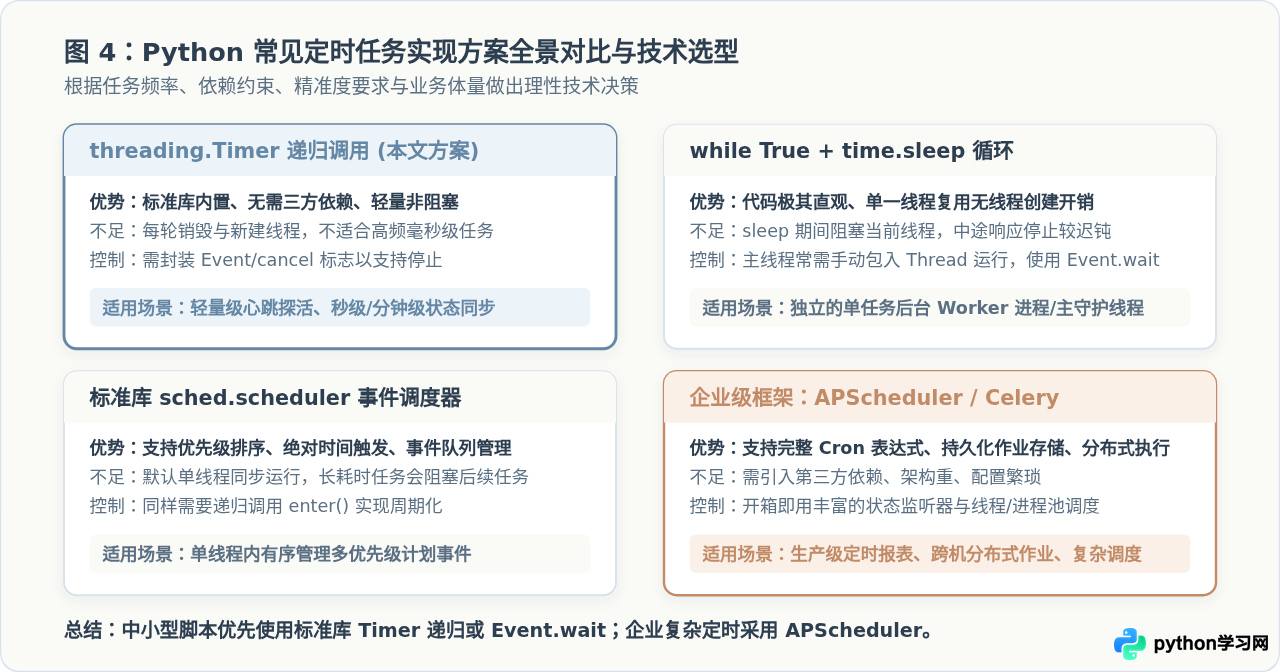
| 实现方案 | 依赖库 | 线程模型 | 精度与开销 | 典型适用场景 |
|---|---|---|---|---|
| threading.Timer 递归 | 标准库内置 | 每轮新建/销毁子线程 | 秒级精度;每轮有轻微线程创建开销 | 单任务状态巡检、心跳包上报、轻量无依赖工具脚本 |
| while True + Event.wait | 标准库内置 | 单一长驻后台工作线程 | 毫秒级/秒级;单线程循环无创建开销 | 单一后台 Worker 服务、连续数据流拉取 |
| sched.scheduler | 标准库内置 | 单线程事件表(需自行调度) | 支持绝对时间与优先级;同步阻塞 | 单线程内多事件优先级排队、轻量计划表 |
| APScheduler | 第三方库 | 线程池 / 进程池 / 异步集成 | 企业级精度;支持 Cron 表达式与持久化 | 多任务系统、企业定时报表、复杂日历规则调度 |
总结而言:
- 对于开发轻量级独立小工具、守护进程内部的心跳监测、秒级周期数据同步,使用
threading.Timer递归封装是成本最低、最干净的方案。 - 如果对极高频(毫秒级)有要求,应优先考虑基于单个线程复用的
threading.Event.wait(timeout)循环,避免反复创建线程的系统调用损耗; - 若需要支持复杂的 Cron 规则(如每天凌晨 2 点执行)、任务持久化存储或并发作业编排,建议直接引入
APScheduler。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















