


学会Python爬虫对求职数据分析岗位有哪些实际帮助
深入解析掌握Python爬虫技能对求职数据分析岗位的实际价值,涵盖项目差异化构建、真实数据ETL清洗能力强化、面试业务闭环展现以及合理的学习技术边界。
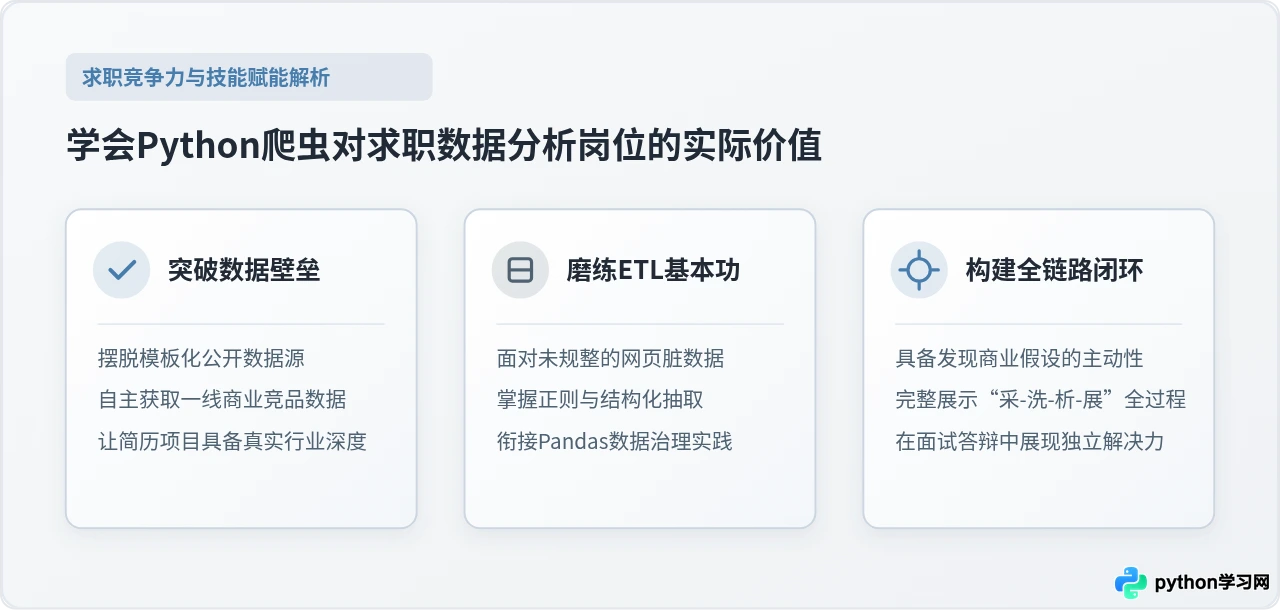
一、突破数据源限制:构建差异化的高质量求职项目
多数初级求职者或转行人员在准备项目作品集时,主要依赖Kaggle、天池或经典教程中的开源数据集,如波士顿房价、泰坦尼克号生还预测、经典的电商开源购买日志等。这些数据集在招聘市场中已被成百上千份简历反复套用,面试官早已产生审美疲劳。更为关键的是,开源公开数据集大多经过了官方的清洗与标准化,字段定义高度规整,无法真实反映求职者应对现实业务中脏数据与非标准化结构的处理能力。
掌握Python爬虫后,求职者能够根据目标应聘企业的行业属性,主动采集外部真实数据来设计专属分析课题。例如,应聘电商或零售行业,可以定向爬取特定商品品类的价格趋势、促销活动记录与用户差评文本;应聘招聘平台或人力咨询,可以抓取不同城市某类技术岗位的技能需求词频与薪资分布;应聘房产或本地生活,可以采集特定区域的二手房挂牌周期与降价动态。
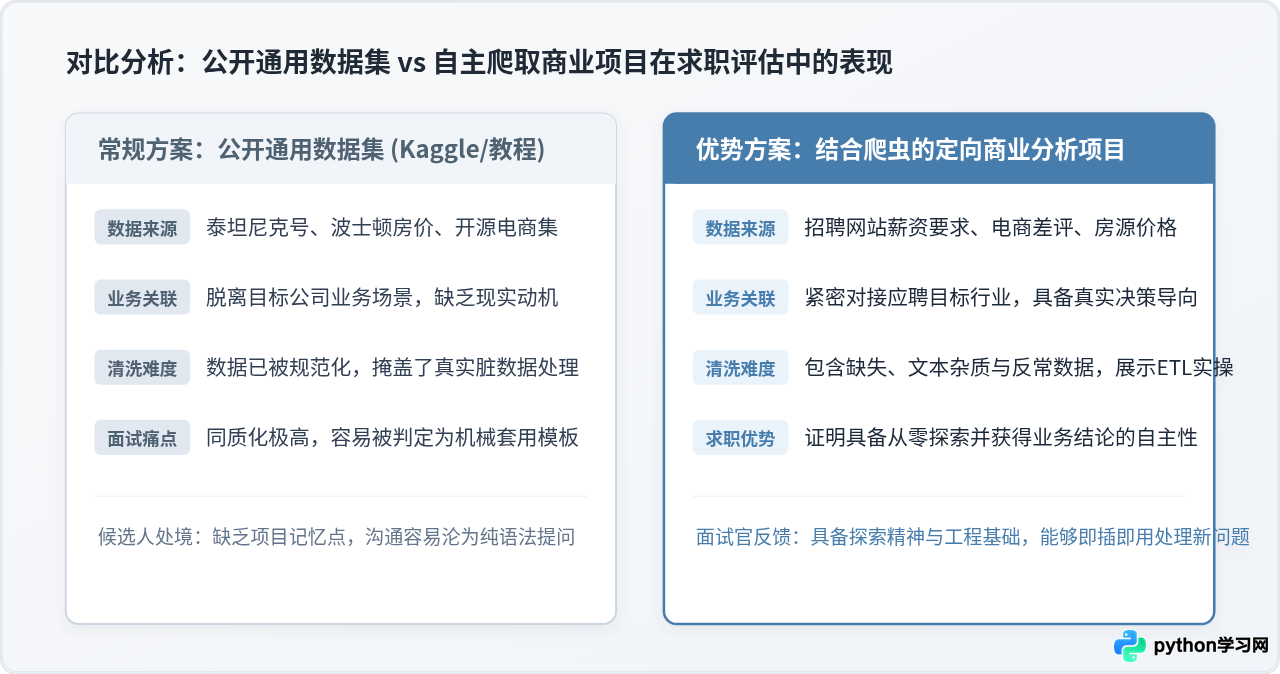
自主获取的数据能够天然体现求职者的行业针对性与求职诚意。当面试官询问“为什么会选择这个分析主题”时,拥有爬虫项目的候选人可以清晰阐述自身如何从业务观察出发定义问题、如何寻找目标网页、如何克服字段缺失完成分析,这种主动探索能力往往比单纯罗列算法模型更具说服力。
二、夯实ETL基本功:在网络数据治理中掌握实战级清洗技能
数据分析日常工作中超过60%甚至70%的精力消耗在数据获取与清洗整理(ETL)环节。从数据库中导出规范表格是理想状态,而在跨部门协同、外部市场调研或竞品跟踪中,分析师常常面对的是格式混乱、存在缺失值、特殊编码及嵌套文本的原始资料。
网页和接口返回的数据是最典型的非结构化与半结构化数据。在编写爬虫的过程中,求职者必然经历将HTML DOM节点或嵌套深层次JSON转化为规范二维表格的过程。这一过程强迫求职者熟练掌握正则表达式、字符串截断、字典遍历以及Pandas数据治理方法。
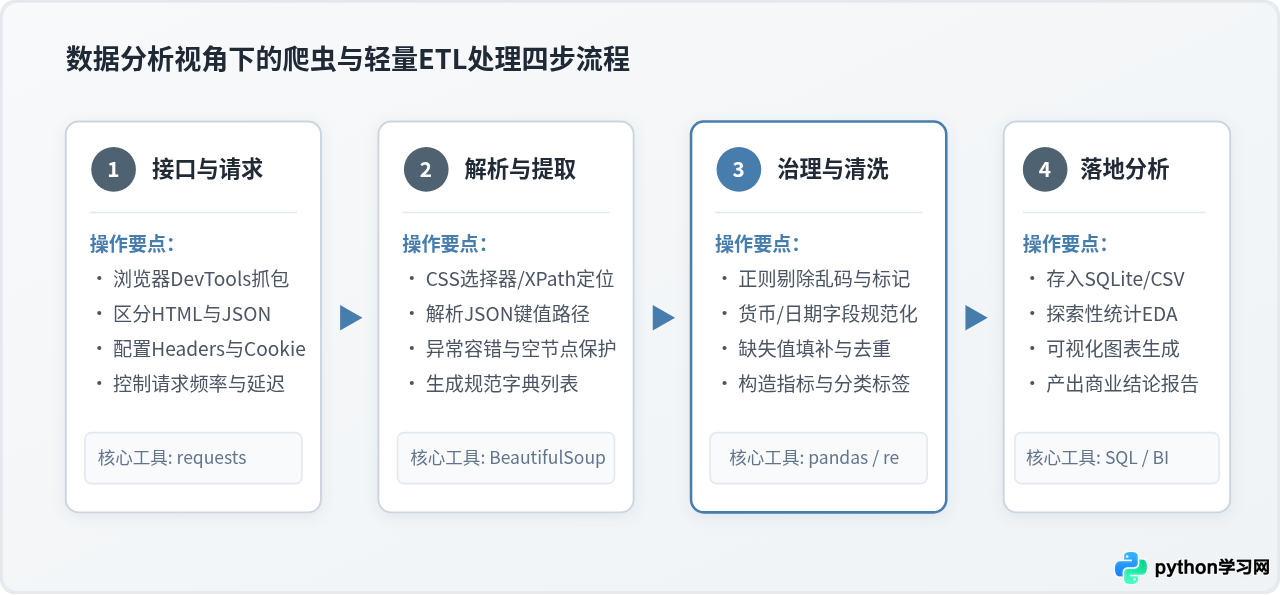
以下代码演示了一个贴近数据分析日常场景的轻量数据采集与清洗范例:通过请求目标接口,提取原始数据中的关键字段,并结合清洗逻辑构建规范的Pandas DataFrame。
import requests
import json
import pandas as pd
import re
import time

def fetch_market_sample():
    # 模拟分析师定向采集目标公开数据接口
    url = "https://httpbin.org/anything"  # 此处以回显接口作为稳定示例
    headers = {
        "User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36",
        "Accept": "application/json"
    }

    # 构造业务请求参数,例如分页查询某类产品价格与评价
    params = {"category": "analytics_tools", "page": 1}

    try:
        response = requests.get(url, headers=headers, params=params, timeout=10)
        response.raise_for_status()
        raw_data = response.json()

        # 模拟从接口返回中抽取的非结构化原始数据集合
        simulated_records = [
            {"item_id": "A101", "raw_price": " ¥ 1,299.00 /年 ", "rating_text": "好评率 96.5% (共120条评价)", "tags": "BI;看板;SQL"},
            {"item_id": "B202", "raw_price": "暂无报价", "rating_text": "好评率 88.0% (共45条评价)", "tags": "数据爬取;自动化"},
            {"item_id": "C303", "raw_price": "¥ 499.50 ", "rating_text": "好评率 92.1% (共310条评价)", "tags": "数据治理;Python"}
        ]

        cleaned_list = []
        for row in simulated_records:
            # 1. 价格字段清洗:提取浮点数,异常值填充
            price_match = re.search(r"([0-9,]+\.?[0-9]*)", row["raw_price"].replace(",", ""))
            clean_price = float(price_match.group(1)) if price_match else None

            # 2. 评价率与评价数正则解析
            rate_match = re.search(r"好评率\s*([0-9.]+)%", row["rating_text"])
            count_match = re.search(r"共([0-9]+)条", row["rating_text"])
            positive_rate = float(rate_match.group(1)) / 100.0 if rate_match else None
            review_count = int(count_match.group(1)) if count_match else 0

            cleaned_list.append({
                "item_id": row["item_id"],
                "price": clean_price,
                "positive_rate": positive_rate,
                "review_count": review_count,
                "tag_count": len(row["tags"].split(";"))
            })

        df = pd.DataFrame(cleaned_list)
        return df

    except requests.exceptions.RequestException as e:
        print(f"数据请求异常: {e}")
        return pd.DataFrame()

# 执行清洗并生成分析就绪的数据框
data_ready = fetch_market_sample()
print(data_ready)
通过这样的实战代码,求职者在面试中可以清晰地向面试官展示:自己不仅会使用 df.dropna(),更清楚网络返回脏数据的常见形态(如空格换行符、货币单位混入、缺失标识符),并且具备将其规整为标准分析底表的技术底色。
三、展示业务闭环:面试官如何通过爬虫评估综合素质
在数据分析面试中,面试官评估候选人往往遵循“技术实现能力”、“业务理解深度”和“解决未知问题主动性”三个核心维度。纯理论答题只能验证第一点,而一个端到端完整的爬虫分析项目能够同时覆盖这三项指标。
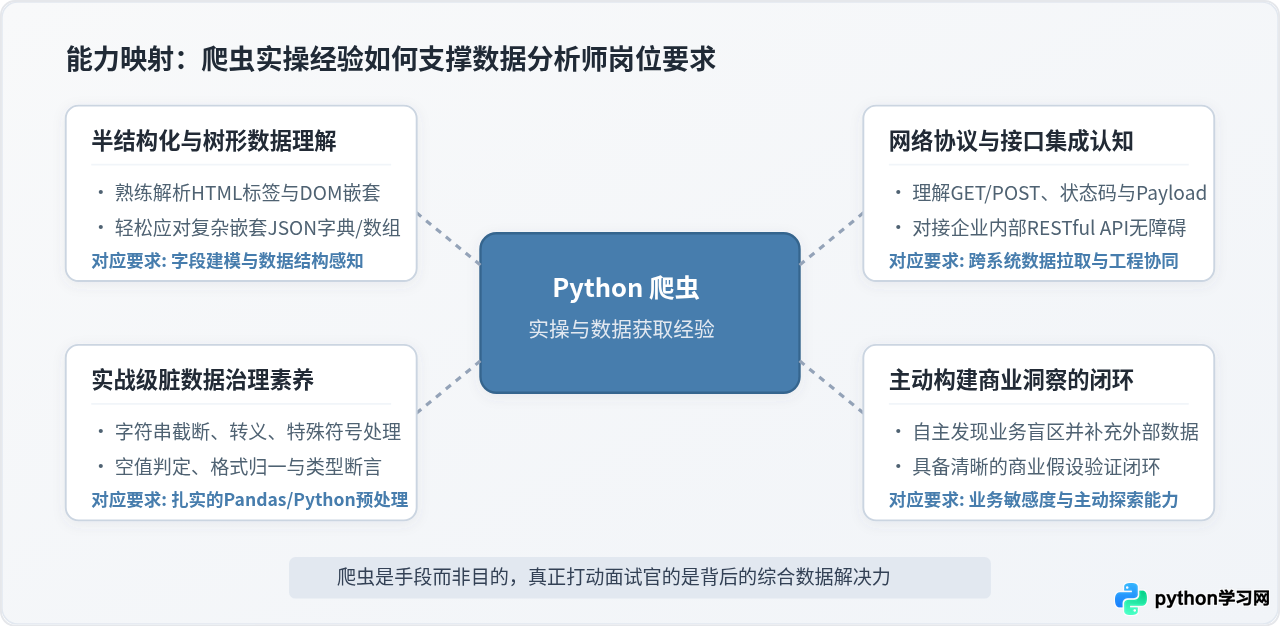
在阐述爬虫分析项目时,求职者展现出的素质通常超出代码本身:
- 网络与协议认知:理解 HTTP 请求方式(GET/POST)、常见状态码(200、403、429、500)、请求头与载荷结构。在进入公司后,当分析师需要对接内部数据系统、外部SaaS服务API或第三方开放平台时,能够零学习成本快速接手。
- 合规与边界把控意识:懂得遵守目标网站的 Robots 协议,合理设置请求间隔时间,避免对目标服务器造成高负载压力;注重敏感信息与个人隐私过滤。这反映出候选人具备良好的工程伦理与规范操作习惯。
- 自主定义业务假设的能力:很多新手分析师习惯于“业务方给什么数据就看什么数据”,缺乏探索精神。拥有爬虫经验的候选人能证明自己面对“数据不足”的现实约束时,具备寻找外部替代数据源、设计数据采集方案来验证业务假设的独立自主性。
四、避开求职陷阱:数据分析师学习爬虫的技术边界与精力分配
需要特别指出的是,数据分析岗位的核心产出是“商业洞察”与“业务决策支持”,绝非“海量高并发数据采集与对抗”。部分求职者在学习过程中本末倒置,花费数月去钻研复杂逆向、APP脱壳或搭建分布式集群,这反而偏离了数据分析岗位的评估核心。
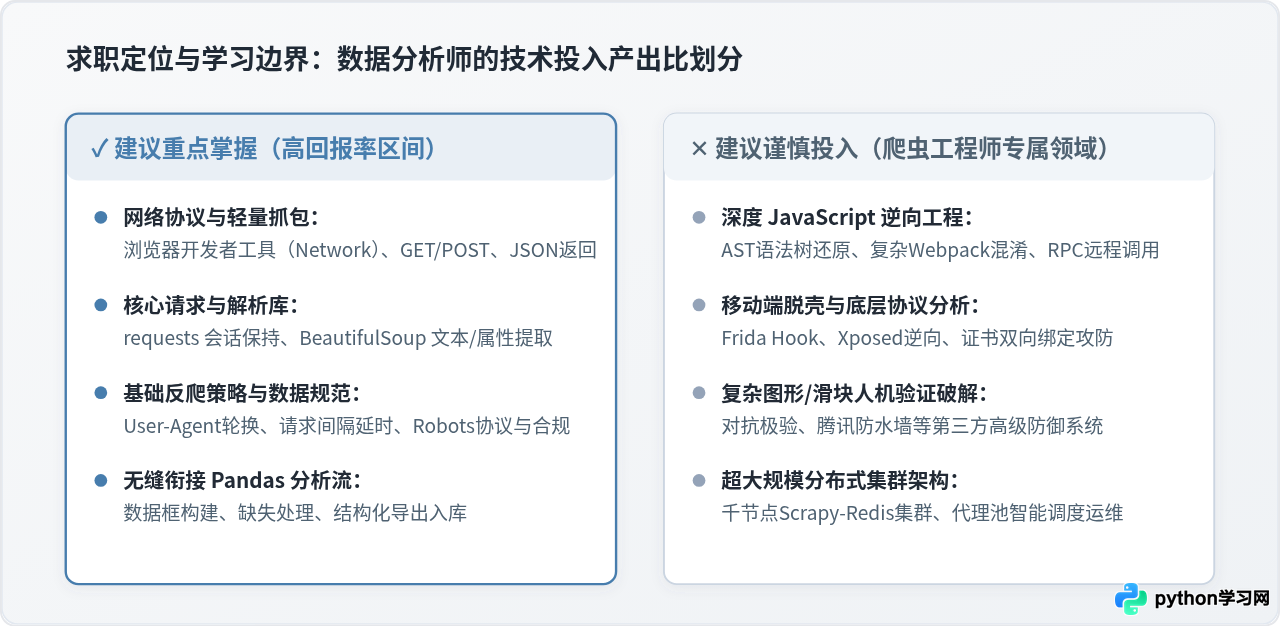
为实现求职收益最大化,建议求职者将爬虫学习控制在合理的ROI边界内:
- 建议深入掌握的高性价比内容:熟练使用
requests库与会话管理;掌握利用浏览器开发者工具(Network 面板)分析 Fetch/XHR 异步请求直接截取 JSON 数据;熟练掌握BeautifulSoup或lxml的 CSS 选择器与 XPath 语法;理解基础的反爬防护(如 User-Agent 伪装、Referer、Cookie 携带与单机延时限速);熟练使用 Pandas 衔接后续清洗。 - 建议主动规避的低性价比内容:深度 JavaScript AST 还原与加密算法混淆逆向;安卓/iOS 原生应用 Frida 动态调试与逆向;高度对抗的第三方复杂滑块验证码与人机识别突破;千节点分布式爬虫架构设计。这些属于全职爬虫工程师的专业范畴,在数据分析岗位面试中不仅无法得到加分,还可能被面试官质疑岗位定位不清晰。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















