


Python 接口开发中 SQLAlchemy 与 Pydantic 的数据模型映射实践
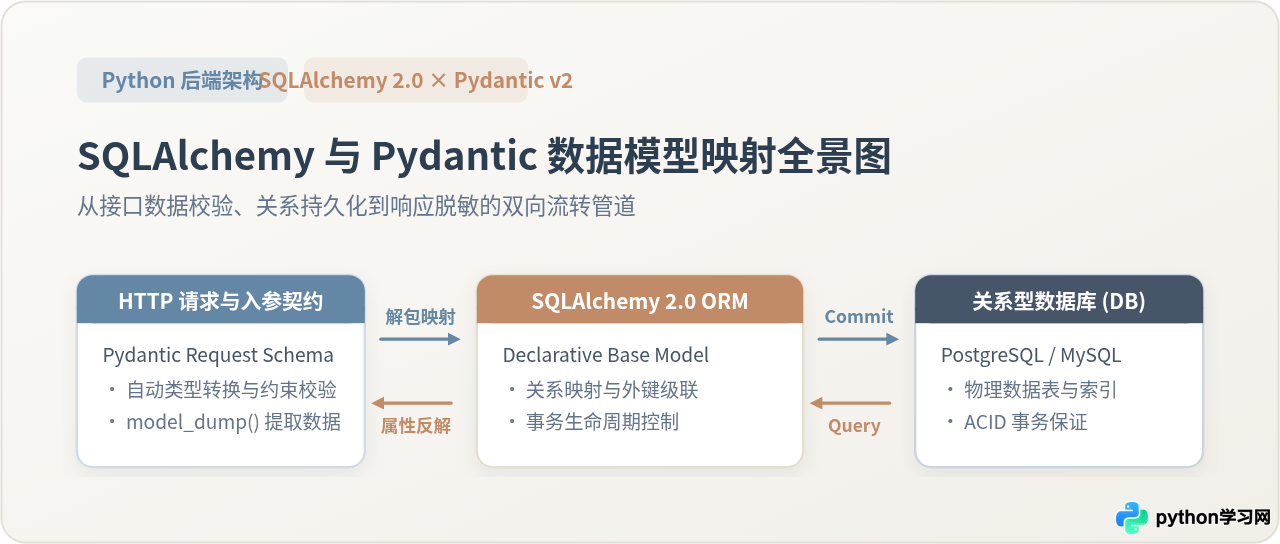
深入解析 Python 接口开发中 SQLAlchemy 与 Pydantic 的模型映射实践,涵盖双向数据流转、从属性加载、嵌套关系序列化与常见性能陷阱的规避方案。
一、架构定位:持久化实体与接口数据契约的边界划分
很多初学者在设计接口时,常产生一种直觉:既然 SQLAlchemy 模型已经定义了数据表的字段与类型,为何还要用 Pydantic 再重复写一套结构类似的 Schema?
这种重复是架构分层的必要成本。数据库物理结构反映的是存储形态,强调范式设计、索引优化与外键级联;而对外 API 接口反映的是业务契约,强调传输安全性、字段访问权限与客户端交互便捷度。如果直接将 SQLAlchemy 实体暴露给接口层,将导致严重的耦合与安全隐患:
- 敏感数据泄漏:数据库实体的
hashed_password、内部审计字段(如deleted_at、tenant_internal_id)极易因疏忽直接输出给客户端。 - 输入缺乏校验契约:ORM 层面只校验物理列约束(如非空或字符串长度),无法完成诸如邮箱格式、密码复杂度、多字段依赖等细粒度业务规则验证。
- 接口形态与数据结构无法对齐:同一个实体表(如用户表),在用户注册(包含明文密码)、用户列表(仅包含昵称与头像)、个人中心(包含关联文章与扩展资料)等不同动作下需要完全不同的字段视图。
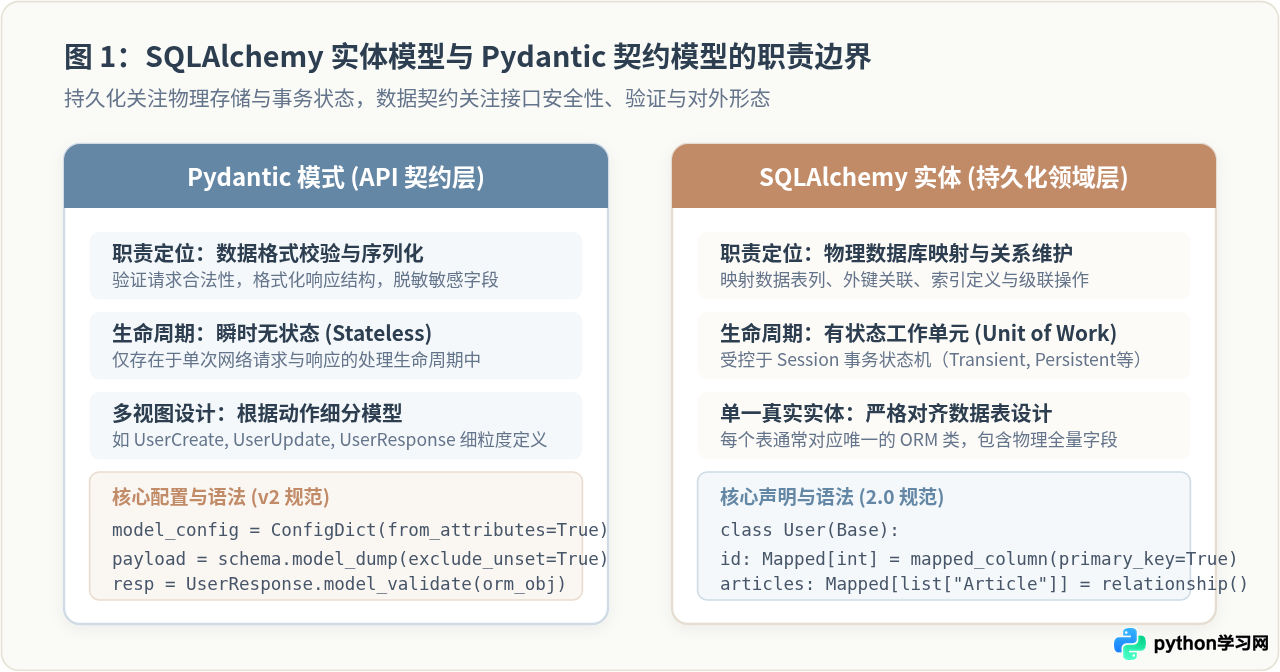
因此,合理的实践是遵循单一职责原则:SQLAlchemy 实体仅属于数据持久层(Persistence Layer),负责与数据库会话(Session)保持有状态交互;Pydantic Schema 则充当数据传输对象(DTO),作为无状态的 API 契约层(Contract Layer)。两者通过明确的入向与出向映射管道进行数据交接。
二、基础模型定义规范(SQLAlchemy 2.0 与 Pydantic V2)
在当前主流的开发实践中,应当采用 SQLAlchemy 2.0 声明式风格与 Pydantic V2 规范。现代版本不仅提供了强大的静态类型推导(Type Hinting),还在性能与映射便利性上有了显著升级。
1. SQLAlchemy 2.0 实体定义
SQLAlchemy 2.0 推荐使用 DeclarativeBase 搭配 Mapped 类型注解和 mapped_column。这种写法使类型检查工具(如 Mypy、Pyright)能够精确推断属性类型:
from datetime import datetime
from typing import List, Optional
from sqlalchemy import String, ForeignKey, DateTime, func
from sqlalchemy.orm import DeclarativeBase, Mapped, mapped_column, relationship

class Base(DeclarativeBase):
    pass

class User(Base):
    __tablename__ = "users"

    id: Mapped[int] = mapped_column(primary_key=True, autoincrement=True)
    username: Mapped[str] = mapped_column(String(50), unique=True, index=True, nullable=False)
    email: Mapped[str] = mapped_column(String(120), unique=True, nullable=False)
    hashed_password: Mapped[str] = mapped_column(String(255), nullable=False)
    is_active: Mapped[bool] = mapped_column(default=True)
    created_at: Mapped[datetime] = mapped_column(DateTime(timezone=True), server_default=func.now())

    # 关联关系定义
    articles: Mapped[List["Article"]] = relationship(back_populates="author", cascade="all, delete-orphan")

class Article(Base):
    __tablename__ = "articles"

    id: Mapped[int] = mapped_column(primary_key=True, autoincrement=True)
    title: Mapped[str] = mapped_column(String(200), nullable=False)
    content: Mapped[str] = mapped_column(nullable=False)
    author_id: Mapped[int] = mapped_column(ForeignKey("users.id"), nullable=False)

    author: Mapped["User"] = relationship(back_populates="articles")
2. Pydantic V2 数据契约模型定义
为了支撑接口的完整生命周期,通常需要为同一个实体定义三类 Schema:创建用(Create)、更新用(Update)、响应输出用(Response)。在 Pydantic V2 中,出向映射的核心配置是 ConfigDict(from_attributes=True)(替代了 V1 版本的 orm_mode = True):
from datetime import datetime
from typing import Optional, List
from pydantic import BaseModel, EmailStr, Field, ConfigDict

# 入参:创建用户
class UserCreate(BaseModel):
    username: str = Field(..., min_length=3, max_length=50, description="用户名")
    email: EmailStr = Field(..., description="电子邮箱")
    password: str = Field(..., min_length=8, description="明文密码")

# 入参:局部更新用户 (PATCH)
class UserUpdate(BaseModel):
    username: Optional[str] = Field(None, min_length=3, max_length=50)
    email: Optional[EmailStr] = None
    is_active: Optional[bool] = None

# 嵌套子模型:文章摘要
class ArticleSummary(BaseModel):
    id: int
    title: str

    model_config = ConfigDict(from_attributes=True)

# 出参:用户响应详情
class UserResponse(BaseModel):
    id: int
    username: str
    email: EmailStr
    is_active: bool
    created_at: datetime
    # 嵌套关联数据
    articles: List[ArticleSummary] = []

    # 关键配置:允许从 ORM 对象的属性 (getattr) 中提取数据
    model_config = ConfigDict(from_attributes=True)
三、入向映射实践:从请求载荷到 ORM 实体构建
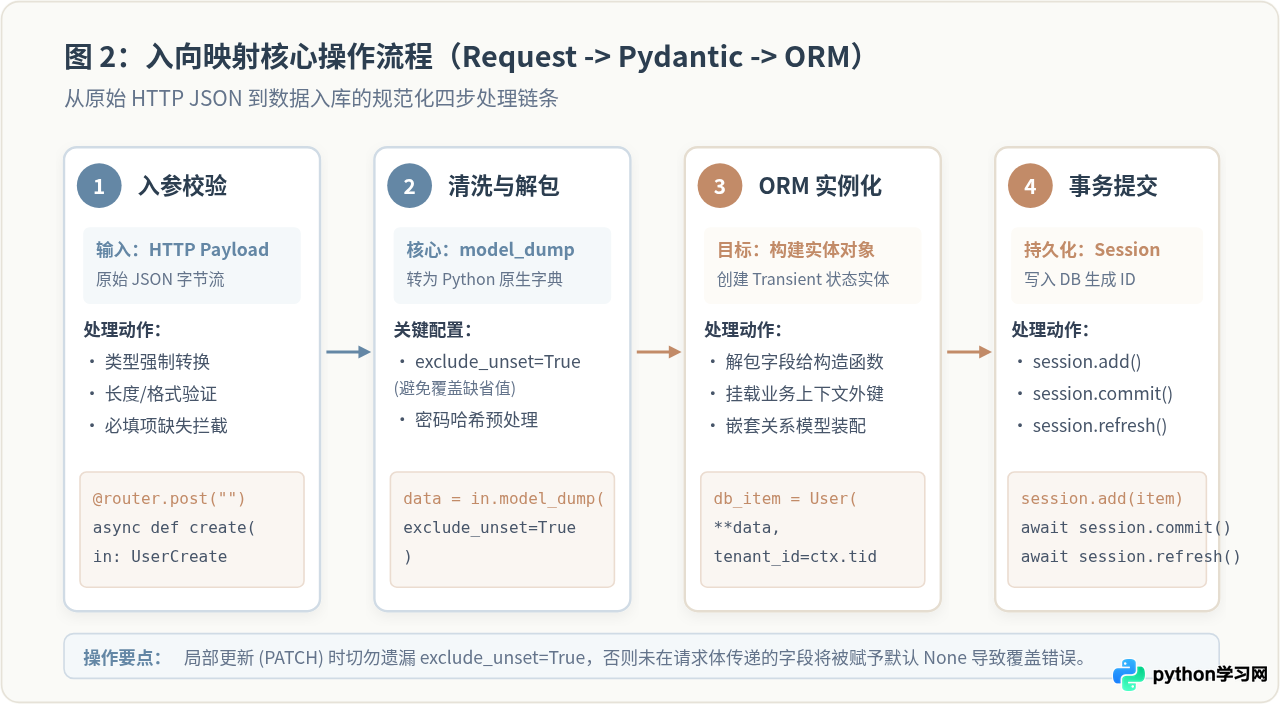
入向映射负责将客户端提交的 JSON 请求载荷经由 Pydantic 校验后,转换为可持久化的 SQLAlchemy ORM 实例并写入数据库。
1. 实体新建(POST 场景)
在新增实体的场景下,通过 Pydantic 对象的 model_dump() 方法将校验通过的数据导出为原生 Python 字典。若需脱敏或重命名字段(例如将请求中的 password 加密并转换为实体的 hashed_password),可以在解包前完成处理:
import hashlib
from sqlalchemy.ext.asyncio import AsyncSession

def hash_password(password: str) -> str:
    # 示例哈希函数(生产环境建议使用 passlib 或 bcrypt)
    return hashlib.sha256(password.encode()).hexdigest()

async def create_user_service(payload: UserCreate, session: AsyncSession) -> User:
    # 1. 提取校验后的字典数据
    user_dict = payload.model_dump()

    # 2. 移除明文密码并追加哈希值
    plain_password = user_dict.pop("password")
    user_dict["hashed_password"] = hash_password(plain_password)

    # 3. 解包实例化 SQLAlchemy ORM 实体
    db_user = User(**user_dict)

    # 4. 挂载到数据库会话并提交
    session.add(db_user)
    await session.commit()
    await session.refresh(db_user)
    return db_user
2. 局部字段更新(PATCH 场景与 exclude_unset)
局部更新是接口开发中最容易出错的环节。客户端可能只提交了 {"username": "new_name"},而没有提交 email。在默认情况下,UserUpdate 对象的 email 属性会被赋予默认值 None。
payload.model_dump(),未提交的字段会以 None 导出。若直接遍历赋值给 ORM 对象,会导致数据库中原有的 email 被错误地覆盖为 NULL!
正确的做法是使用 model_dump(exclude_unset=True)。该参数会精确过滤掉未在原始 HTTP 请求体中显式传递的字段,仅保留客户端主动提交的数据:
from fastapi import HTTPException

async def update_user_service(user_id: int, payload: UserUpdate, session: AsyncSession) -> User:
    db_user = await session.get(User, user_id)
    if not db_user:
        raise HTTPException(status_code=404, detail="用户不存在")

    # 关键:仅提取客户端显式传入的字段
    update_data = payload.model_dump(exclude_unset=True)

    # 动态更新 ORM 实体属性
    for field_name, value in update_data.items():
        setattr(db_user, field_name, value)

    await session.commit()
    await session.refresh(db_user)
    return db_user
四、出向映射实践:从 ORM 对象到响应契约的序列化
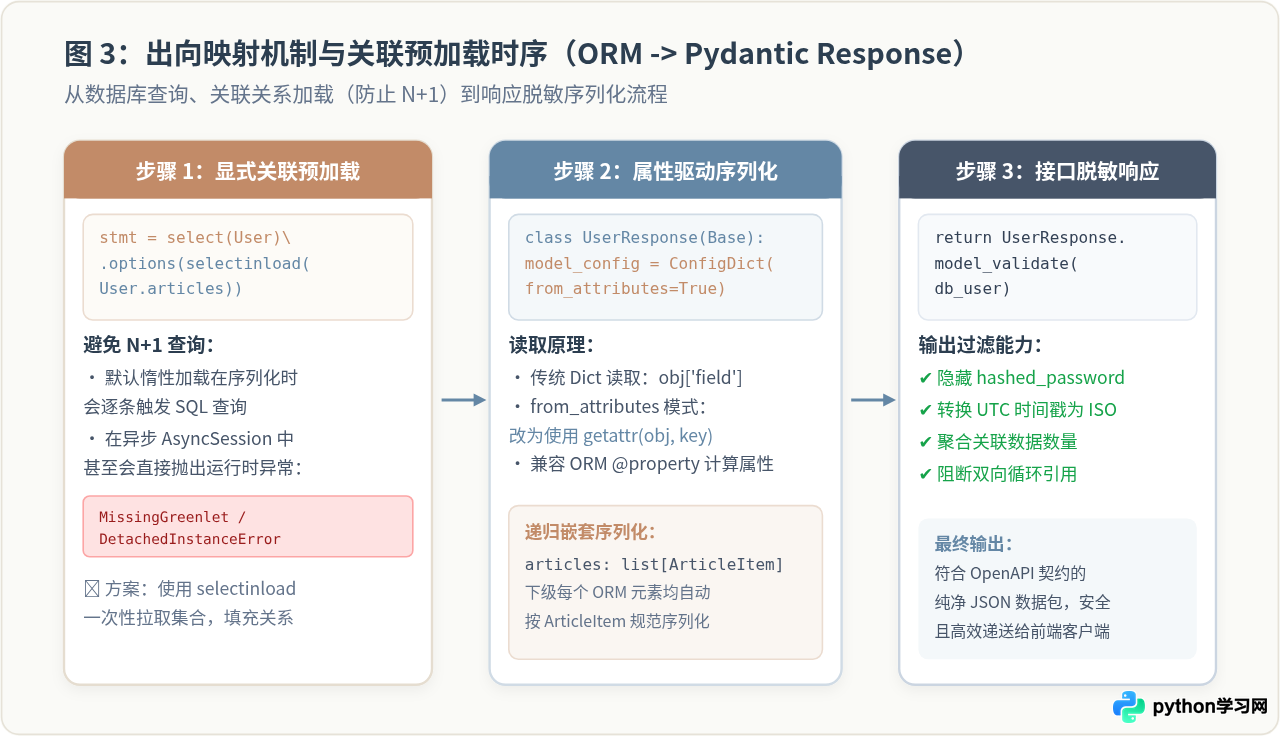
出向映射负责将持久层查询出的 SQLAlchemy 实体转换并过滤为符合 OpenAPI 契约的 JSON 数据结构,避免敏感字段暴露,并标准化日期与枚举格式。
1. from_attributes=True 的工作机制
Python 原生字典通过键索引获取数据(如 data["username"]),而 SQLAlchemy ORM 查询出的实体是 Python 对象,其数据保存在实例属性中(通过 obj.username 访问)。
当在 Pydantic V2 的 Schema 中声明 model_config = ConfigDict(from_attributes=True) 时,Pydantic 内部的取值方式会切换为 getattr(obj, field_name)。此时,我们可以直接调用:
# 方式 1:通过 Schema 类的 model_validate 方法直接反解 ORM 实体
response_data = UserResponse.model_validate(db_user)

# 方式 2:在 FastAPI 路由中指定 response_model,由框架底层自动完成映射
@router.get("/users/{user_id}", response_model=UserResponse)
async def get_user_endpoint(user_id: int, session: AsyncSession = Depends(get_session)):
    user = await get_user_by_id(user_id, session)
    return user  # FastAPI 自动匹配 response_model 调用 model_validate
2. 动态计算字段(Computed Fields)的协同
有时响应数据并不直接对应数据库中的某列,而是需要通过运算派生。例如,需要返回用户的文章总数或全名。在 Pydantic V2 中,推荐使用 @computed_field 装饰器,它能与 ORM 映射无缝结合:
from pydantic import computed_field

class UserDetailResponse(UserResponse):
    @computed_field
    def article_count(self) -> int:
        # 在序列化时动态读取 ORM 实体中的关联集合长度
        return len(self.articles)
五、高频陷阱与系统级防御方案
在实际生产环境中,SQLAlchemy 与 Pydantic 的交互往往涉及复杂关系。以下三个问题是导致接口报错或性能崩溃的高频根源:
1. 惰性加载导致的 N+1 查询与 MissingGreenlet 异常
在同步代码中,当 Pydantic 访问 user.articles 时,SQLAlchemy 会默认触发惰性加载(Lazy Loading),逐个发起针对 articles 表的 SQL 查询。如果查询出 100 个用户,将引发 1 + 100 次数据库请求,导致严重的性能劣化(N+1 查询)。
在更现代的异步架构(Asyncio + AsyncSession)下,惰性加载将引发致命错误:由于 Pydantic 序列化发生在事件循环的主线程,无法在同步属性访问中执行异步 I/O,系统会直接抛出 sqlalchemy.exc.MissingGreenlet 或 DetachedInstanceError。
标准解决方案:必须在查询层使用显式预加载策略。对于一对多集合,推荐使用 selectinload;对于多对一或一对一单对象关联,推荐使用 joinedload:
from sqlalchemy import select
from sqlalchemy.orm import selectinload

async def get_user_with_articles(user_id: int, session: AsyncSession) -> Optional[User]:
    stmt = (
        select(User)
        .options(selectinload(User.articles))  # 显式告知 ORM 预先抓取关联文章集合
        .where(User.id == user_id)
    )
    result = await session.execute(stmt)
    return result.scalar_one_or_none()
2. 双向关联导致的无限递归死循环
在 ORM 中,User.articles 指向文章列表,而 Article.author 指向用户对象。如果同时在 UserResponse 中嵌套了 ArticleResponse,而在 ArticleResponse 中又定义了 UserResponse,Pydantic 在序列化时会陷入无尽的相互引用,最终导致 RecursionError: maximum recursion depth exceeded。
防御准则:打破双向循环。在接口契约层定义专用轻量级 Schema,例如在返回用户详情时,关联的 articles 仅使用扁平化的 ArticleSummary(仅含 id 与 title,不含 author 字段);反之,在查询文章详情时,关联的 author 仅使用 UserSummary。
3. 时区敏感时间与枚举类型(Enum)的对齐
数据库中的时间戳与 Python 对象的 datetime 时区属性往往容易不一致。为了确保输出给前端的时间始终为带时区信息的 ISO 8601 标准字符串,建议在 SQLAlchemy 实体声明时统一使用 DateTime(timezone=True),并在 Pydantic 端明确类型。
六、实践对比速查表
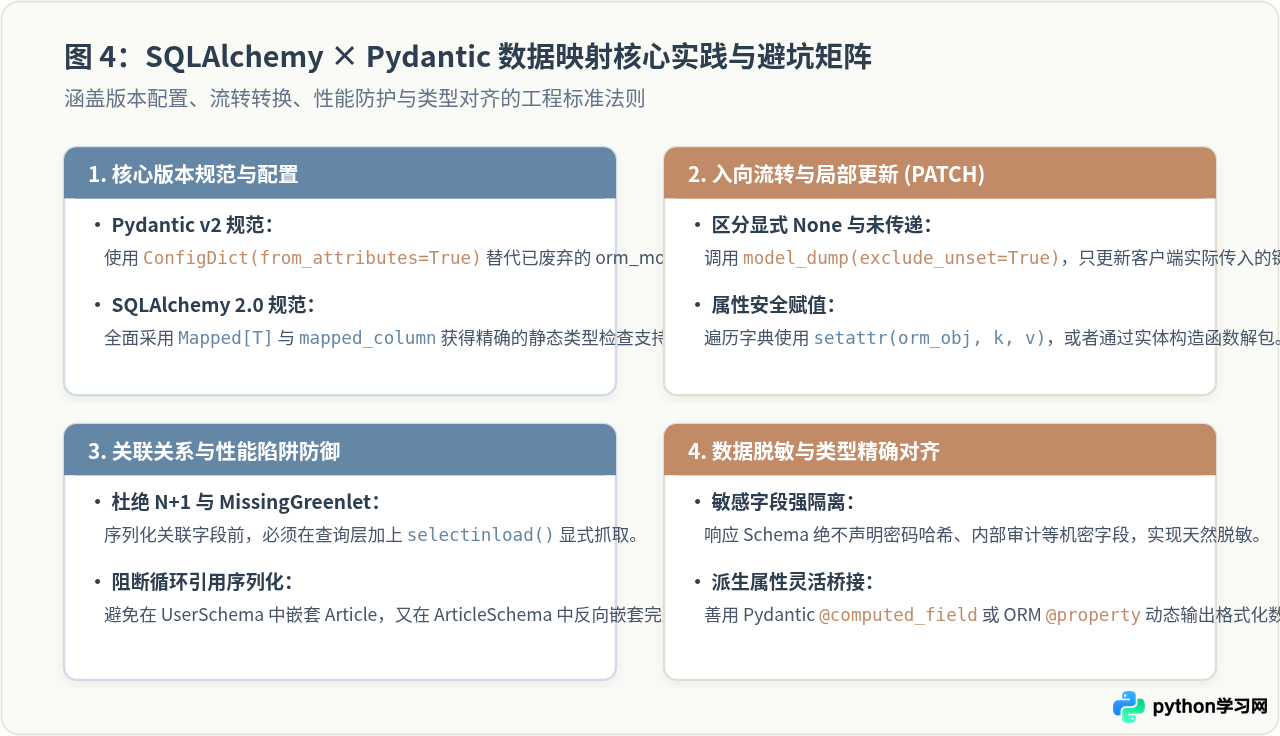
| 场景维度 | 传统/错误做法 | 标准工程实践 | 收益与原因 |
|---|---|---|---|
| 配置开关 | Pydantic v1: orm_mode = True |
Pydantic v2: model_config = ConfigDict(from_attributes=True) |
全面适配 V2 核心底层 Rust 序列化引擎,执行速度提升显著。 |
| 局部更新 (PATCH) | payload.model_dump() 直接遍历赋值 |
payload.model_dump(exclude_unset=True) |
精准区分“未提交字段”与“主动传递的 null”,避免误清空数据库已有值。 |
| 关联数据读取 | 依赖 ORM 默认 lazy loading 隐式触发 | 在 SQL 查询处显式指定 selectinload 或 joinedload |
消灭 N+1 数据库并发查询,彻底杜绝异步环境下的 MissingGreenlet 崩溃。 |
| 双向关系定义 | 父子 Schema 相互完整嵌套对方 | 单向解耦,设计专用轻量 Schema(如 SummarySchema) |
彻底阻断递归序列化死循环,减小网络传输包体积。 |
| 敏感数据防护 | 直接将 ORM 实体通过 Dict 转换后返回 | 在 Response Schema 中显式剔除密码哈希等敏感字段 | 白名单式输出控制,从物理契约层面保障信息安全。 |
七、完整可运行端到端代码示例
以下示例提供了一个精简且完整的模块化架构,展示了在基于 FastAPI + SQLAlchemy 2.0 (Async) + Pydantic V2 的技术栈中,如何规范实现增删改查全流程的数据模型映射:
import asyncio
from typing import List, Optional
from datetime import datetime
from fastapi import FastAPI, Depends, HTTPException, status
from pydantic import BaseModel, EmailStr, Field, ConfigDict
from sqlalchemy import String, ForeignKey, DateTime, select, func
from sqlalchemy.ext.asyncio import create_async_engine, async_sessionmaker, AsyncSession
from sqlalchemy.orm import DeclarativeBase, Mapped, mapped_column, relationship, selectinload

# ----------------- 1. 持久化层:SQLAlchemy ORM -----------------
class Base(DeclarativeBase):
    pass

class User(Base):
    __tablename__ = "users"

    id: Mapped[int] = mapped_column(primary_key=True, autoincrement=True)
    username: Mapped[str] = mapped_column(String(50), unique=True, nullable=False)
    email: Mapped[str] = mapped_column(String(100), unique=True, nullable=False)
    hashed_password: Mapped[str] = mapped_column(String(200), nullable=False)
    created_at: Mapped[datetime] = mapped_column(DateTime(timezone=True), server_default=func.now())

    articles: Mapped[List["Article"]] = relationship(back_populates="author", cascade="all, delete-orphan")

class Article(Base):
    __tablename__ = "articles"

    id: Mapped[int] = mapped_column(primary_key=True, autoincrement=True)
    title: Mapped[str] = mapped_column(String(200), nullable=False)
    author_id: Mapped[int] = mapped_column(ForeignKey("users.id"), nullable=False)

    author: Mapped["User"] = relationship(back_populates="articles")

# ----------------- 2. 接口契约层:Pydantic Schemas -----------------
class ArticleCreate(BaseModel):
    title: str = Field(..., max_length=200)

class ArticleSummary(BaseModel):
    id: int
    title: str
    model_config = ConfigDict(from_attributes=True)

class UserCreate(BaseModel):
    username: str = Field(..., min_length=3, max_length=50)
    email: EmailStr
    password: str = Field(..., min_length=6)

class UserUpdate(BaseModel):
    username: Optional[str] = Field(None, min_length=3, max_length=50)
    email: Optional[EmailStr] = None

class UserResponse(BaseModel):
    id: int
    username: str
    email: EmailStr
    created_at: datetime
    articles: List[ArticleSummary] = []

    model_config = ConfigDict(from_attributes=True)

# ----------------- 3. 数据库连接与依赖注入 -----------------
DATABASE_URL = "sqlite+aiosqlite:///:memory:"
engine = create_async_engine(DATABASE_URL, echo=False)
AsyncSessionLocal = async_sessionmaker(bind=engine, expire_on_commit=False)

async def get_db():
    async with AsyncSessionLocal() as session:
        yield session

# ----------------- 4. 业务路由与映射落地 -----------------
app = FastAPI(title="SQLAlchemy & Pydantic 映射实践")

@app.post("/users", response_model=UserResponse, status_code=status.HTTP_201_CREATED)
async def create_user(payload: UserCreate, db: AsyncSession = Depends(get_db)):
    # 入向映射:提取数据、处理哈希、构建 ORM
    user_data = payload.model_dump()
    raw_password = user_data.pop("password")
    user_data["hashed_password"] = f"hashed_{raw_password}"  # 仅作演示

    db_user = User(**user_data)
    db.add(db_user)
    await db.commit()
    await db.refresh(db_user)
    # 出向映射:返回 ORM 实体,由框架自动按 UserResponse 规则序列化
    return db_user

@app.get("/users/{user_id}", response_model=UserResponse)
async def read_user(user_id: int, db: AsyncSession = Depends(get_db)):
    # 查询层加装 selectinload 防范 N+1 及 MissingGreenlet
    stmt = select(User).options(selectinload(User.articles)).where(User.id == user_id)
    result = await db.execute(stmt)
    user = result.scalar_one_or_none()
    if not user:
        raise HTTPException(status_code=404, detail="用户不存在")
    return user

@app.patch("/users/{user_id}", response_model=UserResponse)
async def patch_user(user_id: int, payload: UserUpdate, db: AsyncSession = Depends(get_db)):
    db_user = await db.get(User, user_id)
    if not db_user:
        raise HTTPException(status_code=404, detail="用户不存在")

    # 局部更新映射:排除未传字段
    update_data = payload.model_dump(exclude_unset=True)
    for key, value in update_data.items():
        setattr(db_user, key, value)

    await db.commit()
    # 重新加载关联关系以保证响应完整
    await db.refresh(db_user, attribute_names=["articles"])
    return db_user
通过上述严密的架构划分与映射控制,数据在“物理存储层”与“对外交互层”之间实现了既相互隔离又高效畅通的流转。在未来的项目演进中,即便数据库表结构发生变更或接口字段需要重构,也只需在对应的映射边界内进行调整,而无需引发全局代码的连带修改。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















