


Python的序列类型不包括哪些数据类型
深入解析Python序列类型(Sequence)的官方协议标准与核心特征,详细辨析字典(dict)、集合(set)、生成器与迭代器、标量数值等不属于序列类型的数据类型及其底层原因。
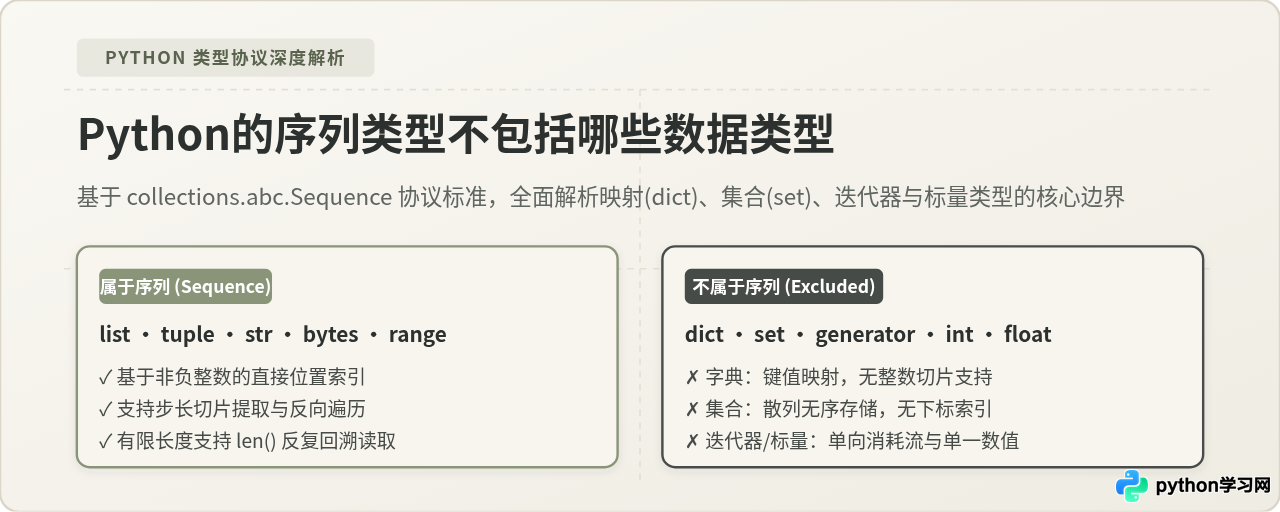
核心答案:在 Python 中,序列类型(Sequence Types)是指元素具有严格先后顺序、能够通过非负整数下标索引(如 s[i])与切片(如 s[i:j])访问,且具有确定长度(支持 len(s))的数据结构。遵循 Python 官方标准(包含 collections.abc.Sequence 抽象基类),Python 的序列类型不包括:字典(dict 等映射类型)、集合与冻结集合(set、frozenset)、生成器与流式迭代器(generator、zip、map、filter)、标量数值类型(int、float、complex、bool)以及特殊单例(NoneType、NotImplemented)。本文将系统拆解序列类型的核心判定标准,并对各常见混淆类型进行深入辨析。
一、序列类型的标准判定法则:究竟什么是序列?
初学者在学习 Python 时,常把“能放在 for 循环中遍历的容器”统称为序列。这种理解将“可迭代对象(Iterable)”与“序列(Sequence)”混为一谈。在 Python 官方数据模型(Data Model)规范中,序列属于可迭代对象的一个具有严苛约束的子集。
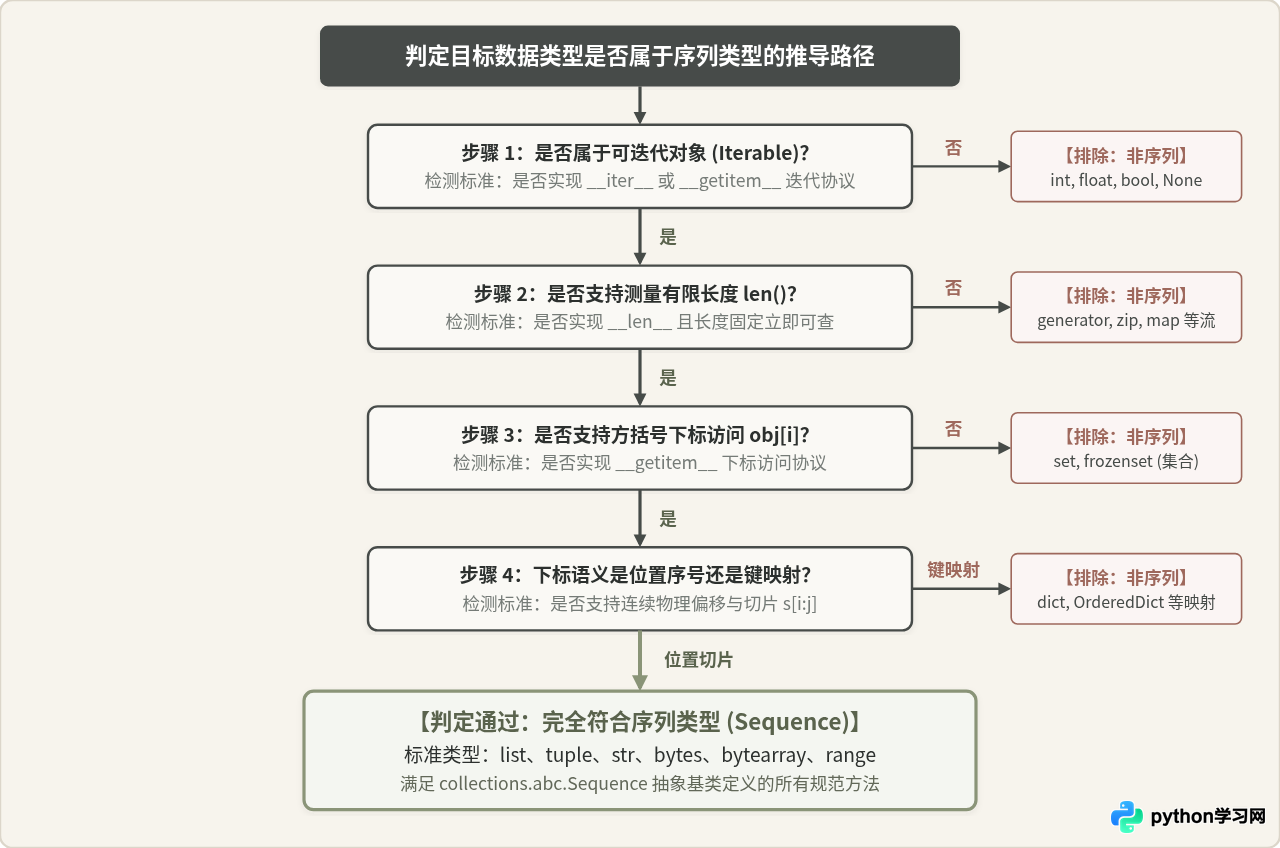
具体而言,一个合格的 Python 序列类型必须完整满足以下三项核心协议规范:
- 确定位置顺序与非负整数随机访问:容器内的元素必须拥有明确的槽位索引(从
0到len(s)-1),并支持使用负整数从末尾反向索引。任意位置的下标访问语义必须是纯粹的位置偏移,而非键名哈希匹配。 - 原生切片机制(Slicing):必须支持通过
s[start:stop:step]语法提取子序列,并在步长支持下实现反转或等距采样。 - 确定且有限的长度度量(
len()):容器在内存中随时可以获知自身包含的元素总数,读取长度不改变内部状态,且支持反复多次遍历而不发生元素耗尽。
Python 标准库中符合这一规范的内置序列类型仅有两组:可变序列(list、bytearray)与不可变序列(tuple、str、bytes、range)。除此之外的内置数据类型,即便外观或行为有相似之处,均不属于序列类型。
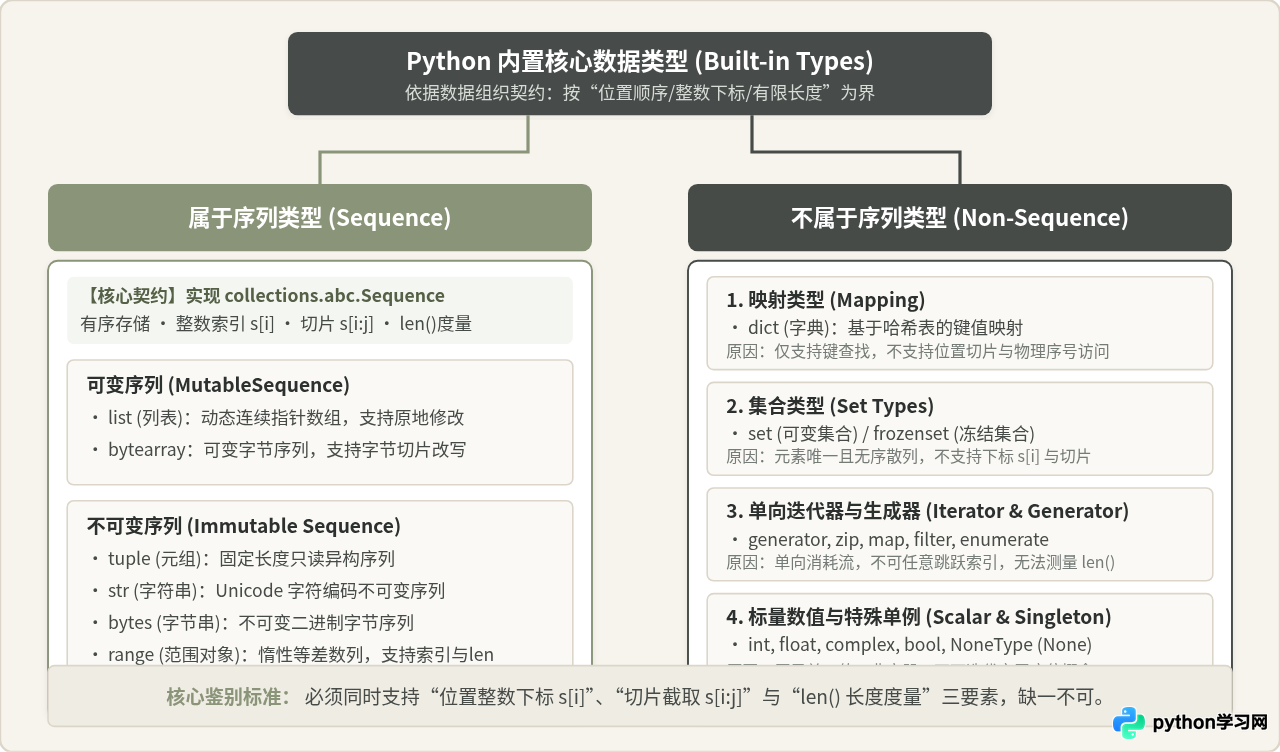
二、最具迷惑性的非序列:字典(dict)
在所有非序列类型中,字典(dict)是最容易让开发者产生误判的类型。特别是从 Python 3.7 开始,官方正式将“字典按照键插入的顺序保持有序”写入语言标准规范,并且在 Python 3.8 中进一步支持了 reversed(dict) 反向遍历。
直觉在于:字典同样用方括号读取元素(如 d["key"]),可以用 len(d) 获取长度,遍历时严格按照键的先后顺序逐个吐出,并且还能反转。这种表现与序列的“有序”、“可索引”、“有长度”极为相近。
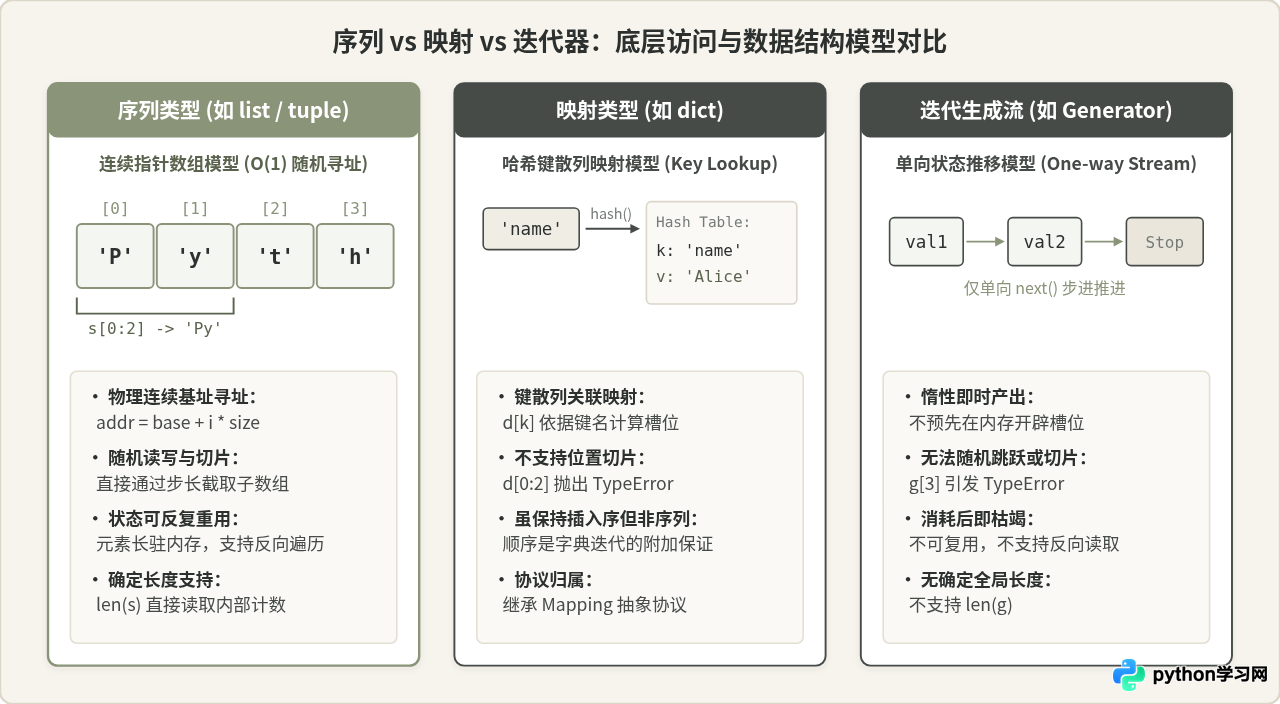
然而,这种表面相似性掩盖了底层访问契约的本质不同。字典属于映射类型(Mapping),绝对不属于序列,原因主要有以下两点:
- 下标语义是键哈希映射(Key Lookup),而非位置序号(Positional Index):在序列中,
s[0]恒定指代物理上的首个元素。而在字典中,方括号内的参数必须是与目标条目完全匹配的键。如果一个字典没有0这个键,执行d[0]将立即触发KeyError,而绝不会返回字典的第一项。即使字典恰好存在一个整数键0,也是 Hash 查找,而非位置偏移。 - 字典严禁切片操作:序列类型可以通过切片
s[0:2]截取连续区间,但字典尝试切片时会抛出异常,因为切片对象(slice)本身不可散列,无法作为映射的键。
我们可以通过一段标准交互示例直接验证这一限制:
# 环境:Python 3.10+
data_dict = {"apple": 5, "banana": 3, "orange": 8}

# 验证 1:尝试通过位置下标 0 获取第一个元素
try:
    print(data_dict[0])
except KeyError as err:
    print(f"执行结果:KeyError: {err}(字典不存在键 0,无法按位置读取)")

# 验证 2:尝试对字典进行切片操作
try:
    sub_dict = data_dict[0:2]
except TypeError as err:
    print(f"执行结果:TypeError: {err}(切片对象无法作为字典的键进行散列)")
输出说明:上述代码在标准 Python 解释器中会相继捕获 KeyError: 0 与 TypeError: unhashable type: 'slice'。这清晰地证明了字典是映射协议(collections.abc.Mapping)的实现者,而非序列协议。
三、集合类型(set 与 frozenset)为什么不是序列?
集合包括可变集合(set)与不可变集合(frozenset)。在日常使用中,集合也是常用的容器类型,能够容纳多个元素,支持 len() 计数,并且支持 for item in s 循环遍历与 in 成员检测。
但集合不仅不属于序列,而且是序列的反义极端:
- 底层完全无序:集合底层由开地址哈希表实现,每个元素根据自身的哈希值(Hash Code)计算存储桶位。集合元素之间没有任何逻辑或物理上的前后次序。即便多次打印看似有某种规律,那也只是哈希桶当前分布的巧合,绝不应作为业务依赖。
- 彻底不支持下标索引与切片:试图通过
my_set[0]访问元素会直接抛出TypeError: 'set' object is not subscriptable。 - 排重唯一性:序列允许并忠实记录重复元素(例如
[1, 1, 2]),而集合具备数学集合的互异性,任何重复项都会被自动合并。
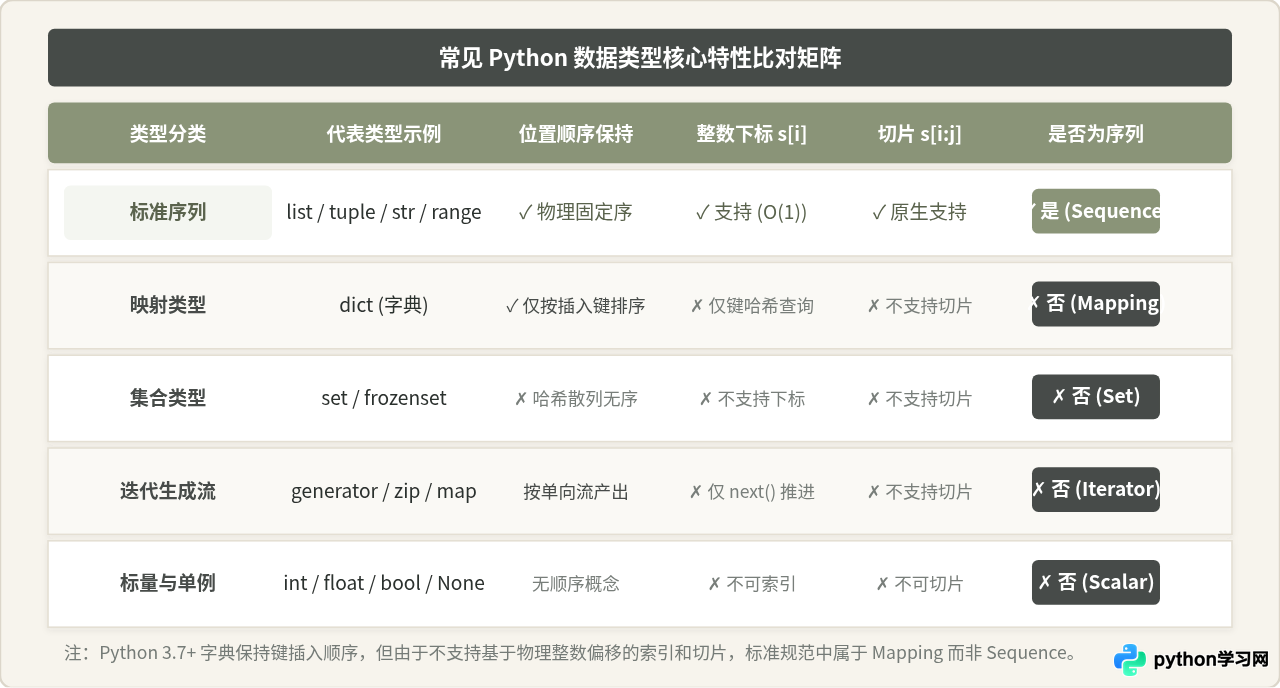
四、单向消耗型数据流:生成器与迭代器
在 Python 函数式编程或处理大型文件流时,生成器(Generator)和迭代器(Iterator)经常登场。例如使用生成器表达式 (x * 2 for x in [1, 2, 3]),或者使用内置函数 zip()、map()、filter()、enumerate() 返回的对象。
在概念上,生成器产出的数据确实具有明确的时间先后顺序。许多开发者会把它们当成“惰性列表”使用。但根据语言规范,生成器与迭代器绝对不是序列,而是单向状态机流(Stream)。
序列与生成器/迭代器的本质差别体现在以下三个维度:
- 不可随机寻址:迭代器只暴露单向推移接口(
__next__())。它不知道也不存储任意下标的元素。对生成器执行g[2]会直接抛出TypeError: 'generator' object is not subscriptable。 - 长度未知且无法度量:大部分生成器在完全消耗完毕之前,无法预先计算其所包含的总项数(有的生成器甚至是无限流)。因此对生成器执行
len(g)会报错TypeError: object of type 'generator' has no len()。 - 一次性消耗与不可回溯:序列是持久驻留内存的静态结构,无论读取多少次
s[0],内容始终存在。而迭代器每产出一个元素,指针就向前推移一步;一旦遍历完毕,迭代器就变为空壳,无法重新从头读取,更无法使用负数反向切片。
五、标量数值类型与特殊单例常量
除了复合容器之外,Python 中的基本数据类型也大量存在非序列对象。这些类型包括:
- 数值类型(Numeric Types):整型
int、浮点型float、复数complex。它们表示的是纯粹的数学标量数值,不是集合,不可分割。执行for x in 12345:或12345[0]会直接触发TypeError: 'int' object is not iterable。 - 布尔类型(bool):许多人容易忽略的是,Python 中的
bool是int的直接子类(即issubclass(bool, int)为True)。True和False实际上就是数值1和0的语义外壳,属于标量数值,因此不是序列。 - 特殊单例常量:如
NoneType(即None)、NotImplemented、Ellipsis(即省略号...)。它们作为语言内部状态或空值占位符存在,同样没有任何序列特征。
六、实战验证:如何在代码中严谨检测序列类型?
在编写通用库、数据转换工具或 API 参数校验时,我们往往需要判断外部传入的参数是否为合格的序列。在实际工程中,通常有以下两种规范的判定方式:
1. 基于标准抽象基类(ABC)的标准验证
Python 标准库的 collections.abc 模块定义了严格的数据结构接口规范。判断一个对象是否属于序列,最权威且兼顾类型继承的方法是使用 isinstance() 配合 Sequence 或 MutableSequence 进行判定:
from collections.abc import Sequence, MutableSequence, Mapping, Iterator

# 测试用例对象
sample_list = [1, 2, 3]
sample_tuple = (1, 2, 3)
sample_str = "Python"
sample_dict = {"a": 1, "b": 2}
sample_set = {1, 2, 3}
sample_gen = (x for x in range(3))
sample_int = 42

# 严谨验证各类型归属
print(f"list 是否属于序列: {isinstance(sample_list, Sequence)}")       # True
print(f"tuple 是否属于序列: {isinstance(sample_tuple, Sequence)}")     # True
print(f"str 是否属于序列: {isinstance(sample_str, Sequence)}")         # True
print(f"dict 是否属于序列: {isinstance(sample_dict, Sequence)}")       # False
print(f"set 是否属于序列: {isinstance(sample_set, Sequence)}")         # False
print(f"generator 是否属于序列: {isinstance(sample_gen, Sequence)}") # False
print(f"int 是否属于序列: {isinstance(sample_int, Sequence)}")         # False

# 检查非序列的具体契约归属
print(f"dict 属于 Mapping: {isinstance(sample_dict, Mapping)}")         # True
print(f"generator 属于 Iterator: {isinstance(sample_gen, Iterator)}") # True
2. 鸭子类型(Duck Typing)与动态契约检查
如果需要在不依赖抽象基类注册的情况下,对任意第三方对象或用户自定义类进行动态判断,可以通过检查对象是否实现了序列关键魔法方法(__getitem__ 与 __len__),并验证其是否支持切片提取:
def is_sequence_like(obj) -> bool:
    """
    通过鸭子类型检测对象是否满足序列核心行为契约
    """
    # 排除显式的映射类型与迭代器类型
    if isinstance(obj, (Mapping, Iterator)):
        return False

    # 检查是否同时实现了 __getitem__ 与 __len__
    if not hasattr(obj, "__getitem__") or not hasattr(obj, "__len__"):
        return False

    # 尝试切片行为测试
    try:
        _ = obj[0:0]
        return True
    except (TypeError, KeyError):
        return False

# 验证效果
print("is_sequence_like 校验结果:")
print(f"  [1, 2, 3]    -> {is_sequence_like([1, 2, 3])}")    # True
print(f"  'hello'      -> {is_sequence_like('hello')}")      # True
print(f"  range(5)     -> {is_sequence_like(range(5))}")     # True
print(f"  {'k': 'v'}   -> {is_sequence_like({'k': 'v'})}")   # False
print(f"  {1, 2, 3}    -> {is_sequence_like({1, 2, 3})}")    # False
七、全景总结速查表
为了便于在日常开发与技术面试中快速查阅与辨析,下表整理了 Python 常用数据类型在序列判定维度的完整归纳:
| 数据类型 | 分类范畴 | 元素先后顺序 | 支持位置整数索引 | 支持切片 | 抽象基类实现 | 是否属于序列 |
|---|---|---|---|---|---|---|
list |
可变序列 | 物理位置序 | 支持 | 支持 | MutableSequence |
属于序列 |
tuple |
不可变序列 | 物理位置序 | 支持 | 支持 | Sequence |
属于序列 |
str |
文本字符序列 | 字符位置序 | 支持 | 支持 | Sequence |
属于序列 |
range |
惰性数值范围 | 等差算术序 | 支持 | 支持 | Sequence |
属于序列 |
dict |
映射容器 | 仅键插入序 | 仅键查询 | 不支持 | Mapping |
不属于序列 |
set / frozenset |
哈希集合 | 完全无序 | 不支持 | 不支持 | Set |
不属于序列 |
generator / 迭代器 |
单向流式状态机 | 单向时间流 | 不支持 | 不支持 | Iterator |
不属于序列 |
int / float / bool |
原子标量数值 | 无顺序概念 | 不可索引 | 不支持 | Integral / Real |
不属于序列 |
NoneType |
单例常量 | 无 | 不可索引 | 不支持 | 无容器协议 | 不属于序列 |
掌握序列类型的边界不仅有助于避免日常编码中诸如 TypeError: unhashable type: 'slice' 或 KeyError 等经典低级错误,更能让我们在设计复杂架构与接口契约时,准确选用最贴合数据特性的底层容器。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















