


C/C++转Python:怎么用模块和包替代头文件功能
针对熟悉 C/C++ 编译体系的开发者,系统讲解 Python 如何通过模块(Module)、包(Package)、sys.modules 单例缓存与门面模式,完整替代头文件的接口声明、防重包含、宏常量与实现隐藏功能。
一、C/C++ 头文件到底承担了哪些职责?
习惯了 C/C++ 开发的工程师在初学 Python 时,最常见的困惑往往是:“我的代码写在同一个 .py 文件里,如果没有头文件,调用方怎么知道我的函数签名?如果两个文件互相导入,为什么不会像 #include 一样无限展开?”
要理解 Python 的解决思路,首先必须看清 C/C++ 头文件的本质。在 C/C++ 传统的编译流水线中,头文件主要履行以下五项职责:
- 接口与实现分离:在
.h中提供函数原型(Prototype)、类结构定义(Class Definition)和外部变量声明(extern),为编译器提供计算类型内存布局和参数校验的依据,具体实现则隐藏在.cpp中。 - 预编译文本拼接:通过预处理指令
#include,将头文件中的文本原封不动地复制粘贴到源文件中,合成一个庞大的翻译单元(Translation Unit)。 - 防止多重包含冲突:为了防止多次
#include引发单定义规则(ODR, One Definition Rule)违规或类型重复定义报错,必须显式书写#ifndef ... #define宏守卫或#pragma once。 - 宏常量与全局配置共享:使用
#define宏或constexpr定义全工程通用的参数、常量和开关。 - 跨编译单元依赖解耦:通过前向声明(Forward Declaration,如
class Engine;)解决指针依赖,避免引入多余的头文件,加速增量编译。
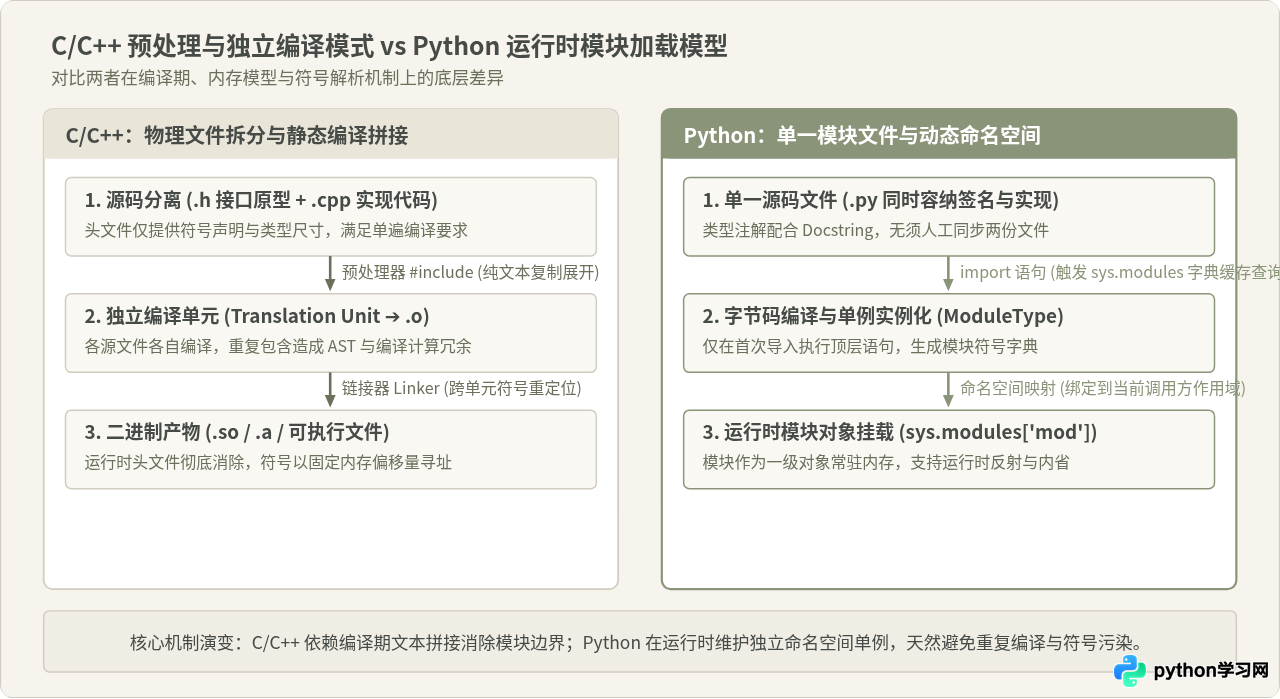
上述设计的底层根源在于:C/C++ 的编译器在处理单个 .cpp 文件时是上下文隔离的。它必须在当前编译单元内看到完整的符号声明才能生成目标文件(.o),最终由链接器(Linker)把分散的符号地址拼装在一起。
二、Python 的运行时模型:为什么不需要独立头文件?
Python 没有静态预处理器,也没有将源码翻译为机器码的目标链接阶段。Python 源代码在运行时被解析为抽象语法树(AST),随后编译为字节码(Bytecode),并在 Python 虚拟机(PVM)中解释执行。
当你在 Python 中书写 import math_tool 时,所发生的不是预处理器的文本拷贝,而是一条动态的 Python 执行语句:
- 解释器在
sys.path中定位到对应的math_tool.py文件; - 在内存中开辟一个新的模块对象(类型为
types.ModuleType),并将其挂载到解释器的全局单例字典sys.modules中; - 顺序执行该文件内部的顶层代码,所有在模块顶层定义的函数、类和变量都会作为属性写入该模块的命名空间字典(
__dict__); - 在当前调用方的局部命名空间中,创建一个同名变量
math_tool,指向内存中的该模块对象。
正因如此,Python 从语言机制上消除了将“声明”与“实现”切分成两个物理文件的客观必要。一个 .py 文件既是定义的承载者,也是运行时的实体对象。
三、逐项替换:如何用模块和包对应头文件的功能
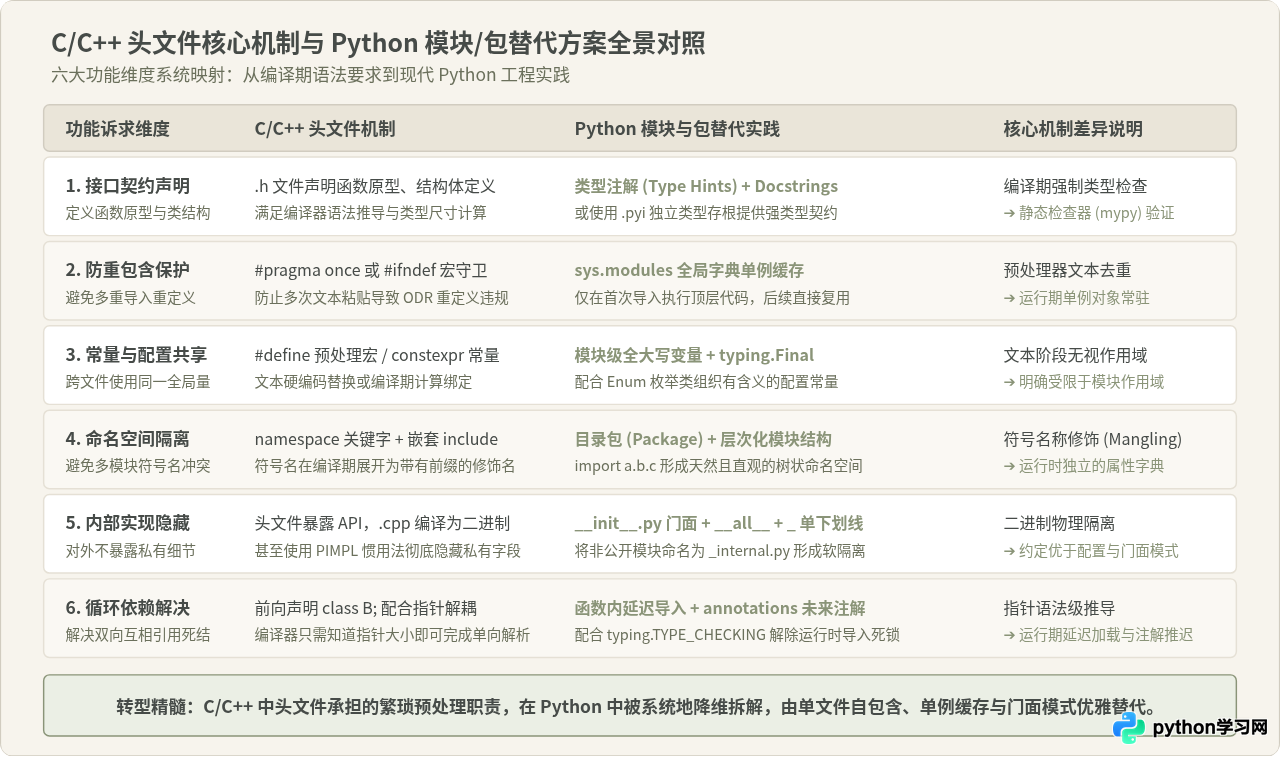
在实际编写 Python 项目时,我们可以系统化地用现代 Python 特性逐一对应并超越 C/C++ 头文件所提供的能力。
3.1 替代接口声明:类型注解(Type Hints)与文档字符串
在 C/C++ 中,头文件的最大价值是充当“契约文档”,调用方通过阅读 .h 即可获知函数参数类型和返回类型:
// C++ 头文件: geometry.h
#pragma once

struct Point {
    double x;
    double y;
};

// 计算两点之间的欧式距离
double calculate_distance(const Point& p1, const Point& p2);
在 Python 中,我们不需要单独建一个文件写声明,而是直接在 geometry.py 实现中运用 类型注解(Type Hints) 与 文档字符串(Docstring) 确立契约:
# Python 实现: geometry.py
from dataclasses import dataclass
import math

@dataclass(frozen=True)
class Point:
    x: float
    y: float

def calculate_distance(p1: Point, p2: Point) -> float:
    """计算两点之间的欧氏距离。

    Args:
        p1: 起始点坐标对象
        p2: 目标点坐标对象

    Returns:
        两点间的几何距离标量值
    """
    return math.hypot(p2.x - p1.x, p2.y - p1.y)
在现代 IDE(如 VS Code、PyCharm)中,无论是代码补全、跳转还是悬停提示,类型注解与 Docstring 提供的体验已经完全覆盖并超过了阅读 .h 文件的效率。
如果你的 Python 模块底层是用 C/C++ 编写的 C-Extension(如
.so / .pyd 二进制库),或者你确实希望向外部商业客户分发经过字节码混淆的源码但保留纯类型契约,可以编写同名的 geometry.pyi(PEP 484 存根文件)。.pyi 内部只写函数原型与类型注解,不包含具体逻辑,它就是 Python 生态中真正的“纯声明头文件”。
3.2 替代头文件守卫:sys.modules 字典与四步导入生命周期
C/C++ 中头文件一旦被间接包含多次,必须依赖 #ifndef ... #define ... #endif 避免编译器报“符号重定义(Redefinition)”错误。
在 Python 中,你完全不需要手动编写任何防重复导入的保护宏。Python 解释器在内部通过全局字典 sys.modules 强制推行了单例加载机制。每一次 import 语句执行时的底层流转如下图所示:
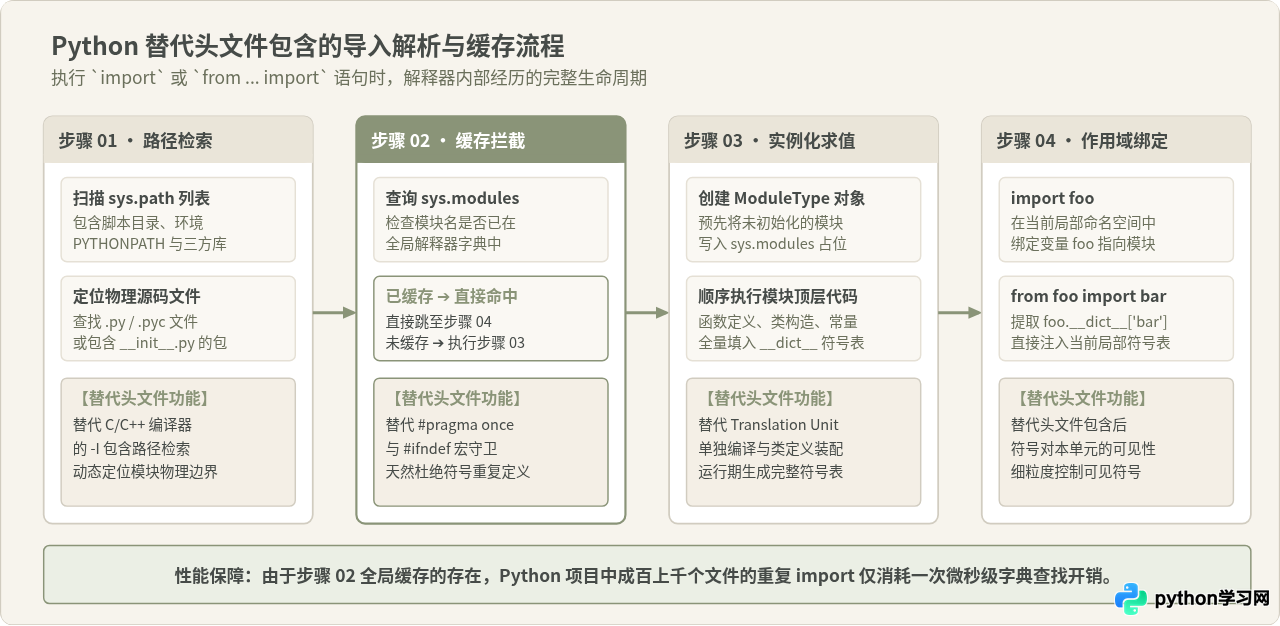
当多个业务模块(例如 service_a.py 和 service_b.py)同时书写 import geometry 时,只有最先执行的那行代码会去读取磁盘并执行顶层代码;后续所有的 import 操作都只会触发一次平均复杂度为 O(1) 的字典检索,直接把已存在的模块引用赋给当前变量。
3.3 替代宏常量定义:模块级常量与 typing.Final
C/C++ 常常在头文件中使用 #define MAX_BUFFER_SIZE 4096 或 static const int TIMEOUT = 30; 来共享配置。
在 Python 中,我们通过模块级全大写命名规范,结合 Python 3.8+ 提供的 typing.Final 实现相同诉求:
# config.py
from typing import Final
from enum import Enum

# 声明模块级不可变常量契约
MAX_BUFFER_SIZE: Final[int] = 4096
DEFAULT_TIMEOUT_SECONDS: Final[float] = 30.0

class ProtocolMode(Enum):
    TCP = "tcp"
    UDP = "udp"
外部调用方只需执行 from config import MAX_BUFFER_SIZE, ProtocolMode 即可。若有代码试图给 MAX_BUFFER_SIZE 赋值修改,静态代码检查工具(如 mypy)会立刻报告类型违规。
3.4 替代 include/src 分割:包(Package)与 __init__.py 门面设计
在典型的 C/C++ 库项目中,代码通常被严格划分为两个目录:include/ 存放暴露给客户的对外头文件,src/ 存放不公开的内部实现。
Python 使用 包(Package) 来实现同样甚至更加优雅的模块化管理。任何包含 __init__.py 文件的目录都会被 Python 识别为一个包。我们可以通过 __init__.py 构建统一的对外门面(Facade),并通过 __all__ 列表精确锁定公开符号。
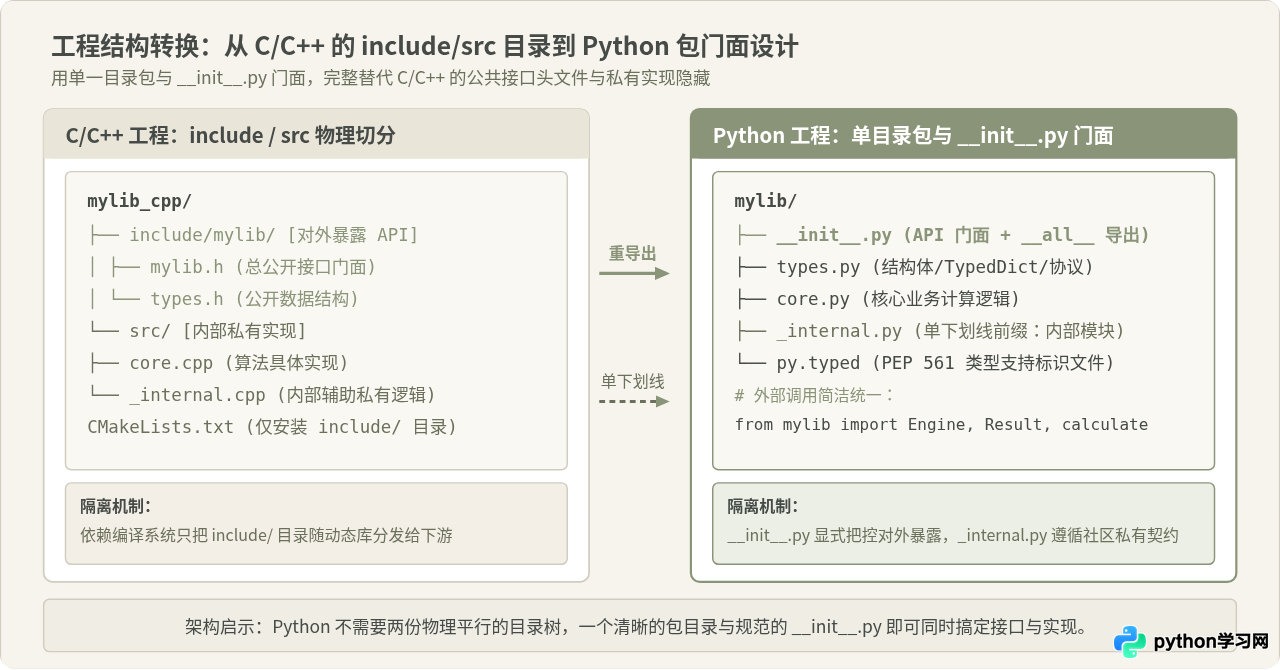
具体的替代操作步骤如下:
- 建立包目录:新建一个以库名命名的文件夹(例如
geomengine/); - 分散业务实现:将复杂的实现代码按功能拆解放入
types.py、core.py,内部专用的工具函数放入_internal.py(以单下划线命名标识私有); - 编写门面
__init__.py:挑选需要提供给调用方的类和函数,在__init__.py中统一导入,并定义__all__变量:
# geomengine/__init__.py
"""几何计算引擎公开接口门面。"""

from .types import Point, Vector
from .core import calculate_distance, intersect_ray

# 显式声明公开 API 导出白名单(替代对外公开总头文件)
__all__ = [
    "Point",
    "Vector",
    "calculate_distance",
    "intersect_ray",
]

__version__ = "1.0.0"
对于库的外部调用者而言,他们无需了解内部具体的 core.py 或 types.py 路径,只需直接面对包本身:
from geomengine import Point, calculate_distance

p1 = Point(0.0, 0.0)
p2 = Point(3.0, 4.0)
dist = calculate_distance(p1, p2)
3.5 替代前向声明:解决循环依赖(Circular Dependency)
在 C++ 中,当两个类(如 ClassA 和 ClassB)互相持有对方的指针时,我们可以通过在头文件头部添加 class ClassB; 前向声明来解开依赖死锁。
在 Python 中,如果 module_a.py 顶层写了 from module_b import ClassB,而 module_b.py 顶层也写了 from module_a import ClassA,程序运行时就会抛出经典的:
ImportError: cannot import name 'ClassB' from partially initialized module 'module_b'。
在 Python 中替代前向声明解决循环依赖的规范手段有三种:
- 延迟局部导入(Deferred Import):不要在模块顶层导入,而是将
from module_b import ClassB移动到具体的方法或函数体内。在调用该方法时,module_b早已初始化完毕,避免了初始化期的循环锁死。 - 静态类型检查解耦(
TYPE_CHECKING):如果互相导入仅仅是为了给类型检查器提供注解,可以使用typing.TYPE_CHECKING门禁配合延迟类型解析:# parent.py from __future__ import annotations # 开启延迟类型注解求值 from typing import TYPE_CHECKING if TYPE_CHECKING: from child import Child # 仅在静态分析时导入,运行时完全跳过 class Parent: def __init__(self, name: str) -> None: self.name = name self.children: list[Child] = [] - 重新划分模块层次:将两个类所共同依赖的数据结构或抽象基类提取到独立的
types.py或protocols.py中,建立单向依赖拓扑。
四、容易混淆的认知误区与辨析
从 C/C++ 切换到 Python 的开发者,在组织模块结构时往往会把旧有经验生搬硬套,导致代码出现不必要的反模式。以下是三种最常见的认知偏差:
为什么看似合理:从表面效果看,两者都是将外部定义的函数或类引入到当前代码文件中使用。
实际差异与问题:#include 是由预处理器在编译前进行的纯文本复制展开,它没有独立作用域的概念;而 Python 的 import 是一条真正的可执行运行时语句。多次 #include 会导致编译生成多份重复代码或膨胀目标文件大小,而多次 import 仅仅是获取已经驻留内存的模块对象引用,内存与解析开销基本为零。
为什么看似合理:在 C/C++ 中,我们分发闭源二进制库时只给一个 .h 和一个 .so,使用者在物理上看不到源实现细节;而 Python 是明文分发源码或字节码,且没有严格的 private 编译关键字限制。
实际机制与纠偏:Python 遵循“大家都是成年人(We are all consenting adults here)”的设计哲学。它通过约定规范驱动而非物理编译器屏障实现封装:
- 以单下划线开头的模块名(如
_backend.py)或函数名(如_calculate_raw())是 Python 社区公认的私有 API,外部代码不应依赖; - 在
__init__.py中定义__all__列表,明确限定了from pkg import *时导出的白名单,同时在各大 IDE 中屏蔽未导出的内部符号; - 如果必须做到商业二进制级别的物理隔离,Python 社区的工业级做法是使用 Cython 将私有模块编译为 C-Extension 二进制扩展模块。
为什么看似合理:这样可以让调用方一次性访问子模块的所有内容,像 C++ 引入一个全功能的大头文件一样方便。
实际危害与修正:星号导入(Wildcard Import)会导致严重的命名空间污染,破坏模块间的依赖追踪,极易引发难以排查的命名覆盖冲突,甚至破坏 IDE 的智能重构与类型推导能力。正确的实践是:在 __init__.py 中显式挑选核心公开符号逐项导入,并显式绑定到 __all__。
五、实战演练:将 C/C++ 模块完整重构为 Python 现代包
为了更直观地展示转换过程,我们以一个常见的空间向量计算模块为例,展示其在 C++ 与 Python 中的完整代码映射。
5.1 原始 C/C++ 方案(头文件 + 源文件)
// vector3d.h (接口声明与契约)
#ifndef VECTOR3D_H
#define VECTOR3D_H

namespace math3d {

struct Vector3D {
    double x;
    double y;
    double z;
};

// 核心计算函数声明
Vector3D add_vectors(const Vector3D& a, const Vector3D& b);
double dot_product(const Vector3D& a, const Vector3D& b);

} // namespace math3d

#endif // VECTOR3D_H
// vector3d.cpp (内部逻辑实现)
#include "vector3d.h"

namespace math3d {

// 内部未暴露在头文件中的辅助函数
static bool is_valid(const Vector3D& v) {
    return true;
}

Vector3D add_vectors(const Vector3D& a, const Vector3D& b) {
    Vector3D result;
    result.x = a.x + b.x;
    result.y = a.y + b.y;
    result.z = a.z + b.z;
    return result;
}

double dot_product(const Vector3D& a, const Vector3D& b) {
    return a.x * b.x + a.y * b.y + a.z * b.z;
}

} // namespace math3d
5.2 迁移后的现代 Python 包方案
我们在工程中建立名为 math3d/ 的 Python 包,目录结构如下:
math3d/
├── __init__.py      # 对外门面:集中重导出公共接口,定义 __all__
├── vector.py        # 向量数据结构与核心计算操作
└── _helpers.py      # 私有辅助函数模块(以单下划线开头)
文件 1:私有辅助模块 math3d/_helpers.py
# math3d/_helpers.py
"""内部专用工具模块,不对外公开暴露。"""
import math

def validate_finite(*values: float) -> bool:
    """验证所有浮点参数是否为有限数。"""
    return all(math.isfinite(v) for v in values)
文件 2:核心功能模块 math3d/vector.py
# math3d/vector.py
"""三维向量数据类型与运算实现。"""
from __future__ import annotations
from dataclasses import dataclass
from ._helpers import validate_finite

@dataclass(frozen=True)
class Vector3D:
    """不可变三维向量对象。"""
    x: float
    y: float
    z: float

    def __post_init__(self) -> None:
        if not validate_finite(self.x, self.y, self.z):
            raise ValueError("向量分量必须是有限数值")

    def add(self, other: Vector3D) -> Vector3D:
        """向量加法运算。"""
        return Vector3D(self.x + other.x, self.y + other.y, self.z + other.z)

    def dot(self, other: Vector3D) -> float:
        """计算与另一向量的点乘标量积。"""
        return self.x * other.x + self.y * other.y + self.z * other.z
文件 3:统一门面导出 math3d/__init__.py
# math3d/__init__.py
"""三维数学计算库。

本文件承担 C/C++ 总对外头文件(如 math3d.h)的功能,
严格管理对外暴露的公开符号列表。
"""
from .vector import Vector3D

# 明确界定对外公共 API(替代 C++ 头文件中的公开符号声明)
__all__ = ["Vector3D"]

__version__ = "1.0.0"
调用方使用方式:
# main.py
from math3d import Vector3D

v1 = Vector3D(1.0, 2.0, 3.0)
v2 = Vector3D(4.0, 5.0, 6.0)

v3 = v1.add(v2)
print("计算结果:", v3)
print("点乘积:", v1.dot(v2))
六、总结与核心功能速查对照
将 C/C++ 项目转换为 Python 项目时,头文件并非“凭空消失”,而是被解构为更现代、更高效的运行时机制:
- 编写声明的成本被消除:通过在
.py实现中书写类型注解和规范文档,消除了“修改函数签名需要同步改动.h与.cpp两处”的人工冗余; - 防重包含由解释器内核托底:
sys.modules的单例模式确保无论依赖树多么深,模块在进程生命周期内只被加载执行一次; - 信息隐藏转向门面与约定:用
__init__.py+__all__构建清晰明了的对外界面,用单下划线命名约定划分内部与外部边界。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















