


学Python能干嘛?盘点数据分析、Web开发与自动化办公三大核心场景
全面盘点学Python最实用的三大落地场景:数据分析、Web开发与自动化办公。详细梳理各场景解决的核心问题、常用工具库、完整代码示例与常见避坑指南,助你根据实际需求明确学习方向与进阶路径。
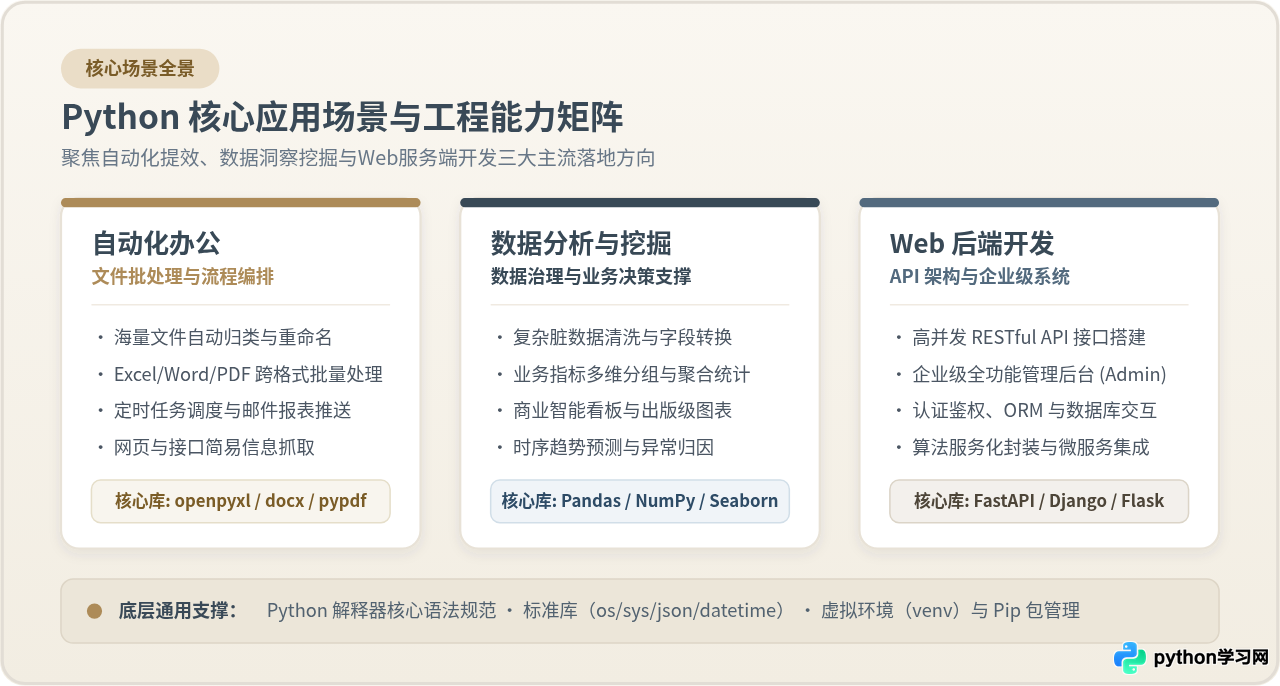
场景一:自动化办公——打破机械重复,批量接管文件与信息流转
日常工作中,许多岗位每天都需要面对海量重复的格式操作:将散落在不同部门的几十个销售 Excel 表格逐一打开、复制粘贴汇总;把数百张凭证扫描件按规则重新命名并归类到年份月份文件夹;或者在每周五下午把格式相同的报表导出成 PDF 并发邮件抄送给负责人。这些工作消耗大量精力且极易因疲劳产生人为遗漏。
自动化办公场景的核心价值,就是编写简短的 Python 脚本,让计算机严格按规则批量完成文件检索、格式转换、数据合并与定时流转,把耗时数小时的手工机械操作压缩至数秒完成。
核心工具链与能力分工
pathlib与os:Python 标准库内置模块,负责跨平台的文件路径扫描、文件名正则过滤、批量重命名与目录创建。openpyxl与pandas:用于 Excel 工作簿的精细化读写。openpyxl擅长处理单元格样式、公式与边框控制;pandas则擅长跨表格批量数据清洗与纵向拼接。python-docx与pypdf:分别用于 Word 模板的批量文本替换、表格填充,以及 PDF 文件的拆分、合并与页面提取。smtplib与email:用于自动组装 HTML 格式邮件正文、添加文件附件并安全投递到 SMTP 邮件服务器。
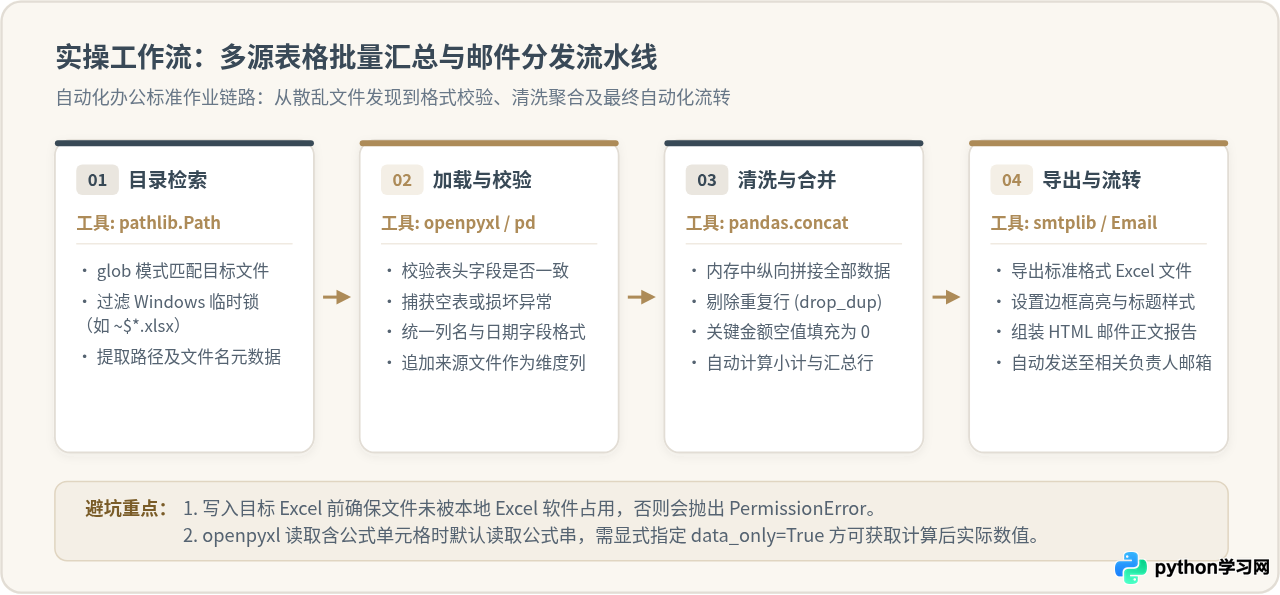
典型实操工作流:多部门销售表格自动聚合
以最常见的业务场景为例:某企业每周需汇总全国各分部的 sales_*.xlsx 文件。每个分部提交的文件结构相同,但行数不一,且存在部分空行与临时文件干扰。脚本需要自动发现有效表格、读取数据、校验列名、合并汇总并输出标准报表。
执行环境与依赖准备:在终端或命令行执行以下安装指令:
pip install openpyxl pandas完整实现代码:创建脚本文件 merge_sales.py:
# -*- coding: utf-8 -*-
from pathlib import Path
import pandas as pd

def batch_merge_sales(source_dir: str, output_file: str):
    folder = Path(source_dir)
    # 过滤以 sales_ 开头且排除 Office 临时隐藏文件(如 ~$ 开头)
    target_files = [f for f in folder.glob("sales_*.xlsx") if not f.name.startswith("~$")]

    if not target_files:
        print(f"未在目录 {source_dir} 中找到符合条件的销售表格。")
        return

    print(f"共发现 {len(target_files)} 个分部表格,准备解析合并...")
    data_list = []

    for file_path in target_files:
        try:
            # 读取第一个工作表
            df = pd.read_excel(file_path, sheet_name=0)

            # 记录来源文件名,便于后续数据审计追踪
            df["来源分部"] = file_path.stem.replace("sales_", "")

            # 剔除全为空的行
            df.dropna(how="all", inplace=True)
            data_list.append(df)
            print(f"✓ 成功加载: {file_path.name} (共 {len(df)} 行)")
        except Exception as e:
            print(f"✗ 读取文件 {file_path.name} 失败,原因: {e}")

    if not data_list:
        print("未提取到任何有效数据,终止合并。")
        return

    # 纵向合并所有数据表
    merged_df = pd.concat(data_list, ignore_index=True)

    # 填充缺失的销售额为 0,确保金额列为浮点数
    if "销售金额" in merged_df.columns:
        merged_df["销售金额"] = merged_df["销售金额"].fillna(0.0)

    # 导出到指定目标 Excel 文件
    merged_df.to_excel(output_file, index=False, engine="openpyxl")
    print(f"合并完成!总计有效记录 {len(merged_df)} 行,已保存至: {output_file}")

if __name__ == "__main__":
    batch_merge_sales("./data", "./data/weekly_summary.xlsx")
模拟运行输出:在终端执行 python merge_sales.py 后的输出:
✓ 成功加载: sales_beijing.xlsx (共 142 行)
✓ 成功加载: sales_shanghai.xlsx (共 188 行)
✓ 成功加载: sales_guangzhou.xlsx (共 96 行)
合并完成!总计有效记录 426 行,已保存至: ./data/weekly_summary.xlsx
1. 文件占用锁(PermissionError):在 Windows 环境下,若被处理的文件已在本地 Excel 软件中处于打开状态,Python 在尝试保存写入时会抛出 PermissionError: [Errno 13] Permission denied。务必在脚本运行前关闭文件,或在代码中使用 try...except PermissionError 给出明确提示。
2. 公式单元格只读出文本:使用 openpyxl.load_workbook(filename, data_only=True) 读取含 =SUM(...) 公式的值时,只有该 Excel 在此之前曾被人工打开并保存过,缓存中才存有计算值;若该文件是其他第三方系统直接生成的,缓存值可能为 None。
场景二:数据分析——从混乱数据到商业洞察与决策看板
当业务数据量达到几十万甚至数百万行时,传统桌面电子表格软件会出现明显的卡顿、假死乃至无法打开的情况。此外,业务日志往往跨越关系型数据库、第三方接口与埋点上报,字段杂乱、时间格式不一、存在大量缺失值与重复项。
数据分析场景的核心,是运用 Python 构建高内聚的数据处理流水线。借助底层的矢量化运算能力,Python 可以在数秒内完成百万级数据的格式转换、缺失值清洗、多表联合(Join)以及复杂的分组聚合运算,并通过直观图表揭示业务指标的波动规律。
核心工具链与架构分层
NumPy:提供高性能的连续内存多维数组对象(ndarray)与广播运算机制,为所有上层数据科学库提供底层 C 语言级别的算力支撑。Pandas:数据分析的基石工具,核心数据结构为DataFrame。支持类似 SQL 的多表合并、透视表(Pivot Table)、滑动窗口统计与时序切片。Matplotlib与Seaborn:专业统计绘图库。Matplotlib提供像素级别的图形参数控制;Seaborn则内置了高级统计图表(如箱线图、分布密度图、相关系数热力图)。Plotly/Streamlit:用于构建 Web 交互式动态数据大屏,读者可以通过鼠标缩放、悬停查看明细,并导出高清图表。
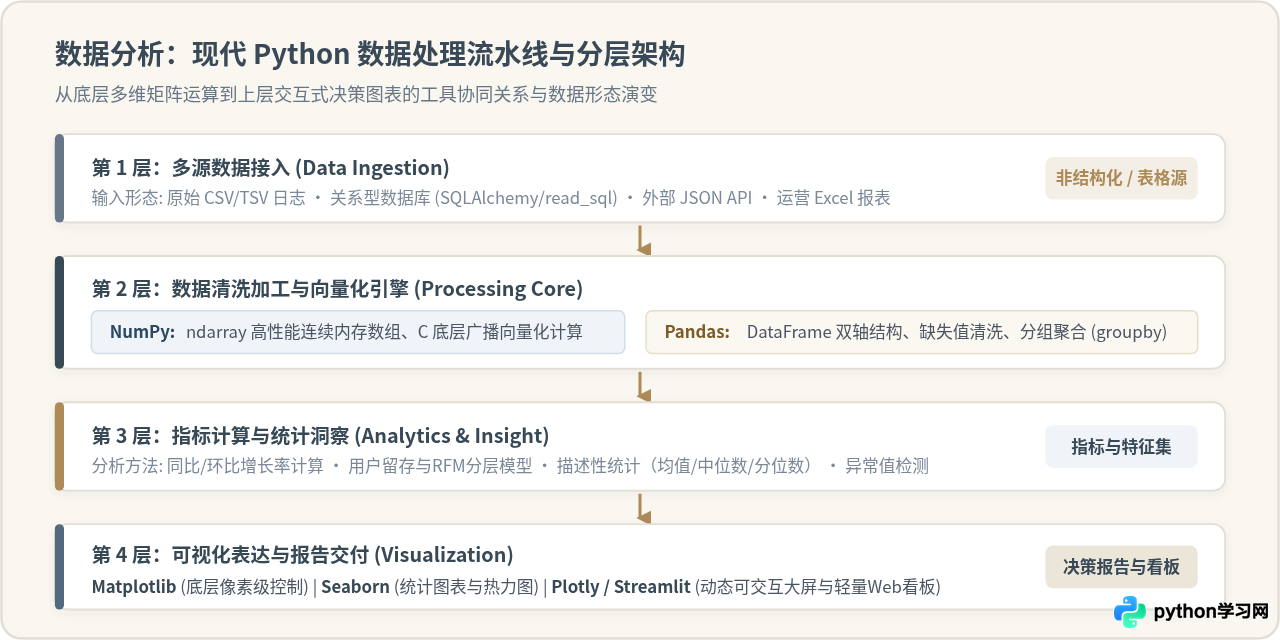
典型实操工作流:订单时序趋势与月度环比计算
业务场景需求:从系统导出的原始订单 CSV 文件中,提取有效下单记录,按月份进行分组聚合,统计每个月的订单总量、总销售额,并自动计算销售额的月度环比增长率(MoM)。
安装依赖:
pip install pandas numpy matplotlib完整实现代码:创建脚本文件 sales_trend_analysis.py:
# -*- coding: utf-8 -*-
import pandas as pd
import numpy as np

def analyze_monthly_trends(csv_path: str):
    # 加载 CSV 数据并自动解析日期列
    df = pd.read_csv(csv_path, parse_dates=["order_time"])

    # 数据清洗:仅保留已支付订单,剔除退款和测试记录
    clean_df = df[df["status"] == "PAID"].copy()

    # 提取年-月维度周期字段
    clean_df["order_month"] = clean_df["order_time"].dt.to_period("M")

    # 分组聚合:计算各月订单数与总销售额
    monthly_summary = clean_df.groupby("order_month").agg(
        order_count=("order_id", "count"),
        total_revenue=("amount", "sum"),
        avg_order_value=("amount", "mean")
    ).reset_index()

    # 计算月度销售额环比增长率 (pct_change)
    monthly_summary["revenue_mom_growth"] = monthly_summary["total_revenue"].pct_change() * 100

    # 格式化输出呈现
    print("=== 核心月度销售趋势报表 ===")
    for _, row in monthly_summary.iterrows():
        month_str = str(row["order_month"])
        revenue = row["total_revenue"]
        count = int(row["order_count"])
        mom = row["revenue_mom_growth"]
        mom_text = f"{mom:+.2f}%" if pd.notna(mom) else "基准月 (N/A)"
        print(f"月份: {month_str} | 订单量: {count:4d} 笔 | 总额: ¥{revenue:10,.2f} | 环比增长: {mom_text}")

    return monthly_summary

if __name__ == "__main__":
    analyze_monthly_trends("./data/raw_orders.csv")
模拟运行输出:在终端执行 python sales_trend_analysis.py 后的示例输出:
月份: 2026-01 | 订单量: 1250 笔 | 总额: ¥215,800.00 | 环比增长: 基准月 (N/A)
月份: 2026-02 | 订单量: 1080 笔 | 总额: ¥189,400.00 | 环比增长: -12.23%
月份: 2026-03 | 订单量: 1460 笔 | 总额: ¥268,900.00 | 环比增长: +41.97%
月份: 2026-04 | 订单量: 1620 笔 | 总额: ¥295,400.00 | 环比增长: +9.86%
1. 链式赋值警告(SettingWithCopyWarning):对 df[df["status"]=="PAID"]["amount"] = 0 这种先切片再赋值的操作,Pandas 会警告用户无法确认是在原 DataFrame 还是副本上修改。正确做法是使用 .loc[condition, "col"] = value,或者在切片后显式调用 .copy() 创建独立副本。
2. 内存占用过大导致 OOM:Pandas 在读取 CSV 时默认将数值列识别为 64 位类型(int64 / float64)。当数据量达到千万级时,在 read_csv 中指定 dtype(如将基数小的字符串改为 category,整数改为 int32)可减少 50% 以上内存消耗。
场景三:Web 开发——构建从轻量 API 到全功能企业级系统
随着业务的推进,单纯的本地运行脚本和离线分析往往无法满足协同需求:内部运营需要随时登录后台查看最新统计数据;移动端前端需要标准化接口获取数据;算法同学需要将写好的计算逻辑封装为云端在线服务供其他业务系统调用。
Python 在 Web 后端开发领域的最大特色是开发效率极高与框架选型边界清晰。无论是几行代码启动的微型服务,还是拥有全套用户权限与后台管理的企业级平台,Python 都有成熟工业级的框架支撑。
主流 Web 框架特性与适用边界
FastAPI:现代化基于异步(asyncio)与 Python 类型注解(Type Hints)的高性能 API 框架。原生支持 OpenAPI / Swagger 文档自动化生成,数据序列化由 Pydantic 驱动,是当前微服务和前后端分离架构的首选。Django:全功能大而全的全栈框架。自带完善的 ORM、用户鉴权体系、CSRF 安全防护以及自动生成的 Admin 管理后台,极度适合快速交付中大型企业级内后台管理系统。Flask:轻量级微框架。核心极为精简,给开发者提供极大的自由度,常用于封装单个算法模型、制作轻量工具链或在资源受限的环境中提供简单 HTTP 钩子。
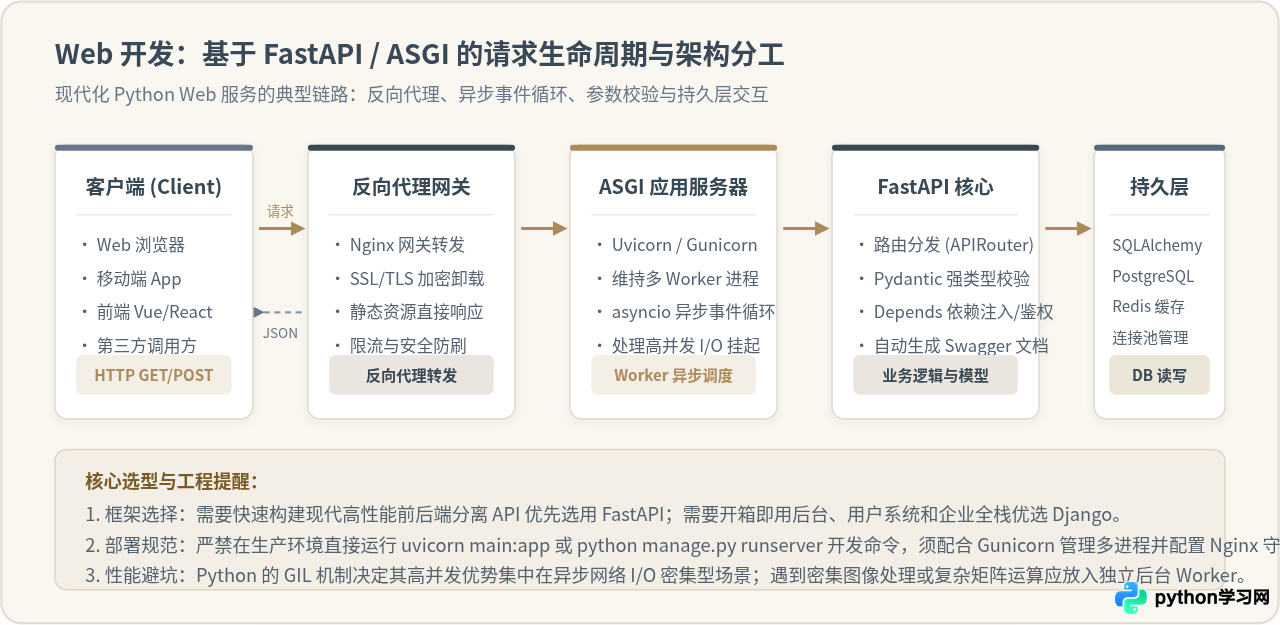
典型实操工作流:使用 FastAPI 构建带参数校验的 RESTful API
业务需求:构建一个根据商品 ID 查询明细并支持新增订单的微服务接口。接口需对客户端传入的 JSON 数据进行强类型校验(如金额不能为负数、必须有商品名称),校验失败自动返回清晰的 HTTP 422 错误信息,并在浏览器中自动提供在线交互式测试文档。
安装依赖:
pip install fastapi uvicorn pydantic完整实现代码:创建服务脚本 main_api.py:
# -*- coding: utf-8 -*-
from fastapi import FastAPI, HTTPException, status
from pydantic import BaseModel, Field
from typing import Optional
from datetime import datetime

app = FastAPI(
    title="商业分析与订单服务 API",
    description="提供基于 FastAPI 的现代化轻量数据查询与录入服务",
    version="1.0.0"
)

# 内存数据存储(示例使用,实际场景连接数据库)
fake_db = {
    101: {"item_id": 101, "name": "机械键盘", "price": 499.0, "stock": 25},
    102: {"item_id": 102, "name": "4K显示器", "price": 2399.0, "stock": 10}
}

# 定义输入校验模型
class ItemCreate(BaseModel):
    name: str = Field(..., min_length=2, max_length=50, description="商品名称")
    price: float = Field(..., gt=0, description="单价,必须大于0")
    stock: int = Field(default=0, ge=0, description="库存数量")

@app.get("/items/{item_id}", summary="根据商品ID查询详情")
async def get_item(item_id: int):
    if item_id not in fake_db:
        raise HTTPException(
            status_code=status.HTTP_404_NOT_FOUND,
            detail=f"商品 ID {item_id} 不存在"
        )
    return fake_db[item_id]

@app.post("/items", status_code=status.HTTP_201_CREATED, summary="录入新商品")
async def create_item(payload: ItemCreate):
    new_id = max(fake_db.keys(), default=100) + 1
    new_record = {
        "item_id": new_id,
        "name": payload.name,
        "price": payload.price,
        "stock": payload.stock,
        "created_at": datetime.now().isoformat()
    }
    fake_db[new_id] = new_record
    return {"message": "商品创建成功", "data": new_record}
启动服务命令:在终端运行:
uvicorn main_api:app --host 127.0.0.1 --port 8000 --reload模拟客户端请求与响应:使用 curl 发送请求测试新增商品接口:
curl -X POST "http://127.0.0.1:8000/items" -H "Content-Type: application/json" -d '{"name": "人体工学椅", "price": 1280.0, "stock": 15}'Content-Type: application/json
{"message":"商品创建成功","data":{"item_id":103,"name":"人体工学椅","price":1280.0,"stock":15,"created_at":"2026-11-01T07:30:00.123456"}}
1. 开发服务器严禁直接上生产:uvicorn main:app --reload 仅供本地开发调试。生产环境必须使用 Gunicorn 作为多进程进程管理器(Process Manager),挂载 Uvicorn Worker,并前置 Nginx 处理静态资源与反向代理。
2. GIL 机制与异步非阻塞的边界:FastAPI 的高并发优势在于等待网络请求、数据库 I/O 时的异步挂起。如果在异步路由处理函数中执行耗时 5 秒的纯 CPU 密集运算(如大量循环、深度学习推理),会导致整个事件循环阻塞。该类任务必须通过 run_in_threadpool 或异步任务队列(Celery)卸载到工作进程。
场景四:三大场景选型指南——如何根据自身背景选择学习路径
面对三个成熟的应用方向,初学者往往陷入“什么都想学,最后什么都没掌握”的困境。三大场景之间既有互通的底层基础,又有着显著不同的知识树重心和见效周期。
| 对比维度 | 自动化办公 | 数据分析与挖掘 | Web 后端开发 |
|---|---|---|---|
| 前置知识门槛 | 极低(基础语法与循环即可) | 中等(需理解表格关系与基础统计) | 进阶(需理解网络协议与数据库) |
| 核心工具库 | pathlib, openpyxl, docx | NumPy, Pandas, Seaborn | FastAPI, Django, SQLAlchemy |
| 典型产出成果 | 本地批量自动化脚本、定时任务 | 清洗后数据集、动态统计图表与洞察看板 | 标准化 REST API 接口、Web 业务管理后台 |
| 初见成效周期 | 1 ~ 2 周(即学即用) | 1 ~ 2 个月(需结合业务数据实操) | 2 ~ 4 个月(需掌握完整工程链路) |
| 最适宜目标人群 | 职能部门、行政运营、财务报表人员 | 业务分析师、产品运营、金融/科研人员 | 全栈/后端工程师、技术创业者 |
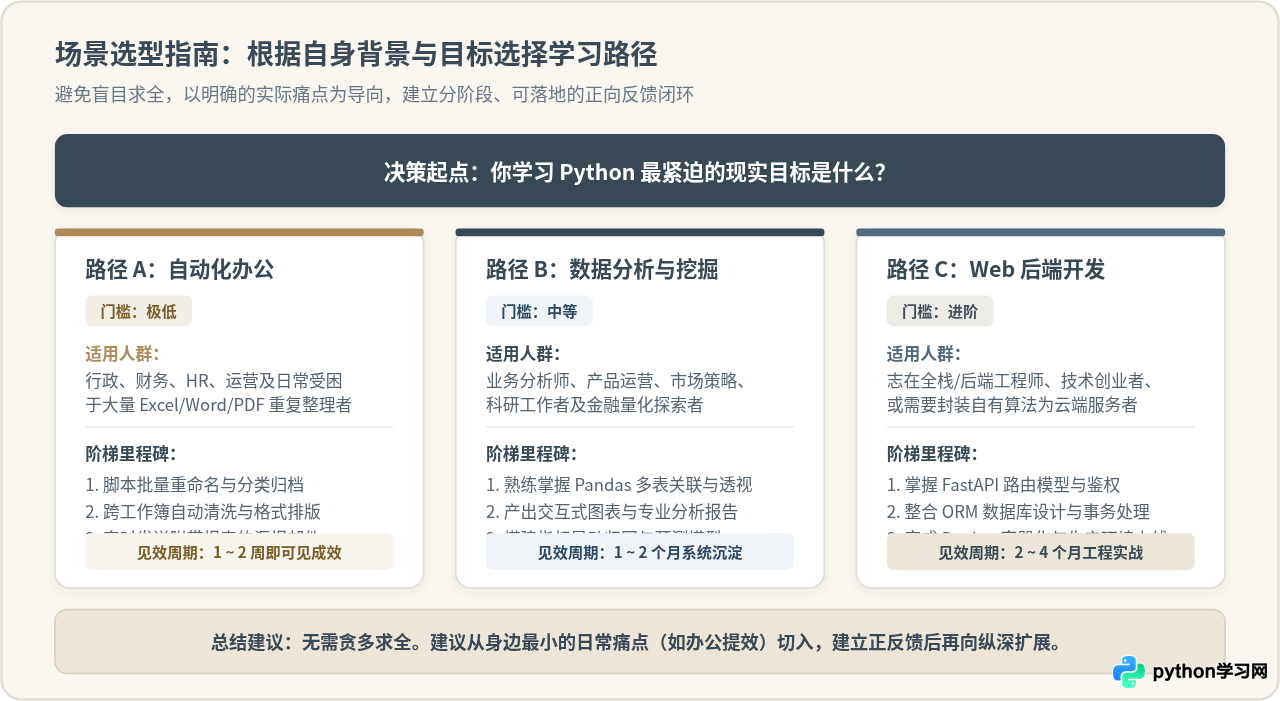
针对不同背景读者的具体落地建议
- 非技术岗位、日常有大量重复电脑操作:建议直接从自动化办公切入。不需要一上来硬啃面向对象编程或设计模式,先学会用
pathlib批量重命名文件,用openpyxl合并三张表。这种立竿见影的“今天学完,明天少加班一小时”的正向反馈,是持续学习的最强动力。 - 业务运营、市场策略、科研与金融从业者:建议选择数据分析方向。跳过复杂的服务器配置与网络底层,把精力集中在
Pandas的多表关联、透视表分析与可视化表达上。掌握从业务问题出发、用数据验证假设的能力,比单纯编写代码更具职业杠杆效应。 - 计算机专业、志在从事全职软件开发或产品落地:建议系统化攻坚 Web 后端开发。从 HTTP 协议与 RESTful 规范入手,熟练掌握 FastAPI 或 Django 框架,深入理解关系型数据库索引与事务设计,并学习 Docker 容器化打包与 Linux 部署运维,构建起扎实可靠的现代后端工程化能力。
总结:以用促学,建立属于自己的正反馈闭环
学习编程最怕陷入“语法书翻了三遍,却连一个实际文件都处理不了”的空转状态。Python 的最大优势在于其丰富的武器库早已为各行各业的痛点准备好了现成的轮子。
不必追求一次性精通所有方向。找到你当前工作生活里最痛苦、最枯燥的一个具体节点——无论是一堆待合并的 Excel 表格、一份需要整理的销售日志,还是一个需要向外提供数据的接口——用 Python 把它攻克下来。当第一个自动化脚本成功跑通时,你对这门语言的真正掌握才刚刚开始。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















