


Python跨目录导入py文件:相对导入与绝对导入的区别
深入解析Python跨目录导入py文件时的绝对导入与相对导入机制,对比sys.path物理路径寻址与__name__包命名空间的本质差异,剖析常见导入报错原因与工程规范最佳实践。
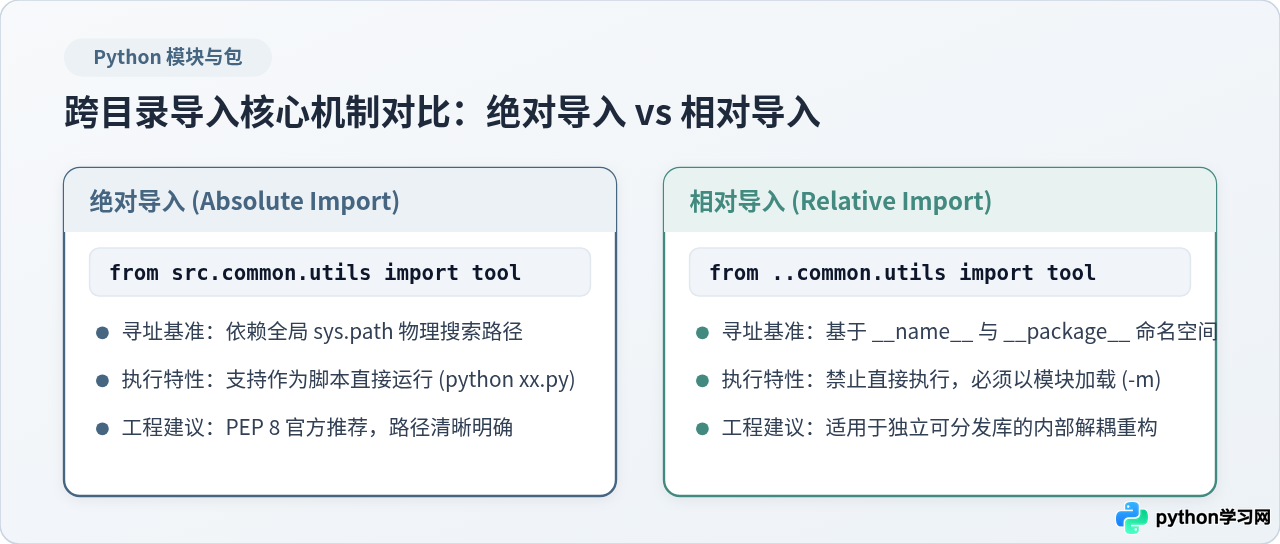
在 Python 项目日益庞大的开发过程中,跨越不同文件夹层级调用其他 .py 文件的函数或类是极为常见的需求。实现跨目录导入通常有两种官方语法:绝对导入(Absolute Import)与相对导入(Relative Import)。两者的根本区别在于寻址基准不同:绝对导入以全局搜索路径(sys.path)为基准自顶向下匹配;相对导入则完全脱离 sys.path,严格依赖当前模块自身的包元数据(__name__ 和 __package__)沿着目录树做相对跳跃。理解这一本质差异,能够从源头上避免 ModuleNotFoundError 和 ImportError: attempted relative import with no known parent package 等高频报错。
一、跨目录导入的标准工程场景与目录结构
为了让跨目录导入的探讨具备实际工程意义,我们设定一个标准的企业级小型 Python 项目。假设项目根目录为 my_project,其内部组织了多个业务子包:
my_project/
├── main.py                     # 项目顶层统一运行入口
└── src/                        # 核心代码包
    ├── __init__.py
    ├── common/                 # 公共工具包
    │   ├── __init__.py
    │   └── utils.py            # 提供 clean_data 工具函数
    └── services/               # 业务服务包
        ├── __init__.py
        └── processor.py        # 业务处理模块(调用方)
核心需求非常明确:我们希望在 processor.py 模块中,跨越同级分支目录调用 common/utils.py 中定义的 clean_data() 函数。此时便涉及到跨目录导入的寻址路径抉择。
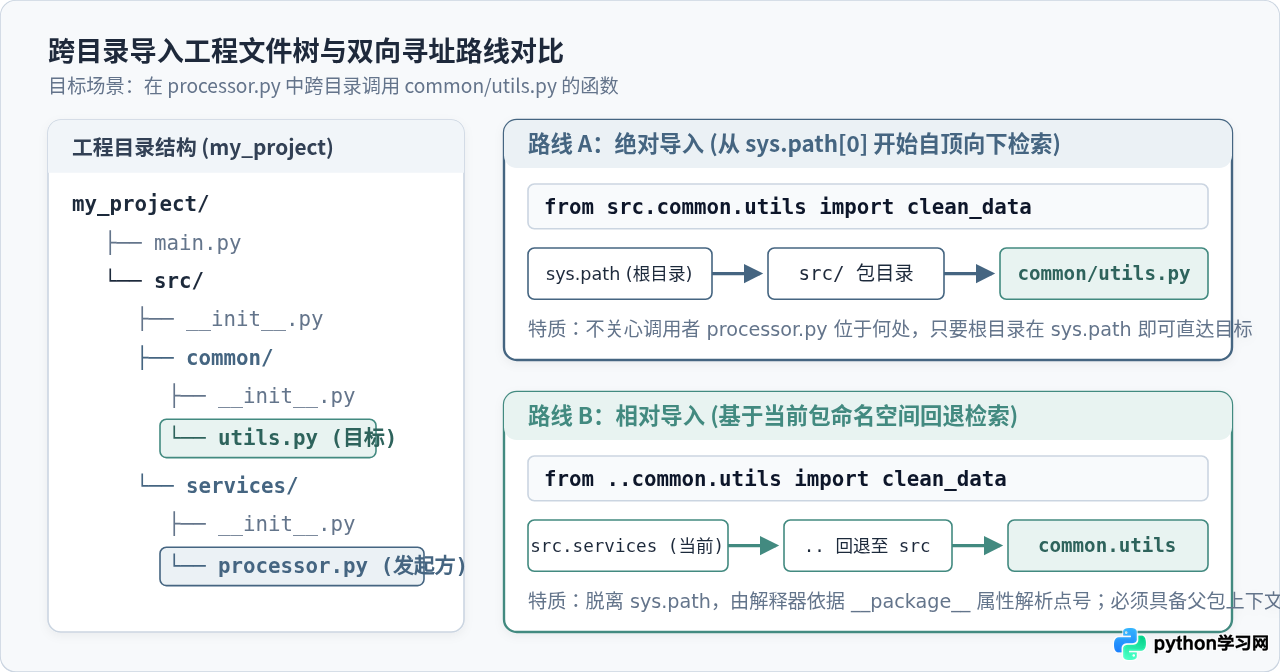
如上图所示,从 processor.py 访问 utils.py,绝对导入从顶层根路径开始一层层向下穿透;而相对导入则以当前所在模块为原点,使用点号 .. 向上一层回退到 src 包,再向下转入 common 子包。两种方式对应着完全不同的解释器解析逻辑。
二、绝对导入(Absolute Import):基于 sys.path 的全局索引
绝对导入是指通过指定从项目顶层包或系统路径起点开始的完整层级路径来引入模块。其语法形式非常直观:
# 形式一:直接导入目标函数
from src.common.utils import clean_data

# 形式二:导入模块别名
import src.common.utils as utils

def run_task():
    raw = "  hello world  "
    result = clean_data(raw)
    print(f"处理结果: {result}")
1. 绝对导入的工作原理与 sys.path 搜索机制
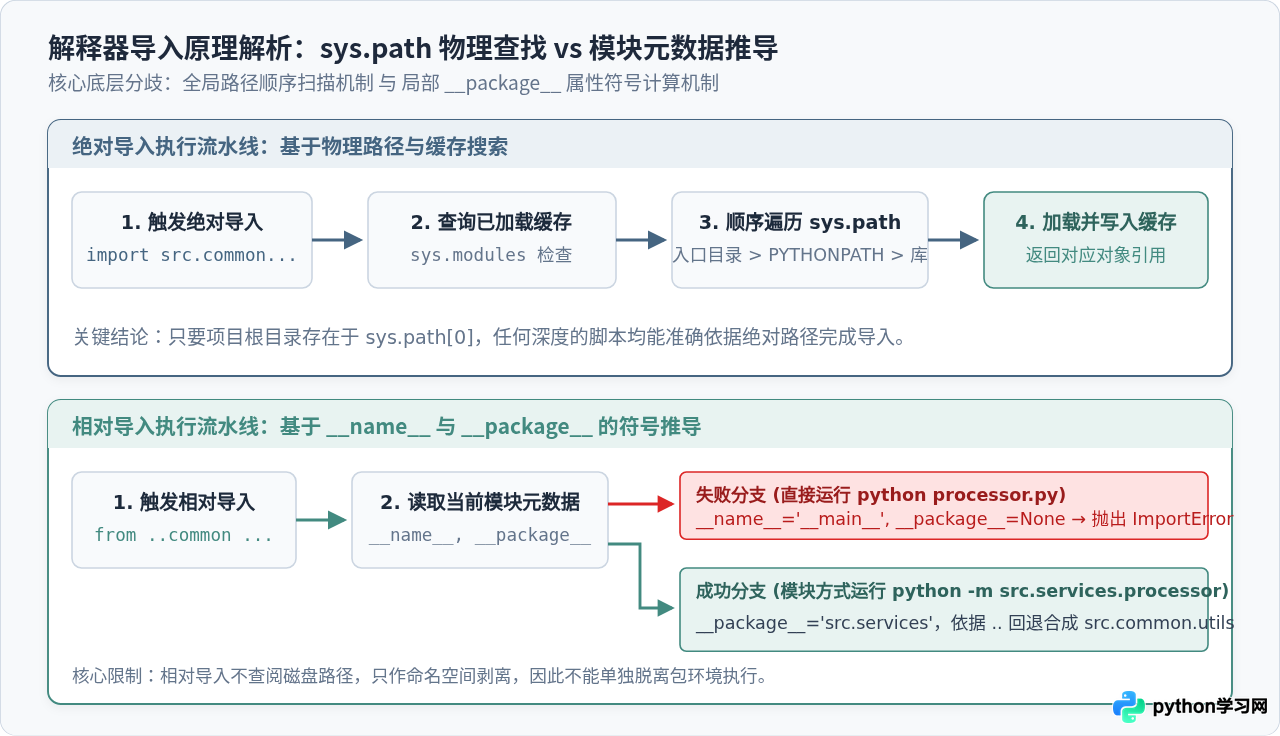
当 Python 解释器执行到绝对导入语句时,它会依次检索 sys.path 列表中的所有物理目录。sys.path 包含了三个主要来源:
- 当前入口脚本所在目录:即
sys.path[0]。例如直接运行python main.py时,my_project目录会被自动置为首位。 - PYTHONPATH 环境变量:用户或系统显式声明的目录列表。
- Python 标准库与第三方库目录:即全局或虚拟环境下的
site-packages。
解释器沿着 sys.path 的目录列表寻找名为 src 的目录或包,找到后再深入到 common,最终定位并执行 utils.py。
三、相对导入(Relative Import):基于 __name__ 与包层级的局部索引
相对导入不依赖物理搜索路径,而是使用前导点号(.)表明目标模块相对于当前模块文件的相对位置。语法中的点号规则如下:
- 单个点(
.):代表当前模块所在的同级包(同一目录)。 - 两个点(
..):代表上一级父包(上层目录)。 - 三个点(
...):代表上上级祖父包,以此类推。
# 当前 processor.py 位于 src/services/ 目录下
# 两个点 '..' 回退至上一级父包 src,再进入 common.utils
from ..common.utils import clean_data

def run_task():
    raw = "  relative import test  "
    result = clean_data(raw)
    print(f"处理结果: {result}")
1. 相对导入的底层解析机理
很多初学者会误以为相对导入类似于操作系统的相对路径(cd ../common),但其实 Python 相对导入完全不查阅文件系统的物理路径。它完全依赖当前模块运行时的两个内置属性:__name__ 和 __package__。
当解释器加载一个模块时,若该模块作为包的一部分被引入,其 __package__ 会被记录为其所属的完整包命名空间(例如 src.services)。当遇到 .. 时,解释器会对命名空间字符串执行截断操作:去掉最后一节 services,保留 src,然后再将后半段 common.utils 拼接上去,计算出目标模块的完整标识符 src.common.utils,最终交由全局导入器加载。
四、绝对导入与相对导入的核心区别
为了在实际工程中做出正确的选型,我们需要从寻址底层、执行方式、重构影响等核心维度进行系统对比:
| 对比维度 | 绝对导入 (Absolute Import) | 相对导入 (Relative Import) |
|---|---|---|
| 寻址依据 | 依赖 sys.path 物理目录列表中的搜索路径自顶向下查找。 |
依赖当前模块运行时的 __name__ 与 __package__ 符号命名空间。 |
| 直接作为独立脚本运行 | 支持。只要项目根目录位于 sys.path 中,即可通过 python script.py 执行。 |
严格不支持。直接运行脚本会导致 __name__ == '__main__',立即抛出 ImportError。 |
| 模块化执行 (-m) | 完美支持,如 python -m src.services.processor。 |
必须使用 -m 参数,以保留模块所处的完整包上下文元数据。 |
| 顶层包重命名影响 | 较大。如果顶层包 src 变更为 core,所有绝对导入语句均需同步修改。 |
极小。包内部的相对引用关系不受外部顶层包重命名或嵌套位置变更的影响。 |
| 代码可读性与复用度 | 极高。路径无歧义,复制到任何地方都能明确指出依赖来源。 | 一般。在深层目录嵌套中使用较多点号(如 ...)容易导致混淆。 |
| PEP 8 规范倾向 | 官方明确推荐作为默认方式。 | 仅在复杂的模块间紧密协同、且避免硬编码包名时作为补充使用。 |
五、跨目录导入的标准操作流程与正确执行方式
理解了理论区别后,如何在终端中正确执行包含跨目录导入的代码?下面展示标准化的四步落地流程:
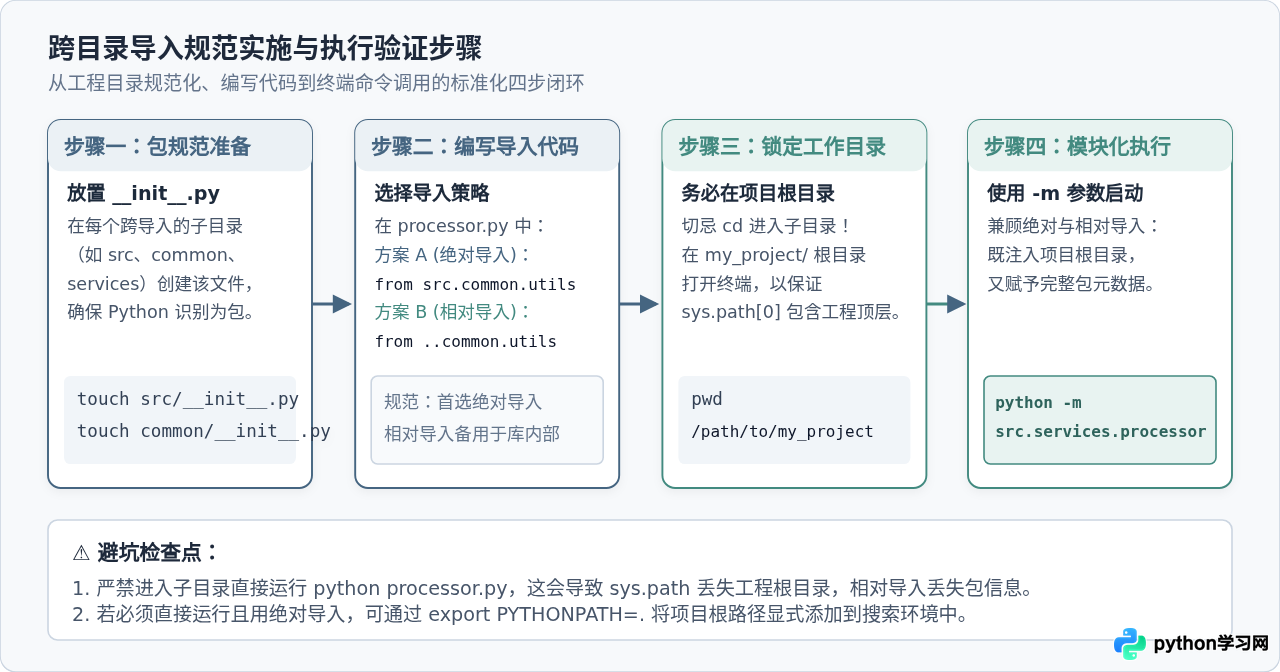
步骤一:完善包标识文件
确保每一个作为包的子文件夹都创建了 __init__.py 文件。尽管在现代 Python 3.3+ 引入了隐式命名空间包,但显式保留 __init__.py 是保障跨目录导入和 IDE 代码跳转稳定的最佳实践。
步骤二:在项目根目录启动
这是 90% 跨目录导入报错的根源。很多开发者习惯 cd 进入深层子目录执行命令,导致当前工作目录丢失了对项目根节点的认知。正确的做法是始终将终端保持在项目根目录 my_project/:
# 确认当前终端工作目录为项目根目录
cd /path/to/my_project
pwd
# 输出示例: /Users/developer/my_project
步骤三:选用正确的启动命令
根据导入方式的不同,执行命令存在关键分歧:
情况 A:项目使用【绝对导入】
在根目录可以通过项目的统一入口执行,也可以通过模块参数执行:
# 推荐方式 1:通过主程序入口启动
python main.py

# 推荐方式 2:使用 -m 模块方式调用业务脚本
python -m src.services.processor
情况 B:项目使用【相对导入】
若 processor.py 内部编写了 from ..common.utils import clean_data,则绝对不能直接运行 python src/services/processor.py!必须使用 -m 参数,并将包层级以点号语法传入:
# 正确命令:保留模块在 src.services 中的完整包命名空间
python -m src.services.processor

# 错误示范(切勿使用):
# python src/services/processor.py
# 报错: ImportError: attempted relative import with no known parent package
六、高频报错原因剖析与精准排查指南
1. ImportError: attempted relative import with no known parent package
错误表现:在终端运行 python src/services/processor.py 时触发该异常。
根本原因:当一个 .py 文件被作为主程序直接执行时,Python 解释器会将该模块的内置属性 __name__ 强制重置为字符串 "__main__",同时其 __package__ 属性被置为 None。当代码遇到 from ..xxx import yyy 时,解释器发现当前模块根本没有已知的父包(no known parent package),因此无法向上回退,只能抛出异常。
- 推荐修复:不要将包含相对导入的文件直接作为脚本启动。保持在项目根目录,使用
python -m src.services.processor执行。 - 彻底解决:如果该脚本确实需要经常单独调试或作为独立命令行工具执行,请将内部所有的相对导入改写为绝对导入。
2. ValueError: attempted relative import beyond top-level package
错误表现:在调用代码时抛出 ValueError,提示相对导入超出了顶层包范围。
根本原因:点号数量过多。例如在 src/services/processor.py 中写了 from ...common import utils(三个点)。解释器首先回退到 src(两个点),第三个点试图继续向上跳出 src,但 src 已经是运行环境所能识别的顶级包边界,无法继续向上索引。
排查修复方案:仔细核对文件深度与点号数量:1 个点为当前层级,2 个点为上一层级。避免跨越项目根包进行相对导入。
3. ModuleNotFoundError: No module named 'src'
错误表现:使用绝对导入 from src.common.utils import clean_data 时提示找不到 src 模块。
根本原因:解释器的 sys.path 列表中不包含包含 src 文件夹的父级目录(即 my_project)。常见于开发者 cd src/services/ 后直接执行代码。
排查修复方案: 返回项目根目录运行,或者在运行前通过环境变量将当前工程根路径显式添加到搜索环境中:
# Linux / macOS 临时注入 PYTHONPATH
export PYTHONPATH=.
python src/services/processor.py

# Windows PowerShell
$env:PYTHONPATH="."
python src/services/processor.py
七、工程选型指南与 PEP 8 实践建议
在企业级工程中,我们究竟应当在何时选用绝对导入,何时选用相对导入?我们可以通过以下决策流来指导日常开发:
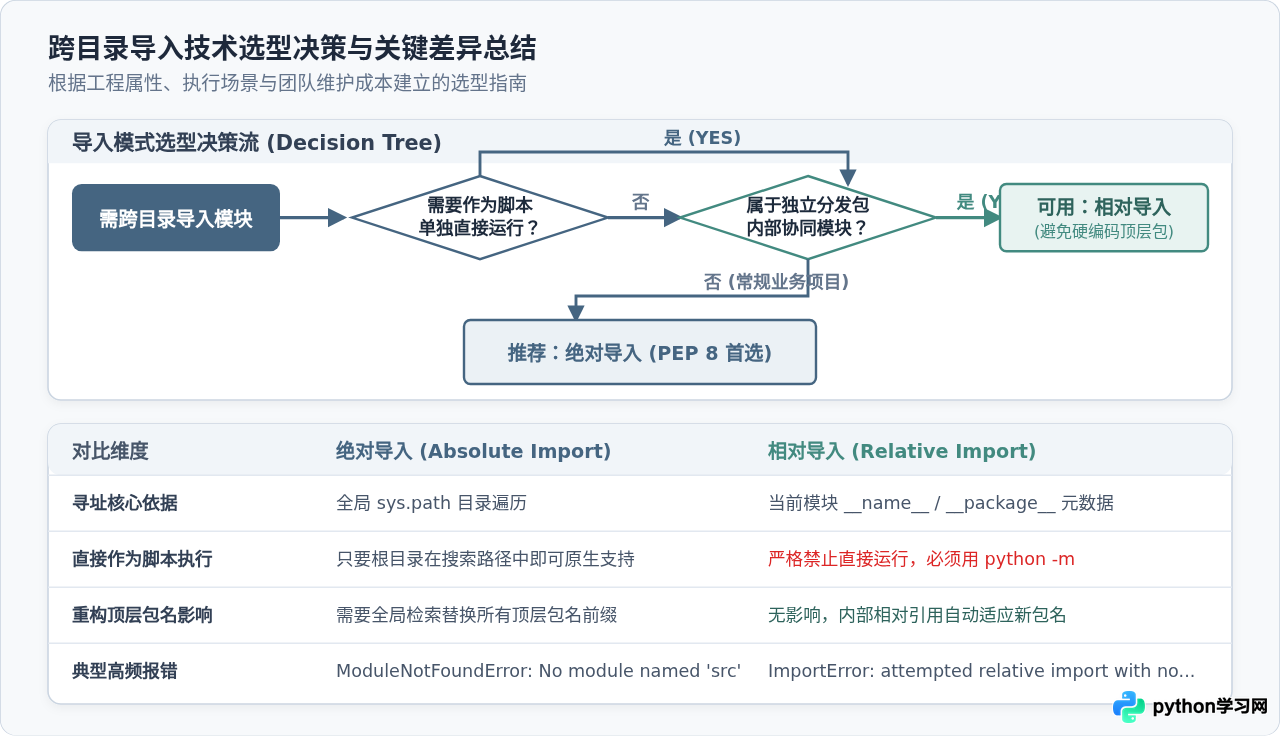
1. 坚决选用绝对导入的场景
- 业务应用程序开发:如 Django/FastAPI 后端服务、数据分析处理工作流、机器学习训练流水线等。业务代码各层级清晰,使用绝对导入便于跨模块跳转与代码审查。
- 需要作为命令行入口或单元测试独立调用的脚本:绝对导入允许文件直接被调用或被测试框架加载,免去了复杂的模块上下文配置。
- 团队协作项目:绝对导入对代码阅读最为友好,能有效防止新成员因相对路径点号数错而引发困惑。
2. 适合使用相对导入的场景
- 通用第三方库或独立 SDK 内部:对于准备打包发布到 PyPI 的开源库,库内部的子模块之间推荐使用显式相对导入。这可以保证当用户把你的库重命名或作为子模块嵌入其它系统时,库内部的代码引用不会因为顶层包名改变而崩溃。
- 高度内聚的深层子包内部:如一个
auth子包内部包含models.py、views.py和helpers.py,在views.py中使用from .models import User可以减少长包名前缀的视觉干扰。
八、日常开发检查清单(Checklist)
- 优先默认绝对导入:除非是封装可分发库的内部子模块,否则一律首选从项目根目录开始的绝对导入。
- 保持终端位于根目录:任何命令执行操作,都应在项目根目录完成,避免进入子目录直接运行 Python 脚本。
- 善用 python -m 执行:调试非顶层脚本时,使用
python -m 包名.子包名.模块名代替直接路径执行,确保包命名空间完整。 - 补齐包标记 __init__.py:为项目内每个子文件夹建立
__init__.py,确保构建工具和各类 IDE 具备一致的包识别机制。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















