


Python基于AST抽象语法树实现代码查重思路
详细讲解如何利用Python内置的ast模块实现代码查重。从文本匹配的缺陷讲起,深入阐明AST语法树解析、树节点清洗与归一化、特征提取及相似度计算的完整思路与工程落地实现。
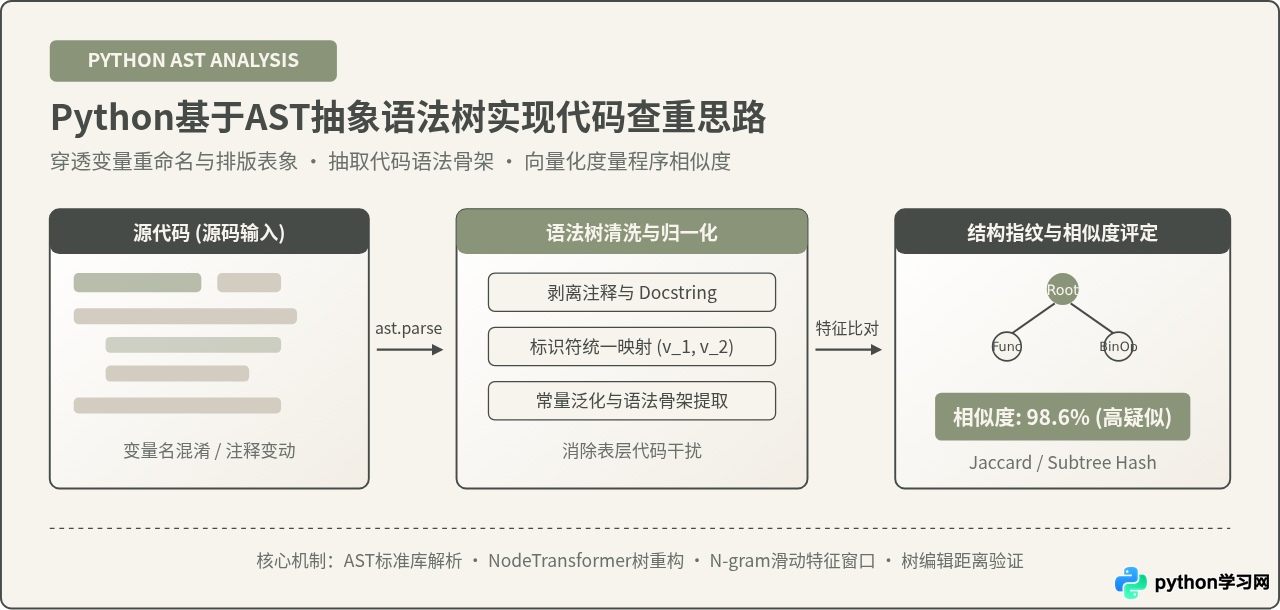
一、为什么文本比对在代码查重中频频失效
很多初学者在考虑代码查重时,往往会首先想到使用文本 Diff 算法、字符串编辑距离(Levenshtein Distance)或者提取代码文本的 MD5/SHA256 哈希。这类方法在常规文本文档检测中表现良好,但在处理程序源代码时却极度脆弱。
根本原因在于:源代码是具备高度结构化与逻辑等价性的符号文本。对于 Python 解释器而言,以下两段代码在运行语义和语法骨架上几乎完全等价,但在字面文本层面却大相径庭:
# 代码片段 A
def calculate_average(scores):
    """计算列表平均分"""
    total = sum(scores)
    count = len(scores)
    return total / count

# 代码片段 B(经过常见的初级改写伪装)
def get_mean_val(data_list):
    # 先对所有数值累加
    res_sum = sum(data_list)
    # 获取总数量并返回商
    res_len = len(data_list)
    return res_sum / res_len
如果使用文本行对比或字符相似度算法,代码 A 与代码 B 的相似度往往不到 40%,因为函数名、形参名、局部变量名全部被替换,且增加了多处注释行。然而,只要把它们送入 Python 的语法解析阶段,两者的语法结构是完全一致的:都是一个包含两个参数引用的函数定义,内部包含两次函数调用、两次局部赋值与一次除法返回。
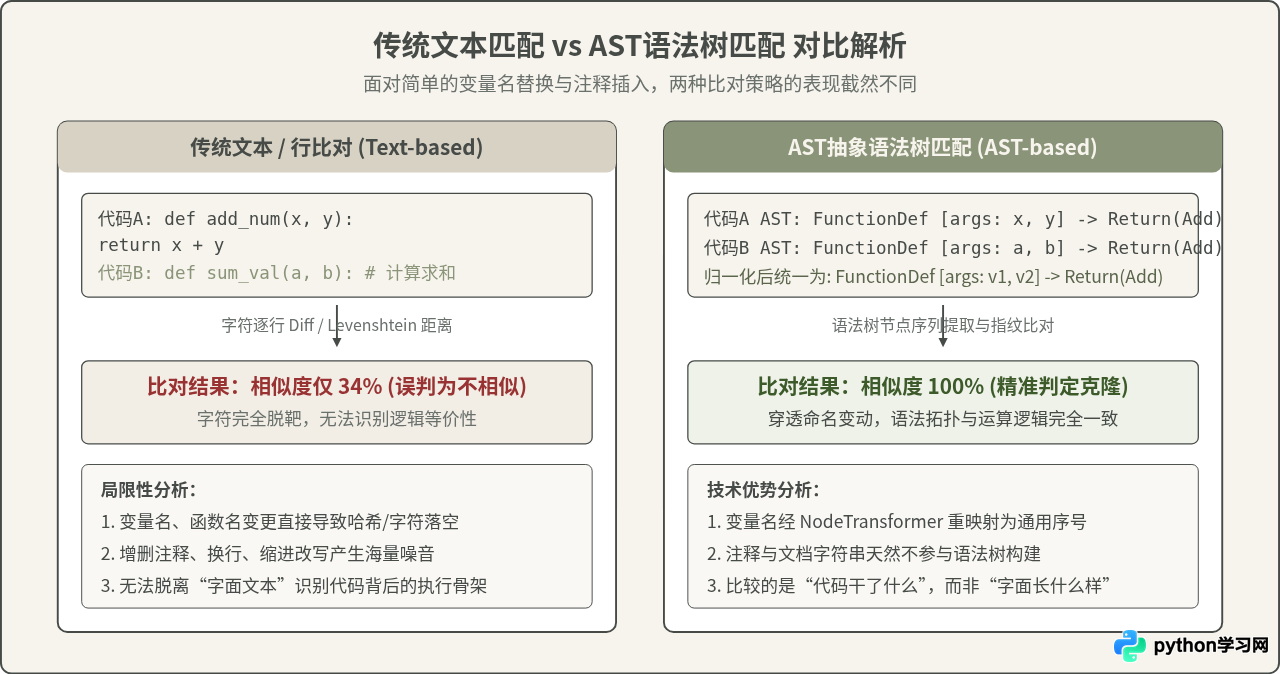
AST 抽象语法树是编译器与解释器前端将词法单元(Tokens)按照语言的形式文法(Grammar)组织起来的树状数据结构。在 AST 中,所有的空格、缩进、行号和注释都被过滤或抽离,只保留节点类型(如 FunctionDef、Assign、BinOp)及其层级归属。这就为穿透字面伪装、比对代码逻辑骨架提供了坚实基础。
二、AST代码查重的核心处理流程
实现一套实用的基于 AST 的 Python 代码查重工具,通常需要经过四个关键阶段:源码解析、语法树清洗与归一化、特征提取与向量化以及相似度度量与判定。
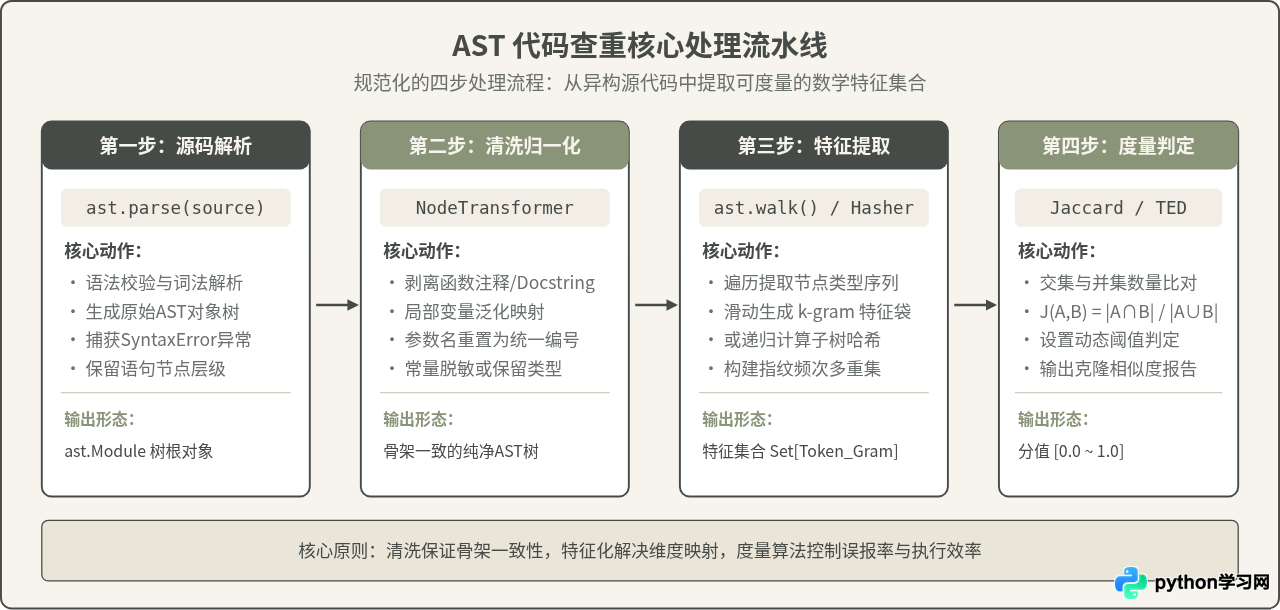
1. 源码解析为语法树对象
Python 官方标准库自带了极其强大的 ast 模块。通过调用 ast.parse(source_code),即可在内存中直接获得以 ast.Module 为根节点的树形对象。如果待测代码存在语法错误(如缺少冒号或括号不闭合),解析器会抛出 SyntaxError。在工程实现中,必须捕获该异常并记入异常日志,避免中断批量查重流程。
2. 语法树清洗与归一化(核心脱敏)
原始的 AST 节点虽然剔除了常规行内注释,但仍然保留了函数与类的 Docstring、具体的变量名(Name.id)以及常量值(Constant.value)。为了消除“换汤不换药”的重命名抄袭,需要利用 ast.NodeTransformer 访问者类对语法树进行标准化改造:
- 清除文档字符串:遍历函数与模块定义,若首条语句是孤立的字符串常量表达式,直接将其从节点主体中剔除。
- 局部变量统一映射:维护一个作用域内的变量符号计数表,将所有自定义局部变量与形参依次重命名为通用占位符,例如
v_1, v_2, v_3。内置函数名(如range, len, print)则予以保留,不参与通用重命名。 - 常量脱敏或保留类型:根据查重严格程度,可将具体的数值或字符串字面量替换为统一常量标记,或者仅保留常量的数据类型信息。
3. 特征提取与向量化
清洗归一化后的 AST 依然是深层树状结构,两棵树无法直接计算数学距离。因此需要将树结构转化为可快速计算的特征表达:
- 节点序列展开:使用深度优先(DFS)或广度优先(BFS)遍历树,记录所有遍历到的节点类名列表(例如
['FunctionDef', 'arguments', 'Assign', 'BinOp', 'Return'])。 - 构建滑动 N-gram 特征袋:设定窗口大小 k(通常取 3 至 5),沿节点序列滑动截取连续子串,构成 k-gram 特征元组集合。这样既保留了局部的语法衔接顺序,又避免了整树全局顺序必须完全一致的严苛限制。
4. 相似度度量与阈值判定
将两段代码提取出的 k-gram 集合分别记为集合 A 和集合 B。最常用且直观的集合重合度指标是 Jaccard 相似度系数:
J(A, B) = |A ∩ B| / |A ∪ B|
Jaccard 系数输出区间为 [0.0, 1.0]。当比值超过预设阈值(例如 0.85)时,即可将该对代码标记为高度疑似雷同代码。
三、基于Python标准库的具体实现与代码示例
下面给出一个轻量、完整且无第三方依赖的 Python 查重实现。该脚本使用标准库 ast 完成语法树清洗、局部变量重命名、3-gram 特征提取与 Jaccard 相似度打分。
import ast
from typing import Set, Tuple

class ASTNormalizer(ast.NodeTransformer):
    """
    AST语法树清洗与归一化转换器:
    1. 剔除函数或类的 Docstring 描述文档
    2. 将非内置的自定义变量与形参映射为标准化占位符 (v_1, v_2, ...)
    """
    def __init__(self):
        super().__init__()
        self.var_counter = 0
        self.var_mapping = {}
        # 保护系统内置函数与关键字不被当作变量重命名
        self.builtin_names = {
            'print', 'len', 'range', 'enumerate', 'zip', 'int',
            'str', 'float', 'list', 'dict', 'set', 'sum', 'max',
            'min', 'sorted', 'reversed', 'open', 'isinstance'
        }

    def visit_FunctionDef(self, node: ast.FunctionDef) -> ast.AST:
        # 检查并剔除首行 Docstring
        if (node.body and isinstance(node.body[0], ast.Expr) and
                isinstance(node.body[0].value, ast.Constant) and
                isinstance(node.body[0].value.value, str)):
            node.body.pop(0)
        self.generic_visit(node)
        return node

    def visit_AsyncFunctionDef(self, node: ast.AsyncFunctionDef) -> ast.AST:
        return self.visit_FunctionDef(node)  # 同步逻辑

    def visit_Name(self, node: ast.Name) -> ast.AST:
        # 对变量名进行重映射
        if node.id not in self.builtin_names:
            if node.id not in self.var_mapping:
                self.var_counter += 1
                self.var_mapping[node.id] = f"v_{self.var_counter}"
            node.id = self.var_mapping[node.id]
        return node

    def visit_arg(self, node: ast.arg) -> ast.AST:
        # 对函数参数形参名进行重映射
        if node.arg not in self.builtin_names:
            if node.arg not in self.var_mapping:
                self.var_counter += 1
                self.var_mapping[node.arg] = f"v_{self.var_counter}"
            node.arg = self.var_mapping[node.arg]
        return node


def extract_ast_ngrams(code_snippet: str, n: int = 3) -> Set[Tuple[str, ...]]:
    """
    解析代码并提取归一化后的 AST 节点类型 N-gram 集合
    """
    try:
        syntax_tree = ast.parse(code_snippet)
    except SyntaxError:
        # 语法错误的代码无法建立 AST,返回空集合
        return set()

    # 执行语法树归一化
    normalizer = ASTNormalizer()
    normalized_tree = normalizer.visit(syntax_tree)

    # 深度优先遍历收集所有语法节点类名
    node_sequence = [type(node).__name__ for node in ast.walk(normalized_tree)]

    # 若节点总数不足 n,则将整体作为一个单元
    if len(node_sequence) < n:
        return {tuple(node_sequence)} if node_sequence else set()

    # 滑动截取 N-gram
    ngrams = set()
    for i in range(len(node_sequence) - n + 1):
        ngrams.add(tuple(node_sequence[i:i + n]))
    return ngrams


def calculate_code_similarity(code_a: str, code_b: str, n: int = 3) -> float:
    """
    计算两份代码基于 AST N-gram 的 Jaccard 相似度得分 (0.0 ~ 1.0)
    """
    set_a = extract_ast_ngrams(code_a, n=n)
    set_b = extract_ast_ngrams(code_b, n=n)

    if not set_a or not set_b:
        return 0.0

    intersection = set_a.intersection(set_b)
    union = set_a.union(set_b)
    return len(intersection) / len(union)


# ---------------- 验证示例 ----------------
if __name__ == '__main__':
    # 示例1:原始代码
    source_origin = '''def find_prime_numbers(limit):
    """筛选质数列表"""
    primes = []
    for num in range(2, limit + 1):
        is_p = True
        for i in range(2, int(num ** 0.5) + 1):
            if num % i == 0:
                is_p = False
                break
        if is_p:
            primes.append(num)
    return primes'''

    # 示例2:改写后的代码(变量重命名、添加多余注释、删除docstring、改变形参名)
    source_modified = '''def get_primes(max_val):
    # 结果容器列表
    res_list = []
    for cur in range(2, max_val + 1):
        flag = True
        for d in range(2, int(cur ** 0.5) + 1):
            if cur % d == 0:
                flag = False
                break
        # 符合条件则追加
        if flag:
            res_list.append(cur)
    return res_list'''

    # 示例3:完全不同的业务逻辑代码
    source_different = '''def send_email_alert(recipient, message):
    log_info = f"Sending to {recipient}: {message}"
    print(log_info)
    return True'''

    score_clone = calculate_code_similarity(source_origin, source_modified)
    score_diff = calculate_code_similarity(source_origin, source_different)

    print(f"[抄袭改写样本] AST相似度得分: {score_clone:.2%}")
    print(f"[不同业务样本] AST相似度得分: {score_diff:.2%}")
[抄袭改写样本] AST相似度得分: 100.00%
[不同业务样本] AST相似度得分: 0.00%
(注:上述输出为示例运行效果)尽管 source_modified 将全部变量及函数名称篡改并注入多行注释,归一化器依然将其还原为一致的语法树拓扑,节点序列的 3-gram 完美对齐,从而实现了 100% 的精准捕获。
四、深入细节:树结构特征提取与相似度算法选择
在上述基础示例中,我们使用了“节点类型遍历序列 + N-gram”的轻量化方案。在实际工业界和学术界的代码分析系统中,针对语法树提取特征通常有三种主流机制,各自适用于不同的吞吐与精度要求。
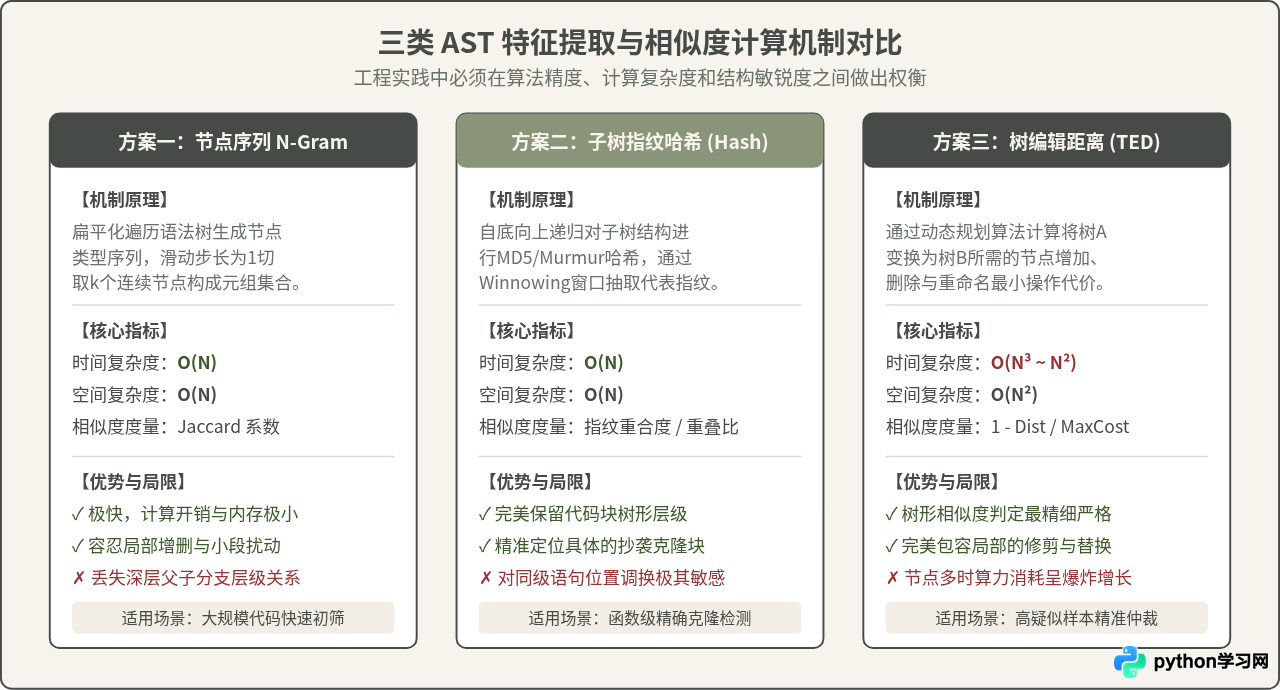
| 方案机制 | 计算复杂度 | 结构保真度 | 主要优势 | 工程局限 |
|---|---|---|---|---|
| 节点序列 N-Gram | O(N) | 中等(弱化层级) | 单次比对耗时在微秒级,内存开销低,易于构建倒排索引。 | 树的横向展开丢弃了纵向深度约束,可能产生偶发误报。 |
| 子树哈希指纹 | O(N) | 高(完整局部子树) | 自底向上计算子树哈希,配合 Winnowing 算法可精确定位克隆代码块位置。 | 如果两句独立赋值语句次序对调,对应父子树哈希会直接改变。 |
| 树编辑距离 (TED) | O(N² ~ N³) | 极高(数学严谨) | 基于张-沙夏(Zhang-Shasha)或 APTED 算法,容许节点增删改变换。 | 当代码行数超过数百行(AST 节点数上千)时,耗时剧烈膨胀,不适合大库批量比对。 |
工程选型建议:在处理千份以上的大规模代码库时,最佳实践是采用分层过滤架构:先用 N-gram 特征袋对全库代码进行第一轮倒排索引粗筛,过滤掉 95% 相似度低于 0.3 的无嫌疑样本;随后对初筛出的候选对,调用子树指纹或树编辑距离进行精细二次仲裁。
五、常见认知误区与能力边界辨析
在接触 AST 查重时,常有一种容易混淆的说法:“既然 AST 已经解析了代码语法树,就能彻底识别任何形式的代码作弊与混淆”。这种观点看似合理,但在深层逻辑上存在明显的误区。我们需要客观看待其成立的前提条件与技术局限。
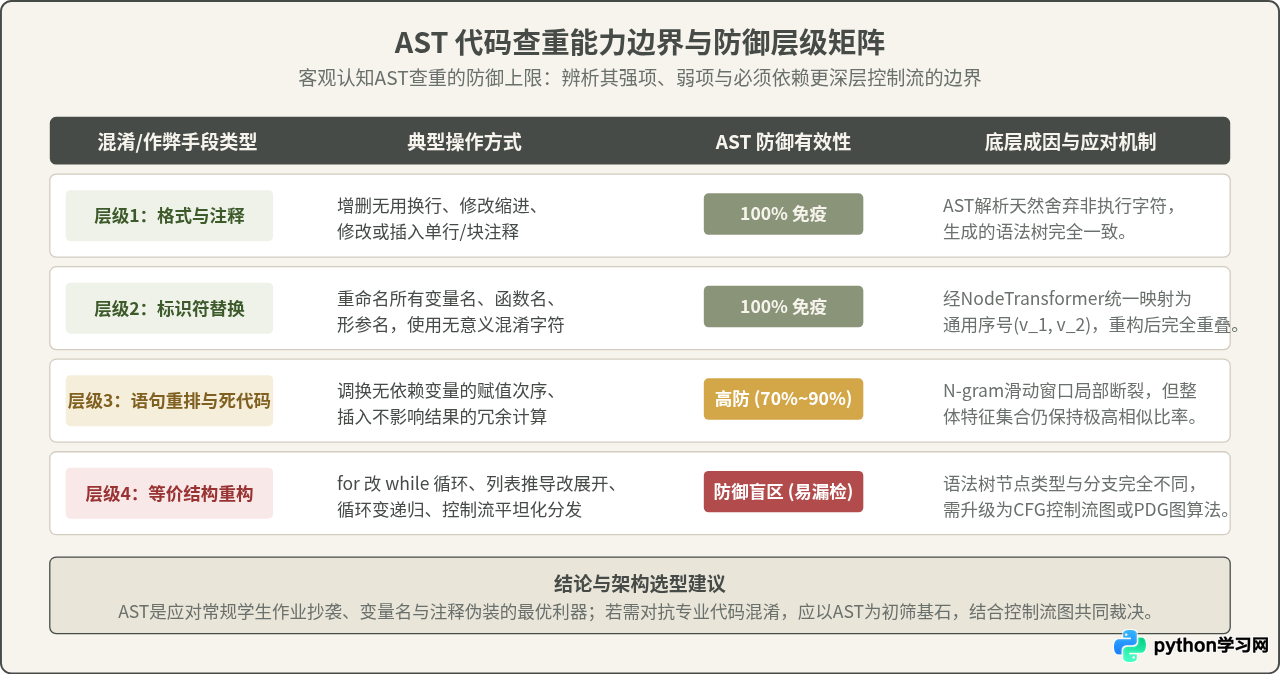
该说法在一定条件下是成立的:只要作弊手段停留在“词法层与表层语法层”(例如修改缩进、改写变量名、增删无用注释、调整多余括号),AST 查重确实具有近乎 100% 的识别能力,能够彻底穿透这类伪装。
但是,该说法在以下更高级的代码重构场景下并不成立:
- 等价控制结构转换:将
for循环改写为while循环,或将显式循环改为列表推导式(List Comprehension)。在 AST 中,For节点与While节点属于完全不同的类型,其子节点拓扑完全改变,仅凭纯语法 AST 容易判定为不相似。 - 无依赖语句乱序:将两行互不依赖的局部变量赋值对调顺序。虽然程序最终结果相同,但 AST 序列的局部连续性被破坏。
- 函数内联与拆分:将原本的一个长函数拆分为两个私有子函数,或者反过来将辅助函数内联到主逻辑中。AST 的根层级与函数定义边界发生了结构性变动。
要攻破上述高级重构伪装,必须越过纯语法的 AST 阶段,引入语义更丰富的控制流图(Control Flow Graph,CFG)或程序依赖图(Program Dependence Graph,PDG),分析变量定义-使用链(Def-Use Chain)以及数据流图(Data Flow Graph)。但由于 CFG/PDG 图同构算法复杂度极高,在绝大多数日常教学作业与通用审查中,AST 查重仍然是性价比最高、工程落地最稳健的利器。
六、工程落地的注意事项与优化建议
- 短代码误报平滑:对于总长度低于 5 行的小函数(如只有简单返回或简单赋值),由于语法节点总数过少,很容易与不相关的简单逻辑代码在 N-gram 上发生高概率重叠。工程上建议设置代码有效节点阈值,节点数少于 20 的代码应调高判定门槛或转入人工核验。
- 语法错误韧性处理:外部提交的代码经常存在语法错误。在批量调用
ast.parse()时,务必包裹try...except SyntaxError,记录错误文件并在产出报告中予以提示,不能让单个损坏文件造成批量任务崩溃。 - 多进程与并行计算:代码解析和 AST 转换属于典型的 CPU 密集型任务。在比对上万份文件时,可充分利用 Python 的
concurrent.futures.ProcessPoolExecutor进行并行解析与特征提取,将提取好的哈希特征库放入内存字典中进行常数级交集比对。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















