


Python高阶内置函数实战:map、filter和sorted的高级技巧
深入讲解Python高阶内置函数map、filter和sorted的实战技巧与高级用法,涵盖多序列并行映射、None特异值过滤、Timsort稳定多维排序、惰性管道构建与列表推导式选型对比。
在Python语言中,map()、filter()与sorted()是标准内置函数中兼具函数式编程思想与工程实用价值的三个典型代表。前两者以惰性迭代器的机制运行,专注于在零额外内存堆积的前提下完成数据的流式转换与条件筛选;sorted()则依托性能优越且具备稳定性的Timsort算法,配合key参数的高阶应用解决各类多维复杂排序诉求。掌握它们的深层机制与高级技巧,能使日常的数据清洗和流水线构建更加紧凑高效。
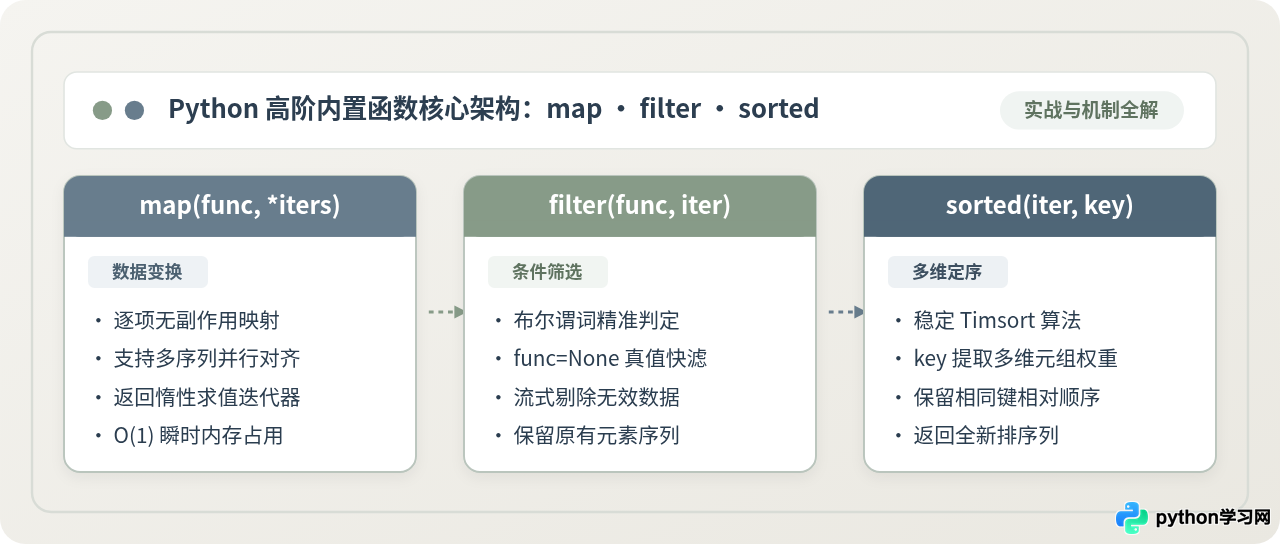
全景图:map、filter 与 sorted 的核心职能划分与数据协作路径
一、map() 的高级实战:多序列并行与无副作用转换
map(function, *iterables) 最基础的用法是对单个集合的每个元素应用指定函数并产生新序列。但在实际工程场景中,map() 具备两个经常被忽略的重要高阶特性:多可迭代对象的并行解构,以及与标准库现成函数的零额外封装协同。
1. 多可迭代对象的并行同步迭代
当向 map() 传入多个可迭代对象时,映射函数接收的参数个数必须与传入的可迭代对象数量完全一致。map() 会在每次求值时,同时从各个序列中取出一个元素作为实参传递给函数。在Python 3中,这种并行处理以最短的序列耗尽为终止条件。
# 场景示例:多个指标序列的加权评分计算
weights = [0.2, 0.3, 0.5]
scores = [80, 90, 95]

# 使用多参数函数并行映射,无需使用 range(len(...)) 下标操作
def weighted_score(w, s):
    return round(w * s, 2)

result_iter = map(weighted_score, weights, scores)
print(list(result_iter))  # 示例输出: [16.0, 27.0, 47.5]
这种模式在概念上类似于 zip() 与解包传参的结合,但由于 map() 内部直接在C语言层面将多个迭代器生成的项传入函数对象,避免了在Python解释器层额外构造元组再解包的开销。
2. 协同 operator 与内置方法替代冗余 lambda
很多开发者习惯在 map() 中直接嵌套 lambda 表达式,例如 map(lambda x: x.strip(), lines)。这种写法在语法上虽然合法,但每次调用都会产生额外的Python栈帧开销。更高级的做法是直接传递类型本身的无绑定方法,或使用 operator 模块提供的底层C函数:
import operator

raw_lines = ["  apple
", "  banana  ", " orange 	"]
records = [{"id": 101, "val": "A"}, {"id": 102, "val": "B"}]

# 1. 传递已有类型的无绑定方法(速度显著高于 lambda x: x.strip())
clean_lines = list(map(str.strip, raw_lines))
# 示例输出: ['apple', 'banana', 'orange']

# 2. 结合 operator.itemgetter 批量提取字典字段
get_id = operator.itemgetter("id")
all_ids = list(map(get_id, records))
# 示例输出: [101, 102]str.strip 是一个普通的函数对象,其第一个参数正是字符串实例本身。因此 map(str.strip, lines) 等效于对每一项执行 str.strip(line),其字节码指令更少,执行速度比自定义 lambda 更快。
二、filter() 的高级实战:谓词过滤与 None 特异行为
filter(function, iterable) 承担的是布尔谓词过滤任务。它接受一个返回真假值的判定函数,当判定结果为真时保留该项。
1. filter(None, iterable) 的 Truthy 过滤特异性
在官方规范中,当 filter() 的第一个参数显式传入 None 时,函数并不会报错,而是启用内部特殊的真值判定机制——直接依据Python中对象的布尔真值性(即等效于 bool(x))过滤所有“假值”(Falsy values),包括空字符串 ""、数字 0、None、空列表 [] 等。
# 快速清洗含有空项、空行或占位假值的脏数据列表
raw_tokens = ["python", "", 0, "filter", None, [], "sorted", False]

# 传入 None 直接利用底层的快速真值检验
valid_tokens = list(filter(None, raw_tokens))
print(valid_tokens)
# 示例输出: ['python', 'filter', 'sorted']
该写法比 filter(lambda x: bool(x), tokens) 或 [x for x in tokens if x] 的函数调用栈更轻,是文本分词清洗或环境变量过滤时的实用简写。
2. 闭包式谓词生成与动态边界过滤
在需要根据外部配置动态筛选数据时,可以通过高阶函数返回谓词闭包,使 filter() 具备极佳的复用性:
def make_range_predicate(min_val, max_val):
    """生成数值区间判定的闭包谓词"""
    return lambda x: min_val <= x <= max_val

temperatures = [12.5, 38.2, 24.0, -5.1, 19.8, 41.0]

# 动态构造适宜温度区间的过滤器
is_comfortable = make_range_predicate(18.0, 26.0)
comfortable_temps = list(filter(is_comfortable, temperatures))
print(comfortable_temps)
# 示例输出: [24.0, 19.8]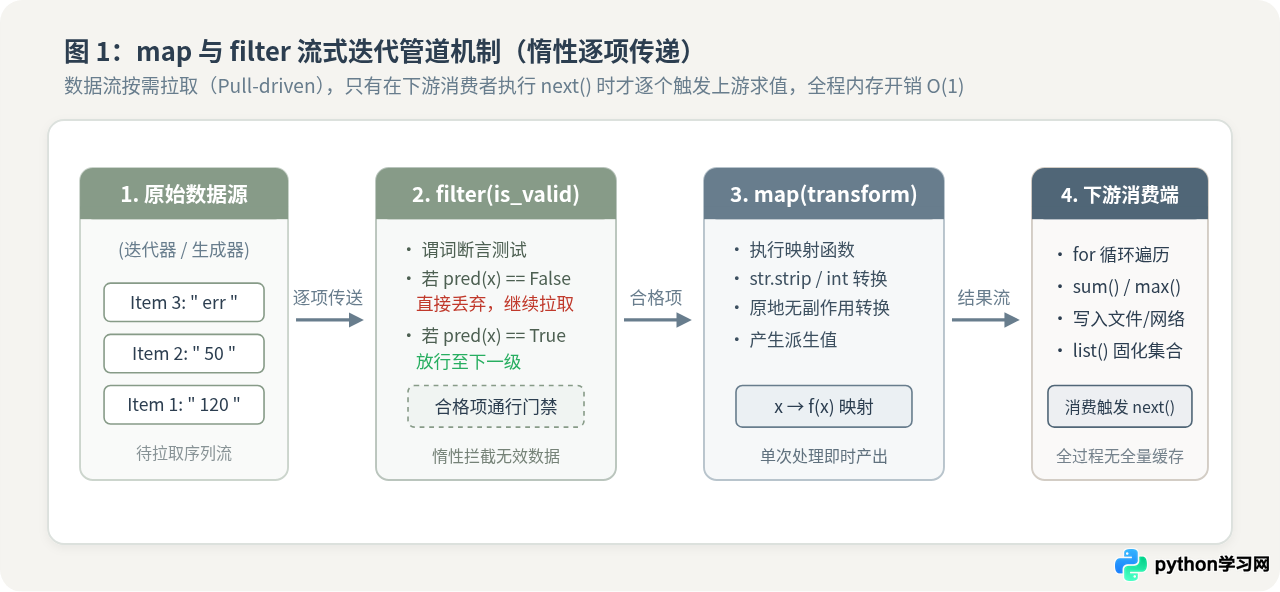
图 1:map 与 filter 流式管道迭代机制(惰性逐项传递,避免全量中间缓存)
三、核心差异解析:惰性迭代器管道与列表推导式的权衡
在Python代码重构时,开发者经常面临一个经典抉择:是使用 map() 与 filter() 搭建管道,还是统一改用列表推导式(List Comprehension)?为了做出合理的技术选型,需要在完全一致的基准条件下剖析这两种机制的关键差异及其工程影响。
1. 内存分配与计算时机差异
考虑处理包含100万条字符串的日志数据:需要先剔除无意义的空行,再进行大小写转换。
-
列表推导式(即时求值):
[line.lower() for line in raw_lines if line.strip()]会在语句被执行的瞬间,立即分配一块连续的堆内存,并将处理后的100万个元素全部实体化存入新列表中。如果后续只需要取前10条数据(例如分页查看),这会导致剩余99万多次计算全部白费,并占用数百兆内存。 -
map 与 filter 组合(惰性求值):
map(str.lower, filter(str.strip, raw_lines))在声明时仅仅返回一个迭代器对象,不进行任何一次字符串截取或字符转换。只有在外部通过for循环或next()索取数据时,数据才逐个从数据源被拉取、过滤、转换并吐出。整个过程占用的内存始终是单条记录的O(1)常数级空间。
2. 消费生命周期与可重入性
差异的关键不仅在于性能,还在于“对象的生命周期”:
| 对比维度 | map() + filter() 迭代器管道 | 列表推导式 (List Comprehension) |
|---|---|---|
| 返回值类型 | map / filter 迭代器对象 |
标准 list 实例 |
| 瞬时内存开销 | O(1)(常数内存,按需拉取) |
O(N)(与过滤后的数据量呈线性正比) |
| 可重入与复用 | 单次消费(遍历一次后即耗尽) | 可多次遍历、支持索引与切片访问 |
| 代码表达性 | 已有纯函数或方法时结构极其干净 | 内联包含复杂表达式或嵌套逻辑时更易读 |
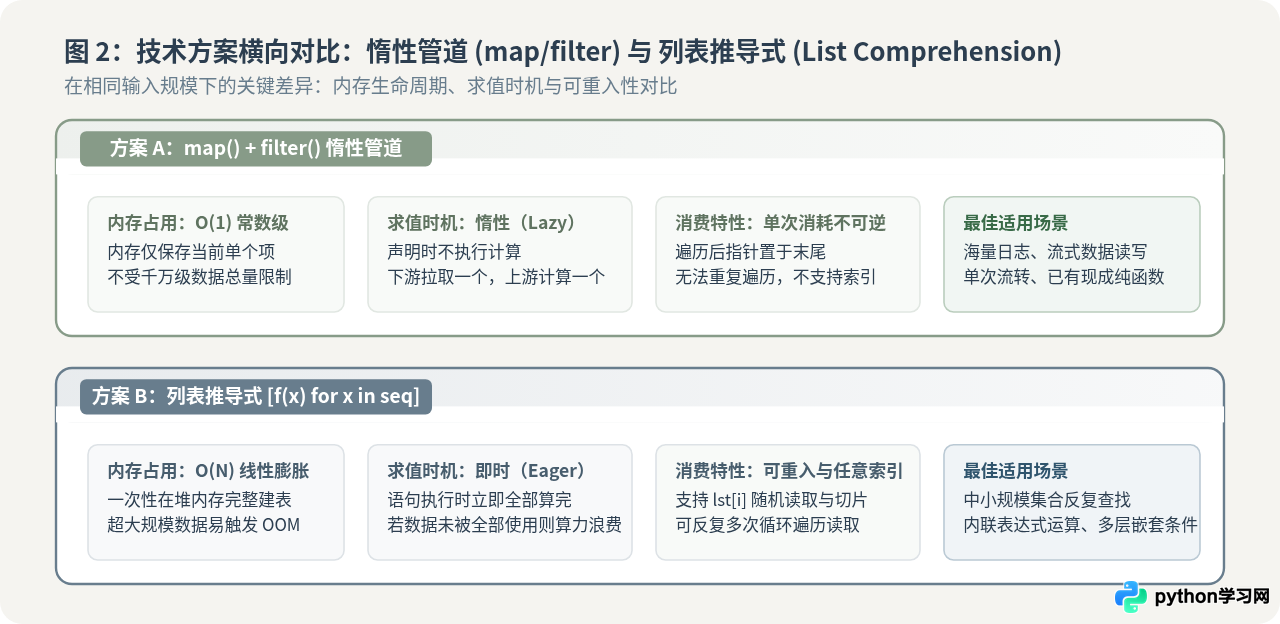
图 2:惰性迭代器管道与列表推导式在内存与求值机制上的对比
四、sorted() 的高阶技巧:从基础排序到多维稳定定序
与 map 和 filter 不同,排序本质上无法做到纯惰性的流式处理,因为找出全局最小或最大值必须遍历完整个数据集。Python内置的 sorted(iterable, key=None, reverse=False) 接收任意可迭代对象,并基于 Timsort 算法返回一个新的排好序的 list。
1. 复合 key 与元组权重模型
key 参数接收一个单参数函数,它并不改变原序列中的元素本身,而是为每个元素生成一个“排序代理键(Proxy Key)”。当面对多维业务排序诉求时,最核心的技巧是利用Python元组(tuple)的天生比较规则——从左至右逐元素依次比较,前一个字段相同时才比较下一个字段。
# 场景示例:员工列表多维排序
# 排序规则:先按部门名称升序;若部门相同,按绩效分降序;若绩效分仍相同,按工龄升序
employees = [
    {"name": "Alice", "dept": "Engineering", "score": 92, "tenure": 3},
    {"name": "Bob",   "dept": "Engineering", "score": 95, "tenure": 5},
    {"name": "Carol", "dept": "Marketing",   "score": 88, "tenure": 2},
    {"name": "David", "dept": "Engineering", "score": 95, "tenure": 2},
]

# 技巧:数值类型通过取负号 -x['score'] 巧妙实现“局部降序”
sorted_employees = sorted(
    employees,
    key=lambda x: (x["dept"], -x["score"], x["tenure"])
)

for emp in sorted_employees:
    print(f"{emp['dept']} | 分数: {emp['score']} | 工龄: {emp['tenure']} | 姓名: {emp['name']}")

# 示例输出:
# Engineering | 分数: 95 | 工龄: 2 | 姓名: David
# Engineering | 分数: 95 | 工龄: 5 | 姓名: Bob
# Engineering | 分数: 92 | 工龄: 3 | 姓名: Alice
# Marketing   | 分数: 88 | 工龄: 2 | 姓名: Carol
2. 利用 Timsort 算法的“稳定性”解决不可逆维度的排序
上述数值取负技巧仅适用于数字。如果第二排序维度是字符串,并且要求“第一字段升序、第二字段降序”,字符串无法进行取负操作(例如 -"Alice" 会抛出 TypeError)。此时,最优雅的解法是利用 Python 默认底层排序算法 Timsort 的稳定性(Stability)。
稳定性保证:当两个元素的 key 相等时,它们在排序后的相对前后顺序与排序前保持完全一致。因此,我们可以通过“自底向上分步排序”实现混合升降序:先按次要字段排序,再按主要字段排序。
items = [
    {"category": "A", "code": "x-01"},
    {"category": "B", "code": "m-05"},
    {"category": "A", "code": "z-99"},
]

# 目标:category 升序,code 降序
# 第一步:先按次要维度 code 降序排序
step1 = sorted(items, key=lambda x: x["code"], reverse=True)

# 第二步:再按主要维度 category 升序排序(由于稳定算法保证,相同 category 内的 code 降序关系原样保留)
final_sorted = sorted(step1, key=lambda x: x["category"])

# 示例输出中 category 为 A 的项,code 为 'z-99' 在 'x-01' 之前
print(final_sorted)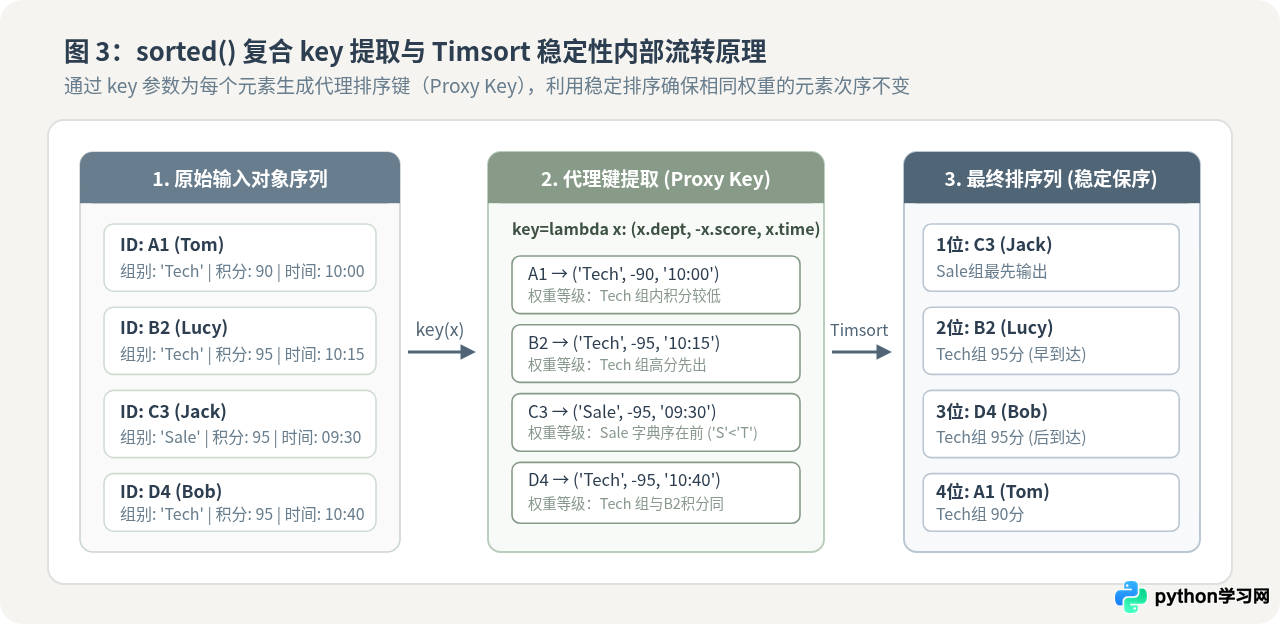
图 3:sorted() 复合 key 提取与 Timsort 稳定性内部流转原理
五、综合实战:电商订单清洗与多维排名流水线
为了将这三个高阶函数有机融汇于真实场景中,以下演示一个结构化电商订单分析处理流水线:
- 数据源:包含脏数据、退款订单与有效付款订单的原始字典序列;
- 过滤阶段(filter):流式过滤掉未付款订单及总额异常的坏账;
- 转换阶段(map):利用纯函数将外币金额统一转换为标准人民币,并计算折后实付额;
- 排序阶段(sorted):按实付金额降序、下单时间升序输出最终交付榜单。
import datetime

raw_orders = [
    {"order_id": "T101", "status": "PAID", "amount": 250.0, "currency": "CNY", "created_at": "2026-10-31 10:15:00"},
    {"order_id": "T102", "status": "CANCELLED", "amount": 1200.0, "currency": "CNY", "created_at": "2026-10-31 10:20:00"},
    {"order_id": "T103", "status": "PAID", "amount": 50.0, "currency": "USD", "created_at": "2026-10-31 09:30:00"},
    {"order_id": "T104", "status": "PAID", "amount": 360.0, "currency": "CNY", "created_at": "2026-10-31 11:00:00"},
    {"order_id": "T105", "status": "PAID", "amount": 0.0, "currency": "CNY", "created_at": "2026-10-31 11:30:00"},
]

# 1. 过滤函数:仅保留有效支付且金额大于0的记录
def is_valid_paid_order(item):
    return item.get("status") == "PAID" and item.get("amount", 0) > 0

# 2. 转换函数:汇率换算与结构标准化(纯函数,无全局变量篡改)
USD_TO_CNY_RATE = 7.2
def normalize_order(item):
    raw_amount = item["amount"]
    cny_amount = raw_amount * USD_TO_CNY_RATE if item["currency"] == "USD" else raw_amount
    return {
        "order_id": item["order_id"],
        "cny_amount": round(cny_amount, 2),
        "timestamp": datetime.datetime.strptime(item["created_at"], "%Y-%m-%d %H:%M:%S")
    }

# 3. 构建迭代管道:filter 与 map 级联
valid_pipeline = filter(is_valid_paid_order, raw_orders)
normalized_pipeline = map(normalize_order, valid_pipeline)

# 4. 终端聚合与多维稳定定序:金额降序(-cny_amount),时间早的在前(timestamp 升序)
ranked_orders = sorted(
    normalized_pipeline,
    key=lambda x: (-x["cny_amount"], x["timestamp"])
)

# 输出处理结果
for rank, item in enumerate(ranked_orders, start=1):
    print(f"第{rank}名: 订单{item['order_id']} | 金额: ¥{item['cny_amount']} | 下单时间: {item['timestamp']}")

# 预期标准控制台输出:
# 第1名: 订单T103 | 金额: ¥360.0 | 下单时间: 2026-10-31 09:30:00
# 第2名: 订单T104 | 金额: ¥360.0 | 下单时间: 2026-10-31 11:00:00
# 第3名: 订单T101 | 金额: ¥250.0 | 下单时间: 2026-10-31 10:15:00
在上面的示例中,T103(原50美元折合360元)与T104(人民币360元)金额相同,但T103下单更早,因此通过复合键 (-x['cny_amount'], x['timestamp']) 精确排在第一位。整个数据清洗、转换与排序的过程清晰解耦,具备优良的模块化测试特性。
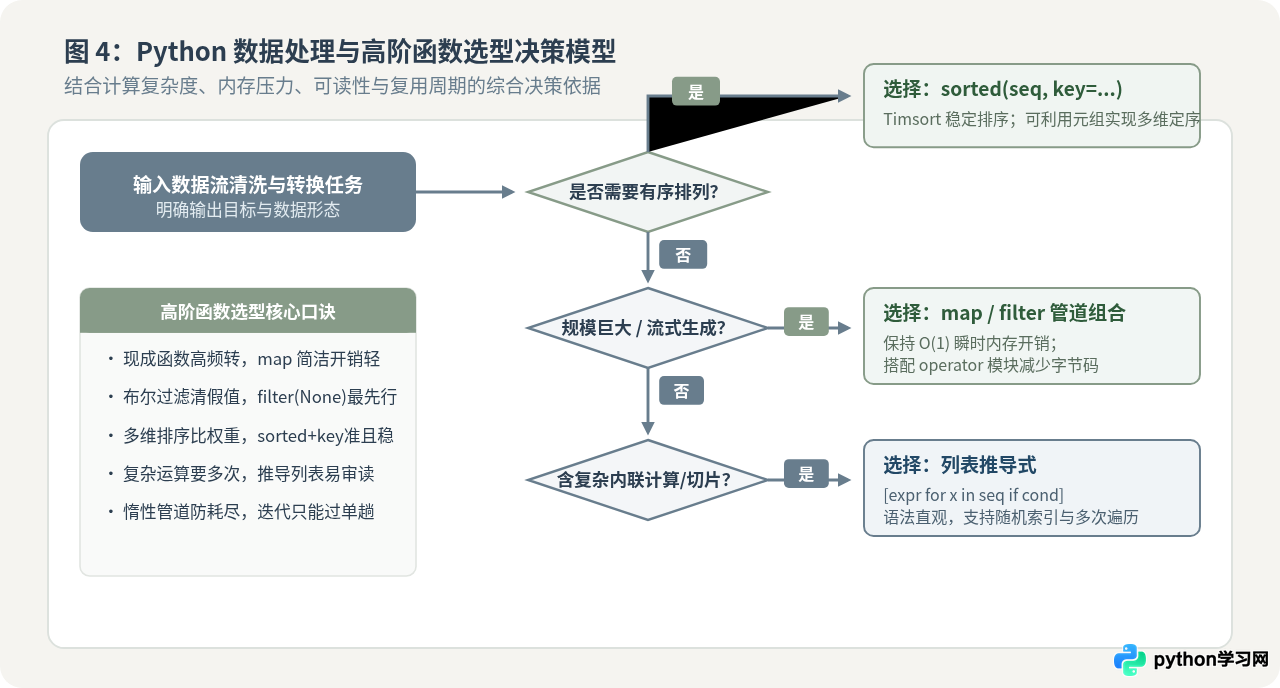
图 4:Python 数据处理与高阶函数选型决策模型与特性速查
六、避坑指南与工程注意事项
在团队开发中,高阶函数如果使用不当,容易引入一些隐蔽的逻辑缺陷。以下整理三条最容易踩中的陷阱及应对方案:
1. 迭代器单次耗尽陷阱(Exhausted Iterators)
map() 和 filter() 返回的对象本质上是迭代器(Iterator),而不是容器(Container)。迭代器一旦被遍历过一次,其内部游标便会停在尾部。再次对其调用 for 循环或 list() 会得到空序列。
m = map(int, ["1", "2", "3"])
total = sum(m)       # total 为 6,此时迭代器已完全耗尽
count = len(list(m)) # count 结果为 0!不会重新从头计算
防范措施:如果处理结果需要被多次读取或同时计算长度与极值,应显式使用 list(m) 将其持久化为列表,或者在流式场景下利用 itertools.tee 复制多路独立分支。
2. map 与 filter 中的隐蔽副作用(Side Effects)
函数式编程主张“纯函数”(Pure Function),即无副作用且返回值仅取决于入参。切忌在传递给 map() 的函数体内修改外部全局变量、执行文件写入或修改原传入字典内容。
# 错误示范:在 map 中产生外部状态修改,一旦迭代器未完全消费,副作用将不可预测地丢失
seen_ids = set()
def bad_transform(item):
    seen_ids.add(item["id"])  # 危险的外部状态修改
    return item["id"]

pipeline = map(bad_transform, records)
# 此时 seen_ids 仍然为空!只有在 pipeline 被下游拉取时才会产生变更
3. 辨析 sorted() 与 list.sort()
两者的关键边界在于内存分配与适用类型:
list.sort()仅存在于列表类型上,执行的是就地排序(In-place sort),无须额外分配同等规模的数组空间,但会永久破坏原有序列次序,返回值始终为None;sorted()接受包含生成器、字典键、元组、集合在内的任意可迭代对象,始终分配并返回一个全新列表,原数据源完全保持不变。在数据不可变场景或流水线末端,应当优先选用sorted()。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















