


Python中前后双下划线__init__是做什么的?
深入解析Python中__init__方法的核心作用、运行机制与生命周期。通过具体代码示例与清晰图示,详解__init__与__new__的本质区别、self参数原理、继承与super调用以及常见避坑要点。
在 Python 类中,前后带有双下划线的 __init__ 是一个实例初始化方法(Initialization Method)。它的唯一核心任务是在对象刚刚被创建出来后,立即为这个全新的实例绑定属于它自己的属性(状态数据)并完成初步配置。本文将从执行机制、参数传递、底层原理、继承扩展及高频易错点五个维度,完整拆解 __init__ 的运作逻辑。
一、直观理解:什么是初始化方法?
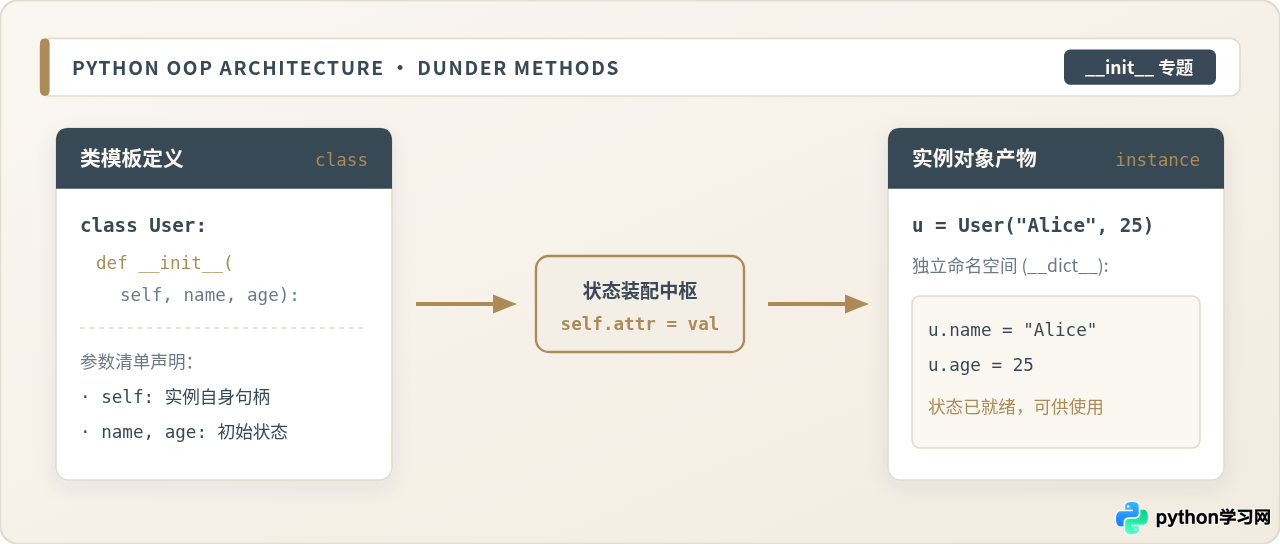
在 Python 中,类(Class)是创建对象的模具,而实例(Instance)则是依照模具铸造出的具体实体。当我们在模具中定义 def __init__(self, ...): 时,我们是在告知 Python 解释器:“每当产生一个基于该类的新实例时,请立刻运行这段代码,把调用方传入的数据打包存入这个实例自身中”。
在 Python 术语中,以双下划线开头和结尾的方法被称为特殊方法(Special Methods),在社区中也常被非正式地称为 Dunder Methods(即 Double Underscores 的缩写)。这类方法由解释器在特定事件发生时自动隐式调用,无需开发者手动显式执行 obj.__init__()。
来看一个最基础的代码示例:
# 运行环境:Python 3.8+
class User:
    def __init__(self, name, age):
        self.name = name  # 将传入的实参 name 绑定到当前实例的 name 属性
        self.age = age    # 将传入的实参 age 绑定到当前实例的 age 属性

# 实例化调用(此时解释器会自动在后台调用 __init__)
user1 = User("张三", 25)
user2 = User("李四", 30)

# 示例输出:
print(user1.name, user1.age)  # 打印结果:张三 25
print(user2.name, user2.age)  # 打印结果:李四 30
在这段代码中,每次通过 User(...) 创建新对象时,每个对象都拥有相互独立的属性数据。user1 拥有自己的 name="张三",而 user2 拥有自己的 name="李四",它们互不干扰。这正是 __init__ 所完成的工作:为新实例注入专属的初始状态。
二、深层原理:__new__ 与 __init__ 的本质分工
许多初学者常把 __init__ 称作“构造函数(Constructor)”,并误以为是 __init__“创建”了对象。这种说法在严格的 Python 语言规范中是不准确的。
Python 对象的实例化过程实际上是一个清晰的两阶段生命周期(Two-Phase Instantiation):
- 阶段一:对象创建(Allocation) —— 由特殊方法
__new__(cls, ...)负责。它是一个类级别的静态方法,真正向操作系统申请内存空间,并生成一个属于该类的空白对象实例。 - 阶段二:对象初始化(Initialization) —— 由特殊方法
__init__(self, ...)负责。它接收阶段一刚生产出来的空白实例(也就是self),为该实例的属性字典(__dict__)填充初始键值对。
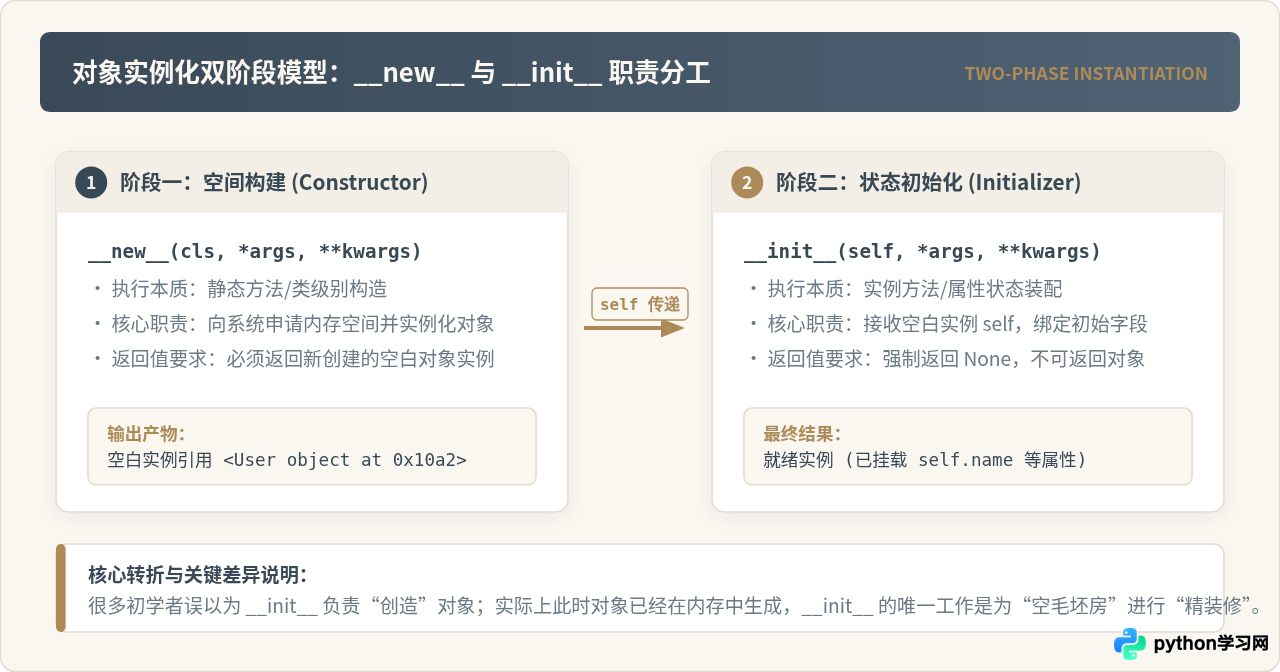
我们可以通过重写 __new__ 和 __init__ 来直观验证两者的先后触发顺序:
class LifecycleDemo:
    def __new__(cls, *args, **kwargs):
        print("1. [__new__] 正在申请内存,创建空白对象...")
        instance = super().__new__(cls)
        print(f"   空白对象已在内存中生成,地址为: {hex(id(instance))}")
        return instance  # 必须返回实例,否则不会触发后续的 __init__

    def __init__(self, label):
        print(f"2. [__init__] 接收到实例引用 self={hex(id(self))},开始绑定属性...")
        self.label = label
        print("   属性绑定完毕!")

# 执行实例化
demo = LifecycleDemo("演示对象")

# 示例输出记录:
# 1. [__new__] 正在申请内存,创建空白对象...
#    空白对象已在内存中生成,地址为: 0x104b39b10
# 2. [__init__] 接收到实例引用 self=0x104b39b10,开始绑定属性...
#    属性绑定完毕!
从上面的输出可以清晰地看到:__new__ 产出的对象内存地址与 __init__ 中接收到的 self 完全一致。在绝大多数日常业务开发中,开发者只需要编写 __init__ 来定义业务字段,无需干预 __new__(除非需要实现单例模式、元编程或继承不可变内置类型如 tuple、int)。
三、核心参数 self 的本质与调用映射过程
在编写 __init__ 时,初学者最容易产生的疑惑是:为什么方法定义的第一个参数必须写成 self?而在外部实例化调用 User("张三", 25) 时,明明只传了两个参数,为什么不会发生参数数量不匹配的报错?
原因在于:self 代表的是当前刚刚被创建出的实例本身。在 Python 内部,类名调用语法(如 User("张三", 25))并不是直接执行函数,而是由解释器调度转换成一套完整的映射流程。
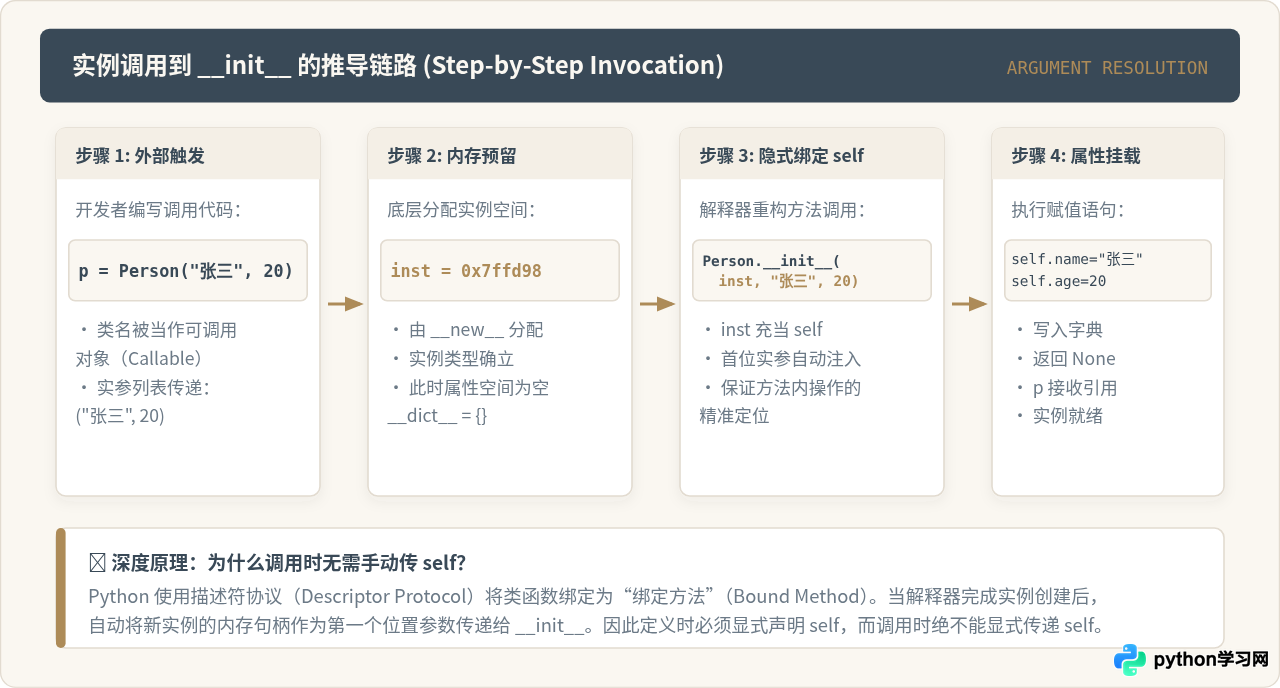
整个映射机制可以拆解为四个具体步骤:
- 外部触发:调用端发起
p = Person("张三", 20)请求。 - 分配空间:解释器先执行
Person.__new__,在堆内存中为对象划分独立区域,返回引用地址(例如0x7ffd98)。 - 首参隐式注入:解释器随后把该实例引用作为第一个位置参数,连同开发者传入的实参一起,重构成底层方法调用:
Person.__init__(0x7ffd98, "张三", 20)。 - 属性写入完成:在
__init__函数体内部,执行self.name = "张三",实际上就是向0x7ffd98这个特定实例命名空间(__dict__)中写入键值对。执行完毕后,外部变量p正式获得指向该就绪对象的引用。
虽然从 Python 语法底层角度,第一个形参可以使用任何合法的变量名(例如使用 this 或 me 语法上也能运行),但 PEP 8 官方代码规范强烈要求必须使用 self。遵循这一命名习惯能够确保团队协作沟通与代码可读性的一致。此外,调用端绝不能手动显式传入 self,否则会导致参数多传一个的 TypeError。
四、面向对象继承中的 __init__ 与 super()
在面向对象继承关系中,__init__ 的继承与重写(Override)遵循以下严格规则:
- 子类未定义
__init__:子类会自动沿用并执行父类的__init__方法,实例化参数必须与父类一致。 - 子类重写了
__init__:子类自己的__init__会彻底覆盖父类的同名方法。此时父类的初始化逻辑不会被自动调用。
当子类需要既拥有父类的通用属性,又增加子类特有的专属属性时,必须在子类的 __init__ 内部通过 super().__init__(...) 显式调用父类方法。
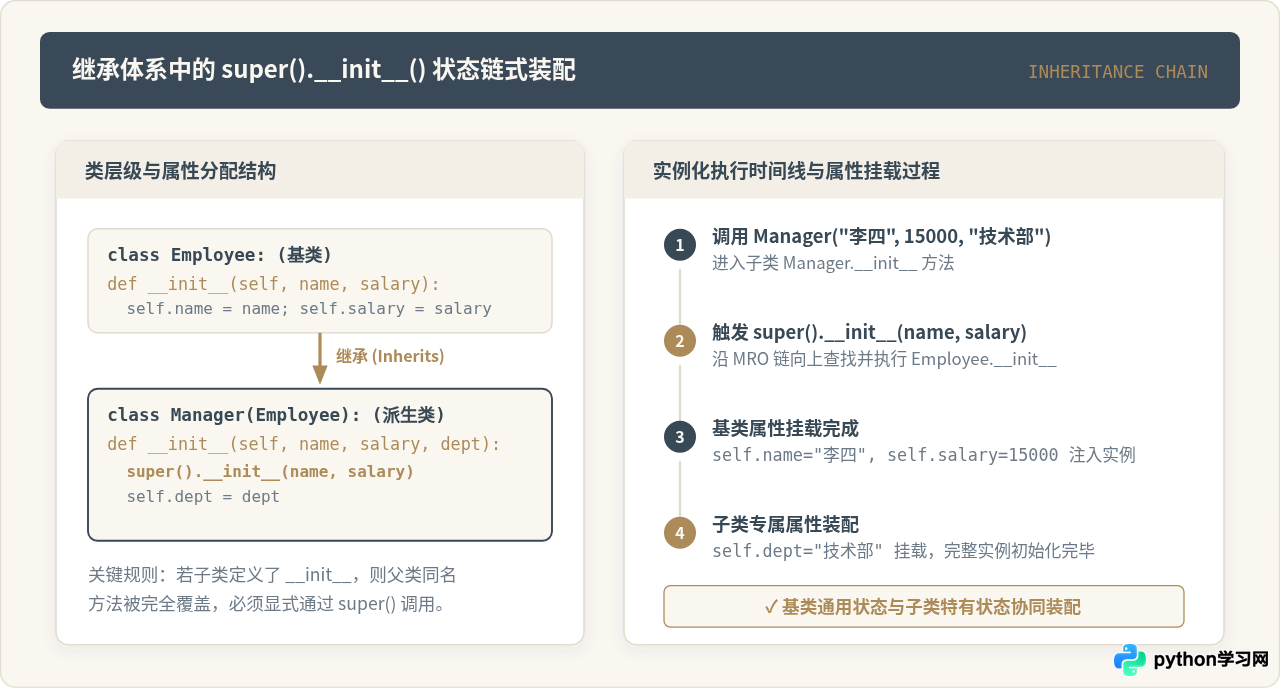
以下是规范的继承示例:
# 基类:员工类
class Employee:
    def __init__(self, name: str, salary: float):
        self.name = name
        self.salary = salary

# 派生类:技术经理
class TechLead(Employee):
    def __init__(self, name: str, salary: float, team_size: int):
        # 关键步骤:使用 super() 将基础属性的初始化委托给父类
        super().__init__(name, salary)
        # 装配子类特有属性
        self.team_size = team_size

# 实例化派生类
lead = TechLead("李华", 28000.0, 12)

# 示例验证:
print(lead.name)       # 来自父类初始化:李华
print(lead.salary)     # 来自父类初始化:28000.0
print(lead.team_size)  # 来自子类初始化:12
如果在子类中忘记书写 super().__init__(name, salary),那么当访问 lead.name 时,Python 会直接抛出 AttributeError: 'TechLead' object has no attribute 'name'。这是继承开发中最常见的新手排查难点之一。
五、关键规则与避坑指南
为了写出健壮且符合 Python 惯例的代码,开发者在编写 __init__ 时需要格外警惕以下几项限制与易错场景:
1. 强制返回值必须为 None
__init__ 的唯一目标是就地(In-place)修改传入的 self 实例状态。因此,__init__ 绝对不能返回非 None 的值。如果试图在 __init__ 中返回任何对象,Python 会直接抛出运行时异常:
class FaultyClass:
    def __init__(self):
        return "错误:试图返回值"  # 运行时报错!

# 试图实例化将引发异常:
# TypeError: __init__() should return None, not 'str'
允许的做法是:在满足特定条件时,使用不带任何表达式的纯 return 或 return None 来提前结束初始化流程。
2. 严禁使用可变对象作为默认参数
在 __init__ 的参数列表中,如果需要给属性设置默认值,千万不要把列表([])或字典({})等可变类型作为默认值:
# 错误写法:所有未传 tags 的实例将共享同一个内存列表!
class BadDesign:
    def __init__(self, name, tags=[]):
        self.name = name
        self.tags = tags

# 正确工程写法:使用 None 并在函数体内按需赋新列表
class SafeDesign:
    def __init__(self, name, tags=None):
        self.name = name
        self.tags = tags if tags is not None else []
3. 避免在 __init__ 中执行重度 I/O 操作
__init__ 的职责是“纯粹的状态设置”。若在 __init__ 中直接编写阻塞性的网络请求(如请求外部 API)、复杂数据库连接或磁盘大文件解析,不仅难以编写单元测试,还会导致对象在初始化失败时处于不一致状态。推荐做法是在 __init__ 仅保留属性赋值,将复杂逻辑抽离为独立的连接方法或使用 @classmethod 工厂方法。
六、总结速查与技术规格对比
最后,我们将 __init__ 与 Python 对象的关键生命周期规则汇总为速查清单:
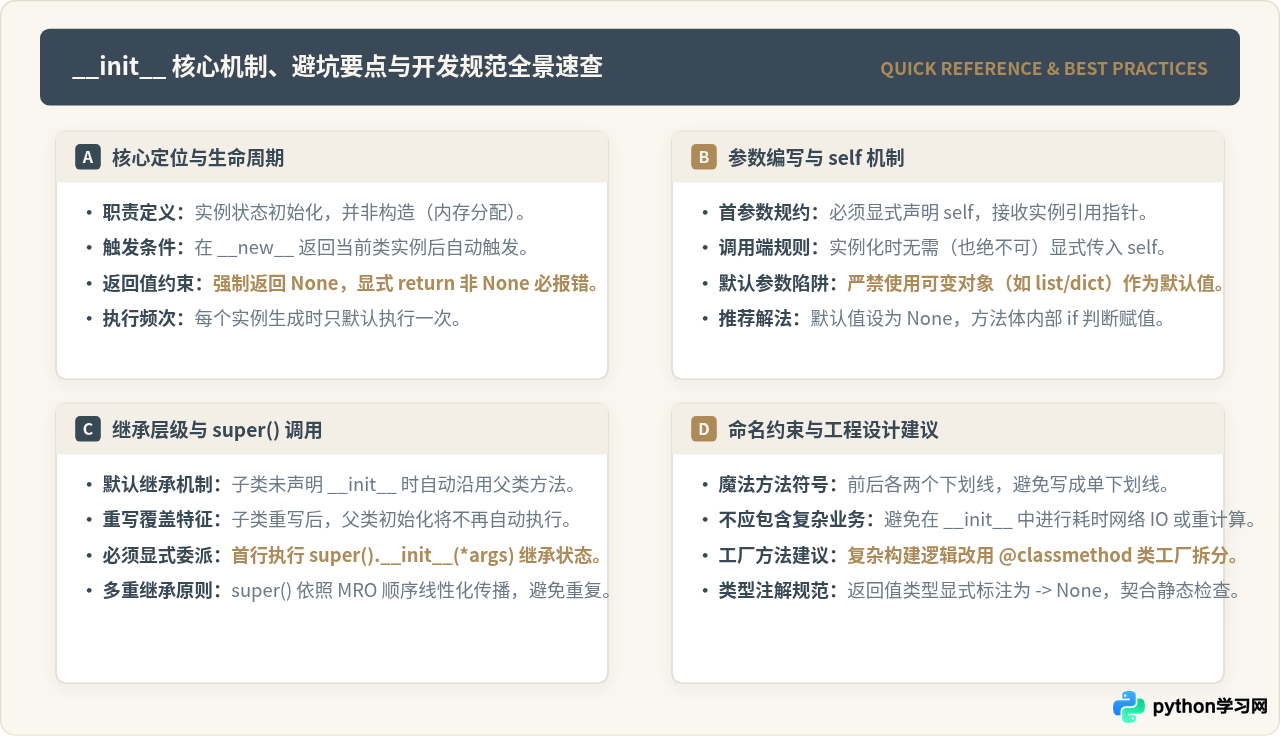
| 核心要素 | __init__ 方法具体规则 | 常见误区与违例结果 |
|---|---|---|
| 本质与角色 | 实例状态初始化器(Initializer),负责属性绑定 | 误以为负责创建内存对象(实际由 __new__ 负责) |
| 首位形参 | 必须显式声明 self,代表当前实例 |
外部实例化时不应传 self,否则报实参超限 |
| 返回值 | 必须隐式或显式返回 None |
若返回非 None 值,直接抛出 TypeError |
| 继承机制 | 子类重写时必须显式写出 super().__init__(...) |
若遗漏 super 调用,父类属性不会挂载,导致 AttributeError |
| 参数默认值 | 必须使用不可变对象或 None 占位 |
使用 [] 导致所有实例跨对象共享可变列表 |
总结而言,Python 中的 __init__ 就是对象初生时的“装配车间”。只要把握好“只负责装配不负责分配”、“首参绑定 self 且返回必须为 None”、“继承中通过 super 维系调用链”这三条基本铁律,就能在面向对象编程中准确、优雅地构建任何类结构。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















