


Python元组只有count和index?详解5种核心操作技巧
Python内置元组方法虽然只有count和index,但依托语法解包、切片衍生、字典序比较、哈希复合键及NamedTuple,元组拥有极其强大的数据处理能力。本文详解5大核心操作技巧与实践场景。
很多开发者在刚接触 Python 元组(tuple)时,通过 dir(tuple) 会吃惊地发现其实例公开方法只有可怜的 count() 和 index()。与列表拥有 append、extend、sort、pop 等十余种方法相比,元组看似功能极其贫瘠。但这并非设计疏忽,而是 Python 坚持“不可变记录(Immutable Records)”哲学的精巧裁量:元组的真正操作威力从来不是靠对象方法展开,而是深植于 Python 的语言级语法协议之中。本文将直接带你掌握元组不可替代的 5 种核心操作技巧。
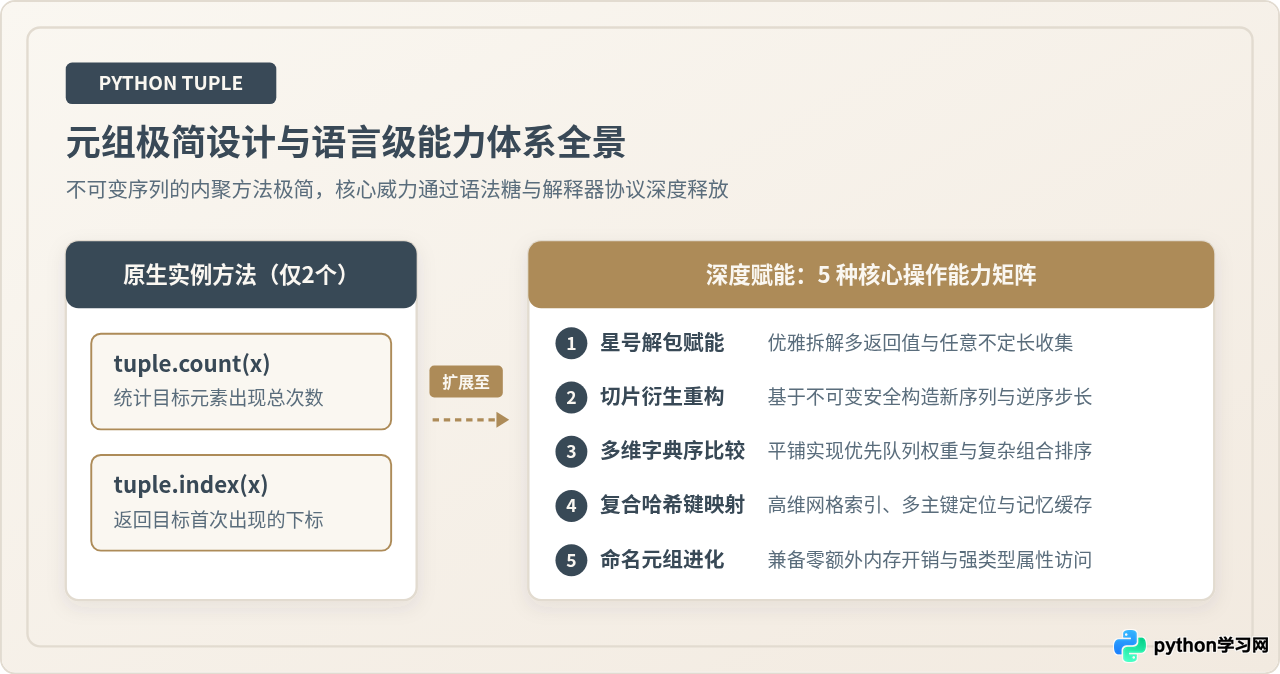
1 技巧一:结构化赋值与星号(*)解包
在日常开发中,元组最核心的操作就是充当轻量级数据容器。由于元组支持 Python 的解构协议(Unpacking),我们可以用一行代码将元组中的多项数据精准注入不同变量,彻底告别依赖硬编码索引提取字段的脆弱写法。
1.1 基本位置解包与多变量无中间临时交换
当函数需要返回多个不同维度的状态时,直接返回元组是 Python 的标准规范。接收方直接在等号左侧声明对应数量的变量即可完成无损接收:
# 环境:Python 3.8+ 交互式终端或脚本
def query_user_location(user_id: int):
    # 模拟从数据库或底层服务返回经纬度与城市
    return 31.2304, 121.4737, "上海"  # 实际返回一个三元组 (lat, lon, city)

lat, lon, city = query_user_location(10086)
print(f"纬度: {lat}, 经度: {lon}, 城市: {city}")

# 经典场景:变量值互换(无需第三个临时变量 temp)
x, y = 10, 20
x, y = y, x  # 底层先将右侧打包为临时元组 (20, 10),再解包赋予左侧
print(f"交换后: x={x}, y={y}")纬度: 31.2304, 经度: 121.4737, 城市: 上海
交换后: x=20, y=10
1.2 扩展星号(*)解包应对不定长切分
如果在解包时左右两侧数量不匹配,Python 默认会抛出 ValueError: too many values to unpack。而借助 PEP 3132 引入的扩展星号表达式(Extended Iterable Unpacking),我们可以在元组任意位置放置带 * 的变量,捕获剩余所有元素并自动打包为 list:
log_record = ("2026-11-01", "POST", "/api/v1/trade", 200, 1420, 0.038)

# 提取首尾关键字段,中间指标由 *metrics 统一收集
log_date, method, path, *metrics, duration = log_record

print("访问日期:", log_date)
print("请求方法与路径:", method, path)
print("动态指标列表:", metrics)  # 收集到的 [200, 1420]
print("响应耗时(s):", duration)访问日期: 2026-11-01
请求方法与路径: POST /api/v1/trade
动态指标列表: [200, 1420]
响应耗时(s): 0.038
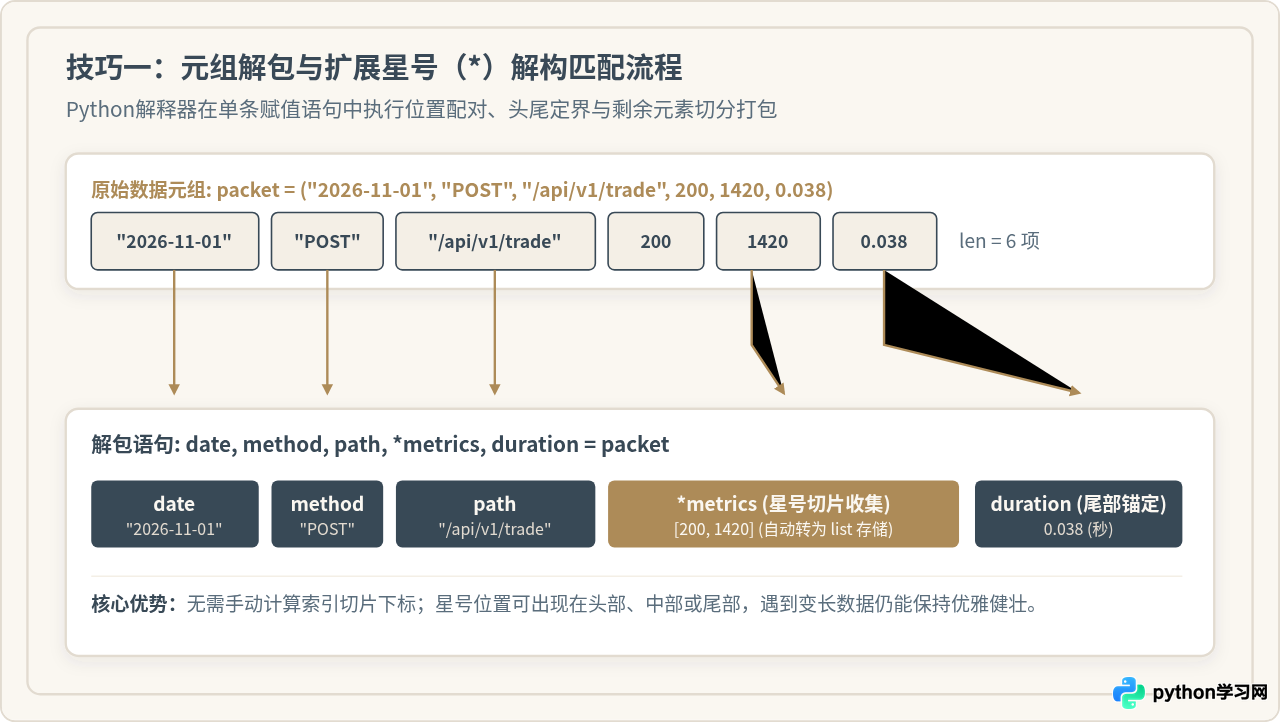
*head, mid, *tail = data 是非法语法,会引发 SyntaxError)。此外,即使没有任何中间元素,星号变量也会被安全赋值为空列表 [],不会触发越界报错。
2 技巧二:基于不可变性的切片衍生与安全拼接
初学者常常困惑:元组没有 append() 或 insert(),如果要在数据流中追加或修改元素该怎么办?答案是遵循函数式编程思想——不要原地修改,而是通过切片与加法拼接衍生新元组。
2.1 利用步长切片提取与反转
元组原生完整支持切片语法 tuple[start:stop:step]。切片操作始终返回一个新的元组对象,不仅执行速度处于 C 级别极快,而且绝对不会影响原始元组:
versions = ("v1.0", "v1.1", "v1.2", "v2.0", "v2.1", "v3.0")

# 1. 步长提取:获取所有偶数索引的阶段主版本
major_checkpoints = versions[::2]
print("里程碑版本:", major_checkpoints)

# 2. 负步长反转:O(N) 极速倒序生成
reversed_versions = versions[::-1]
print("逆序排列:", reversed_versions)里程碑版本: ('v1.0', 'v1.2', 'v2.1')
逆序排列: ('v3.0', 'v2.1', 'v2.0', 'v1.2', 'v1.1', 'v1.0')
2.2 替换或插入元素的衍生技巧
当需要更新元组中的某个特定位置时,我们可以利用切片两端与新元素相加:
config_tuple = ("prod-cluster", "10.0.0.12", 8080, "SSL_ENABLED")

# 需求:将端口 8080 (索引 2) 替换为 8443
# 注意:单元素元组必须带有逗号 (8443,),否则会被识别为普通带括号的整型表达式
updated_config = config_tuple[:2] + (8443,) + config_tuple[3:]

print("原始配置(保持不变):", config_tuple)
print("更新后新元组:", updated_config)原始配置(保持不变): ('prod-cluster', '10.0.0.12', 8080, 'SSL_ENABLED')
更新后新元组: ('prod-cluster', '10.0.0.12', 8443, 'SSL_ENABLED')
3 技巧三:多字段字典序(Lexicographical)比较与复合排序
元组拥有非常强大且优雅的比较机制:从左向右依次比对元素。一旦在某一位置分出大小,比较就会立刻短路终止并返回布尔值,根本不会去评估后续字段。这个特性在实现复合优先级队列或多条件排序时极其高效。
3.1 复合排序的极简表达
假设我们有一批订单数据,需要按照“优先级从高到低(降序)”、“响应耗时从小到大(升序)”以及“创建时间戳从小到大(升序)”进行多重排序。传统做法可能要编写复杂的比较函数或类,而在 Python 中,只需使用元组包装 key:
orders = [
    {"id": "A-101", "priority": 1, "latency_ms": 45, "ts": 1700000100},
    {"id": "B-202", "priority": 2, "latency_ms": 12, "ts": 1700000200},
    {"id": "C-303", "priority": 1, "latency_ms": 80, "ts": 1700000050},
    {"id": "D-404", "priority": 2, "latency_ms": 12, "ts": 1700000080},
]

# 排序规则:priority 越大越靠前(用负号反转数值实现降序),latency_ms 越小越靠前,ts 越小越靠前
sorted_orders = sorted(
    orders,
    key=lambda x: (-x["priority"], x["latency_ms"], x["ts"])
)

for o in sorted_orders:
print(f"ID: {o['id']} | 优先级: {o['priority']} | 耗时: {o['latency_ms']}ms | 时间: {o['ts']}")ID: D-404 | 优先级: 2 | 耗时: 12ms | 时间: 1700000080
ID: B-202 | 优先级: 2 | 耗时: 12ms | 时间: 1700000200
ID: A-101 | 优先级: 1 | 耗时: 45ms | 时间: 1700000100
ID: C-303 | 优先级: 1 | 耗时: 80ms | 时间: 1700000050
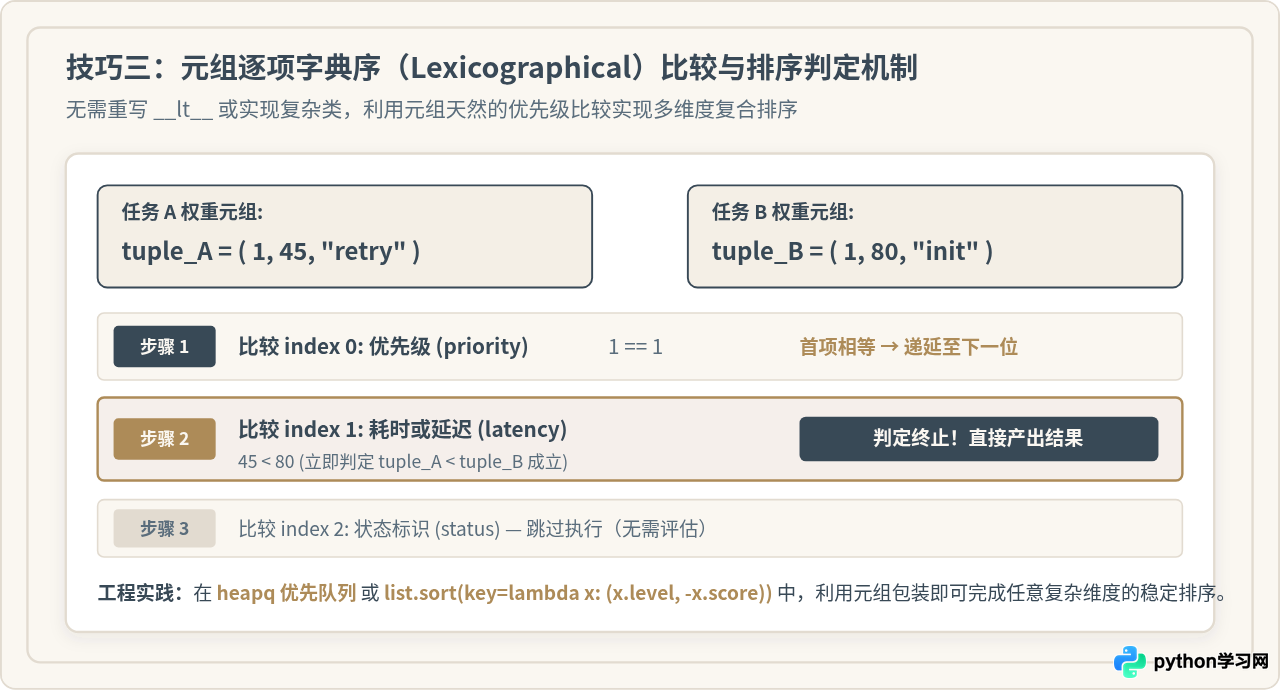
3.2 在 heapq 堆中杜绝不可比对象报错
在使用标准库 heapq 时,如果存入自定义对象 (priority, task_obj),当两个任务的 priority 相同时,Python 会尝试比较 task_obj < other_task_obj,若对象未实现 __lt__ 就会直接抛出 TypeError: '<' not supported between instances。
使用三元组 (priority, entry_count, task_obj) 即可完美避开这个问题。因为 entry_count 是单调递增的整数,绝不重复,比较逻辑在第二项就会分出先后,永远不会触发对 task_obj 的非法比较。
4 技巧四:哈希特性与字典复合键(Composite Keys)
Python 字典(dict)和集合(set)要求键必须是可哈希的(Hashable)。列表(list)由于是可变的,没有实现 __hash__,因此无法作为字典的键。而元组只要其包含的所有元素都是可哈希类型,元组自身就是完全可哈希的。
4.1 坐标、网格图与多字段复合索引
在处理地理信息系统、棋盘算法、网格坐标或多维矩阵时,我们无需定义嵌套字典 d[x][y],直接将元组作为复合键:
# 建立 3D 空间坐标映射表
world_voxel_map = {}

# (x, y, z) 坐标元组直接作为 dict 的 key
world_voxel_map[(0, 0, 0)] = "BasePlatform"
world_voxel_map[(12, -4, 5)] = "EnergyPylon"
world_voxel_map[(12, -4, 6)] = "Beacon"

target_coord = (12, -4, 5)
print(f"坐标 {target_coord} 上的实体:", world_voxel_map.get(target_coord, "Air"))

# 集合去重复合主键
seen_composite_keys = set()
seen_composite_keys.add(("tenant_01", "order_20261101_001"))
print("租户与订单联合键是否存在:", ("tenant_01", "order_20261101_001") in seen_composite_keys)坐标 (12, -4, 5) 上的实体: EnergyPylon
租户与订单联合键是否存在: True
4.2 原生支撑多参数记忆化缓存(Memoization)
Python 标准库 functools.lru_cache 的底层原理,就是把调用函数的每一个位置参数自动组合成一个元组,并将该元组作为内部字典查找命中缓存的键。
t = (1, 2, [3, 4]),因为包含列表,执行 hash(t) 会立即触发 TypeError: unhashable type: 'list'。因此,作为复合键时必须确保元素全为基础不可变类型(int、str、float、tuple 等)。
5 技巧五:向强类型与可读性演进——NamedTuple
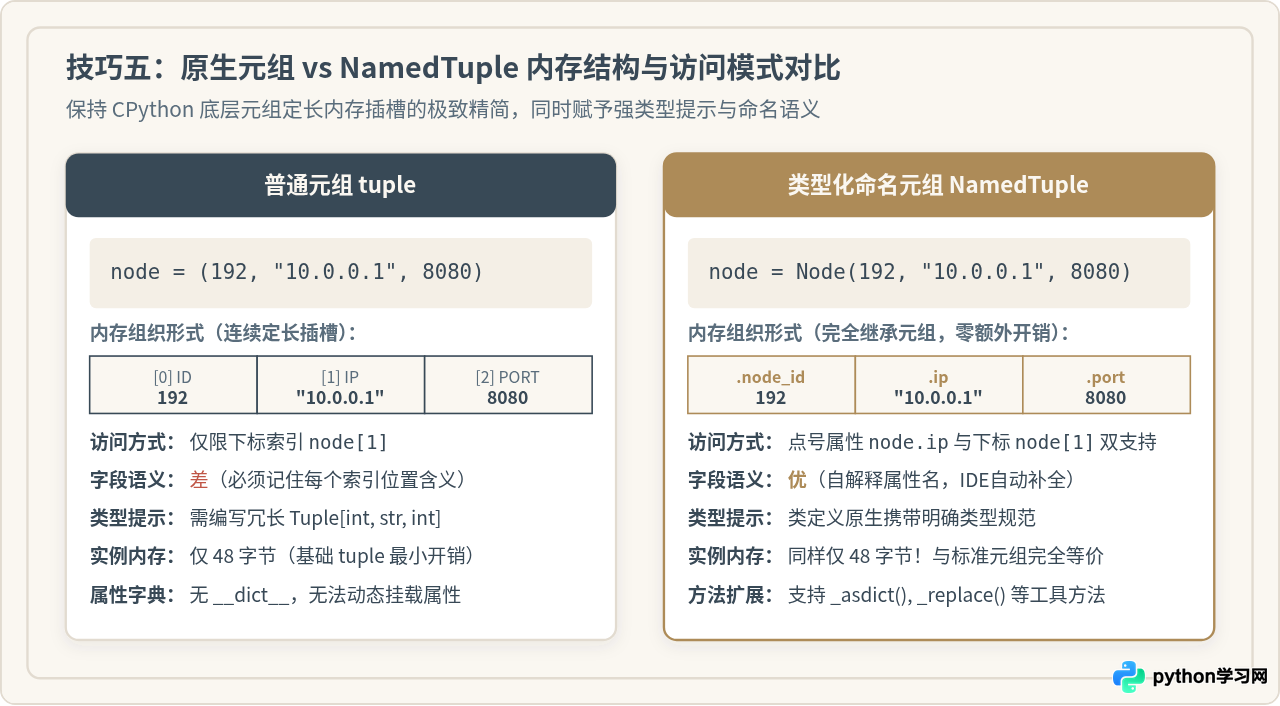
普通元组有一个显著痛点:依赖数字索引访问。代码中充斥着 record[0]、record[3] 会严重破坏可读性。如果未来元组中间增加了一个字段,所有硬编码的数字下标都会错位产生隐蔽 Bug。
Python 标准库提供了进阶解法:collections.namedtuple 与现代的 typing.NamedTuple。它在保留元组所有优势的同时,带来了类对象般的优雅属性访问。
5.1 使用 typing.NamedTuple 编写现代化工业级结构体
通过声明继承自 typing.NamedTuple 的类,可以为每个字段提供类型提示、默认值,并且支持 IDE 的自动代码补全:
from typing import NamedTuple

class ServerNode(NamedTuple):
    node_id: int
    ip_address: str
    port: int = 8080
    active: bool = True

# 1. 实例化:支持位置参数与关键字参数
node = ServerNode(101, "192.168.1.50")

# 2. 核心特性:同时支持点号属性访问与经典元组下标
print("按属性名访问:", node.ip_address, node.port)
print("按元组索引访问:", node[0], node[1])

# 3. 完全向下兼容解包语法
nid, ip, port, is_active = node
print(f"解包输出: ID={nid}, Active={is_active}")

# 4. 辅助方法:_replace 产生修改后的新命名元组
upgraded_node = node._replace(port=8443)
print("通过 _replace 衍生的新实例:", upgraded_node)按属性名访问: 192.168.1.50 8080
按元组索引访问: 101 192.168.1.50
解包输出: ID=101, Active=True
通过 _replace 衍生的新实例: ServerNode(node_id=101, ip_address='192.168.1.50', port=8443, active=True)
5.2 为什么优先选择 NamedTuple 而非普通 Class 或 dict?
| 特性维度 | 标准字典 dict | 常规自定义 Class | typing.NamedTuple |
|---|---|---|---|
| 内存开销 | 大(哈希桶空间冗余) | 较大(默认包含 __dict__) |
极小(与纯元组完全相同,紧凑槽位) |
| 不可变保证 | 否(键值可随时增删) | 否(属性可随意重写) | 是(天然不可变,防止意外篡改) |
| 支持解包 | 否(需调用 .values()) | 否(需实现解包协议) | 是(原生全兼容元组解包) |
| 可哈希复合键 | 否(TypeError) | 需手动实现 __hash__ / __eq__ | 是(可直接作为 dict 键或存入 set) |
总结与选型指南
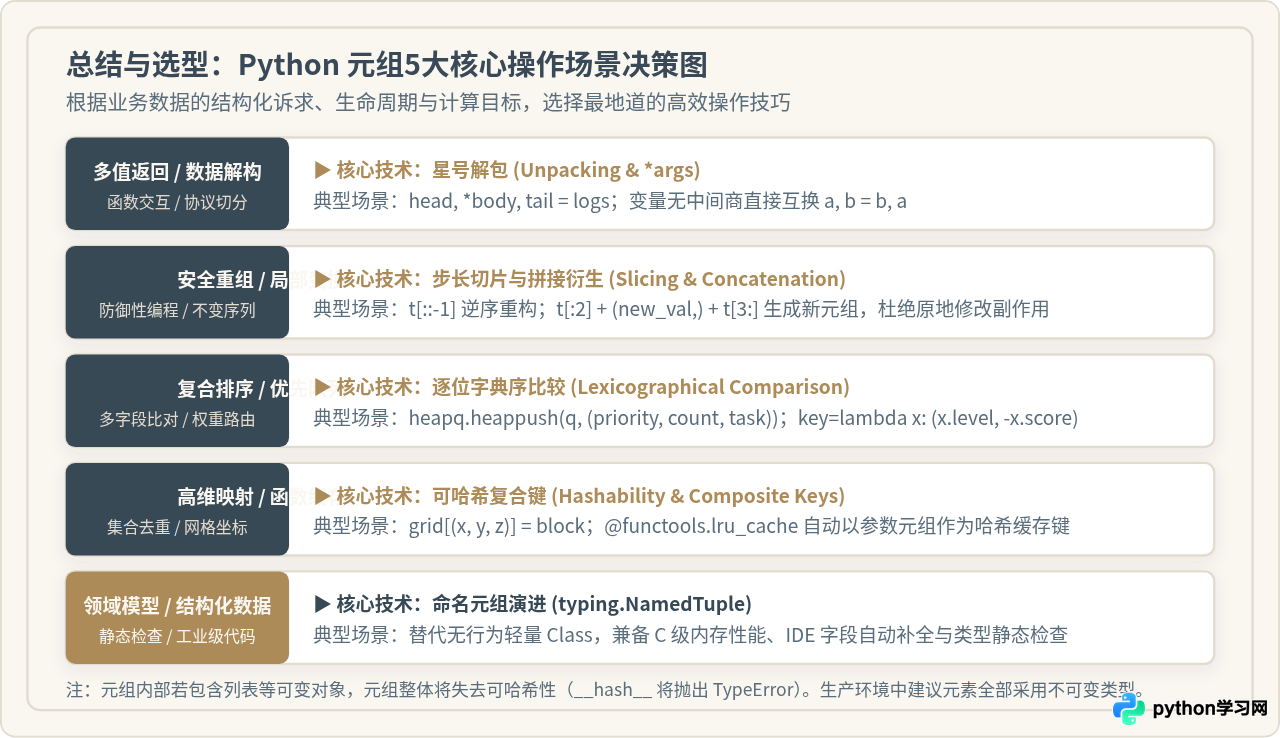
Python 之所以给元组只保留 count() 和 index(),正是因为元组的使命是作为轻量、定长、不可变的结构化数据载体。它不需要列表那些复杂的修改方法,而是与解释器的核心协议紧密融合:
- 处理多返回值与复杂协议拆分时,首选星号结构化解包;
- 在多线程与安全管道传递数据时,利用切片与不可变拼接衍生新实例;
- 在多字段综合排序与优先队列中,直接利用逐项短路字典序比较;
- 在多维空间检索、图计算与记忆化缓存中,把元组作为不可变哈希复合键;
- 在大型工程协作中,将匿名元组升级为 NamedTuple,兼揽极致性能与类型自解释性。
深入理解并灵活运用这 5 种操作技巧,你便能用最地道、最健壮的 Python 代码驾驭这一基础内置类型。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















