


为什么修改Python浅拷贝后的嵌套列表会影响原数据?
深入解析在Python中对浅拷贝生成的嵌套列表进行内部修改会同步影响原列表的底层原因。通过内存模型、指针引用分析与分步执行推导,对比就地修改与重新赋值的本质差异,并给出清晰的高效防范与解决实践。
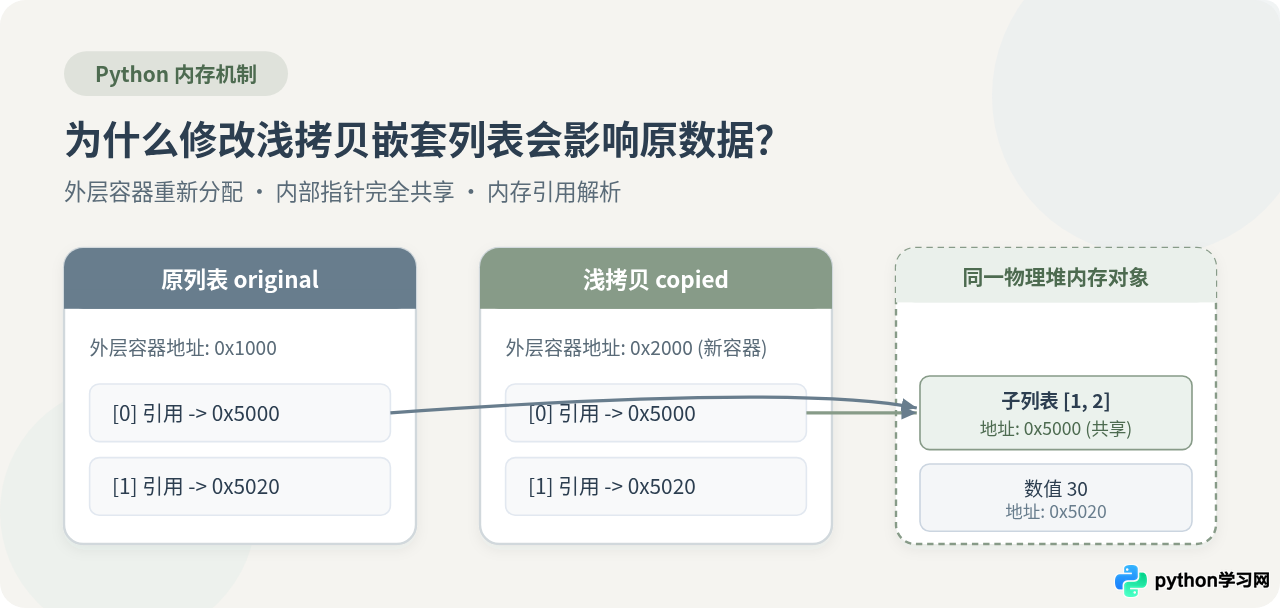
list.copy()、切片 [:] 或 copy.copy())只复制了外层的列表容器本身,而不会递归复制容器内的子对象。浅拷贝生成的新列表所包含的元素,仅仅是原列表中各个子对象的内存指针引用。当列表中包含子列表等“可变对象”时,新旧列表内部存储的是完全相同的子列表内存地址;因此,通过新列表对嵌套子列表进行“就地修改”(如追加元素或修改下标项)时,改变的是两者共享的同一块内存区域,原列表必然会受到同步影响。
一、现象直击:一次让人困惑的列表修改
在日常使用 Python 处理数据时,很多初学者为了保护原始数据,会习惯性地在修改前对列表做一次拷贝。然而,一旦列表中嵌套了子列表,事情往往会出乎意料:
# 示例代码:浅拷贝嵌套列表并尝试修改子项
original = [[1, 2], [3, 4]]
copied = original.copy()  # 执行浅拷贝

# 对拷贝后列表的第一个子列表追加元素
copied[0].append(99)

print("copied:  ", copied)
print("original:", original)original: [[1, 2, 99], [3, 4]]
此时会发现,我们明明只对 copied[0] 执行了 .append(99),从未直接操作过 original,但 original 内部的第一项却同样多出了 99。这违背了我们对“独立副本”的直观预期。
二、内存透视:浅拷贝到底拷贝了什么?
要理解这个现象,首先必须理解 Python 的底层变量与容器模型:Python 的列表并不是一块连续存放具体数值的实心积木,而是一个存放“对象引用(指针)”的连续数组。
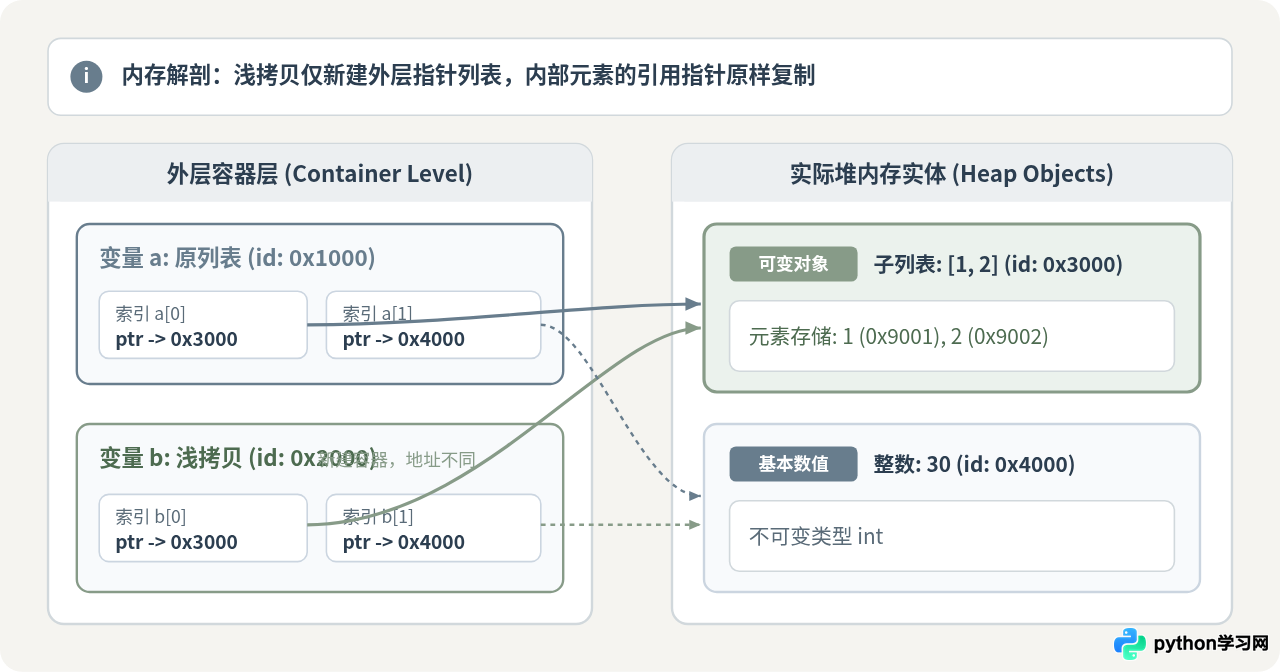
当你创建一个列表 original = [[1, 2], [3, 4]] 时,系统在内存中实际上创建了三个主要对象:
- 子列表对象 A:内容为
[1, 2],假设其内存地址为0x3000。 - 子列表对象 B:内容为
[3, 4],假设其内存地址为0x4000。 - 外层列表对象
original:存放了两个地址指针[0x3000, 0x4000],其自身地址假设为0x1000。
此时调用 copied = original.copy() 产生浅拷贝,Python 会在堆内存中新分配一个外层列表容器(假设地址为 0x2000),随后把 original 中存放的指针原封不动地抄写到新容器中。因此,copied 容器内部存储的依然是 [0x3000, 0x4000]。
我们可以使用内置函数 id() 直接在代码中验证这一内存事实:
# 验证外层容器与内层子对象的内存地址
print("外层容器 ID 是否不同:", id(original) != id(copied))
print("子列表对象 ID 是否相同:", id(original[0]) == id(copied[0]))子列表对象 ID 是否相同: True
输出结果明确证实:外层容器确实是独立的(ID 不同),但内层包含的子列表是同一个物理对象(ID 完全相同)。这就是“浅”字的真正含义——只浅浅地复制了一层容器外壳,内部指针丝毫不动。
三、执行推导:修改操作引发的“连环反应”
理解了内存模型后,我们把 copied[0].append(99) 的执行过程分解为微观步骤,便能清晰看到原列表是如何“被动改变”的:
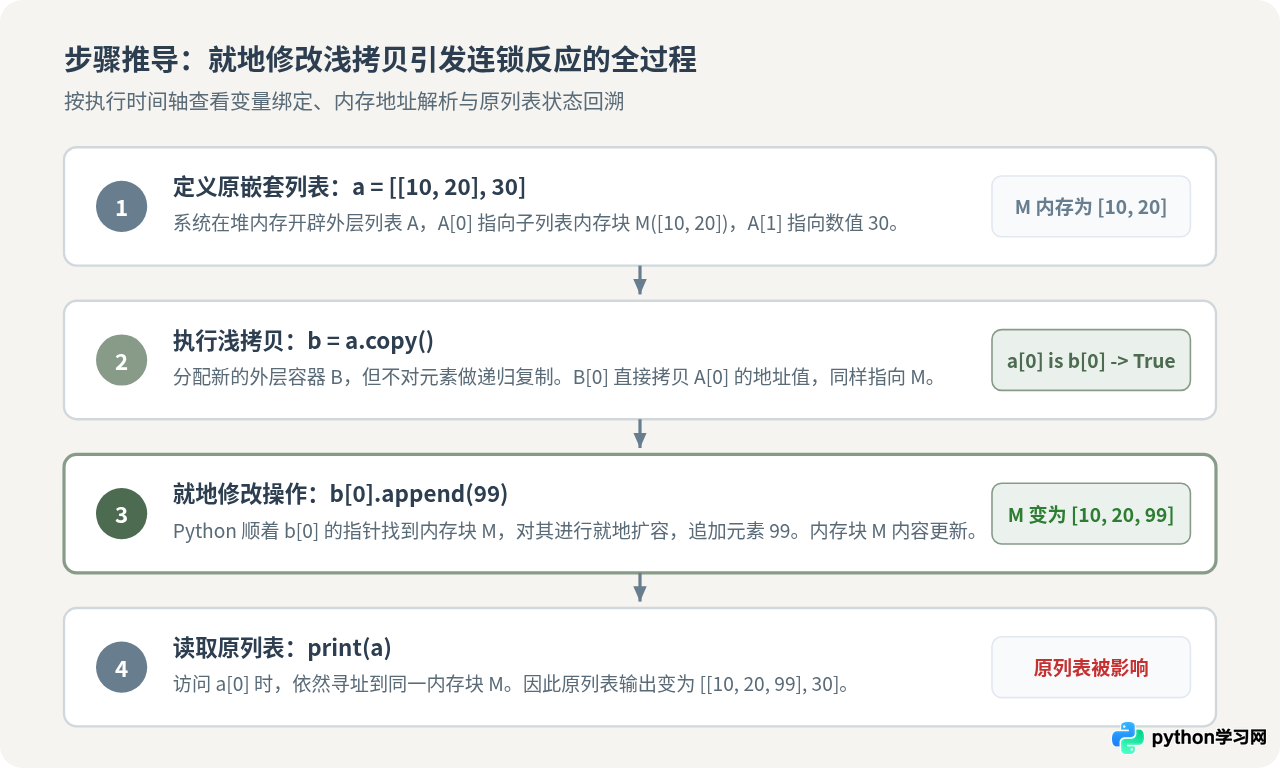
- 寻址阶段:解释器先解析
copied[0]。新容器copied在其 0 号槽位上取出了指针0x3000。 - 操作阶段:解释器顺着
0x3000找到物理内存中的子列表[1, 2],并对其调用append方法。列表是可变对象(Mutable Object),因此直接在当前内存块就地扩容,写入99。此时该内存块的值变为[1, 2, 99],但该子列表自身的物理地址依然是0x3000,指针并未发生任何改变。 - 回溯阶段:当程序后续执行
print(original)时,解释器需要读取original[0]。原容器从自身的 0 号槽位取出的依然是指针0x3000,它指向的正是刚刚被修改过的内存块,读出的数据自然就是[1, 2, 99]。
四、关键差异对照:就地修改 vs 重新赋值
初学者容易产生一个误区:“既然子列表共享引用,那是不是只要我对 copied[0] 动任何手脚,original 都会变?”答案是否定的。关键在于你采用的是“就地修改内部(In-place Mutation)”还是“对外层元素重新赋值(Reassignment)”。
让我们在完全一致的初始条件下对比这两种操作:
| 对比维度 | 情境 A:就地修改内部元素 | 情境 B:对外层索引重新赋值 |
|---|---|---|
| 典型操作 | copied[0].append(99) 或 copied[0][0] = 99 |
copied[0] = [100, 200] |
| 作用对象 | 指针所指向的子列表内部内存块 | 外层容器 copied 的 0 号槽位指针本身 |
| 指针状态 | 槽位指针不变,依然指向 0x3000 |
槽位指针被改绑,指向新生成的列表 0x8000 |
| 对原数据影响 | 会影响 original[0] | 不会影响 original[0] |
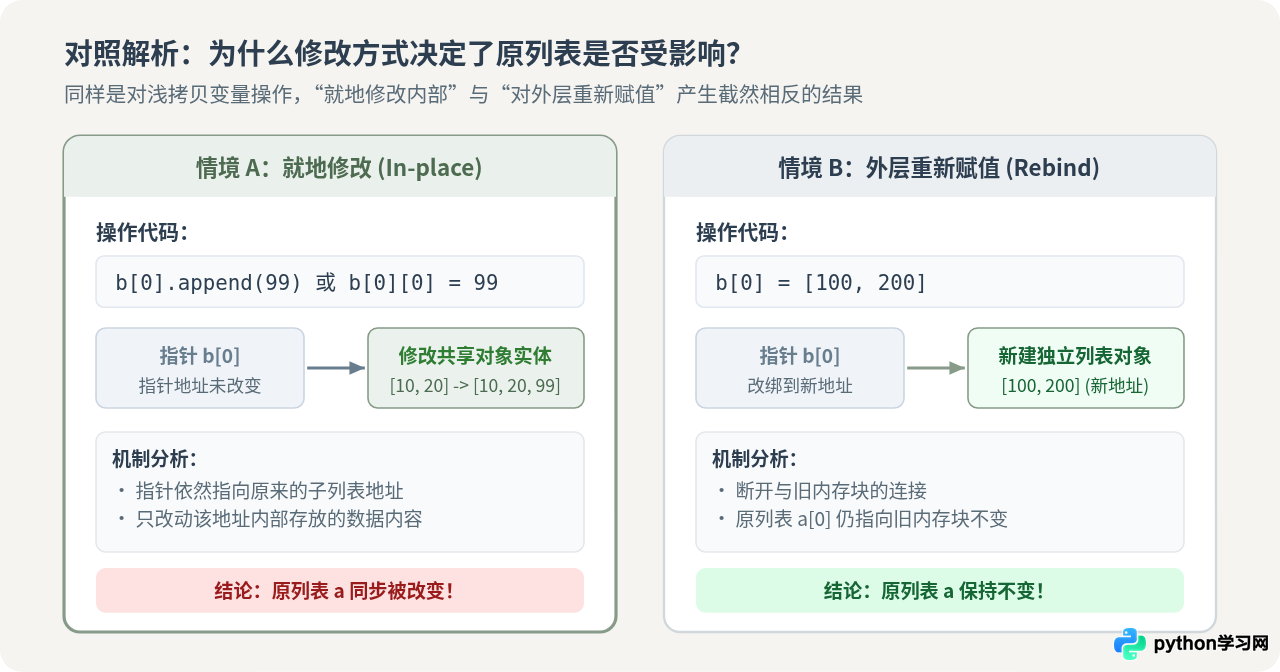
下面通过代码直观验证情境 B 的执行结果:
# 验证情境 B:对外层索引重新赋值
original = [[1, 2], [3, 4]]
copied = original.copy()

# 直接将 copied[0] 指向一个全新创建的列表对象
copied[0] = [100, 200]

print("copied:  ", copied)
print("original:", original)original: [[1, 2], [3, 4]]
可以看到,由于 copied[0] = ... 是将 copied 的 0 号槽位与原内存块 0x3000 解绑,并绑定到了新的列表对象上,因此原列表 original[0] 毫发无损。这进一步证明了:原数据之所以被影响,是因为就地修改了共享的子对象实体,而非修改了容器本身。
五、彻底解决:如何避免嵌套列表互相影响?
如果业务逻辑确实需要对嵌套子列表进行添加、删除或内容修改,且要求原始数据保持绝对独立,有以下三种行之有效的方法:
1. 使用标准库 copy.deepcopy()(深拷贝)
深拷贝会递归遍历对象树,当遇到子列表、字典等嵌套可变对象时,会全部克隆出全新的物理副本,从而彻底切断所有引用共享。
import copy

original = [[1, 2], [3, 4]]
# 使用 deepcopy 递归克隆整个对象树
deep_copied = copy.deepcopy(original)

deep_copied[0].append(99)

print("deep_copied: ", deep_copied)
print("original: ", original)original: [[1, 2], [3, 4]]
deepcopy 功能强大,能处理复杂的循环引用结构,但其底层通过递归和对象备忘录实现,在数据规模较大或层级很深时性能开销显著。
2. 列表推导式显式浅拷贝子层(适用于确定两层的矩阵结构)
在二维矩阵或固定两层嵌套的场景中,如果不需要递归到更深层,使用列表推导式逐个复制子列表往往比 deepcopy 性能快 3~5 倍:
original = [[1, 2], [3, 4]]
# 对每一个子列表进行单层拷贝
safe_copied = [item.copy() for item in original]

safe_copied[0].append(99)
print("original 依然保持原样:", original)  # [[1, 2], [3, 4]]
3. 防御性设计:使用不可变类型(元组)
如果子列表的内容在业务逻辑中不应当被篡改,在数据初始化阶段优先使用元组(tuple)代替列表。例如 [(1, 2), (3, 4)]。元组不可变,任何尝试调用 append 或修改下标项的代码都会直接抛出 TypeError,从源头杜绝非预期的副作用。
六、总结与技术选型指南
为了在实际开发中快速做出正确决策,请参考以下逻辑判定图:
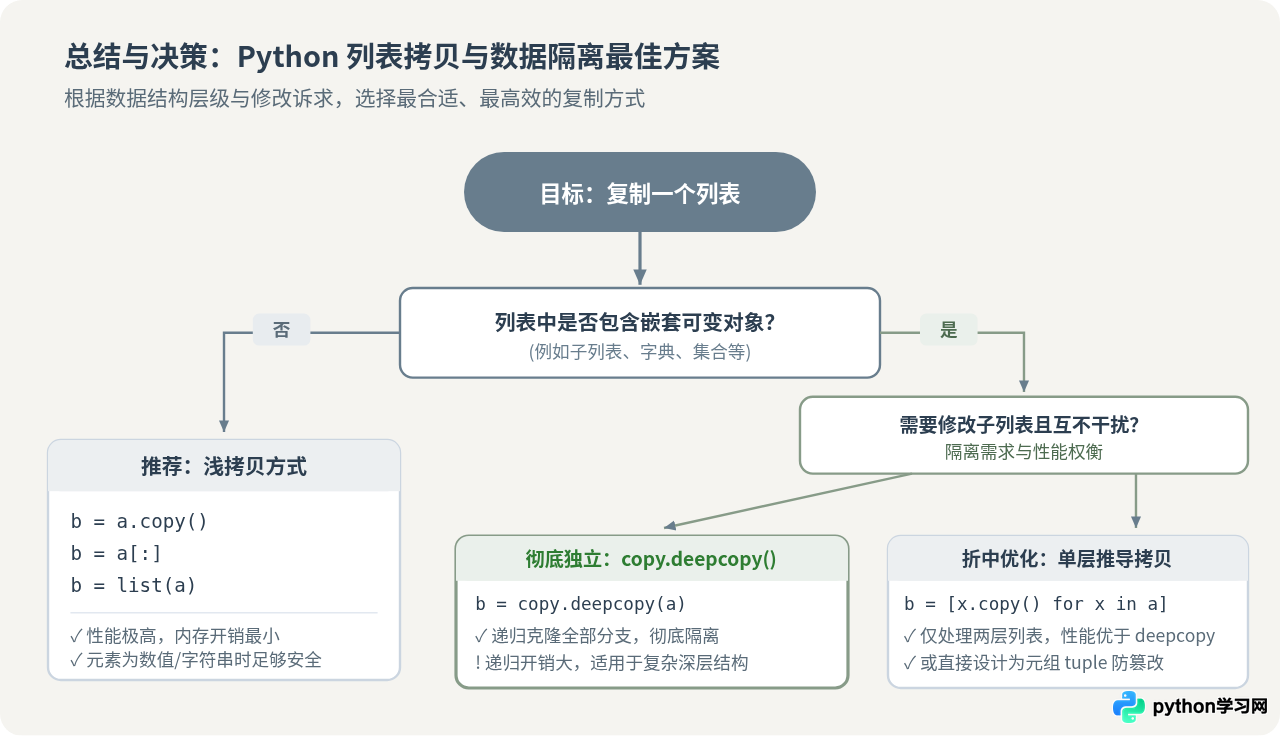
最后,请牢记以下常见的浅拷贝形式,它们在面对嵌套可变对象时都会表现出相同的引用共享特性:
- 切片语法:
b = a[:] - 类型工厂函数:
b = list(a) - 内置方法:
b = a.copy() - 标准库单层拷贝:
import copy; b = copy.copy(a) - 乘法重复列表:
a = [[]] * 3(特别警惕:此时生成的 3 个子项指向同一个空列表)
只要牢记“浅拷贝只造新壳,不造新瓤”这一根本特征,在面对嵌套可变对象时主动评估是否需要深拷贝或数据冻结,就能彻底避开数据被意外污染的隐蔽陷阱。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















