


Python主要就业方向盘点:Web后端、数据分析与AI岗位解析
深度盘点Python三大主要就业方向:Web后端开发、数据分析与商业智能、人工智能与算法工程。详细解析各方向技术栈、工作交付物、代码实例及求职选型依据。
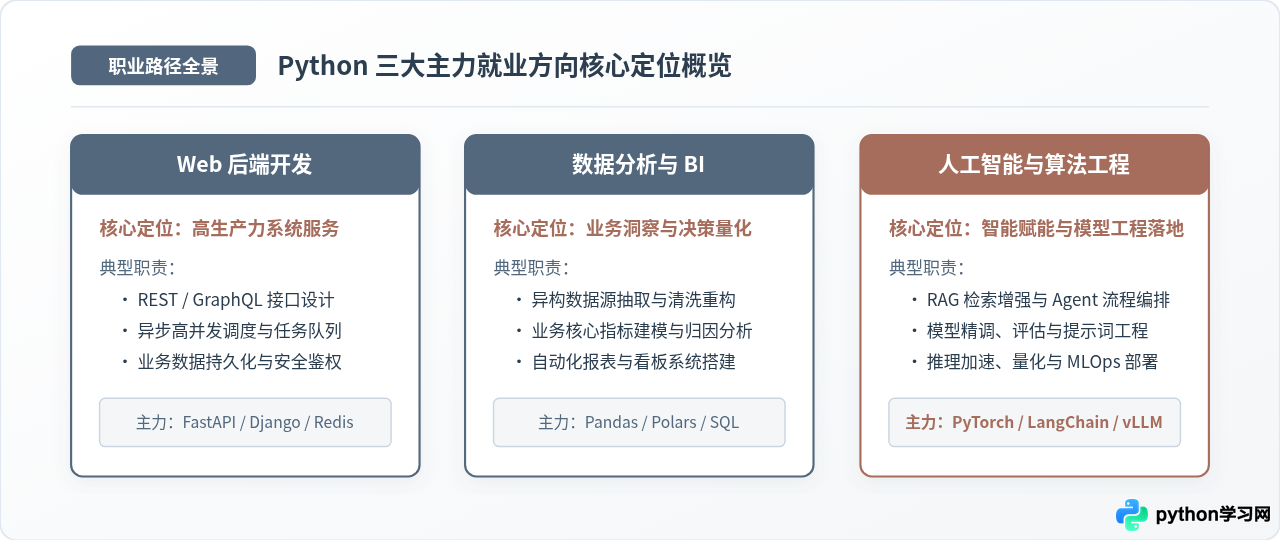
企业在招聘时几乎不会招募泛泛的“Python 程序员”,而是严格按照业务形态招聘具体岗位的工程师。目前以 Python 为主力技术栈的就业方向高度集中在三大板块:Web 后端开发、数据分析与商业智能(BI)以及人工智能与算法工程。本文将针对这三大方向的工程门槛、核心交付物、真实技术代码和求职选型逻辑展开具体解析。
一、求职分流的前提:为什么不存在纯粹的“Python 岗位”
在技术交流中,Python 常因“语法简洁、胶水特性强”被初学者误认为学会语法便能胜任开发工作。然而在真实的工业界协作中,编程语言只是表达业务逻辑的底层工具,决定岗位薪资与招聘门槛的是特定领域的业务壁垒与工程范式。
选择就业方向本质上是选择日常工作中解决的核心问题:
- Web 后端开发:核心在于系统工程与并发稳定性。关注网络协议、高可用服务、数据库事务、缓存更新以及接口契约,交付物是可以稳定运行的在线服务。
- 数据分析与 BI:核心在于业务洞察与量化决策。关注指标体系拆解、脏数据清洗、异构数据抽取与业务归因,交付物是支撑商业决策的分析报告与可视化看板。
- AI 与算法工程:核心在于模型赋能与工程落地。关注私有知识库检索增强(RAG)、Agent 自动化流程编排、模型量化推理与上下文长文本工程,交付物是具有推理判断能力的智能化服务模块。
明确这一底层逻辑后,求职者即可避免“为了学库而学库”的无效内卷,结合自身的专业背景、工程积累与逻辑偏好进行精准对位。
二、方向一:Web 后端开发——高生产力服务与现代化架构
在后端领域,虽然国内超大流量场景多采用 Java 或 Go 构建中台,但 Python 凭借其极高的生产效率与活跃的现代生态,在中小企业敏捷开发、企业级中后台管理系统、海外远程外企,以及目前爆发式增长的 AI 原生应用接入层中占据着不可替代的生态位。
1. 核心技术栈与职责分层
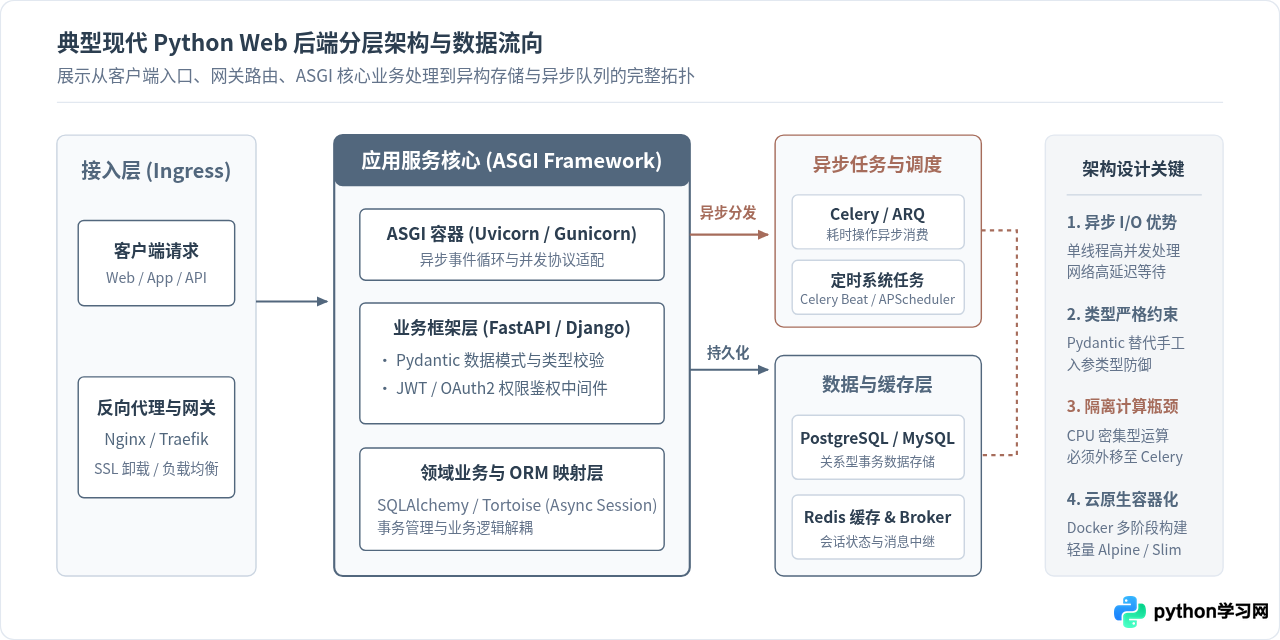
现代化 Python 后端开发已经全面告别过去的同步阻塞模式,以 FastAPI、Starlette 为代表的异步 ASGI 框架成为主流,同时老牌成熟的 Django 在大型全功能企业应用中依然具备极高的统治力:
- 网关与 ASGI 容器:Nginx 负责反向代理与 TLS 终结,Uvicorn 或 Gunicorn 负责处理并发请求事件循环。
- 核心业务框架:FastAPI 提供类型提示驱动的高性能路由与自动 OpenAPI 文档生成;Pydantic 负责入参严格类型校验与响应序列化。
- 持久层与 ORM:PostgreSQL / MySQL 配合异步 SQLAlchemy 2.0 或 Tortoise-ORM 实现数据事务安全操作与高效连接池复用。
- 异步削峰与任务调度:基于 Redis 的 Celery 或轻量级 ARQ,将邮件推送、大文件导出、模型调用等耗时任务从 Web 请求中解耦。
2. 生产级开发代码示例:异步任务与严谨校验
以下展示现代 Python 后端最典型的开发风格:利用 FastAPI 实现强类型校验、异步数据库交互及异步耗时任务解耦。
from fastapi import FastAPI, BackgroundTasks, HTTPException, status
from pydantic import BaseModel, Field, EmailStr
from typing import Optional
import asyncio

app = FastAPI(title="用户开通服务接口", version="1.0.0")

# 1. 严格的数据模式定义 (Schema)
class UserRegisterRequest(BaseModel):
    username: str = Field(..., min_length=3, max_length=32, description="用户唯一账号名")
    email: EmailStr = Field(..., description="有效工作邮箱")
    tier: str = Field(default="standard", pattern="^(standard|premium)$", description="会员级别")

class UserRegisterResponse(BaseModel):
    user_id: int
    username: str
    status: str
    message: str

# 2. 模拟耗时异步操作(如生成初始空间、发送激活邮件)
async def send_welcome_and_provision(email: str, username: str):
    await asyncio.sleep(2)  # 模拟网络与 I/O 耗时
    print(f"[异步审计] 用户空间配置完成,已向 {email} 发送激活通知")

# 3. 核心 API 端点
@app.post(
    "/api/v1/users",
    response_model=UserRegisterResponse,
    status_code=status.HTTP_201_CREATED,
    summary="创建用户并异步初始化环境"
)
async def create_user(payload: UserRegisterRequest, background_tasks: BackgroundTasks):
    # 模拟业务唯一性校验
    if payload.username == "admin":
        raise HTTPException(
            status_code=status.HTTP_400_BAD_REQUEST,
            detail="保留用户名,不允许外部注册"
        )

    # 模拟持久化到数据库
    simulated_user_id = 1024

    # 将高耗时 I/O 卸载至后台任务,立即向调用方返回响应
    background_tasks.add_task(send_welcome_and_provision, payload.email, payload.username)

    return UserRegisterResponse(
        user_id=simulated_user_id,
        username=payload.username,
        status="active",
        message="用户创建成功,初始化环境已在后台排队处理"
    )
requests.get() 或同步数据库驱动)。一个长达 3 秒的同步阻塞会直接冻结单进程内的所有并发请求,必须使用 httpx.AsyncClient 或将阻塞调用放入线程池 run_in_executor 中执行。
三、方向二:数据分析与 BI——从清洗规整到商业决策归因
数据分析岗位的核心价值不是“画好看的柱状图”,而是在业务混乱沉淀的异构日志与交易数据中,找出阻碍业务增长或导致流失的根因,并给出量化依据。该方向对跨专业转行者相对包容,但门槛正从单纯的“Excel + 简单脚本”向“SQL 高级运算 + 现代工程化数据处理(Polars/Pandas)+ 深入商业洞察”快速提升。
1. 数据分析与指标建模工作流
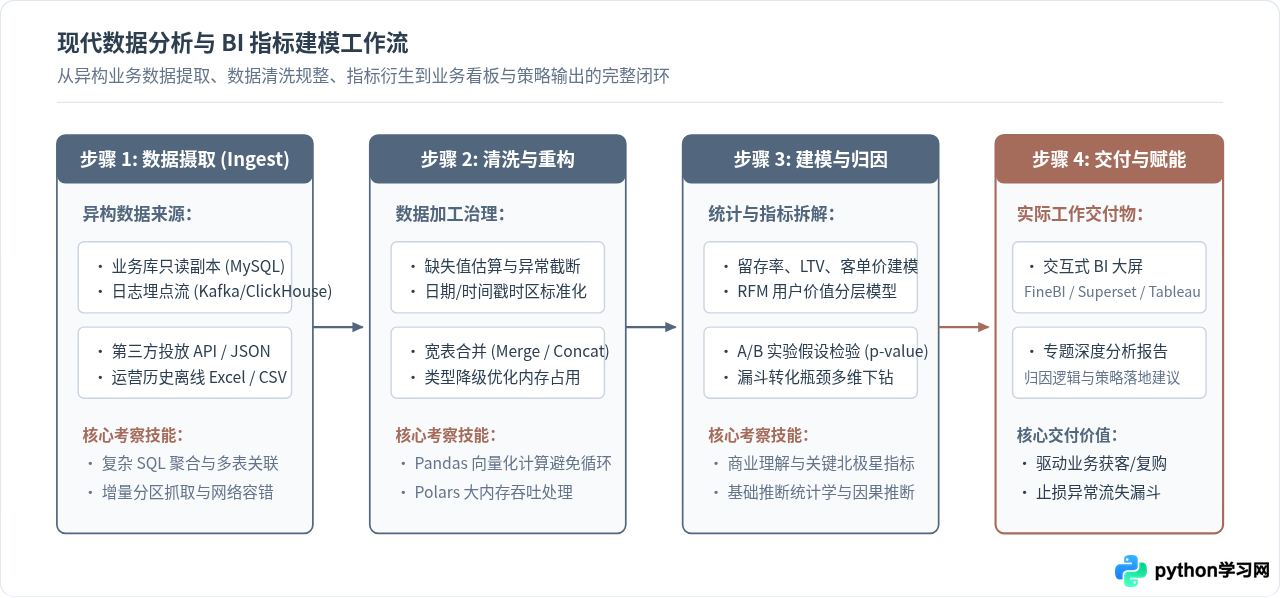
现代数据分析工作已形成高度规范的标准闭环:
- 数据摄取阶段:通过复杂 SQL 从数仓(Hive/ClickHouse/StarRocks)拉取业务分区数据,或通过 API 与日志收集管道抽取增量日志。
- 清洗重构阶段:处理脏数据、填补异常值、时区对齐、宽表 Join,并进行字段降级以降低内存开销。
- 指标建模阶段:搭建留存分析(Cohort Analysis)、用户生命周期价值(LTV)、RFM 用户价值分层、A/B 实验假设检验等。
- 决策输出阶段:提炼明确的归因结论,转化为企业决策看板与专题复盘报告。
2. 典型数据分析代码示例:分组聚合与留存矩阵计算
以下示例展示使用 Pandas 进行用户月度行为留存率计算的工程标准写法,避免低效的 Python 原生 for 循环,使用向量化操作处理数据:
import pandas as pd
import numpy as np

# 1. 构造生产环境常见的用户订单流水原始数据
raw_data = {
    "order_id": range(1, 9),
    "user_id": [101, 102, 101, 103, 102, 101, 104, 103],
    "order_time": [
        "2024-01-15", "2024-01-20", "2024-02-10", "2024-02-14",
        "2024-02-18", "2024-03-05", "2024-03-12", "2024-03-22"
    ],
    "amount": [128.5, 89.0, 210.0, 56.5, 99.0, 320.0, 45.0, 78.0]
}

df = pd.DataFrame(raw_data)

# 2. 数据规范化:转换时间并抽取年月周期
df["order_date"] = pd.to_datetime(df["order_time"])
df["order_month"] = df["order_date"].dt.to_period("M")

# 3. 计算每个用户的首单发生月份(Cohort)
cohort_first_month = df.groupby("user_id")["order_month"].min().rename("cohort_month")
df = df.join(cohort_first_month, on="user_id")

# 4. 计算用户复购与首单的月份差值
def calculate_period_diff(row):
    return (row["order_month"].year - row["cohort_month"].year) * 12 + \
           (row["order_month"].month - row["cohort_month"].month)

df["period_distance"] = df.apply(calculate_period_diff, axis=1)

# 5. 生成留存矩阵
cohort_group = df.groupby(["cohort_month", "period_distance"])["user_id"].nunique().unstack()
cohort_size = cohort_group.iloc[:, 0]
retention_matrix = cohort_group.divide(cohort_size, axis=0).round(4) * 100

print("=== 用户 Cohort 月度留存分析矩阵 (%) ===")
print(retention_matrix)
四、方向三:AI 与算法工程——大模型落地的工程范式演进
AI 岗位在过去几年发生了深刻的结构分化。单纯在高校写论文、炼丹跑小模型的传统“算法研究员”岗位极度内卷且要求顶会论文与博士学历;而在工业界真实爆发的招聘增长点,是大模型应用开发工程师(LLM Application Engineer)与模型工程部署专家(MLOps)。这类岗位要求扎实的 Python 编程功底、敏锐的系统工程能力与对前沿大模型特性的熟练运用。
1. 渐进式技术演进路径
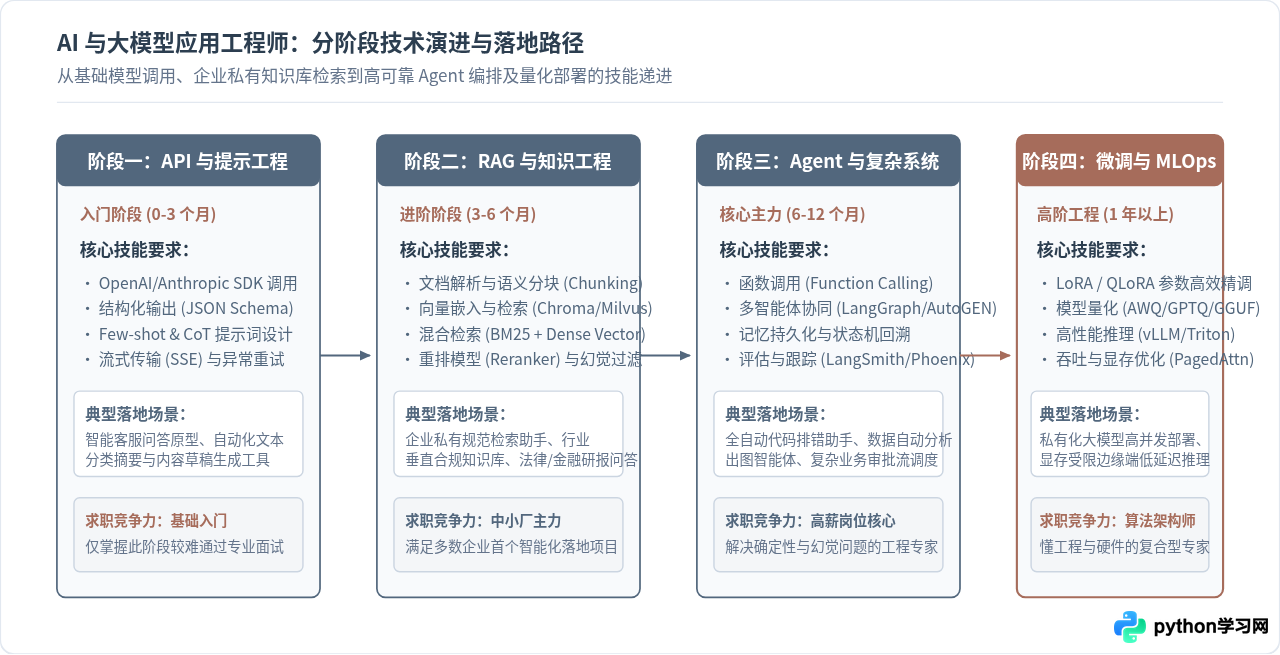
从传统 Python 开发者向 AI 大模型工程师进阶,建议遵循清晰的阶段梯度:
- 阶段一:API 接入与结构化输出。熟练掌握 Prompt Engineering、Few-shot、JSON 约束模式、异步流式响应。
- 阶段二:RAG 与知识工程。深入语义切片策略(Chunking)、多路召回(BM25 稠密+稀疏向量)、向量数据库与重排(Reranker)过滤。
- 阶段三:Agent 与自主智能体编排。利用 LangGraph、AutoGen 搭建带状态回溯的复杂工作流,利用 Function Calling 驱动外部 API。
- 阶段四:微调与高并发推理部署。掌握 LoRA/QLoRA 领域模型微调,熟悉 vLLM、Triton、AWQ 量化与显存优化技术。
2. 生产级 RAG 检索增强工程代码示例
以下展示一个工业级知识库检索流程的骨架代码:结合向量检索、相似度阈值过滤与上下文拼接:
from typing import List, Dict
import numpy as np

class VectorStoreDemo:
    def __init__(self):
        # 模拟预存的企业制度知识库嵌入向量与文本
        self.doc_embeddings: Dict[str, np.ndarray] = {
            "doc_1": np.array([0.15, 0.82, -0.31, 0.44]),
            "doc_2": np.array([-0.05, 0.12, 0.94, 0.21]),
            "doc_3": np.array([0.22, 0.79, -0.28, 0.51])
        }
        self.doc_contents: Dict[str, str] = {
            "doc_1": "公司年假标准:入职满一年享有 5 天带薪年假,每年 3 月自动更新额度。",
            "doc_2": "财务报销规范:发票需包含公司全称与纳税人识别号,每月 25 日截止提交。",
            "doc_3": "加班补偿规定:工作日延时加班按 1.5 倍核算调休,周末加班按 2 倍核算。"
        }

    def cosine_similarity(self, a: np.ndarray, b: np.ndarray) -> float:
        norm_a = np.linalg.norm(a)
        norm_b = np.linalg.norm(b)
        if norm_a == 0 or norm_b == 0:
            return 0.0
        return float(np.dot(a, b) / (norm_a * norm_b))

    def retrieve_context(self, query_vec: np.ndarray, top_k: int = 2, threshold: float = 0.6) -> List[str]:
        scored_docs = []
        for doc_id, emb in self.doc_embeddings.items():
            score = self.cosine_similarity(query_vec, emb)
            if score >= threshold:
                scored_docs.append((score, self.doc_contents[doc_id]))

        # 按相似度降序排列
        scored_docs.sort(key=lambda x: x[0], reverse=True)
        return [content for _, content in scored_docs[:top_k]]

# 运行检索示例
store = VectorStoreDemo()
# 模拟用户提问“请问年休假有几天”的查询嵌入
mock_query_embedding = np.array([0.18, 0.80, -0.30, 0.46])
contexts = store.retrieve_context(mock_query_embedding)

print("=== 命中企业私有知识库参考上下文 ===")
for idx, ctx in enumerate(contexts, 1):
    print(f"[{idx}] {ctx}")
五、三大方向综合决策:能力模型与选型矩阵
选择哪一个就业方向,不仅取决于市场薪酬行情,更取决于求职者自身的技术积累、数理能力与学历背景。盲目追求所谓“高薪风口”往往容易导致在面试第一轮便因学历或工程底子不足而被筛选淘汰。
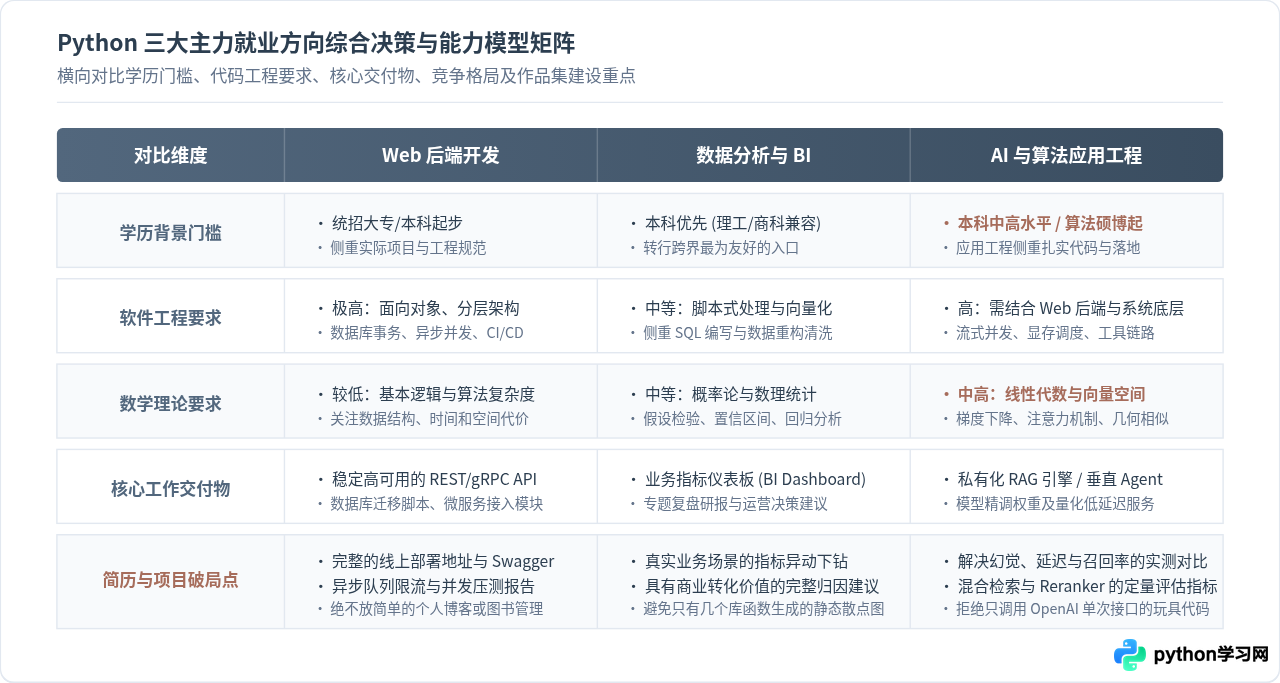
客观选型决策依据
| 推荐匹配人群 | 首选建议方向 | 关键转型动作 |
|---|---|---|
| 计算机科班 / 具备扎实软件工程素养 | Web 后端开发 或 AI 应用工程 | 深入掌握 Linux 底层、Docker 编排、异步高并发架构与数据库性能调优,打造具有实际部署运行地址的生产级项目。 |
| 经管商科 / 数理统计 / 理工科非计算机专业 | 数据分析与商业智能 (BI) | 以 SQL 与业务逻辑为突破口,深入理解电商、金融、游戏等目标行业的北极星指标与归因模型,突出商业变现分析能力。 |
| 硕博学历 / 数理扎实且工程能力过硬 | AI 算法工程与 MLOps | 跳出单纯调用 API 的层次,攻坚高性能推理(vLLM/Triton)、垂直场景微调(LoRA/QLoRA)与自主智能体(Agent)状态机系统。 |
求职作品集的核心避坑建议
无论是哪个方向,在当前求职环境下,千篇一律的教学项目(如二手房爬虫、个人博客、简单聊天机器人)几乎无法获得面试机会。求职者应将精力集中在“工程完整性”与“指标可量化性”上:
- 后端项目:必须提供线上可访问的 Swagger/API 地址、附带 Docker-compose 一键启动脚本与高并发压力测试报告(如 Locust/JMeter 压测下的 QPS 与 P99 延迟数据)。
- 数据分析项目:避免只输出几张孤立的散点图,必须结合完整业务故事——从问题发现、漏斗流失定位,到提出具体的营销/产品优化策略,并量化该策略预期的业务收益。
- AI 工程项目:务必展示针对幻觉控制、检索精度评测(Hit Rate、MRR)、长文本截断优化以及低延迟流式吞吐所做的定量工程改进。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















