


Python主要用来做什么:Web开发、数据分析与人工智能应用解析
深入解析Python在Web服务端开发、数据分析与挖掘、以及人工智能三大核心领域的典型应用、技术栈选型、执行机制与性能边界。
一、Web开发:高并发API与现代服务端架构
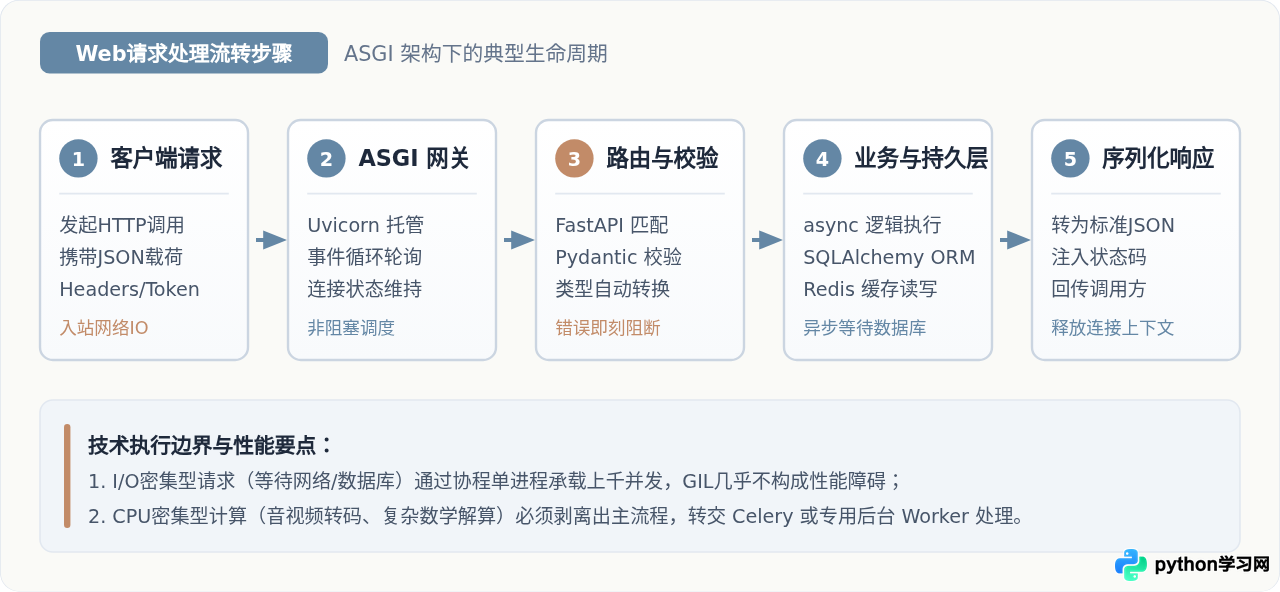
在Web开发领域,Python主要承担服务端接口(RESTful/GraphQL API)、业务中台系统以及异步微服务的构建。现代Web系统逐渐由传统的服务端HTML模版渲染(SSR)转向前后端分离架构,Python的核心阵地相应集中在高性能API构建与异步数据交换上。
1. 主流框架的工程定位与适用场景
Python拥有分工明确的Web框架矩阵。选型通常取决于团队对交付速度、系统规范性与并发吞吐量之间的权衡:
- FastAPI:基于现代Python类型提示(Type Hints)与ASGI标准,底层采用Starlette与Pydantic。它原生支持
async/await异步协程,具备接近Go语言的单节点网络吞吐表现,并能根据类型声明自动生成OpenAPI(Swagger)交互式文档,已成为目前构建微服务API的首选方案。 - Django:采用“开箱即用(Batteries Included)”设计哲学的全功能框架。内置生产级ORM、身份认证鉴权模块以及自动化后台管理界面(Django Admin),特别适合业务模型复杂、需要快速推进首个版本交付的企业管理后台或综合门户系统。
- Flask:极简的WSGI轻量级微框架。核心仅保留路由与请求分发,其余功能(ORM、表单验证、缓存)完全由开发者自由组装,适用于轻量级原型验证、无状态微服务以及工具类脚本的HTTP接口化。
2. 典型实践:构建规范的异步RESTful API
以下是一个使用FastAPI构建的设备数据上报接口示例,展示了入参类型校验、异步数据库/缓存挂起等待以及标准化响应生成的完整过程:
# 环境依赖:pip install fastapi uvicorn pydantic
from fastapi import FastAPI, HTTPException, status
from pydantic import BaseModel, Field
import asyncio
from typing import Optional

app = FastAPI(title="Sensor Telemetry Service")

# 定义严格的数据输入模型
class SensorData(BaseModel):
    device_id: str = Field(..., min_length=4, max_length=32, description="设备唯一编码")
    temperature: float = Field(..., ge=-40.0, le=85.0, description="摄氏度温度")
    humidity: float = Field(..., ge=0.0, le=100.0, description="相对湿度百分比")
    status_code: Optional[str] = "NORMAL"

# 异步端点:支持非阻塞高并发挂起
@app.post("/api/v1/telemetry", status_code=status.HTTP_201_CREATED)
async def ingest_telemetry(payload: SensorData):
    # 模拟异步写入数据库或消息队列(如 Redis / PostgreSQL)
    await asyncio.sleep(0.02)

    # 业务规则判定
    if payload.temperature > 65.0:
        alert_state = "WARNING_HIGH_TEMP"
    else:
        alert_state = "HEALTHY"

    return {
        "code": 200,
        "device_id": payload.device_id,
        "processed_state": alert_state,
        "recorded": True
}启动服务命令:uvicorn main:app --host 0.0.0.0 --port 8000 --workers 4
调用示例输出:{"code": 200, "device_id": "SN-98214", "processed_state": "HEALTHY", "recorded": true}
二、数据分析与处理:从数据清洗到商业度量
数据分析是Python应用最为成熟的领域之一。工程师与数据分析师主要利用Python进行自动化数据抽取(ETL)、脏数据清洗转换、探索性数据分析(EDA)、统计建模与指标可视化输出。
1. 核心工具链的职责分工
Python之所以取代传统电子表格与部分专有统计软件,是因为其围绕表格数据构建了环环相扣的高效工具链:
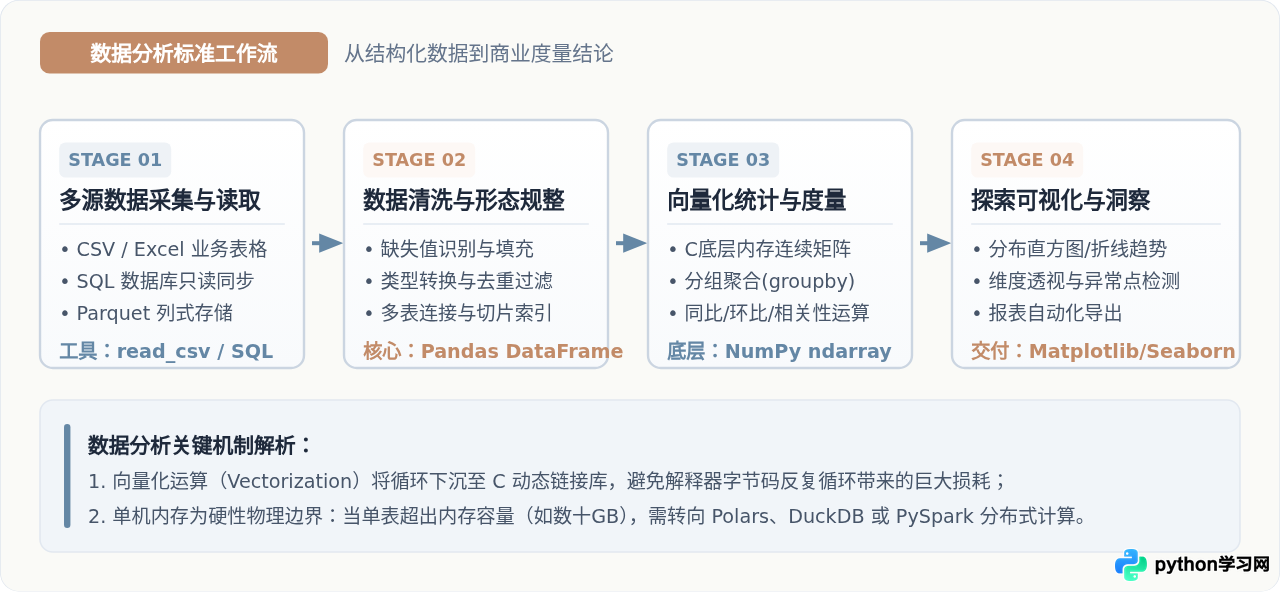
- Pandas:提供以
DataFrame为核心的二维表格数据结构。内置强大的缺失值处理、类型映射、时间序列解析、多表连接(Merge/Join)与分组聚合(Groupby)算子,是处理单机结构化数据的工业标准。 - NumPy:作为整个科学计算体系的基础基石。提供由C语言编写的连续内存多维数组(
ndarray),支持广播机制与高度优化的线性代数矩阵运算。Pandas的底层底层内存即构建在NumPy之上。 - Matplotlib & Seaborn:专业统计制图库。Matplotlib提供高度可定制的底层绘图API,Seaborn在其基础上封装了面向统计分布、分类对比与相关性热力图的高级接口。
2. 典型实践:电商订单数据的聚合统计与清洗
以下代码展示了从载入原始数据、处理异常缺失记录,到按类别进行销售总额与客单价聚合计算的标准操作步骤:
# 环境依赖:pip install pandas numpy
import pandas as pd
import numpy as np

# 1. 模拟构建含有缺失与异常的原始业务数据
raw_records = {
    "order_id": ["A101", "A102", "A103", "A104", "A105", "A106"],
    "category": ["Electronics", "Books", "Electronics", "Home", "Books", np.nan],
    "sales_amount": [1299.0, np.nan, 3499.0, 189.5, 45.0, 890.0],
    "quantity": [1, 2, 3, 1, 1, 2]
}
df = pd.DataFrame(raw_records)

# 2. 数据清洗:剔除品类缺失记录,填充数值字段中位数
cleaned_df = df.dropna(subset=["category"]).copy()
median_sales = cleaned_df["sales_amount"].median()
cleaned_df["sales_amount"] = cleaned_df["sales_amount"].fillna(median_sales)

# 3. 向量化计算每单平均单价,并进行分组汇总指标统计
cleaned_df["unit_price"] = cleaned_df["sales_amount"] / cleaned_df["quantity"]

summary_metrics = cleaned_df.groupby("category").agg(
    total_sales=pd.NamedAgg(column="sales_amount", aggfunc="sum"),
    total_items=pd.NamedAgg(column="quantity", aggfunc="sum"),
    avg_unit_price=pd.NamedAgg(column="unit_price", aggfunc="mean")
).reset_index()

# 保留两位小数
summary_metrics["total_sales"] = summary_metrics["total_sales"].round(2)
summary_metrics["avg_unit_price"] = summary_metrics["avg_unit_price"].round(2)

print(summary_metrics.to_string(index=False))category total_sales total_items avg_unit_price
Books 234.5 3 69.88
Electronics 4798.0 4 1233.00
Home 189.5 1 189.50
for循环遍历行,优先采用向量化操作;对于超大规模数据,需平滑迁移至列式计算引擎(如Polars、DuckDB)或分布式大数据计算框架(如PySpark)。
三、人工智能与机器学习:算法研发与模型服务化
在人工智能领域,Python是全球公认的“核心控制语言”。无论是经典的统计机器学习(分类、回归、聚类),还是前沿的计算机视觉(CV)、大语言模型(LLM)与智能体(AI Agent),算法的研究、训练与推理生态均以Python为主接口。
1. 为什么Python在AI领域具备不可替代性?
这并非因为Python运行速度快,而是因为其优雅的胶水特性:
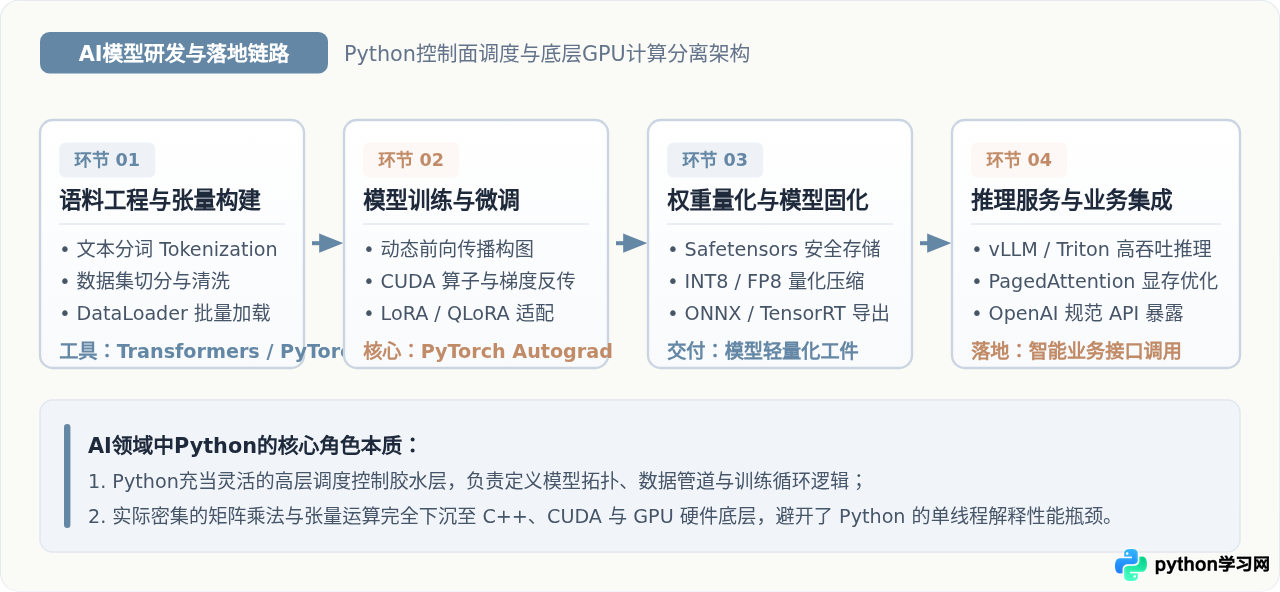
- 算力与控制分离:研究人员在Python层编写清晰的模型网络结构定义、训练超参数循环与损失函数;当调用前向传播计算时,底层实际上是由C++、CUDA及GPU硬件芯片内的张量核心(Tensor Cores)在全速运算。
- 顶级研究机构的生态沉淀:绝大多数前沿学术论文、开源预训练基座模型(如Llama、Mistral、DeepSeek)首发均以Python代码与PyTorch权重格式发布,形成了极强的网络外部性。
2. 核心框架与技术栈结构
当前主流的人工智能开发工具链主要分为三个层级:
- 经典机器学习层(Scikit-learn):专注于支持向量机(SVM)、随机森林(Random Forest)、梯度提升树(GBDT/XGBoost)及降维特征工程,适用于传统表格业务预测。
- 深度学习计算引擎(PyTorch):以动态计算图(Dynamic Graph)、张量自动求导(Autograd)为核心,全面支撑了现代神经网络的研究与训练。
- 预训练模型与工程交付层(Transformers / vLLM):Hugging Face的Transformers库统一了现代模型分词与微调标准;而在生产推理侧,则依赖vLLM、Triton等高性能推理服务实现高并发Token生成。
3. 典型实践:基于PyTorch构建简易张量回归流水线
以下代码演示了定义神经网络层、执行前向传播并计算梯度的最小可运行闭环:
# 环境依赖:pip install torch
import torch
import torch.nn as nn

# 检查硬件加速可用性
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")

# 定义前馈线性回归网络
class SimplePredictor(nn.Module):
    def __init__(self, input_dim: int, hidden_dim: int, output_dim: int):
        super(SimplePredictor, self).__init__()
        self.fc1 = nn.Linear(input_dim, hidden_dim)
        self.relu = nn.ReLU()
        self.fc2 = nn.Linear(hidden_dim, output_dim)

    def forward(self, x):
        out = self.fc1(x)
        out = self.relu(out)
        out = self.fc2(out)
        return out

# 实例化模型并挂载至计算设备
model = SimplePredictor(input_dim=4, hidden_dim=8, output_dim=1).to(device)
criterion = nn.MSELoss()
optimizer = torch.optim.SGD(model.parameters(), lr=0.01)

# 生成模拟特征张量 (批次大小 2, 4维特征)
inputs = torch.randn(2, 4).to(device)
labels = torch.tensor([[1.5], [3.2]]).to(device)

# 执行一次完整的前向传播与反向求导
optimizer.zero_grad()
outputs = model(inputs)
loss = criterion(outputs, labels)
loss.backward()
optimizer.step()

print(f"执行设备: {device}")
print(f"当前批次损失值: {loss.item():.4f}")执行输出:执行设备: cpu (若安装CUDA则为cuda:0)
当前批次损失值:当前批次损失值: 1.4821
四、三大领域综合对比与技术选型指南
明确Python的适用边界对于技术选型至关重要。虽然Python在三个领域都表现优异,但其面临的技术瓶颈与应对策略各有不同。下表从计算负载、典型工具与选型约束三个维度进行横向对比:
| 应用领域 | 主要工具栈 | 负载核心特征 | 主要瓶颈 | 推荐应对策略 |
|---|---|---|---|---|
| Web 服务端开发 | FastAPI, Django, SQLAlchemy | I/O 密集型(网络与存储等待) | 单进程多线程受GIL制约,CPU密集运算慢 | 采用ASGI异步协程并发,重度计算剥离至Celery异步队列 |
| 数据分析与挖掘 | Pandas, NumPy, Matplotlib | 内存驻留型(矩阵与表格计算) | 单机物理内存上限,for循环低效 | 优先使用底层C向量化算子;超大文件采用Polars或DuckDB |
| 人工智能与算法 | PyTorch, Hugging Face, vLLM | 计算密集型(超大规模张量相乘) | 纯Python解释器性能极低 | Python仅做控制面,计算全量下沉至CUDA/GPU算子与ONNX推理引擎 |
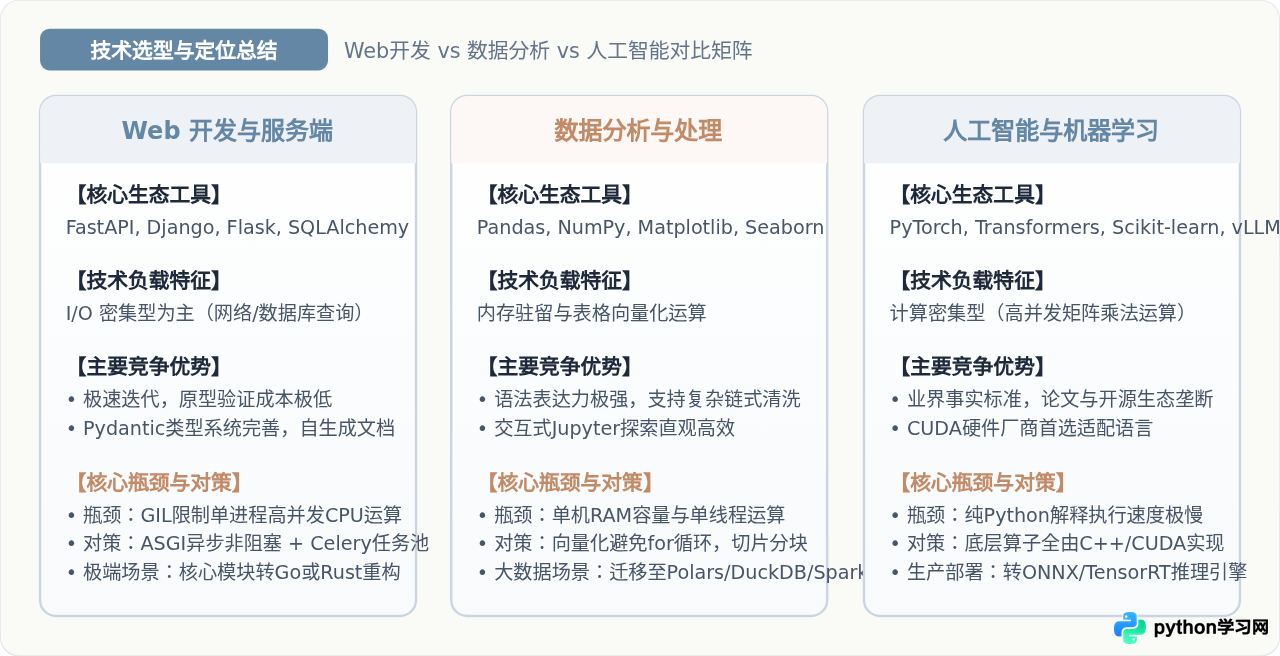
总结与选型判断
回答“Python主要用来做什么”这一问题,本质是看技术需求与Python语言特性的匹配度:
- 如果你的核心需求是业务快速上线、构建高规范RESTful/微服务API:选择以
FastAPI或Django为核心的Web技术路线; - 如果你的核心需求是处理表格业务数据、指标拆解、报表生成与归因分析:选择以
Pandas与NumPy为核心的数据分析技术路线; - 如果你的核心需求是训练算法模型、微调大语言模型或搭建AI智能体系统:选择以
PyTorch与Transformers为核心的人工智能工程路线。
在实际现代工业级项目中,这三大应用往往协同运转:通过Web服务(FastAPI)承接用户请求,调用后台AI推理引擎(PyTorch/vLLM)生成决策,并由数据分析模块(Pandas/DuckDB)沉淀度量业务指标。理解各领域的底层实现机制与性能边界,才能在工程实践中充分发挥Python的最大效能。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















