


Python小型实战项目源码:命令行工具与简易Web应用构建
深入剖析Python小型实战项目源码构建过程,涵盖基于argparse的文本统计命令行工具与基于Flask+SQLite的轻量级Web数据看板应用,提供完整可运行源码、设计原理与工程避坑实践。
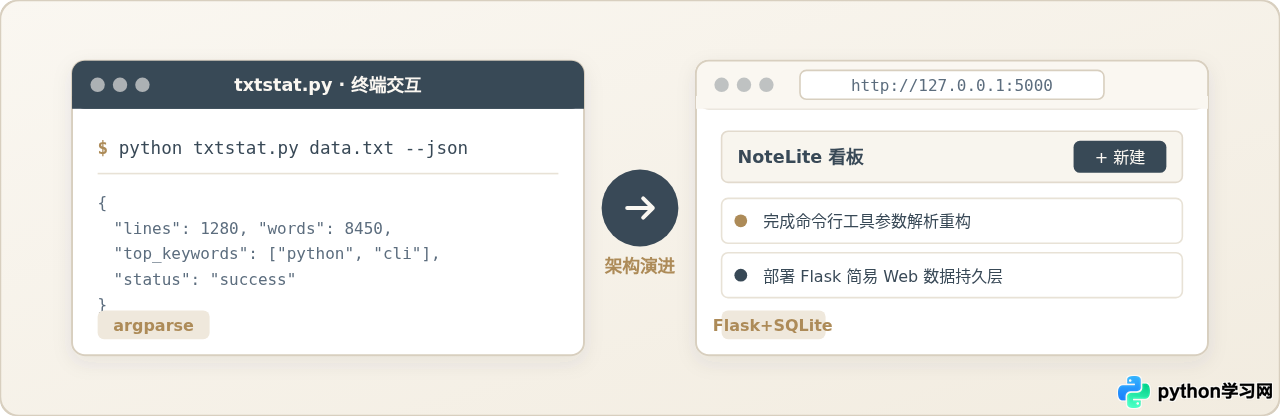
一、实战项目一:基于 argparse 的文本统计命令行工具
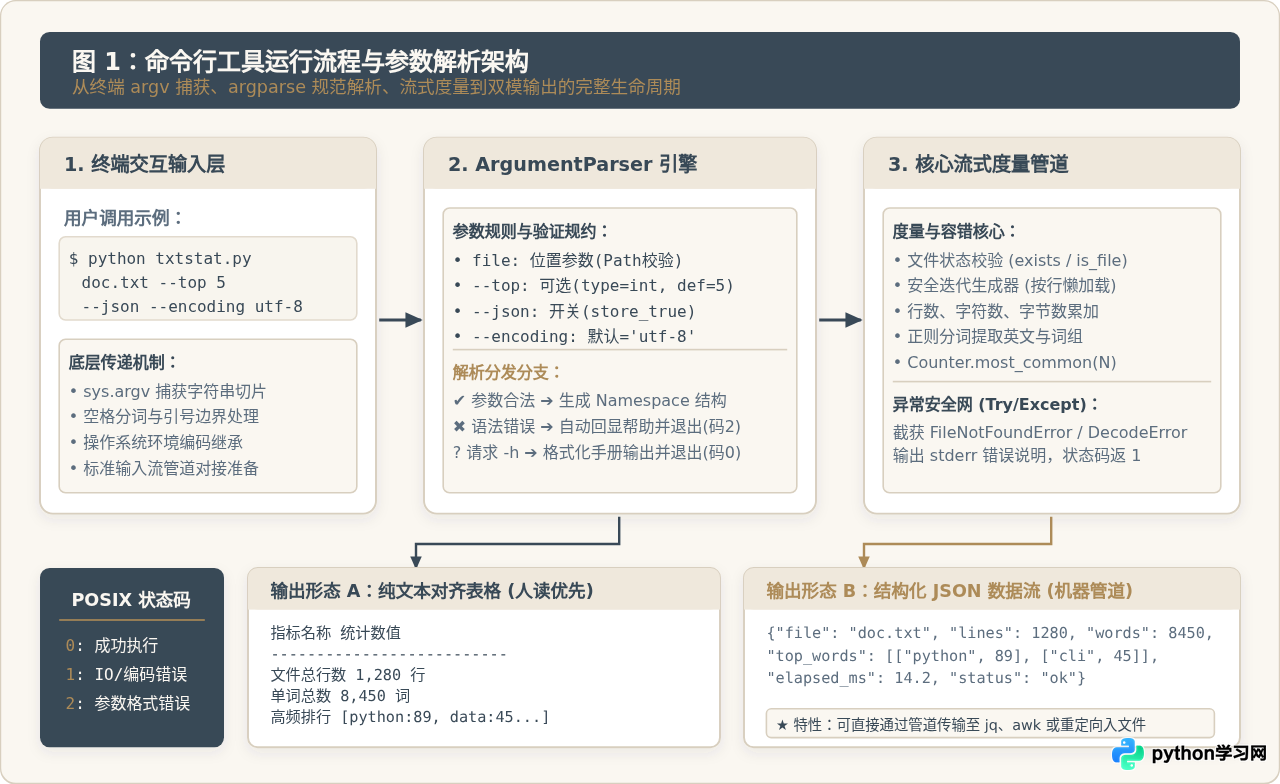
命令行工具是自动化运维、数据管线与开发辅助的核心载体。构建一个健壮的 CLI 工具,不能仅仅停留在使用 input() 交互,而必须接入操作系统级的标准输入输出协议、实现严格的命令行参数解析、提供标准帮助手册,并向操作系统回传符合 POSIX 规范的进程退出状态码。
1.1 需求定位与架构设计
本工具命名为 txtstat,定位为轻量级文本分析与度量工具。其功能规约如下:
- 核心计算指标:统计指定文件的总物理行数、单词总数、字符总数以及磁盘字节占用大小。
- 高频词统计算法:通过
--top N参数,基于词频分析提取排名前 N 的高频单词。 - 双模输出适配:默认以对齐格式的人类可读表格呈现;当指定
--json标志位时,输出标准 JSON 文本流,便于下游工具(如jq)通过管道处理或重定向至文件。 - 容错与标准返回:规范拦截文件不存在、字符集编码错误与读取权限异常,错误信息一律写入标准错误流
sys.stderr,并向调用方返回明确的非零退出码。
1.2 完整源码实现(txtstat.py)
以下为工具的完整源代码,基于 Python 标准库构建,无任何第三方包依赖,开箱即用:
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""
txtstat.py - 轻量级文本统计与词频分析命令行工具
包含行数、词数、字符量统计、高频词分析及 JSON 格式化输出功能。
"""

import argparse
import collections
import json
import os
import pathlib
import re
import sys
import time
from typing import Dict, Any, List, Tuple


def analyze_text_stream(file_path: pathlib.Path, top_n: int = 5, encoding: str = 'utf-8') -> Dict[str, Any]:
    """
    流式读取并分析指定文件,返回结构化统计字典。

    :param file_path: 目标文件的 Path 对象
    :param top_n: 提取高频词的数量
    :param encoding: 文本读取编码,默认为 utf-8
    :return: 包含各项统计指标的字典
    """
    start_time = time.perf_counter()
    file_stat = file_path.stat()
    file_bytes = file_stat.st_size

    line_count = 0
    char_count = 0
    word_counter = collections.Counter()

    # 编译单词提取正则:支持英文字词与下划线,忽略标点符号干扰
    word_pattern = re.compile(r'\b[a-zA-Z0-9_\u4e00-\u9fa5]+\b')

    with file_path.open('r', encoding=encoding, errors='strict') as fp:
        for line in fp:
            line_count += 1
            char_count += len(line)
            tokens = word_pattern.findall(line)
            for token in tokens:
                # 统一转为小写收敛频次
                word_counter[token.lower()] += 1

    total_words = sum(word_counter.values())
    top_keywords: List[Tuple[str, int]] = word_counter.most_common(top_n)
    elapsed_ms = round((time.perf_counter() - start_time) * 1000, 2)

    return {
        "file_name": file_path.name,
        "file_path": str(file_path.resolve()),
        "file_bytes": file_bytes,
        "line_count": line_count,
        "word_count": total_words,
        "char_count": char_count,
        "top_n_requested": top_n,
        "top_words": top_keywords,
        "elapsed_ms": elapsed_ms
    }


def format_text_table(stats: Dict[str, Any]) -> str:
    """
    将分析结果格式化为对齐的人类可读终端表格。
    """
    separator = "-" * 56
    lines = [
        separator,
        f" 文本统计报告: {stats['file_name']}",
        separator,
        f" 绝对路径   : {stats['file_path']}",
        f" 文件大小   : {stats['file_bytes']:,} 字节",
        f" 物理总行数 : {stats['line_count']:,} 行",
        f" 词汇总数   : {stats['word_count']:,} 个",
        f" 字符总数   : {stats['char_count']:,} 个 (含换行与空格)",
        f" 分析耗时   : {stats['elapsed_ms']} 毫秒",
        separator,
        f" 高频词汇 TOP {stats['top_n_requested']} 统计:"
    ]

    if not stats['top_words']:
        lines.append("   (未检测到有效单词词汇)")
    else:
        for rank, (word, count) in enumerate(stats['top_words'], 1):
            ratio = (count / stats['word_count'] * 100) if stats['word_count'] > 0 else 0
            lines.append(f"   [{rank:02d}] {word:<18} : {count:>6} 次 (占比 {ratio:5.2f}%)")

    lines.append(separator)
    return "\n".join(lines)


def build_parser() -> argparse.ArgumentParser:
    """
    配置并返回标准命令行参数解析器。
    """
    parser = argparse.ArgumentParser(
        prog="txtstat",
        description="专业级文本结构度量与高频词统计命令行工具。",
        epilog="示例: python3 txtstat.py sample.txt --top 10 --json"
    )

    # 必选位置参数
    parser.add_argument(
        "target_file",
        metavar="FILE",
        type=str,
        help="待统计的目标文本文件路径"
    )

    # 可选配置参数
    parser.add_argument(
        "-t", "--top",
        dest="top_n",
        type=int,
        default=5,
        help="指定输出高频词的条目数量(默认前 5 项)"
    )

    parser.add_argument(
        "-e", "--encoding",
        dest="encoding",
        type=str,
        default="utf-8",
        help="读取文本时使用的字符编码(默认: utf-8)"
    )

    # 格式化开关
    parser.add_argument(
        "--json",
        dest="output_json",
        action="store_true",
        help="指定以标准 JSON 结构化流输出结果,便于管道流转"
    )

    return parser


def main() -> int:
    """
    主程序调度入口,负责参数调度与异常边界防御。
    :return: POSIX 退出码 (0 表示成功, 1 表示业务与IO故障, 2 表示参数语法错误)
    """
    parser = build_parser()
    args = parser.parse_args()

    target_path = pathlib.Path(args.target_file)

    # 1. 前置状态校验
    if not target_path.exists():
        sys.stderr.write(f"[错误] 目标文件不存在: {args.target_file}\n")
        return 1

    if not target_path.is_file():
        sys.stderr.write(f"[错误] 目标路径不是一个普通文件: {args.target_file}\n")
        return 1

    if args.top_n <= 0:
        sys.stderr.write(f"[错误] --top 参数必须为正整数,当前输入: {args.top_n}\n")
        return 1

    # 2. 执行核心运算
    try:
        stats = analyze_text_stream(
            file_path=target_path,
            top_n=args.top_n,
            encoding=args.encoding
        )
    except UnicodeDecodeError as err:
        sys.stderr.write(f"[编码错误] 无法使用 '{args.encoding}' 解码文件 (偏移位: {err.start})。请通过 -e 指定编码。\n")
        return 1
    except PermissionError:
        sys.stderr.write(f"[权限错误] 当前运行环境无权读取该文件: {args.target_file}\n")
        return 1
    except Exception as err:
        sys.stderr.write(f"[运行时异常] 发生未预期错误: {str(err)}\n")
        return 1

    # 3. 输出格式化分发
    if args.output_json:
        # 结构化输出到 stdout
        sys.stdout.write(json.dumps(stats, ensure_ascii=False, indent=2) + "\n")
    else:
        # 纯文本表格输出到 stdout
        sys.stdout.write(format_text_table(stats) + "\n")

    return 0


if __name__ == "__main__":
    sys.exit(main())
1.3 核心技术点剖析
优秀的命令行工具源码应体现清晰的分层思想:
- 解耦核心算法与交互外壳:
analyze_text_stream函数作为核心计算模块,仅接收Path与基本类型参数,返回基础字典。它既可以被终端主入口调用,也能直接被其他 Python 脚本作为库模块导入,实现业务逻辑的高内聚。 - 流式迭代规避内存爆炸:在处理 GB 级别的文本大文件时,严禁使用
fp.read()或fp.readlines()将全量内容一次性载入内存。本源码采用for line in fp:生成器迭代,使得内存开销始终稳定在单行文本级别。 - 标准错误流与标准输出流分离:所有报错诊断信息均通过
sys.stderr.write()吐出,成功的结果才写入sys.stdout。这种设计保证了下游工具执行python3 txtstat.py test.txt --json | jq .时,不会因为偶发的警告字符串破坏 JSON 解析。
1.4 操作步骤与执行验证
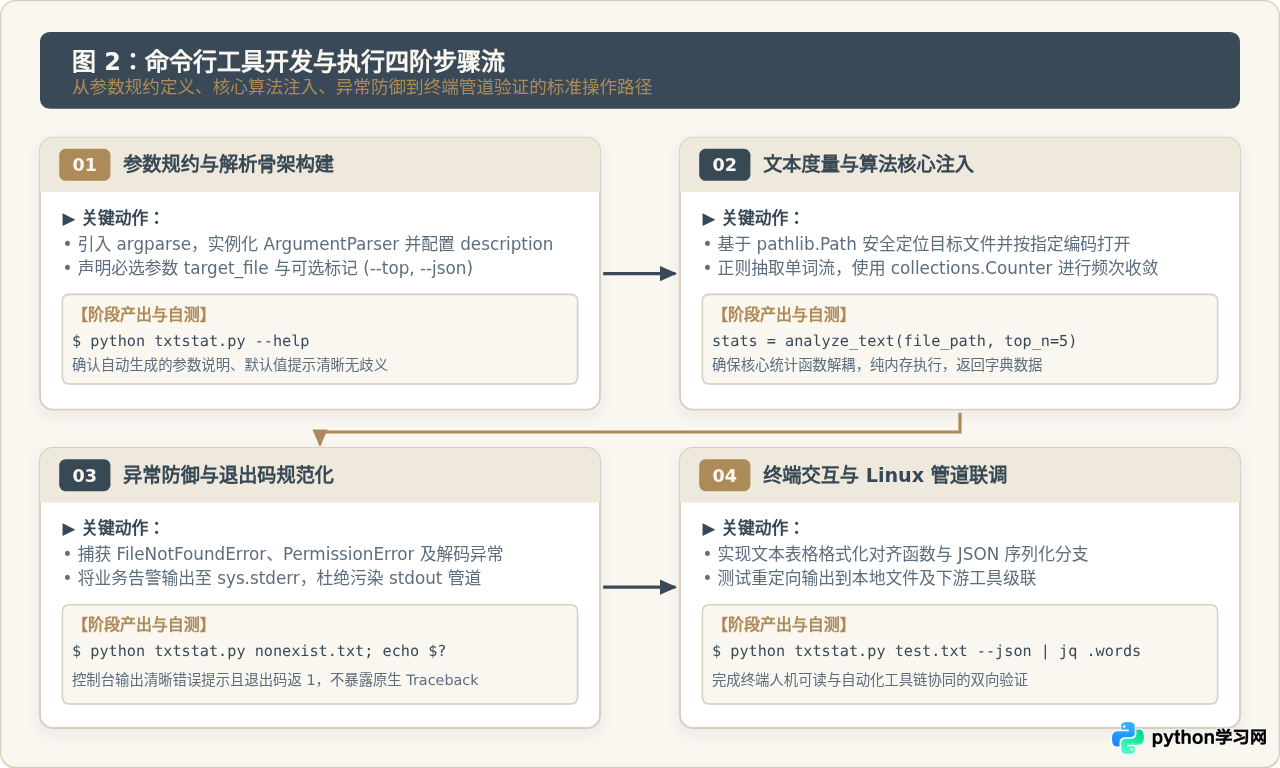
为了验证工具在不同场景下的表现,先创建一个名为 sample.txt 的示例测试文本:
Python is an easy to learn, powerful programming language.
Python has efficient high-level data structures and a simple approach.
Python syntax and dynamic typing make it an ideal language for scripting.
验证场景 A:默认表格输出
# 执行命令
python3 txtstat.py sample.txt --top 3
示例输出如下:
--------------------------------------------------------
 文本统计报告: sample.txt
--------------------------------------------------------
 绝对路径   : /workspace/sample.txt
 文件大小   : 207 字节
 物理总行数 : 3 行
 词汇总数   : 28 个
 字符总数   : 207 个 (含换行与空格)
 分析耗时   : 0.32 毫秒
--------------------------------------------------------
 高频词汇 TOP 3 统计:
   [01] python             :      3 次 (占比 10.71%)
   [02] an                 :      2 次 (占比  7.14%)
   [03] language           :      2 次 (占比  7.14%)
--------------------------------------------------------
验证场景 B:JSON 管道流与下游过滤
# 执行命令
python3 txtstat.py sample.txt --top 2 --json
示例输出如下:
{
  "file_name": "sample.txt",
  "file_path": "/workspace/sample.txt",
  "file_bytes": 207,
  "line_count": 3,
  "word_count": 28,
  "char_count": 207,
  "top_n_requested": 2,
  "top_words": [
    ["python", 3],
    ["an", 2]
  ],
  "elapsed_ms": 0.28
}
验证场景 C:异常防御与状态码检验
# 传入不存在的文件并打印状态码
python3 txtstat.py not_found.txt; echo "退出状态码: $?"
控制台将输出 [错误] 目标文件不存在: not_found.txt,紧随其后的 退出状态码: 1 证明程序已按照规约受控退出,未倾泻堆栈跟踪日志。这对于自动化脚本监控极其关键。
二、实战项目二:基于 Flask 与 SQLite 的轻量 Web 应用构建
当数据需要面向多人协作、提供可视化看板或支持远程客户端交互时,Web 服务是标准的解决方案。构建小型 Web 项目时,常见痛点是模板多层嵌套、静态资源缺失导致初次启动受挫。本项目 NoteLite 采用极简单文件闭环架构,集成嵌入式 SQLite 数据库与内联响应视图,展示 Web 请求处理的核心全流程。
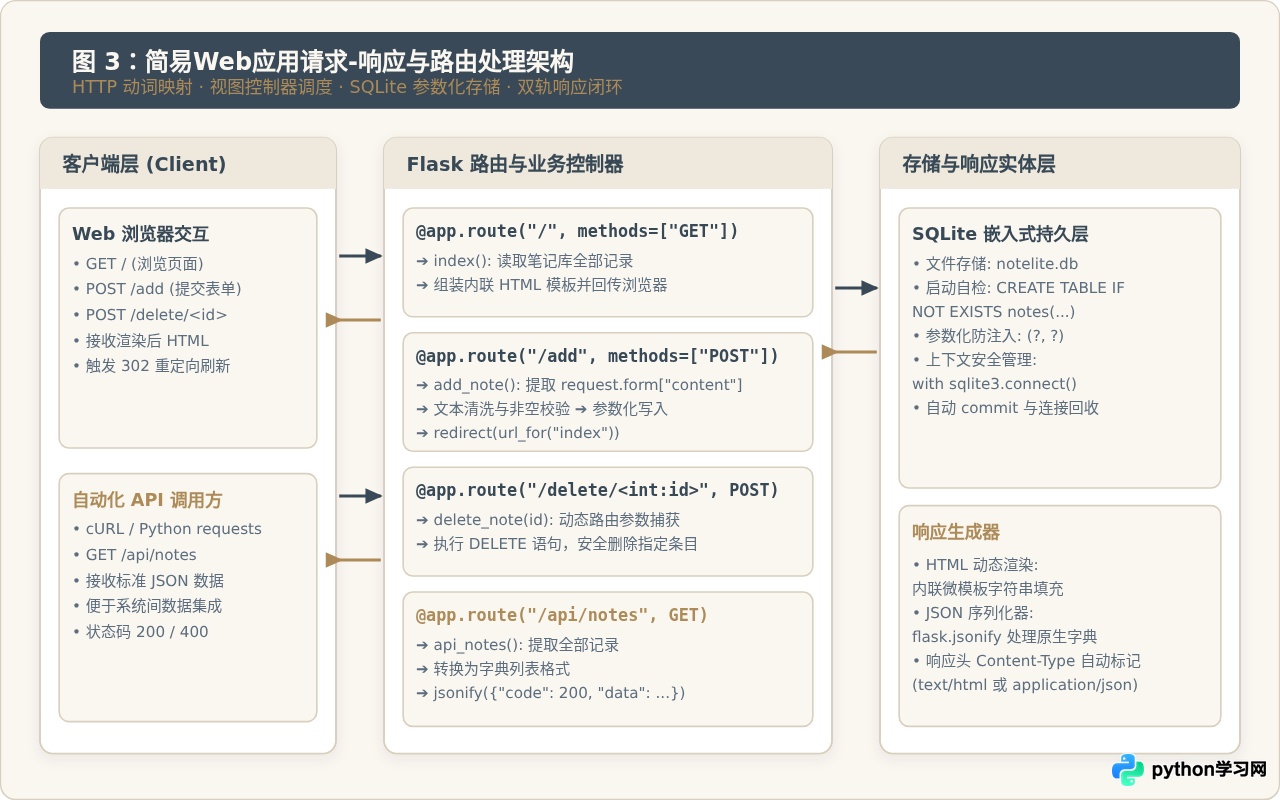
2.1 需求定位与架构设计
NoteLite 是一个即开即用的随手记事与工作清单 Web 节点:
- 数据持久层:应用首次启动时,自动在本地检测并创建
notelite.db数据库文件及notes数据表,保证环境零初始化门槛。 - 界面展现(GET /):使用内置内联 HTML/CSS 渲染现代响应式卡片视图,展示当前记录列表、记录创建时间及新建输入框。
- 数据添加(POST /add):接收并解析浏览器表单提交内容,完成空白清洗校验,采用参数化 SQL 插入记录,并通过
302 Found重定向刷新页面,防止用户重复刷新导致的表单重复提交(PRG 模式)。 - 数据物理删除(POST /delete/<int:note_id>):支持基于动态 URI 路径变量定位记录并安全移除。
- 开放式 API(GET /api/notes):提供标准的 JSON 数据查询端点,支持与移动端、前端 SPA 或外部脚本进行数据对接。
2.2 完整源码实现(notelite.py)
以下为完整的单文件 Web 应用源码。依赖轻量级框架 Flask,内置 SQLite 数据库支持:
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""
notelite.py - 极简轻量级备忘与任务看板 Web 应用
单文件内含 SQLite 数据库自初始化、表单路由、动态页面渲染与 RESTful API。
"""

import os
import sqlite3
import sys
from datetime import datetime
from typing import List, Dict, Any
from flask import Flask, request, redirect, url_for, jsonify, render_template_string, Response

app = Flask(__name__)
DATABASE_FILE = "notelite.db"

# 内联 HTML/CSS 响应模板,保证单文件可独立运行,无需多级文件夹准备
PAGE_TEMPLATE = """
<!DOCTYPE html>
<html lang="zh-CN">
<head>
  <meta charset="UTF-8">
  <meta name="viewport" content="width=device-width, initial-scale=1.0">
  <title>NoteLite - 随手记事看板</title>
  <style>
    * { box-sizing: border-box; margin: 0; padding: 0; }
    body {
      background-color: #FAF7F1;
      font-family: -apple-system, BlinkMacSystemFont, "Segoe UI", Roboto, "PingFang SC", sans-serif;
      color: #394957;
      padding: 30px 15px;
    }
    .wrapper {
      max-width: 680px;
      margin: 0 auto;
      background: #FFFFFF;
      padding: 30px;
      border-radius: 10px;
      box-shadow: 0 4px 16px rgba(57, 73, 87, 0.08);
      border: 1px solid #E2DACD;
    }
    .header {
      display: flex;
      justify-content: space-between;
      align-items: center;
      border-bottom: 2px solid #AD8B58;
      padding-bottom: 12px;
      margin-bottom: 24px;
    }
    .header h1 { font-size: 22px; font-weight: 700; color: #394957; }
    .header .tag { font-size: 12px; color: #AD8B58; font-weight: bold; }
    .add-form { display: flex; gap: 10px; margin-bottom: 25px; }
    .add-form input[type="text"] {
      flex: 1;
      padding: 10px 14px;
      border: 1px solid #D8CFBF;
      border-radius: 6px;
      font-size: 14px;
      outline: none;
    }
    .add-form input[type="text"]:focus { border-color: #AD8B58; }
    .btn-submit {
      background-color: #394957;
      color: #FAF7F1;
      border: none;
      padding: 10px 20px;
      border-radius: 6px;
      cursor: pointer;
      font-size: 14px;
      font-weight: 600;
    }
    .btn-submit:hover { background-color: #27333E; }
    .note-list { list-style: none; }
    .note-item {
      display: flex;
      justify-content: space-between;
      align-items: center;
      padding: 14px 16px;
      border-bottom: 1px solid #EFE8DC;
      transition: background 0.2s;
    }
    .note-item:hover { background-color: #FAF7F1; }
    .note-content { font-size: 14.5px; color: #394957; word-break: break-all; }
    .note-meta { font-size: 12px; color: #8C9BA5; margin-top: 4px; }
    .btn-delete {
      background: none;
      border: 1px solid #D9534F;
      color: #D9534F;
      padding: 4px 10px;
      border-radius: 4px;
      cursor: pointer;
      font-size: 12px;
    }
    .btn-delete:hover { background: #D9534F; color: #FFFFFF; }
    .empty-state { text-align: center; padding: 40px 0; color: #8C9BA5; font-size: 14px; }
    .footer-api { margin-top: 25px; font-size: 12px; color: #8C9BA5; text-align: right; }
    .footer-api a { color: #AD8B58; text-decoration: none; }
  </style>
</head>
<body>
  <div class="wrapper">
    <div class="header">
      <h1>NoteLite 随手记事</h1>
      <span class="tag">共 {{ notes|length }} 条记录</span>
    </div>

    <form class="add-form" action="{{ url_for('add_note') }}" method="POST">
      <input type="text" name="content" placeholder="输入待办项或备忘内容..." required autocomplete="off">
      <button type="submit" class="btn-submit">添加</button>
    </form>

    {% if notes %}
      <ul class="note-list">
        {% for note in notes %}
          <li class="note-item">
            <div>
              <div class="note-content">{{ note['content'] }}</div>
              <div class="note-meta">记录于 {{ note['created_at'] }}</div>
            </div>
            <form action="{{ url_for('delete_note', note_id=note['id']) }}" method="POST">
              <button type="submit" class="btn-delete" onclick="return confirm('确认删除本条记录?')">删除</button>
            </form>
          </li>
        {% endfor %}
      </ul>
    {% else %}
      <div class="empty-state">暂无记录,在上方输入内容创建第一条备忘吧。</div>
    {% endif %}

    <div class="footer-api">
      开放数据端点: <a href="{{ url_for('api_get_notes') }}" target="_blank">GET /api/notes</a>
    </div>
  </div>
</body>
</html>
"""


def init_database():
    """
    自检并初始化 SQLite 数据库文件与数据表结构。
    """
    with sqlite3.connect(DATABASE_FILE) as conn:
        cursor = conn.cursor()
        cursor.execute("""
            CREATE TABLE IF NOT EXISTS notes (
                id INTEGER PRIMARY KEY AUTOINCREMENT,
                content TEXT NOT NULL,
                created_at DATETIME NOT NULL DEFAULT CURRENT_TIMESTAMP
            )
        """)
        conn.commit()


def get_db_connection() -> sqlite3.Connection:
    """
    获取配置有行字典映射的数据库连接上下文。
    """
    conn = sqlite3.connect(DATABASE_FILE)
    conn.row_factory = sqlite3.Row
    return conn


@app.route("/", methods=["GET"])
def index() -> str:
    """
    主页路由:读取全部笔记列表并渲染内联 HTML 视图。
    """
    with get_db_connection() as conn:
        cursor = conn.cursor()
        cursor.execute("SELECT id, content, created_at FROM notes ORDER BY id DESC")
        rows = cursor.fetchall()

    notes_data = [
        {
            "id": row["id"],
            "content": row["content"],
            "created_at": row["created_at"]
        }
        for row in rows
    ]
    return render_template_string(PAGE_TEMPLATE, notes=notes_data)


@app.route("/add", methods=["POST"])
def add_note() -> Response:
    """
    表单接收接口:处理新备忘插入,执行校验,完成后重定向。
    """
    raw_content = request.form.get("content", "").strip()

    # 严格校验:防范空字符提交
    if not raw_content:
        return redirect(url_for("index"))

    with get_db_connection() as conn:
        cursor = conn.cursor()
        # 参数化 SQL 查询,防范 SQL 注入攻击
        cursor.execute(
            "INSERT INTO notes (content, created_at) VALUES (?, datetime('now', 'localtime'))",
            (raw_content,)
        )
        conn.commit()

    # PRG 设计模式:重定向刷新,防止页面刷新重复提交
    return redirect(url_for("index"))


@app.route("/delete/", methods=["POST"])
def delete_note(note_id: int) -> Response:
    """
    删除记录接口:根据动态路径参数 note_id 物理剔除数据。
    """
    with get_db_connection() as conn:
        cursor = conn.cursor()
        cursor.execute("DELETE FROM notes WHERE id = ?", (note_id,))
        conn.commit()

    return redirect(url_for("index"))


@app.route("/api/notes", methods=["GET"])
def api_get_notes() -> Response:
    """
    RESTful 开放数据接口:回传全部备忘的 JSON 格式数据。
    """
    with get_db_connection() as conn:
        cursor = conn.cursor()
        cursor.execute("SELECT id, content, created_at FROM notes ORDER BY id DESC")
        rows = cursor.fetchall()

    results = [
        {
            "id": row["id"],
            "content": row["content"],
            "created_at": row["created_at"]
        }
        for row in rows
    ]

    return jsonify({
        "status": "success",
        "total": len(results),
        "data": results
    })


if __name__ == "__main__":
    init_database()
    print("[NoteLite] 本地数据库已就绪,正在启动 Web 服务...")
    print("[NoteLite] 请在浏览器中访问: http://127.0.0.1:5000")
    # 监听本地环回地址 5000 端口
    app.run(host="127.0.0.1", port=5000, debug=False)
2.3 核心技术点剖析
- 连接上下文生命周期管理:Web 应用是长生命周期的网络常驻进程。在
get_db_connection()中使用with sqlite3.connect(...) as conn:确保每个 HTTP 请求所申请的数据库文件描述符在代码块退出后立即被安全释放,防止多请求并发下产生连接句柄泄露。 - 参数化防御 SQL 注入:在执行
INSERT与DELETE时,严格使用 SQL 占位符?传参(如cursor.execute("DELETE FROM notes WHERE id = ?", (note_id,))),杜绝使用 Python 原生 f-string 拼接用户输入,从根源掐死 SQL 注入漏洞。 - PRG(Post/Redirect/Get)设计模式:在表单提交的
/add路由最后,不直接向浏览器回显 HTML,而是向客户端下发302 Redirect重定向至GET /。这样用户在浏览器端反复按 F5 刷新时,只会重复请求只读的 GET 路由,不会导致重复插入相同的脏数据。
2.4 部署运行与接口调试
第一步:安装依赖并启动服务
# 安装轻量框架 Flask(系统未内置时执行)
pip3 install flask

# 启动 NoteLite 应用
python3 notelite.py
控制台将输出服务就绪日志:
[NoteLite] 本地数据库已就绪,正在启动 Web 服务...
[NoteLite] 请在浏览器中访问: http://127.0.0.1:5000
 * Serving Flask app 'notelite'
 * Debug mode: off
 * Running on http://127.0.0.1:5000 (Press CTRL+C to quit)
第二步:浏览器交互体验
打开浏览器访问 http://127.0.0.1:5000,在输入框中提交一条“梳理命令行参数设计规范”并点击添加,列表将即时呈现新增的条目及系统时间;点击右侧“删除”按钮,通过弹窗二次确认后该条目被物理移除。
第三步:API 端点验证
另起一个终端窗口,通过 curl 模拟第三方客户端调用内部 JSON 数据接口:
# 请求 API 端点
curl -s http://127.0.0.1:5000/api/notes
示例返回如下:
{
  "data": [
    {
      "content": "梳理命令行参数设计规范",
      "created_at": "2026-11-01 05:20:18",
      "id": 1
    }
  ],
  "status": "success",
  "total": 1
}
三、从 CLI 工具到 Web 服务的架构演进与模式对比
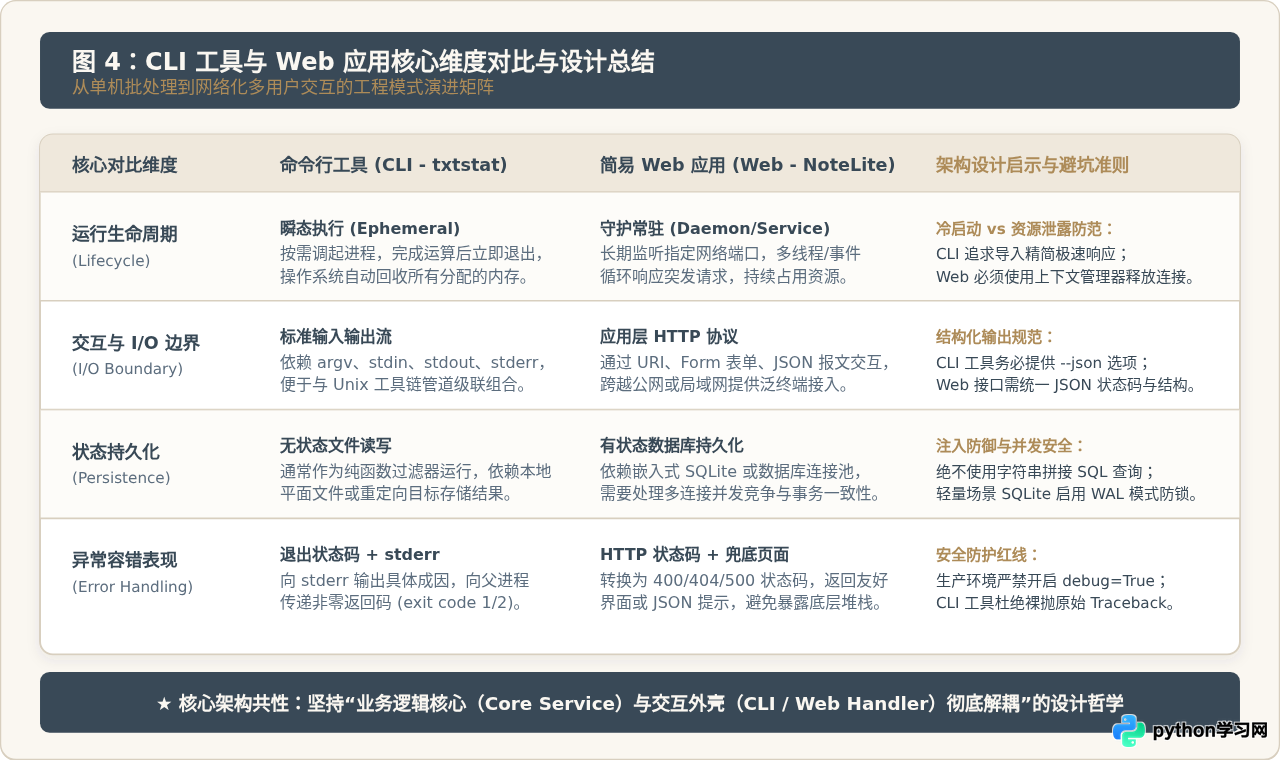
命令行工具与 Web 服务是 Python 生态中两种最常见的系统交互形态。许多初学者容易将它们割裂看待,但在成熟的工程实践中,二者往往只是针对不同交互媒介封装的“外壳(Adapter)”,其底层的“业务核心(Core Domain)”应当是完全通用且解耦的。
3.1 核心设计差异辨析
| 对比维度 | 命令行工具 (CLI) | Web 应用 (Web Service) |
|---|---|---|
| 进程生命周期 | 瞬态执行:进程随单次计算完成立即退出,资源由 OS 统一销毁 | 守护常驻:监听端口,多工作线程持续维持,需自行管控资源回收 |
| 输入与协议 | argv 参数列表、环境变量、标准输入管道(stdin) | HTTP 协议报文:Request Headers、Query、Form、JSON Payload |
| 状态与存储 | 无状态流处理:依赖本地文件、重定向管道或标准输出 | 有状态持久化:依赖事务性关系数据库(SQLite/MySQL) |
| 容错呈现 | 向 stderr 输出诊断信息,回传非零 POSIX 退出码 (1/2) | 转换为 4xx/5xx HTTP 状态码,返回友好提示页面或错误 JSON |
3.2 业务内核与外壳解耦的设计范式
设想一个业务升级需求:如果需要在 NoteLite 的 Web 看板中增加一个“文本实时统计分析”功能,是否需要把 txtstat.py 的代码在 Web 中重写一遍?
答案是否定的。因为在 txtstat.py 的设计中,我们已经将计算函数 analyze_text_stream 剥离为纯函数。在 Web 项目中,只需要执行一行导入:
from txtstat import analyze_text_stream

@app.route("/api/analyze-file", methods=["POST"])
def api_analyze_file():
    target = pathlib.Path(request.json.get("path"))
    # 直接复用 CLI 工具的底层分析算法
    stats = analyze_text_stream(target, top_n=10)
    return jsonify(stats)
这就是六边形架构(Hexagonal Architecture)或“端口与适配器”模式的微型雏形:核心业务逻辑只关注输入与输出的确定性计算,命令行外壳与 Web 路由外壳仅仅负责将外部协议参数转换为核心函数所需的入参,再将计算结果渲染为目标介质所需的格式。
3.3 生产环境演进与注意事项
- CLI 工具打包分发:通过编写
pyproject.toml并配置[project.scripts] txtstat = "txtstat:main",可通过pip install -e .将其直接注册为全局终端命令,读者无需再键入python3前缀。 - Web 服务生产化部署:Flask 自带的
app.run()仅适用于本地单人调试。部署上线时,应将其置于生产级 WSGI 容器之后(例如 Gunicorn:gunicorn -w 4 -b 127.0.0.1:5000 notelite:app),并由 Nginx 处理静态资源与反向代理。 - 安全红线:在线上部署 Web 服务时,严禁开启
debug=True,否则其交互式调试器将成为任意代码执行的安全漏洞;同时必须强制校验用户上传文件的扩展名与大小上限,规避资源耗尽型 DoS 风险。
四、结语
通过本文对 txtstat 文本统计工具与 NoteLite 随手记事看板的完整实现,读者已经贯通了 Python 小型实战项目源码从参数规范、数据流度量、异常防御到 HTTP 路由、参数化数据库读写与 API 交付的全部工程环节。掌握这两类工程的原型设计规范与解耦思维,便具备了进一步拓展开发微服务、网络爬虫调度器与复杂后端系统的扎实基础。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















