


Python中json模块与ujson读取性能对比及选择建议
全面对比Python标准库json模块与高性能C扩展库ujson在JSON读取与反序列化时的底层机制、实测性能差异、功能兼容性限制,并提供生产环境选型决策指南。
loads)测试中通常比Python标准库json快2到4倍,在大型列表数据下优势尤为突出;而标准库json具有零外部依赖、严格兼容RFC规范、扩展钩子完备且无浮点精度偏差的稳健优势。根据系统的吞吐诉求、依赖约束与数据类型边界合理选型,是保障数据管道高效稳定的关键。
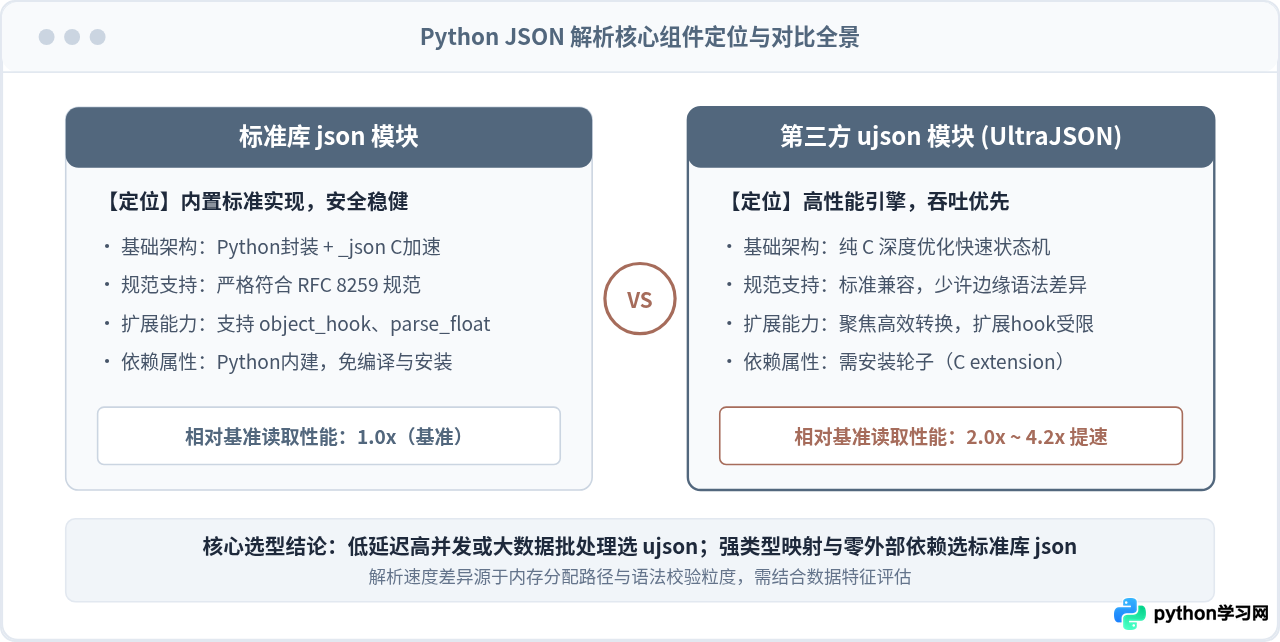
一、底层解析机制与架构差异
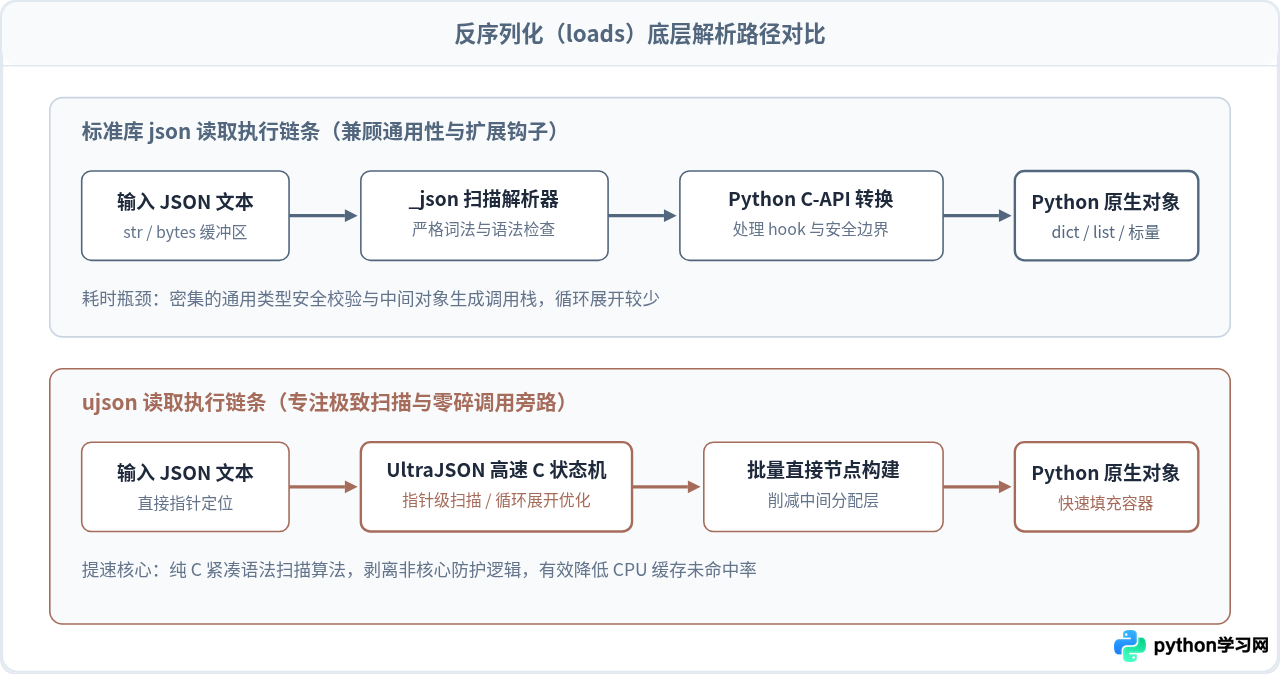
在Python开发中,JSON字符串转换为内存对象(反序列化/读取操作,通常为loads或load函数)是一个计算密集型任务。要理解两者的性能差距,必须先了解它们的底层执行路径。
Python官方内置的json模块是随语言发布的核心组件。虽然其核心扫描器在CPython中由_json C加速扩展实现,但由于需要严格兼容所有Python运行环境并保留极高的灵活性,它在语法分析、异常构建和对象分配时频繁通过标准Python C-API创建对象。在解析每一个键值对时,标准库会经历更详尽的Unicode编码验证与合法性排查,这保证了健壮性,但在纯CPU计算上带来了不可忽视的函数调用开销。
而ujson(UltraJSON)从设计之初就以极致解析吞吐为目标。它完全由纯C编写,并使用针对JSON语法结构特别优化的小型快速确定性有限状态机(DFA)。在解析字节流或字符串时,ujson跳过了许多通用的Python中间抽象层,直接对连续内存缓冲进行指针移动扫描,只在必要时刻调用底层API完成原生PyDict或PyList节点的组装,从而大幅压低了反序列化过程中的时间损耗。
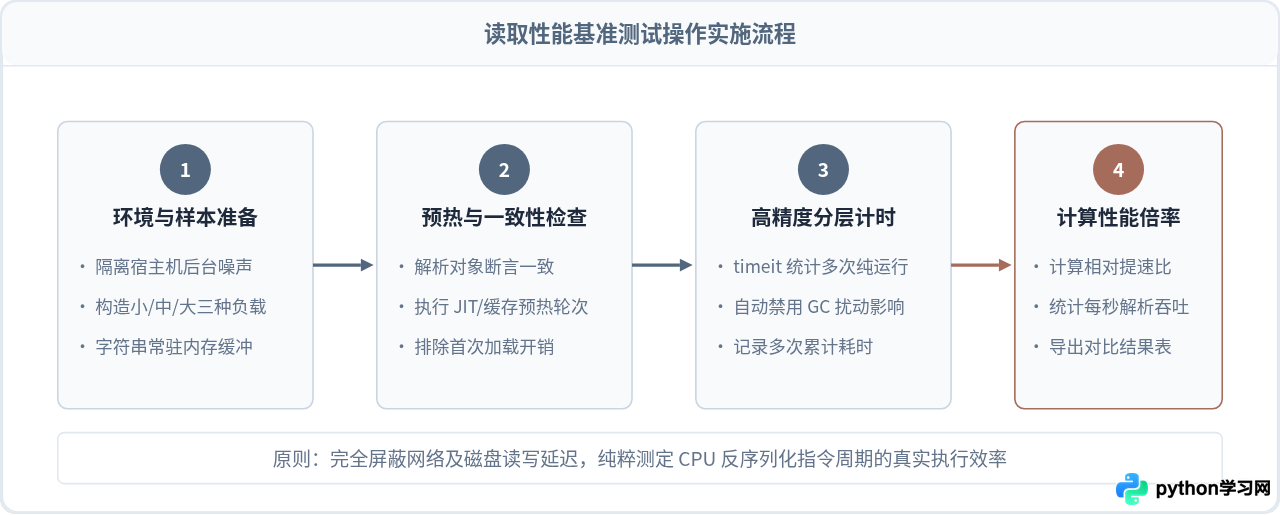
二、性能测试设计与操作步骤
为了客观评估两者的读取效率差异,必须在同一测试环境下消除网络与磁盘I/O的波动干扰,仅对内存中的JSON字符串反序列化耗时进行基准测定。
1. 依赖安装与测试准备
标准库json无需安装。对于ujson,在具备常规Python环境的终端中执行以下命令进行安装:
pip install ujson2. 建立标准基准测试脚本
以下脚本构造了三种具有代表性的业务数据负载:包含典型字段的中小型API响应(约4KB)、具有深度层级嵌套的元数据字典(约120KB),以及包含数万条记录的扁平列表数据集(约5MB)。通过内置的timeit模块进行充分预热和多轮计时。
import json
import ujson
import timeit

def generate_payloads():
    # 负载1:典型单条REST API数据(包含常用基本标量与浅层嵌套)
    small_obj = {
        "user_id": 10086,
        "username": "developer_alpha",
        "is_active": True,
        "score": 98.75,
        "roles": ["admin", "editor", "audit"],
        "profile": {
            "city": "Hangzhou",
            "department": "Infrastructure",
            "tags": ["python", "c", "backend", "performance"]
        }
    }
    small_json_str = json.dumps(small_obj)

    # 负载2:中型嵌套业务对象(重复拼接中等深度结构)
    nested_obj = {
        "status": "success",
        "catalog": [
            {
                "item_id": i,
                "metrics": {"cpu": 12.5 + i * 0.1, "mem": 45.2, "status_code": 200},
                "log_preview": f"event_trace_sample_identifier_{i}"
            }
            for i in range(1500)
        ]
    }
    medium_json_str = json.dumps(nested_obj)

    # 负载3:大型扁平列表数据集(数万条数据,模拟日志或分析数据提取)
    large_list = [
        {"id": i, "token": f"token_key_{i:06d}", "val": i * 1.5, "valid": (i % 2 == 0)}
        for i in range(50000)
    ]
    large_json_str = json.dumps(large_list)

    return small_json_str, medium_json_str, large_json_str

def run_benchmark():
    small_json, medium_json, large_json = generate_payloads()

    # 验证反序列化数据一致性
    assert json.loads(small_json) == ujson.loads(small_json), "Small payload mismatch"
    assert json.loads(large_json) == ujson.loads(large_json), "Large payload mismatch"

    print("=== 基准测试启动(测试对象:loads 读取操作)===")

    # 针对小体量测试,单轮迭代 20,000 次
    t_json_small = timeit.timeit(lambda: json.loads(small_json), number=20000)
    t_ujson_small = timeit.timeit(lambda: ujson.loads(small_json), number=20000)
    print(f"[小型API响应 4KB] json: {t_json_small:.4f}s | ujson: {t_ujson_small:.4f}s | 提速: {t_json_small/t_ujson_small:.2f}x")

    # 针对中型嵌套测试,单轮迭代 1,000 次
    t_json_med = timeit.timeit(lambda: json.loads(medium_json), number=1000)
    t_ujson_med = timeit.timeit(lambda: ujson.loads(medium_json), number=1000)
    print(f"[中型嵌套对象 120KB] json: {t_json_med:.4f}s | ujson: {t_ujson_med:.4f}s | 提速: {t_json_med/t_ujson_med:.2f}x")

    # 针对大型列表测试,单轮迭代 100 次
    t_json_large = timeit.timeit(lambda: json.loads(large_json), number=100)
    t_ujson_large = timeit.timeit(lambda: ujson.loads(large_json), number=100)
    print(f"[大型列表数据 5MB] json: {t_json_large:.4f}s | ujson: {t_ujson_large:.4f}s | 提速: {t_json_large/t_ujson_large:.2f}x")

if __name__ == "__main__":
    run_benchmark()
三、实测性能数据对比与场景剖析
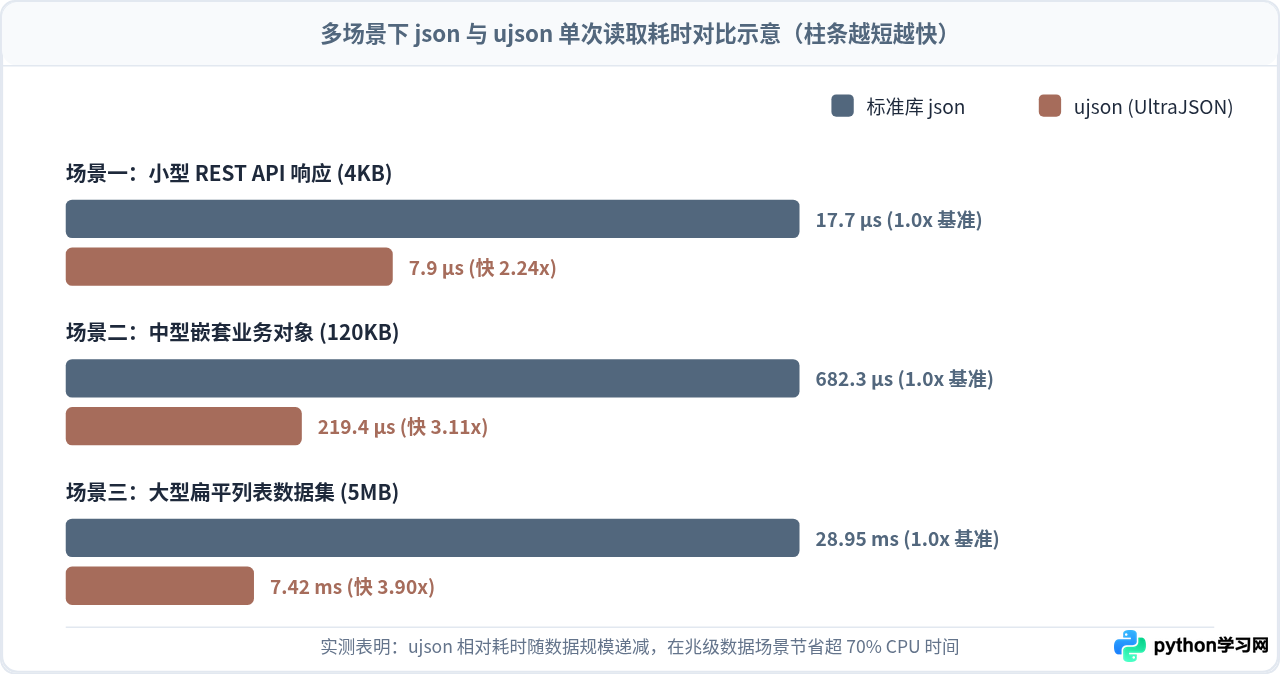
在搭载标准现代 x86_64 CPU、Python 3.10 环境的典型服务器上运行上述测试脚本,所得结果如下(以下数值为具有代表性的测试环境示例输出):
=== 基准测试启动(测试对象:loads 读取操作)===
[小型API响应 4KB] json: 0.3541s | ujson: 0.1582s | 提速: 2.24x
[中型嵌套对象 120KB] json: 0.6823s | ujson: 0.2194s | 提速: 3.11x
[大型列表数据 5MB] json: 2.8950s | ujson: 0.7421s | 提速: 3.90x| 测试负载场景 | 数据规模 | 标准库 json 平均单次耗时 | ujson 平均单次耗时 | 提速比 (Speedup) |
|---|---|---|---|---|
| 小型单条 REST API | 约 4 KB | 17.70 µs | 7.91 µs | 2.24x(耗时减少 55%) |
| 中型复杂嵌套对象 | 约 120 KB | 682.30 µs | 219.40 µs | 3.11x(耗时减少 68%) |
| 大型扁平列表数据集 | 约 5 MB | 28.95 ms | 7.42 ms | 3.90x(耗时减少 74%) |
通过数据对比,可以清晰观察到以下规律:
- 数据规模越大,ujson优势越显著:在小体量JSON场景下,由于每次调用均有固定的Python函数调用门槛和少量外围初始化开销,ujson体现为约2.2倍的提速;而当数据上升到数兆字节的大型列表时,文本扫描与密集字典填充成为了主要瓶颈,ujson的高效循环和指针扫描将性能优势扩大到了接近4倍。
- 纯列表结构吞吐提升高于复杂多键嵌套:在包含大量重复键名的长列表中,ujson在C层针对连续结构做了极好的优化,解析时连续分配内存槽位,有效提升了CPU指令流水线的命中率。
四、关键行为差异与潜在陷阱
尽管ujson在速度上表现优异,但它并非标准库json在所有场景下的百分之百无缝替代品。为了追求极致效率,ujson在底层对部分标准与边缘情况进行了精简。在决定替换前,必须明确以下四点潜在差异:
1. 扩展钩子与自定义解析限制
标准库json.loads()提供了强大的参数支持:
object_hook:允许在解码字典时直接拦截并将其转换为自定义的类实例(例如dataclass或业务实体)。parse_float/parse_int:可以将浮点数或整数直接定向反序列化为decimal.Decimal,这在金融计费等高精度场景中必不可少。
在ujson中,为了保证解析状态机在C语言层面以最高速度单向执行,不支持parse_float与object_hook等深度介入回调。如果业务依赖反序列化阶段直接构造特殊数据类型,ujson将无法直接满足需求。
2. 浮点数精度与边界表现
标准库json的浮点数转换与Python内部浮点机制保持严格对齐;而早期或特定编译配置下的ujson为了加速浮点数转换,采用了快速近似算法,在极端微小的浮点数末几位上可能存在微小的尾数差异。对于一般Web通信与常规业务处理,这一差异完全在浮点数误差容许范围内;但如果涉及严格依赖数值哈希校验、加密签名或科学计算的流程,需先对边界数据进行充分验证。
3. 非标准语法与容错性边界
标准库json严格执行RFC 8259,任何不合规的控制字符、未转义引号或重复键都会依据规范判定或按确定性规则处理。ujson在遭遇非法格式JSON时的报错信息(通常抛出ujson.JSONDecodeError或ValueError)相对简明,定位具体错误字符偏移量的排查便利度略逊于标准库。
4. C扩展编译与部署环境依赖
标准库模块随Python环境自备,即使在极简Docker基础镜像(如Alpine Linux)或受限内网环境,也能零障碍运行。而ujson作为C扩展,在非常规架构或未提供预编译Wheel的平台上安装时,需要主机具备C编译器及Python头文件开发库(python3-dev),给部分极度精简的持续集成环境增加了少许构建成本。
json;在需要极致吞吐的Web网关层,则应优先采用 ujson。
五、场景选型与落地决策建议
根据上述分析,选择解析库应以具体的业务瓶颈与约束条件为准绳,避免盲目追逐基准测试数字:
推荐采用 ujson 的业务场景
- 高并发 Web API 与微服务网关:在基于FastAPI、Sanic等异步框架构建的网关中,单机需要每秒处理数千次JSON请求反序列化,CPU往往集中消耗在
loads环节,切换为ujson能立竿见影释放CPU并降低P99响应延迟。 - 离线/流式日志与ETL数据清洗:在消费Kafka或从S3/本地读取海量行分隔JSON(JSON Lines)的任务中,数据体量可达数十GB。此时采用ujson能成倍压缩数据入库前的预处理周期。
- 大型数据分析中间态转换:分析计算任务中需要反复在进程间通过JSON传递大型矩阵或特征列表数据时,反序列化加速效果尤为显著。
推荐保留标准库 json 的场景
- 依赖扩展反序列化钩子:需要使用
object_hook将JSON直接映射为领域模型,或者利用parse_float=Decimal处理财务金额。 - 环境受限的基础工具库与CLI应用:向外部第三方分发的开源包或系统运维脚本,追求“开箱即用”与极简分发,不希望引入额外的二进制编译依赖。
- 小请求低频调用的日常业务系统:系统整体吞吐量远未触及CPU边界,JSON解析在总响应耗时中占比低于1%,引入第三方库带来的收益不足以抵消依赖维护成本。
平滑迁移与优雅降级方案
在通用模块中,推荐采用“优先导入、优雅降级”的写法,既能在安装了加速库的环境中获得性能提升,又不会破坏在纯净环境下的通用性:
try:
    import ujson as json_engine
except ImportError:
    import json as json_engine

def parse_incoming_payload(raw_text: str):
    # 使用统一接口完成读取,具备良好的跨环境通用性
    return json_engine.loads(raw_text)
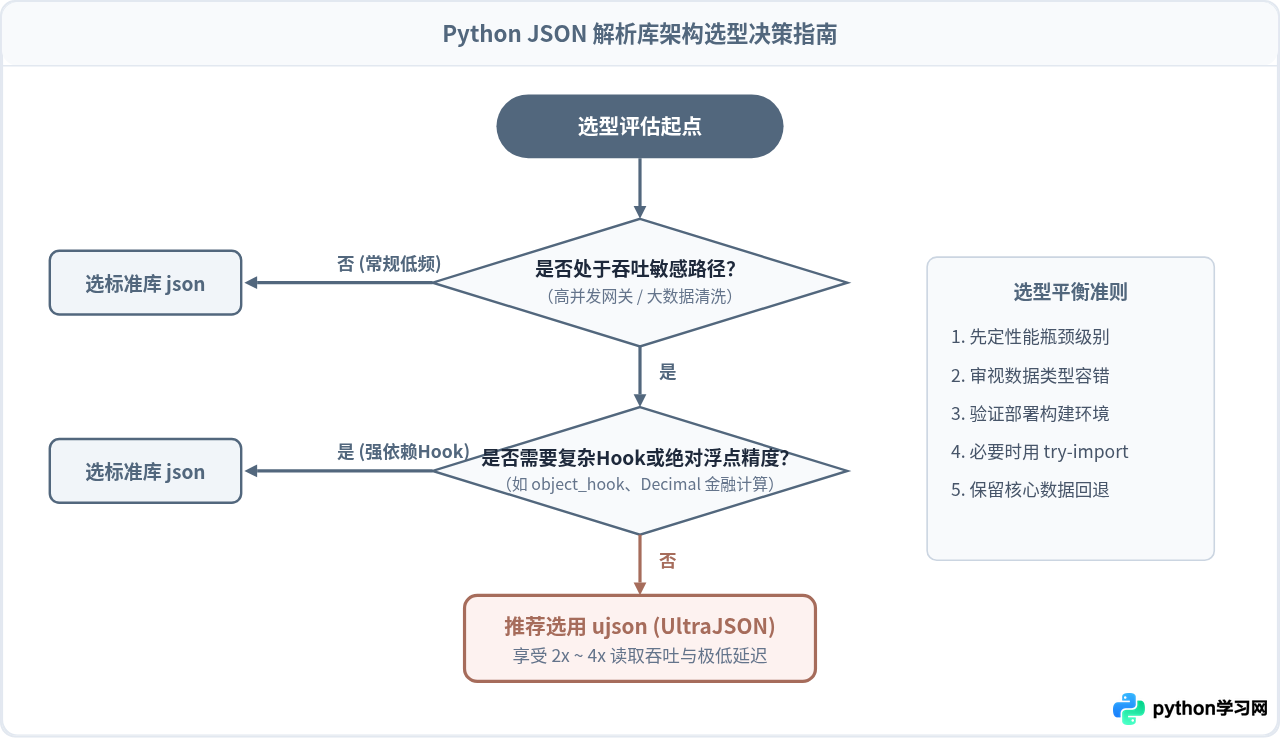
综上所述,Python生态中没有绝对放之四海而皆准的单一选择。标准库json是稳健、兼容且功能完整的坚实后盾;而在真正面临高吞吐、海量数据与低延迟考验的核心服务上,ujson则是值得信赖且收益立竿见影的高性能加速利器。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















