


Python在大数据处理中有什么优势?典型应用场景与库介绍
详细解析Python在大数据处理中的底层执行机制与核心优势,梳理批处理ETL、超内存交互式分析、特征工程等典型应用场景,并提供Polars、Dask、PySpark与PyArrow的完整代码示例及选型指南。
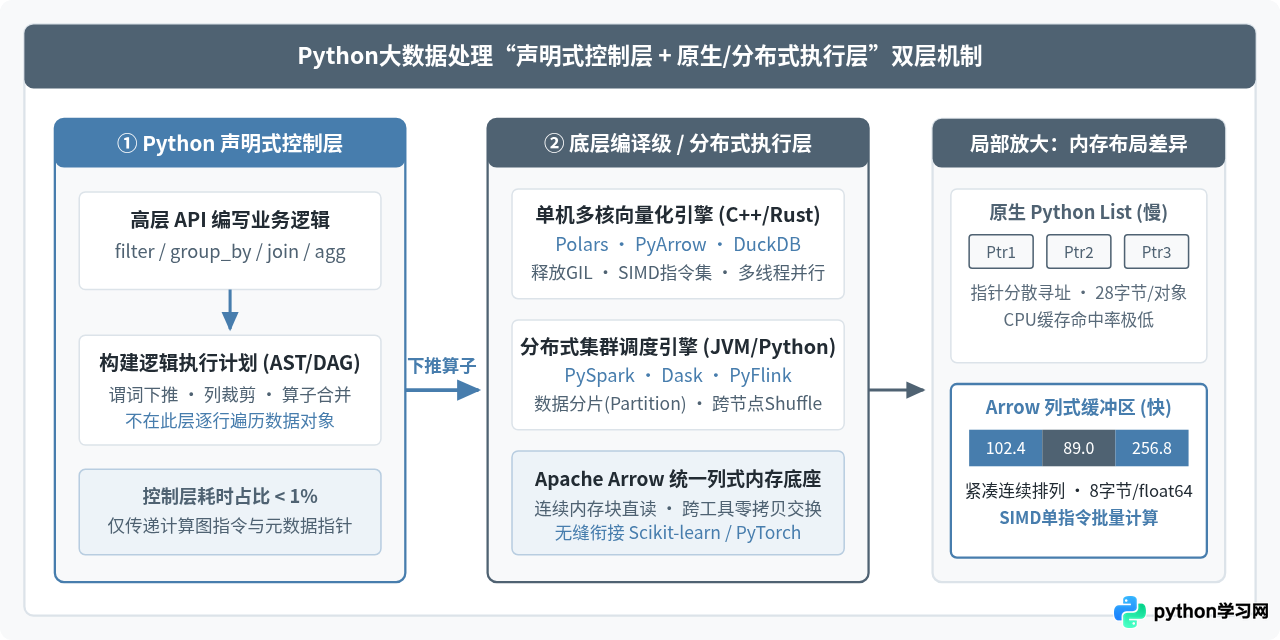
在纯Python中用for循环遍历并计算1亿行浮点数,耗时往往超过15秒;但如果在Python中调用Polars或PyArrow对同样规模的数据执行列式聚合,通常只需不到0.2秒。Python之所以能在大数据处理领域占据核心地位,关键在于它采用“Python层声明计算逻辑、底层C/C++/Rust或JVM集群执行重度计算”的双层架构。本文将具体拆解Python处理大数据的底层优势,梳理三个典型应用场景的数据量级边界,并通过可执行代码示例对比Polars、Dask、PySpark与PyArrow的实际用法与选型标准。
为什么解释型语言Python能高效处理大数据:三大核心优势
初次接触大数据处理的开发者常有一个疑问:Python存在全局解释器锁(GIL),且动态类型对象在内存中开销较大,为什么它反而成了大数据工程和数据分析的主流语言?原因在于现代大数据工具链从未让Python解释器直接逐行搬运数据。
1. 算子下推与向量化执行:绕过解释器与GIL瓶颈
在大数据处理库中,开发者编写的Python代码只负责组装“查询计划(Query Plan)”或“计算图(DAG)”。当触发执行时,真正的数据读取、过滤、哈希连接(Hash Join)和分组聚合全部交由底层的C++(如PyArrow、DuckDB)、Rust(如Polars)或JVM分布式引擎(如Apache Spark)完成。
底层引擎直接操作连续排列的列式内存缓冲区(如Apache Arrow标准内存格式),利用CPU的SIMD(单指令多数据流)指令集批量处理数据,并在C/Rust层主动释放Python的GIL实现多线程并行。这样既保留了Python简洁的语法,又获得了接近原生编译语言的吞吐性能。
2. 数据清洗、特征计算与模型训练的同语言闭环
实际业务中的大数据流水线很少止步于生成报表,处理后的宽表往往要紧接着用于统计检验、异常检测或机器学习训练。如果使用Java或Scala编写数据清洗管道,到了建模阶段仍需将数据导出再由Python读取;而统一使用Python生态时,PySpark或Polars产出的Apache Arrow内存表可以通过零拷贝(Zero-Copy)机制直接传递给NumPy、Scikit-learn、XGBoost或PyTorch,省去了跨语言序列化与中间文件落盘的I/O损耗。
3. 从单机样本验证到分布式集群的平滑演进
大数据工程调试成本高,直接在集群上针对TB级数据编写和排查转换逻辑效率很低。Python生态提供了高度一致的DataFrame API:开发者可以先在本地用几万行样本验证字段清洗和关联逻辑,随后根据数据规模的增长,切换为多核并行引擎(Polars/DuckDB)或分布式框架(Dask/PySpark),核心业务表达式的改写幅度远小于跨语言重构。
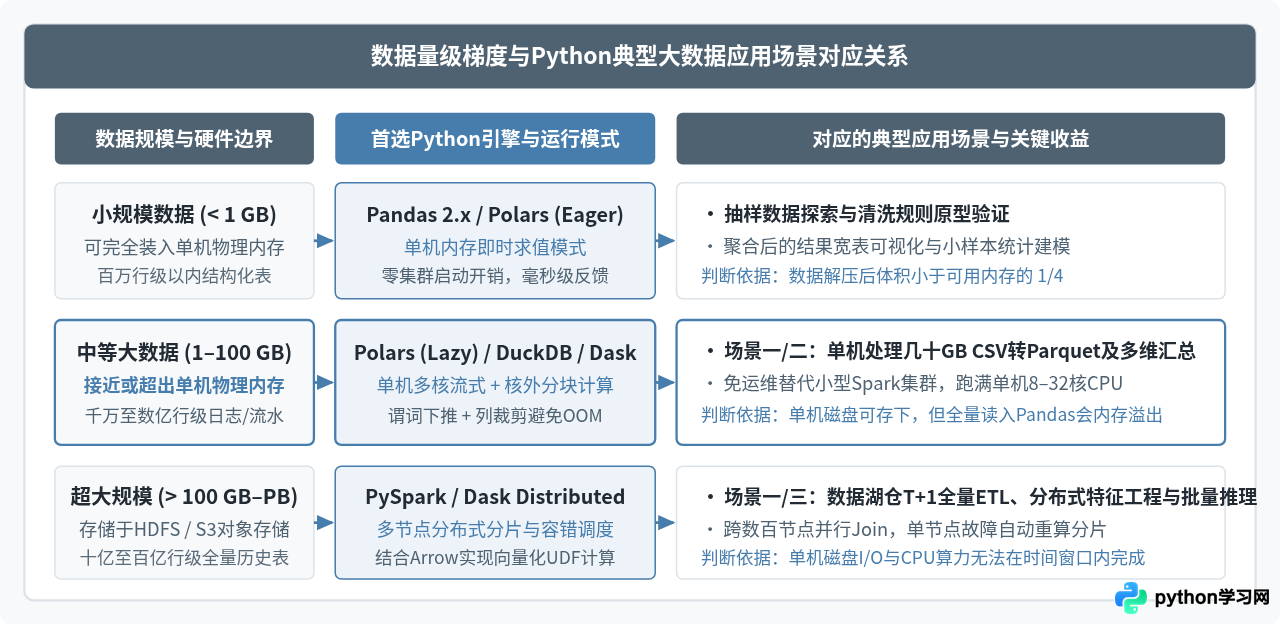
Python在大数据处理中的三个典型应用场景与边界
不同规模的数据集和响应延迟要求,对应完全不同的Python技术栈。脱离数据体量盲目上分布式集群,反而会因为网络通信和序列化开销拖慢运行速度。
场景一:海量原始日志与业务表的批处理ETL(清洗、关联与归档)
互联网行为日志、传感器上报记录和交易流水通常以CSV、JSON Lines格式落地,单日增量在几GB到数TB不等。这类数据存在字段缺失、时间戳格式不统一、嵌套JSON结构复杂等问题。
在此场景下,Python常被用于编写自动化ETL任务:利用Polars(单机10GB–100GB级)或PySpark(100GB–TB级集群)读取原始文本,执行正则提取、异常值过滤、与维表(Dimension Table)执行广播连接(Broadcast Join),最终转换为带有Snappy或ZSTD压缩的列式Parquet文件按日期分区归档。转换后不仅磁盘占用通常会缩减至原CSV的20%–35%,后续下游查询只需读取目标列,I/O速度可提升数倍。
场景二:超越单机内存上限的交互式探索与多维聚合
数据分析师或算法工程师经常需要在只有16GB或32GB内存的开发机上,分析50GB以上的历史订单或用户轨迹表。传统pandas.read_csv()会尝试将整张表一次性载入内存(且内存中DataFrame体积通常是磁盘CSV文件的2到4倍),直接引发MemoryError或触发系统OOM Killer。
通过Python中的核外计算(Out-of-Core)与惰性求值(Lazy Evaluation)工具(如Polars的scan_parquet、DuckDB的磁盘流式引擎或Dask的分块DataFrame),引擎会自动将大文件拆分为适应CPU缓存的微批次(Chunk/Batch),一边从磁盘流式读取目标列,一边在内存中完成分组聚合,最终只将几千行汇总结果保留在内存中,使单机能够平稳处理远超物理内存大小的数据集。
场景三:大规模机器学习特征工程与分布式批量推理
在推荐系统、风控反欺诈和销量预测场景中,需要基于上亿条历史交互记录计算滑窗统计特征(如“过去7天各品类点击率”“最近30天交易金额分位数”),并将训练好的模型应用于海量存量用户进行批量打分。
Python在此场景中具有不可替代性:特征工程脚本可以直接复用PySpark的Window窗口函数或Polars的滚动窗口表达式生成特征矩阵;进入批量推理阶段时,利用PySpark的mapInArrow或pandas_udf,在每个Executor节点上加载一次LightGBM或PyTorch模型,以Apache Arrow批次为单位并发完成亿级样本预测,避免了单机循环调用的瓶颈。
主流Python大数据处理库介绍与实战代码
为了直观对比各库的写法与协作方式,以下示例统一围绕同一份电商用户行为数据集user_events.parquet展开。该数据集包含5个字段:user_id(用户ID,整数)、region(地区,字符串)、event_type(事件类型,如click、purchase)、amount(订单金额,浮点数)和event_time(事件时间戳)。
先在终端安装所需依赖包(建议使用Python 3.10及以上环境):
pip install polars pyarrow "dask[dataframe]" pyspark为了方便在本地直接运行验证,先执行以下脚本在当前工作目录下生成一份标准的列式文件user_events.parquet:
prepare_data.py 并在终端运行 python prepare_data.py):import pyarrow as pa
import pyarrow.parquet as pq
# 构造示例列式数据表(实际生产中通常为数千万至数亿行)
table = pa.table({
"user_id": [1001, 1002, 1001, 1003, 1002, 1004, 1001, 1003],
"region": ["华东", "华南", "华东", "华北", "华南", "华东", "华东", "华北"],
"event_type": ["purchase", "click", "purchase", "purchase", "purchase", "purchase", "click", "purchase"],
"amount": [120.5, 0.0, 340.0, 89.9, 210.0, 560.0, 0.0, 150.0],
"event_time": [
"2026-10-01 10:05:00", "2026-10-01 10:06:12",
"2026-10-01 11:20:00", "2026-10-01 11:35:40",
"2026-10-01 12:10:05", "2026-10-01 14:00:00",
"2026-10-01 15:12:30", "2026-10-01 16:45:00"
]
})
pq.write_table(table, "user_events.parquet", compression="zstd")
print("已生成测试文件: user_events.parquet")1. Polars:基于Rust与Apache Arrow的单机多核高性能引擎
Polars底层完全由Rust编写,原生基于Apache Arrow内存模型,默认使用机器上的全部CPU核心并行计算。它最大的优势是具备完整的查询优化器(Query Optimizer):使用pl.scan_parquet()开启惰性模式后,Polars会先分析整条链式调用,自动只读取代码中用到的列(投影下推),并在读取Parquet文件块时直接跳过不符合过滤条件的数据块(谓词下推)。
import polars as pl

# 1. 使用 scan_parquet 构建惰性查询计划,此时尚未真正加载磁盘数据
lazy_query = (
    pl.scan_parquet("user_events.parquet")
    .filter((pl.col("event_type") == "purchase") & (pl.col("amount") > 100.0))
    .group_by("region")
    .agg([
        pl.len().alias("order_count"),
        pl.col("amount").sum().round(2).alias("total_amount"),
        pl.col("amount").mean().round(2).alias("avg_amount")
    ])
    .sort("total_amount", descending=True)
)

# 2. 调用 collect(streaming=True) 触发流式多核执行,可处理大于内存的数据文件
result_df = lazy_query.collect(streaming=True)
print(result_df)shape: (2, 4)
┌────────┬─────────────┬──────────────┬────────────┐
│ region ┆ order_count ┆ total_amount ┆ avg_amount │
│ --- ┆ --- ┆ --- ┆ --- │
│ str ┆ u32 ┆ f64 ┆ f64 │
╞════════╪═════════════╪══════════════╪════════════╡
│ 华东 ┆ 3 ┆ 1020.5 ┆ 340.17 │
│ 华南 ┆ 1 ┆ 210.0 ┆ 210.0 │
└────────┴─────────────┴──────────────┴────────────┘2. Dask:与Pandas/NumPy接口高度兼容的并行与分块扩展库
如果团队已有大量基于Pandas或NumPy编写的特征清洗脚本,因为数据量从几百MB涨到几十GB而频繁内存溢出,Dask是改造成本最低的选择。dask.dataframe在逻辑上将一张超大的表切分为多个纵深较小的Pandas DataFrame分片(Partitions),通过构建任务调度图,在单机多进程或多台机器组成的集群上并行处理各个分片。
import dask.dataframe as dd

# 1. 仅读取需要的列,Dask 会按文件块自动划分为多个 Partition
ddf = dd.read_parquet(
    "user_events.parquet",
    columns=["region", "event_type", "amount"]
)

# 2. 声明过滤与分组逻辑(语法与 Pandas 高度一致,此时仅构建任务图)
filtered_ddf = ddf[(ddf["event_type"] == "purchase") & (ddf["amount"] > 100.0)]
summary_task = (
    filtered_ddf.groupby("region")["amount"]
    .agg(["count", "sum", "mean"])
)

# 3. 调用 .compute() 触发并行计算,将汇总后的小结果转为标准 Pandas DataFrame
final_pdf = summary_task.compute()
print(final_pdf.sort_values(by="sum", ascending=False)) count sum mean
region
华东 3 1020.5 340.166667
华南 1 210.0 210.0000003. PySpark:百GB至PB级分布式集群计算标准
当数据量达到数百GB乃至TB级、存储在HDFS或对象存储(S3/OSS)上时,单机磁盘I/O和内存带宽已成为物理瓶颈,此时需要使用Apache Spark的Python接口PySpark。PySpark通过Catalyst优化器将Python DataFrame算子编译为JVM底层的Tungsten物理执行计划,在数十至数百台工作节点上并行完成分片读取、跨节点Shuffle和故障自动重试。
注意运行PySpark需要系统已安装Java运行环境(推荐JDK 11或JDK 17),并确保环境变量JAVA_HOME指向对应目录。
import pandas as pd
from pyspark.sql import SparkSession
from pyspark.sql import functions as F
from pyspark.sql.functions import pandas_udf

# 1. 初始化 SparkSession,显式开启 PyArrow 零拷贝数据传输优化
spark = (
    SparkSession.builder
    .appName("PythonBigDataDemo")
    .master("local[*]")  # 本地测试使用所有CPU核心;生产环境连接 YARN 或 K8s
    .config("spark.sql.execution.arrow.pyspark.enabled", "true")
    .getOrCreate()
)

# 2. 定义基于 Arrow 的向量化 Pandas UDF(按批次Series处理,避免逐行序列化开销)
@pandas_udf("double")
def calc_taxed_amount(amount_series: pd.Series) -> pd.Series:
    return (amount_series * 1.06).round(2)

# 3. 读取 Parquet 并执行分布式转换与聚合
sdf = spark.read.parquet("user_events.parquet")
result_sdf = (
    sdf.filter((F.col("event_type") == "purchase") & (F.col("amount") > 100.0))
    .withColumn("taxed_amount", calc_taxed_amount(F.col("amount")))
    .groupBy("region")
    .agg(
        F.count("amount").alias("order_count"),
        F.round(F.sum("amount"), 2).alias("total_amount"),
        F.round(F.sum("taxed_amount"), 2).alias("total_taxed_amount")
    )
    .orderBy(F.col("total_amount").desc())
)

result_sdf.show()
spark.stop()+------+-----------+------------+------------------+
|region|order_count|total_amount|total_taxed_amount|
+------+-----------+------------+------------------+
| 华东| 3| 1020.5| 1081.73|
| 华南| 1| 210.0| 222.60|
+------+-----------+------------+------------------+4. PyArrow:大数据生态的底层内存与文件格式枢纽
PyArrow不仅是一个独立的库,更是Polars、Pandas 2.x、Dask和PySpark之间高速交换数据的底层桥梁。在不需要复杂SQL或分布式调度的场景下,直接使用pyarrow.dataset可以对包含成百上千个分区文件的Parquet目录进行高速流式扫描与列裁剪。
实操步骤:将易内存溢出的传统脚本改造为高吞吐流水线
在实际项目中,最常见的需求是将一段原本用Pandas编写、面对几十GB数据时崩溃或耗时数小时的脚本,改造为高效的大数据处理流水线。以下按实际工程改造的四个标准步骤展开。
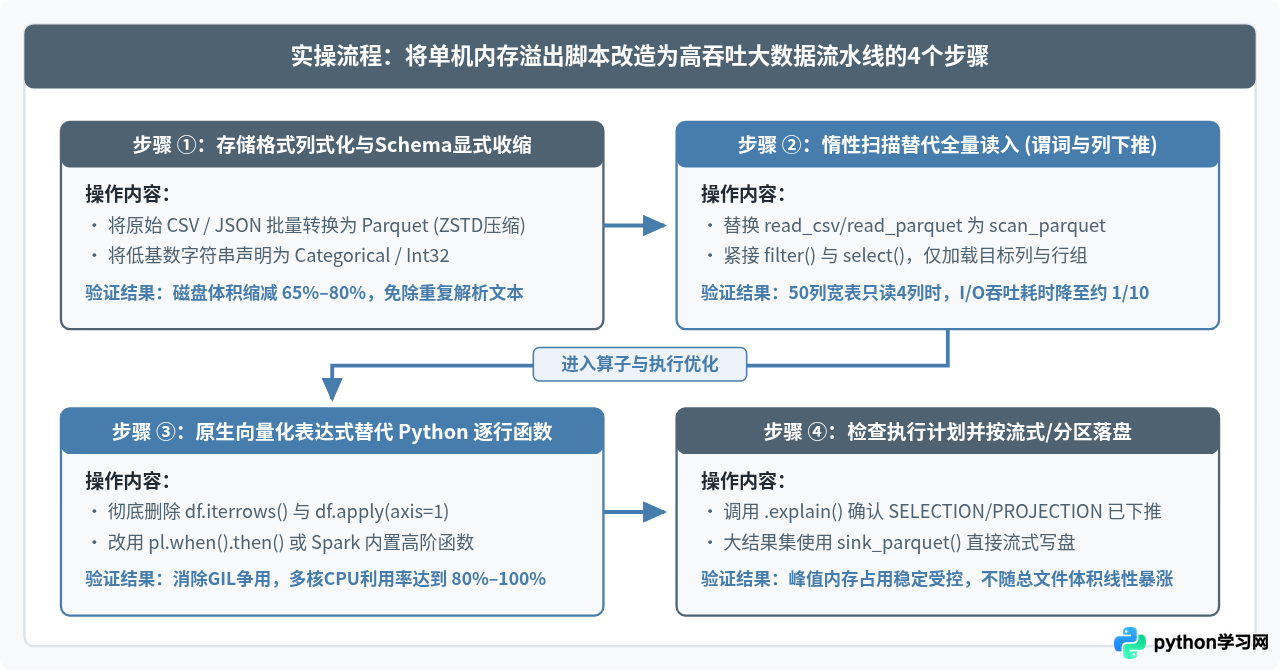
步骤一:将行式CSV转换为列式Parquet并显式指定数据类型
CSV文件没有内置数据类型元数据,每次读取都需要消耗大量CPU解析换行符和推断数据类型,而且无法跳过无关列。在处理几十GB的原始CSV时,第一步应当使用流式读取将其一次性转换为Parquet文件,并在读取时显式指定紧凑的数据类型(例如将64位整数收缩为32位整数)。
import polars as pl

# 先创建一个示例 CSV 文件用于演示转换过程
with open("raw_events.csv", "w", encoding="utf-8") as f:
    f.write("user_id,region,event_type,amount\n")
    f.write("1001,华东,purchase,120.5\n")
    f.write("1002,华南,click,0.0\n")
    f.write("1003,华北,purchase,260.0\n")

# 显式定义紧凑 Schema,并使用 sink_parquet 流式转换落盘
schema_overrides = {
    "user_id": pl.Int32,
    "region": pl.Categorical,
    "event_type": pl.Categorical,
    "amount": pl.Float32
}

(
    pl.scan_csv("raw_events.csv", schema_overrides=schema_overrides)
    .sink_parquet("optimized_events.parquet", compression="zstd")
)
print("流式转换完成: optimized_events.parquet")
步骤二:用惰性扫描替代全量读取,验证谓词与列下推
改用scan_parquet后,不要立刻调用.collect(),而是先将所有的filter(行过滤)和select(列选择)串联起来,并通过.explain()检查优化后的物理执行计划。
import polars as pl

plan = (
    pl.scan_parquet("user_events.parquet")
    .filter(pl.col("amount") > 200.0)
    .select(["user_id", "region", "amount"])
)

# 打印优化后的执行计划
print(plan.explain())Parquet SCAN [user_events.parquet]
PROJECT 3/5 COLUMNS
SELECTION: [(col("amount")) > (200.0)]看到输出中包含PROJECT 3/5 COLUMNS(只读取5列中的3列)和SELECTION位于Parquet SCAN阶段,就证明引擎在磁盘读取阶段已经完成了裁剪,不会把无关列和无效行读入内存。
步骤三:用向量化分支表达式替换Python层自定义循环
在传统脚本中,开发者常使用df.apply(lambda row: ..., axis=1)来实现复杂的多条件打标。在千万行数据下,这会导致Python函数被调用千万次。应将其改写为底层引擎原生的when/then/otherwise向量化表达式。
import polars as pl

tagged_df = (
    pl.scan_parquet("user_events.parquet")
    .filter(pl.col("event_type") == "purchase")
    .with_columns(
        pl.when(pl.col("amount") >= 300.0)
        .then(pl.lit("高价值订单"))
        .when(pl.col("amount") >= 100.0)
        .then(pl.lit("中等订单"))
        .otherwise(pl.lit("小额订单"))
        .alias("order_tier")
    )
    .select(["user_id", "region", "amount", "order_tier"])
    .collect()
)
print(tagged_df)shape: (6, 4)
┌─────────┬────────┬────────┬────────────┐
│ user_id ┆ region ┆ amount ┆ order_tier │
│ --- ┆ --- ┆ --- ┆ --- │
│ i64 ┆ str ┆ f64 ┆ str │
╞═════════╪════════╪════════╪════════════╡
│ 1001 ┆ 华东 ┆ 120.5 ┆ 中等订单 │
│ 1001 ┆ 华东 ┆ 340.0 ┆ 高价值订单 │
│ 1003 ┆ 华北 ┆ 89.9 ┆ 小额订单 │
│ 1002 ┆ 华南 ┆ 210.0 ┆ 中等订单 │
│ 1004 ┆ 华东 ┆ 560.0 ┆ 高价值订单 │
│ 1003 ┆ 华北 ┆ 150.0 ┆ 中等订单 │
└─────────┴────────┴────────┴────────────┘步骤四:流式落盘避免汇聚节点内存崩溃
如果清洗后的结果仍然是几千万行明细表(而非几百行汇总表),最后一步切勿调用.collect()或PySpark中的.toPandas()将结果全部拉回单机内存,而应直接调用Polars的.sink_parquet("output.parquet")或PySpark的df.write.partitionBy("region").parquet("output_dir")直接流式写入磁盘。
df.toPandas()或df.collect()。这会强制所有工作节点将上百GB的数据通过网络集中发送给单个Driver主进程,直接导致Driver节点内存溢出(java.lang.OutOfMemoryError: Java heap space或进程被系统Killed)。若只需查看结果样本,应始终使用df.limit(20).toPandas()或df.show(20)。
工具选型总结与常见疑难排查
下表与总结图梳理了Python大数据处理核心工具的技术定位与选型判断依据:
| 库名称 | 底层执行引擎 | 最佳适用数据量级 | 核心优势 | 主要限制条件 |
|---|---|---|---|---|
| Polars | Rust + Apache Arrow | 单机 1 GB – 100 GB | 内置查询优化器与流式核外计算,单机多核吞吐极高,无需配置JVM | 以单机纵向扩展为主,跨多机分布式能力不如Spark成熟 |
| Dask | Python多进程 + Pandas/NumPy分片 | 单机核外或小型集群 10 GB – 500 GB | API与Pandas/NumPy/Scikit-learn高度一致,存量代码改造成本最低 | 缺少强类型的全局SQL级查询优化器,复杂Shuffle时内存管理较敏感 |
| PySpark | JVM (Spark Catalyst + Tungsten) | 分布式集群 100 GB – PB级 | 工业界大规模数据湖仓标准,容错机制完善,支持SQL、流处理与MLlib | 依赖JVM环境配置,处理几个GB的小数据时启动与调度开销反而偏高 |
| PyArrow / DuckDB | C++ 列式内存与向量化SQL引擎 | 单机内存及核外 1 GB – 100 GB | 零拷贝内存标准底座,支持对Parquet文件直接运行高速分析型SQL | 侧重分析查询与底层数据交换,非分布式集群调度框架 |
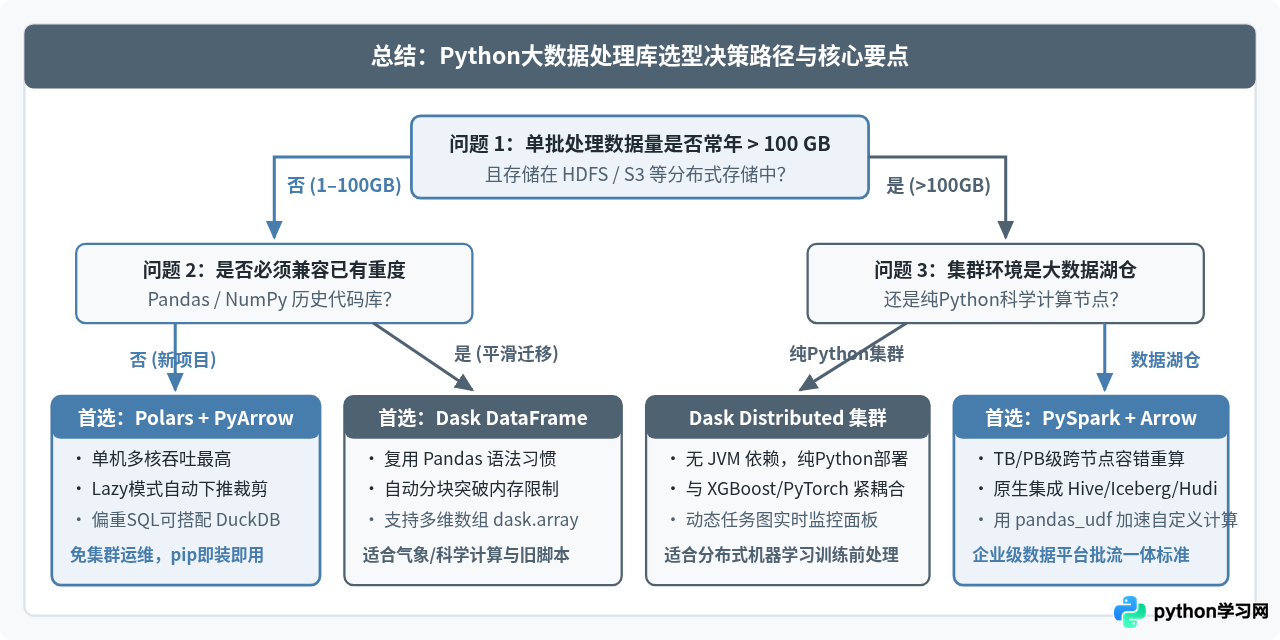
常见疑难与排查方法
1. 为什么在本地处理5GB的数据时,使用PySpark反而比Polars慢很多?
PySpark专为跨节点分布式计算设计,启动任务时需要初始化JVM进程、构建SparkContext、划分Stage并序列化任务闭包。当数据量只有几GB且运行在单机上时,JVM启动、进程间通信以及磁盘Shuffle的固定开销往往达到十余秒;而Polars直接在进程内通过Rust多线程操作Apache Arrow内存,没有任何虚拟机启动和跨进程序列化损耗,通常在1至3秒内即可完成同样规模的计算。处理50GB以内的单机数据,优先选用Polars或DuckDB。
2. 在PySpark中编写了普通的 @udf 函数后,作业耗时暴增数十倍,如何修复?
普通的@udf会将JVM Executor内存中的数据逐行使用pickle序列化,通过Socket管道发送给Python子进程执行,算完再逐行反序列化回JVM。排查与修复按以下优先级进行:
- 优先替换为内置函数:检查
pyspark.sql.functions中是否已有等效算子(如F.regexp_extract、F.when、F.transform),内置算子全程在JVM内以编译字节码运行,完全不经过Python进程。 - 改用基于Arrow的
@pandas_udf:如果必须调用Python第三方库(如SciPy计算或模型推理),将@udf改写为接收pd.Series并返回pd.Series的@pandas_udf,并在Spark配置中开启spark.sql.execution.arrow.pyspark.enabled=true,使数据按列式批次零拷贝传输,吞吐量通常可提升10到50倍。
3. 只有一台16GB内存的电脑,却要汇总一个40GB的单一CSV文件,没有集群怎么办?
不要使用pandas.read_csv("big.csv")直接读取。如果只需要做分组统计或过滤提取,直接使用Polars的pl.scan_csv("big.csv").filter(...).group_by(...).agg(...).collect(streaming=True),或者安装DuckDB执行流式SQL直接产出Parquet结果。这两种方式都会按固定大小的内存块流式扫描CSV,全程内存占用通常稳定在2GB–4GB以内,无需搭建任何分布式集群即可跑完。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















