


零基础怎么规划Python自动化学习路径?从语法基础到实战项目
针对零基础学习者的实用Python自动化学习路径规划指南,从核心语法最小集到环境搭建、三大业务场景技术选型,再到无人值守实战项目的全流程拆解与避坑建议。
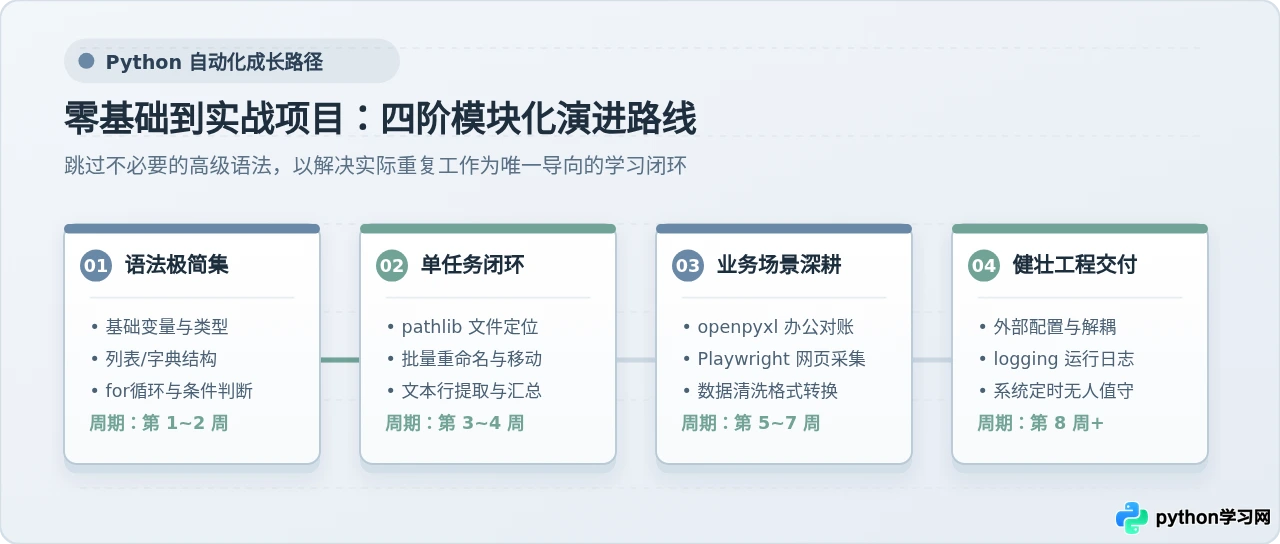
一、确定学习策略:为什么“语法最小集”是自动化的关键起点
许多零基础学习者在起步时最容易犯的错误,就是买一本厚达上千页的编程教材,从面向对象、元编程、装饰器一直背到数据结构与算法。这种传统科班式的学习方式往往耗费两到三个月,却连一个读取本地表格的脚本都写不出来,最终在枯燥的理论中放弃。
实际上,编写自动化脚本与从事大型软件后端开发的思维完全不同。自动化的核心诉求非常纯粹:读取外部数据 → 按业务规则过滤或清洗 → 批量执行操作 → 写入目标位置。为了支撑这套流程,你只需要掌握 Python 语法的“最小必要集合”,其余高级特性完全可以在后续项目中按需查阅。
自动化开发必须掌握的五项核心语法
- 变量与基本数据类型:熟练掌握字符串(String)的拼接与切片清洗,掌握整数(int)与浮点数(float)的基本运算,理解布尔值(True/False)在逻辑判断中的作用。
- 核心容器(列表与字典):列表(list)用于收纳批量的文件路径或数据行,字典(dict)用于映射键值对(例如配置参数、接口返回的 JSON、单号对应的金额)。重点练习如何通过
for item in list进行遍历,以及通过dict.get(key)安全提取字段。 - 流程控制语句:通过
for循环实现批量轮询,通过if / elif / else设置多分支业务规则,配合break与continue控制执行节奏。 - 现代文件与路径操作(
pathlib.Path):摒弃陈旧易错的字符串路径拼接,熟练运用Path.glob()模式匹配查找文件,通过path.exists()校验文件是否存在。 - 基础函数与异常防御:使用
def将独立逻辑封装为可复用的函数;使用try...except捕获文件缺失或类型转换错误,防止单个异常数据导致整个自动化进程中断崩溃。
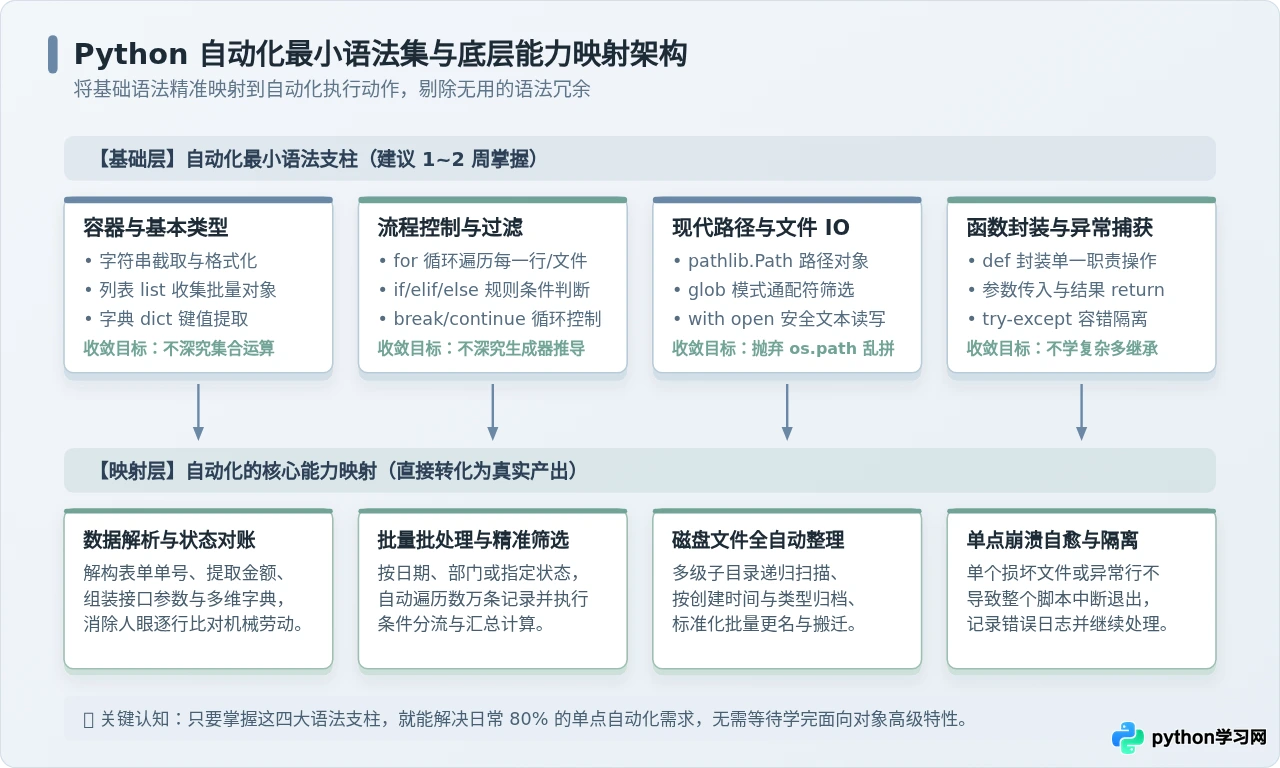
在语法学习阶段,检验自己是否过关的客观标准不是“能不能背出定义”,而是:能否在不看参考答案的前提下,写出一段 20 行以内的代码,遍历本地一个包含文本文件的文件夹,筛选出带有特定关键词的行并打印出来。只要能独立跑通该逻辑,即可果断结束语法学习,立即进入具体实操环境的搭建。
二、搭建可验证环境与首个自动化最小闭环
零基础学习者保持动力的关键在于尽早获得“正向反馈”。通过亲眼看到一段代码在本地磁盘真实创建文件夹、移动上百个杂乱文件,能建立起对自动化的直观掌控感。
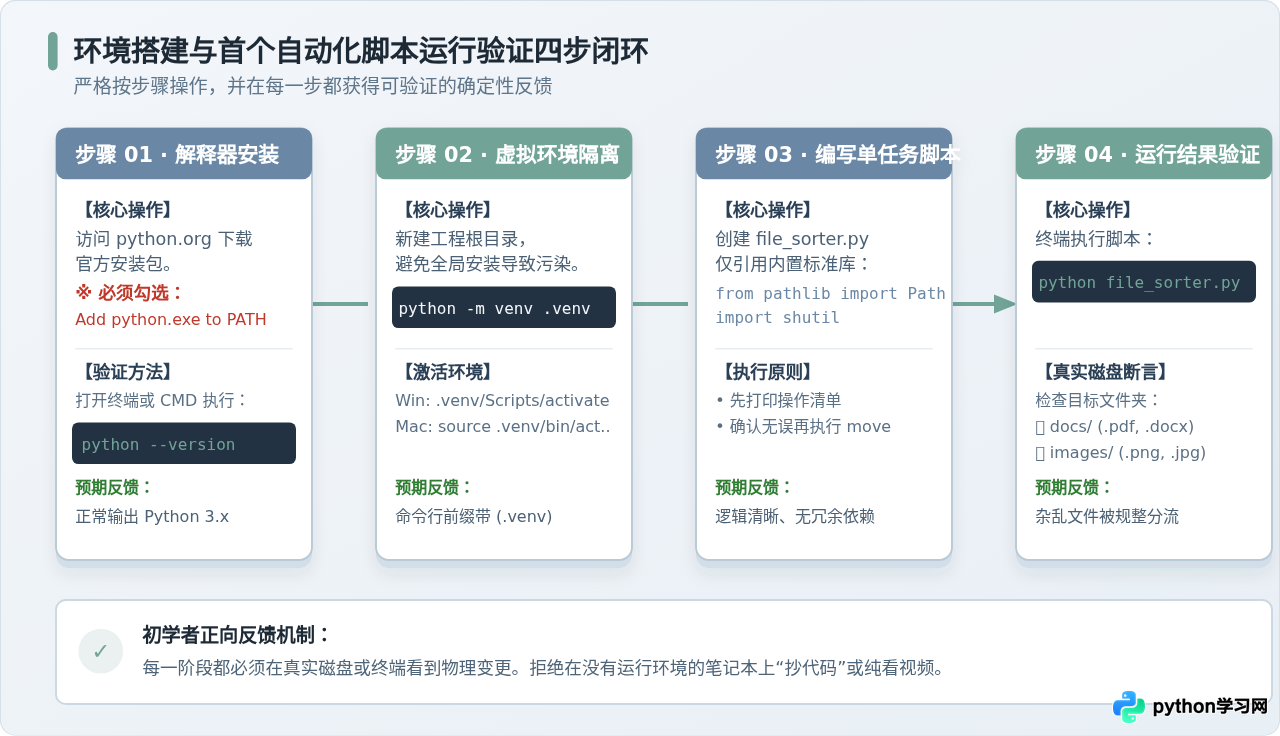
步骤一:Python 解释器安装与 PATH 环境变量核验
从 Python 官方网站(python.org)下载最新的稳定版本安装包。在安装向导首页,务必勾选底部的 “Add python.exe to PATH”(添加至系统环境变量)。如果遗漏该选项,会导致在终端执行命令时提示找不到 Python 解释器。
安装完成后,打开操作系统终端(Windows 下按 Win+R 输入 cmd,macOS 打开“终端”应用),输入以下命令验证:
python --version如果终端正确返回类似于 Python 3.11.x 或更高版本号,说明系统已成功识别解释器。若提示命令不存在,需重新运行安装包并选择 Modify 修复 PATH 环境变量。
步骤二:建立项目目录与虚拟环境隔离
在磁盘中创建一个专门用于存放自动化代码的目录,并为该项目初始化独立的虚拟环境(virtual environment)。虚拟环境能够把第三方库安装在项目内,防止未来不同脚本之间的类库版本发生冲突。
# 1. 创建并进入工程文件夹
mkdir auto_workspace
cd auto_workspace

# 2. 创建名为 .venv 的虚拟环境
python -m venv .venv

# 3. 激活虚拟环境
# Windows 终端执行:
.venv\Scripts\activate
# macOS / Linux 终端执行:
source .venv/bin/activate
激活成功后,命令行提示符最左侧会出现 (.venv) 标识,表示当前所有执行与库安装均处于隔离环境中。
步骤三:编写首个实战脚本——杂乱下载目录智能归类器
在 auto_workspace 目录下新建名为 organize_downloads.py 的文件。本脚本不依赖任何第三方包,仅使用 Python 自带的标准库 pathlib 与 shutil,实现按文件后缀自动分流整理的功能:
from pathlib import Path
import shutil

def organize_folder(target_dir: str):
    """
    扫描目标目录,根据文件后缀名自动归类至对应的分类文件夹中
    """
    base_path = Path(target_dir).resolve()
    if not base_path.exists() or not base_path.is_dir():
        print(f"[错误] 目标目录不存在: {base_path}")
        return

    # 定义后缀名与目标子目录的映射规则
    extension_rules = {
        "文档资料": [".pdf", ".docx", ".doc", ".txt", ".xlsx", ".pptx"],
        "图片素材": [".jpg", ".jpeg", ".png", ".gif", ".svg", ".webp"],
        "压缩归档": [".zip", ".rar", ".7z", ".tar", ".gz"],
        "影音多媒体": [".mp4", ".mp3", ".wav", ".mkv", ".mov"]
    }

    moved_count = 0

    # 遍历当前目录下的所有直接子项
    for item in base_path.iterdir():
        # 仅处理普通文件,忽略文件夹本身
        if item.is_file():
            file_ext = item.suffix.lower()
            matched_folder = None

            # 匹配对应类别
            for folder_name, extensions in extension_rules.items():
                if file_ext in extensions:
                    matched_folder = folder_name
                    break

            # 若未匹配到指定规则,归入“其他杂项”
            if matched_folder is None:
                matched_folder = "其他杂项"

            # 准备目标文件夹
            dest_dir = base_path / matched_folder
            dest_dir.mkdir(exist_ok=True)

            # 目标文件完整路径
            dest_file = dest_dir / item.name

            # 避免覆盖重名文件
            if not dest_file.exists():
                shutil.move(str(item), str(dest_file))
                print(f"[已整理] {item.name} -> {matched_folder}/")
                moved_count += 1
            else:
                print(f"[跳过] 目标已存在同名文件: {item.name}")

    print(f"
整理完毕!共自动移动 {moved_count} 个文件。")

if __name__ == "__main__":
    # 此处可指定用于测试的本地目录路径
    test_folder = "./test_download"
    Path(test_folder).mkdir(exist_ok=True)
organize_folder(test_folder)代码中通过 dest_dir.mkdir(exist_ok=True) 确保目标文件夹在不存在时自动创建,若已存在也不会报错;通过 item.suffix.lower() 统一转为小写,避免因为 .PNG 与 .png 大小写差异导致匹配失败。
步骤四:执行与结果断言
在终端中执行 python organize_downloads.py。执行完成后打开文件管理器,检查 test_download 目录内是否生成了对应的分类子目录,且文件已规范迁移。在本地观察到这一确切结果,意味着你已经完整走通了自动化从代码编写到结果交付的最小闭环。
三、自动化三大主线技术选型与进阶路线
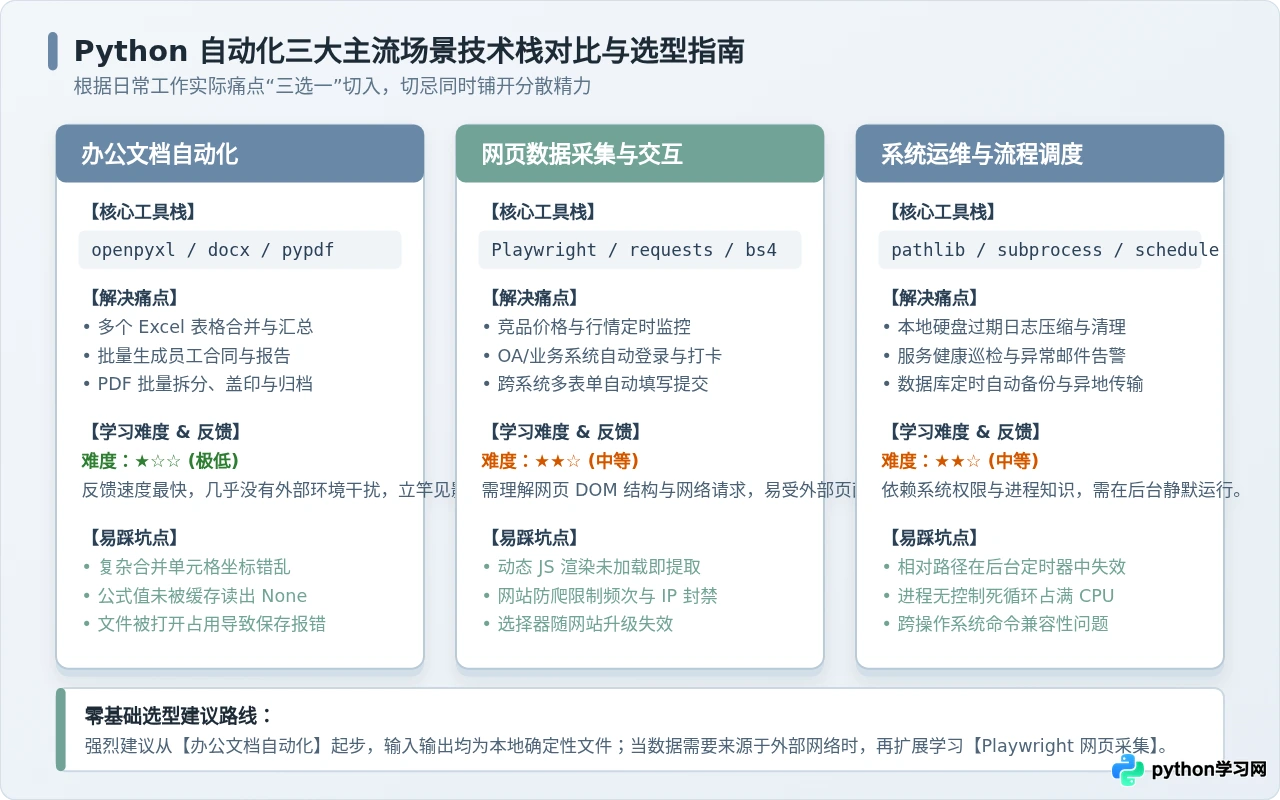
走完基础闭环后,不建议盲目泛读各类扩展包,而应根据日常工作中耗费时间最长的重复劳动类型,在以下三大业务场景中选择一条深入攻坚:
方向一:办公文档自动化(Excel、Word、PDF)
该方向是绝大多数职场人投入产出比最高的选择。其输入和输出都是本地结构化文件,不依赖网络连接,运行结果极易排查。
- Excel 处理核心库:
openpyxl
用于操作.xlsx格式工作簿,支持读取多 Sheet 数据、动态修改单元格样式、公式写入以及多表汇总对账。相比重量级的pandas,openpyxl更轻量,保留原生格式的能力更好。 - Word 报告生成库:
python-docx
支持按预设模板批量套打合同、通报材料和分析报告。通过在 Word 模板中预留占位符(如{{customer_name}}),利用代码读取 Excel 中的客户名册后逐个替换并保存为新文档。 - PDF 处理工具库:
pypdf
负责 PDF 的页面提取、多个文档顺序合并、旋转裁剪与批量加盖水印。
from pathlib import Path
import openpyxl

def merge_excel_reports(input_folder: str, output_path: str):
    """
    扫描指定文件夹下所有的 .xlsx 报表,提取首张工作表数据合并为汇总总表
    """
    src_dir = Path(input_folder)
    target_file = Path(output_path)

    # 创建新的汇总工作簿
    summary_wb = openpyxl.Workbook()
    summary_ws = summary_wb.active
    summary_ws.title = "汇总数据"

    header_written = False
    total_rows = 0

    # 遍历该目录下所有的 Excel 文件
    for file_path in src_dir.glob("*.xlsx"):
        # 跳过打开文件时产生的临时锁文件(以 ~$ 开头)
        if file_path.name.startswith("~$"):
            continue

        try:
            wb = openpyxl.load_workbook(file_path, data_only=True)
            ws = wb.active
        except Exception as e:
            print(f"[读取失败] 跳过损坏文件 {file_path.name}: {e}")
            continue

        rows = list(ws.iter_rows(values_only=True))
        if not rows:
            continue

        # 第一行通常为表头,仅写入一次
        if not header_written:
            summary_ws.append(list(rows[0]) + ["来源文件"])
            header_written = True

        # 从第二行开始追加有效数据行
        for row in rows[1:]:
            # 过滤全空行
            if any(cell is not None for cell in row):
                summary_ws.append(list(row) + [file_path.name])
                total_rows += 1

    summary_wb.save(str(target_file))
    print(f"[成功] 已将多表合并至: {target_file},共计汇总 {total_rows} 条记录。")

if __name__ == "__main__":
    # 执行汇总调用示例
merge_excel_reports("./reports", "./summary_output.xlsx")1. openpyxl.load_workbook 默认不会计算公式值。如果希望读取公式计算后的数值而非公式文本,必须传入 data_only=True 参数。
2. 如果目标 Excel 文件正被微软 Excel 软件打开占用,Python 在执行 save() 时会抛出 PermissionError(拒绝访问)。编写代码时必须加入异常提示,提醒用户关闭已打开的文件。
方向二:网页数据采集与浏览器交互自动化
当需要从外部网站周期性获取行情数据、监控竞品信息,或者需要在公司内部门户网站批量录入表单时,需要进入浏览器自动化领域。
- 现代首选工具:
Playwright
相比历史悠久但配置繁琐的Selenium,微软开源的Playwright自带无头浏览器内核,无需手动下载配置对应版本的chromedriver。它具备强大的内置等待机制(Auto-waiting),能自动等待网页 DOM 元素加载渲染完毕再执行点击或输入,极大地减少了因网速波动导致的“找不到元素”异常。 - 接口直接抓取:
requests
在启动繁重的浏览器之前,优先通过浏览器的开发者工具(F12 -> Network)观察页面背后的异步数据请求。如果目标数据直接通过标准的 JSON 接口返回,直接用requests.get()获取数据速度会比渲染整个网页快上几十倍。
方向三:系统任务与定时调度自动化
该方向适用于需要让脚本在后台长期静默运行的场景,例如每天凌晨定时抓取报表并发送邮件、自动备份数据库、监控磁盘空间不足时清理日志等。核心使用的是系统原生调度器(Windows 任务计划程序 / macOS launchd)结合 Python 的 schedule 与 subprocess 模块。
| 场景类别 | 推荐库 | 学习难度 | 适用业务 |
|---|---|---|---|
| 办公文档自动化 | openpyxl, python-docx, pypdf |
★☆☆ | 财务对账、销售统计、格式转换、合同批量套印 |
| 网页采集与交互 | Playwright, requests, BeautifulSoup |
★★☆ | 行情监控、数据同步、表单填报、OA 系统打卡 |
| 系统运维与调度 | pathlib, subprocess, schedule |
★★☆ | 定时备份、日志轮转归档、服务健康探测告警 |
四、进阶实战:从单点脚本到稳定运行的工程化项目
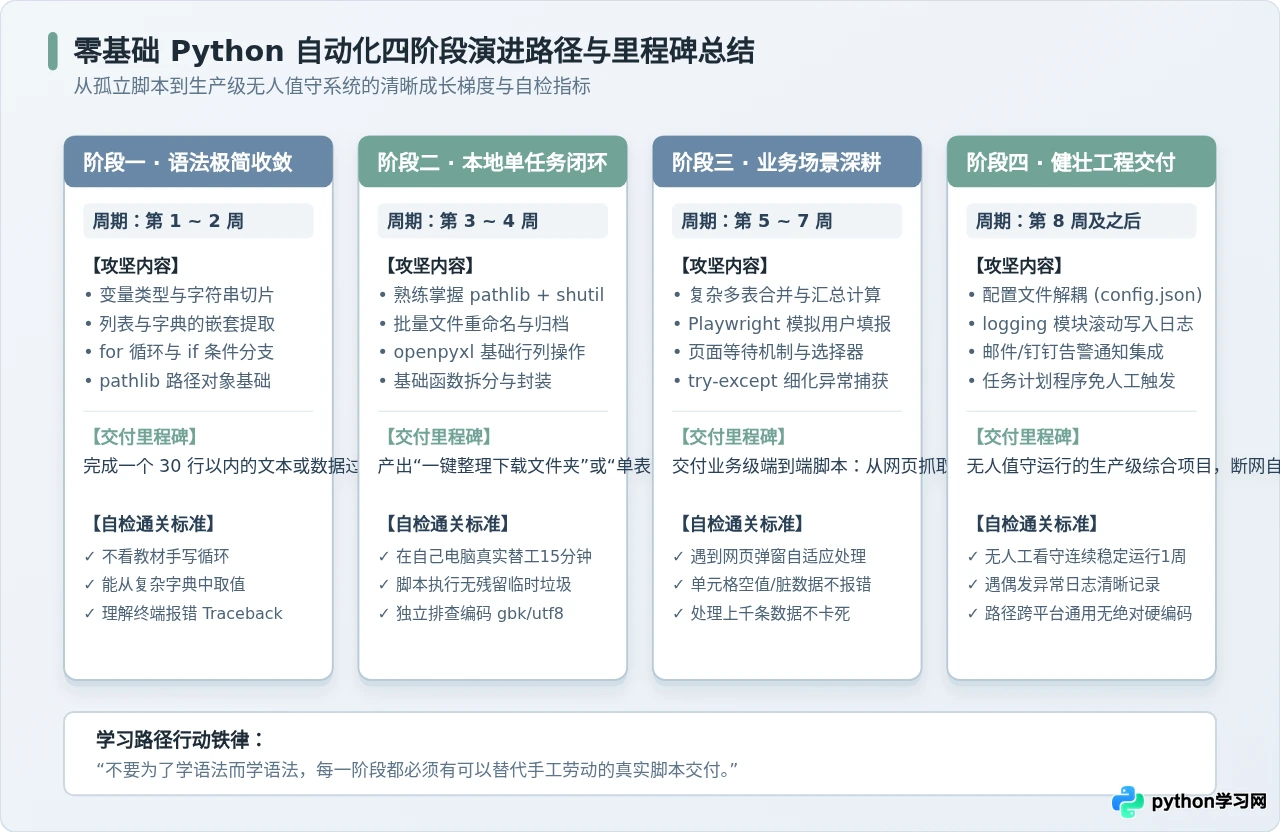
初学者常常困惑:为什么一个在自己电脑终端上运行完美的脚本,配置了定时任务或交给同事使用时,却频繁报错中断?从“玩具级小脚本”跨越到“生产级自动化项目”,核心在于补齐以下四大工程化要素:
1. 参数外部化解耦(禁止硬编码)
绝不要把文件绝对路径、数据库账号、邮箱密码硬编码在代码内部。应将参数提取到外部的 config.json 或环境变量中。即使换一台电脑或目录结构调整,也只需要修改配置文件,无需改动核心逻辑代码。
2. 结构化日志记录(logging 替代 print)
在定时无人值守运行时,终端输出的 print 内容会随终端关闭而丢失。必须使用 Python 内置的 logging 模块,将运行状态、处理文件数以及捕获到的异常堆栈自动按日期写入 run.log 文件,方便事后精准追溯排查。
import logging
from pathlib import Path

def setup_logger(log_dir: str = "logs") -> logging.Logger:
    Path(log_dir).mkdir(exist_ok=True)
    log_file = Path(log_dir) / "automation.log"

    logger = logging.getLogger("AutoTask")
    logger.setLevel(logging.INFO)

    # 避免重复添加 Handler
    if not logger.handlers:
        formatter = logging.Formatter(
            "[%(asctime)s] [%(levelname)s] %(message)s",
            datefmt="%Y-%m-%d %H:%M:%S"
        )
        file_handler = logging.FileHandler(str(log_file), encoding="utf-8")
        file_handler.setFormatter(formatter)
        logger.addHandler(file_handler)

        console_handler = logging.StreamHandler()
        console_handler.setFormatter(formatter)
        logger.addHandler(console_handler)

    return logger
3. 容错隔离与失败保护
外部环境(网络断开、服务器响应超时、文件锁死)往往不可控。在核心循环中,必须对单次处理实施保护,确保某一条脏数据或网络瞬断不会导致整个大批次任务夭折:
for task_item in task_queue:
    try:
        process_single_item(task_item)
    except Exception as err:
        logger.error(f"处理任务项 {task_item} 时出现异常: {err}", exc_info=True)
        # 记录失败项至失败列表,继续执行下一项
        failed_tasks.append(task_item)
        continue
4. 系统原生定时触发(免人工干预)
实现无人值守的最佳方案,是使用操作系统底层的定时调度工具,在调用 Python 脚本时传入完整的解释器绝对路径与脚本绝对路径:
- Windows 系统:使用“任务计划程序”(Task Scheduler),创建基本任务,操作选择“启动程序”。程序输入虚拟环境内的
C:\...\.venv\Scripts\python.exe,参数填入main.py,起始于填入工程根目录。 - macOS / Linux 系统:使用
crontab -e配置定时执行规则(例如0 9 * * 1-5 /path/to/.venv/bin/python /path/to/main.py)。
五、零基础初学者的常见误区与避坑建议
在按照上述路径推进的过程中,提前规避以下三个高频踩坑点,能够节省大量无意义的调试时间:
- 误区一:混淆开发目的,陷入大型 Web 框架。
很多初学者学完基础语法后,被网上的各类教程带偏,去学习 Django、Flask、Vue 等网页开发技术。自动化的目标是“减负增效”,属于脚本编写范畴,过早接触复杂的 Web 框架和数据库 ORM 会增加不必要的心智负担。 - 误区二:盲目复制网络代码,忽视运行环境差异。
网上的示例往往假定固定的系统环境与路径(例如写死C:\Users\Administrator\...)。在引用任何外部代码时,必须先理清数据流向,将路径统一替换为当前工程内的Path(__file__).parent相对定位方式。 - 误区三:忽视跨平台编码格式导致中文字符乱码。
在 Windows 系统下读写文本文件时,系统默认编码常为GBK,而在网络传输与现代编辑器中通常为UTF-8。在调用open()或导出 CSV 时,务必显式指定encoding="utf-8"(导出 Excel 可识别的 CSV 时可使用encoding="utf-8-sig"),从根本上避免乱码。
规划学习路线的最终目的在于落地。建议在接下来的两周内,首先梳理出自己工作流程中耗时超过 20 分钟的 1~2 项重复工作(如多表数据比对、日常文件归类或格式转换),将其作为阶段二与阶段三的专属实战靶场。带着具体目标写代码,是掌握 Python 自动化最高效的捷径。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















