


Python列表排序方法:sort()与sorted()的区别及使用场景
全面解析Python中列表排序方法sort()与内置函数sorted()的核心区别、底层原理、参数用法及在实际开发中的典型适用场景。
list.sort(),或者使用内置全局函数 sorted()。两者的核心差异在于是否修改原始对象以及是否有返回值。sort() 在原列表上就地排序,无返回值;sorted() 则保留原始输入,创建并返回一个全新的已排序列表。
一、核心机制:就地修改与返回新列表
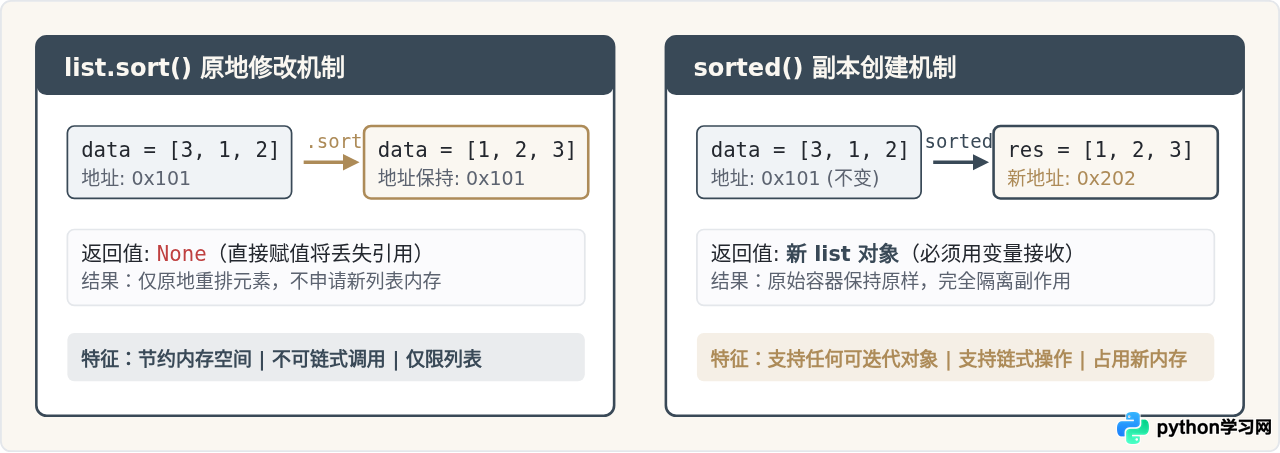
为了直观理解 sort() 与 sorted() 在运行机制上的分野,我们需要观察变量在排序前后的内存标识与内容变化。两者的设计初衷不同,直接决定了它们在内存管理与数据安全性上的取舍。
1. list.sort() 原地修改
sort() 是 Python 列表对象(list)专属的方法。调用它时,解释器直接在当前列表所在的内存空间内部重新排布指针。因为操作直接生效于原列表,所以该方法不返回任何值(即返回 None)。
# 示例:list.sort() 的就地排序特性
raw_scores = [88, 56, 92, 73]
res = raw_scores.sort()

print("返回值 res:", res)
print("原始列表 raw_scores:", raw_scores)返回值 res: None
原始列表 raw_scores: [56, 73, 88, 92]
my_list = my_list.sort() 这样的赋值语句。由于 sort() 返回 None,这会导致原列表丢失,变量 my_list 被赋予 NoneType。
2. sorted() 生成新列表
sorted() 是 Python 提供的内置全局函数,可以接受任何可迭代对象(列表、元组、字典、集合、生成器等)。它在读取输入数据后,开辟一块新的连续内存,构建并返回一个排序好的新列表,原来的输入容器完全不受影响。
# 示例:sorted() 产生新列表且不破坏原数据
raw_scores = [88, 56, 92, 73]
sorted_scores = sorted(raw_scores)

print("原始列表 raw_scores:", raw_scores)
print("排序结果 sorted_scores:", sorted_scores)
print("两者是否为同一对象:", raw_scores is sorted_scores)原始列表 raw_scores: [88, 56, 92, 73]
排序结果 sorted_scores: [56, 73, 88, 92]
两者是否为同一对象: False
二、支持的数据类型差异
两者第二项根本区别在于接受的目标数据类型。sort() 仅绑定在列表类型上;而 sorted() 具备通用性,任何遵守迭代器协议的对象均可传入。
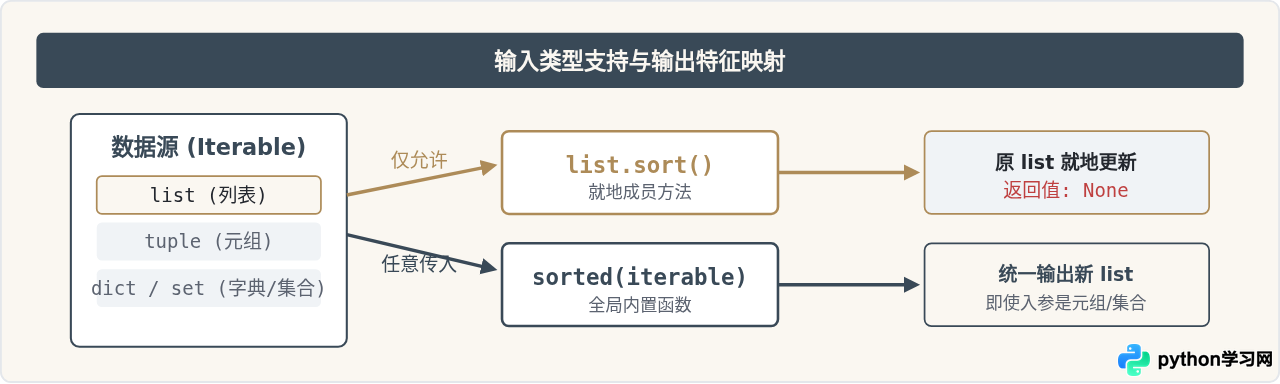
对非列表容器调用 sort() 会触发 AttributeError。如果想对不可变容器(例如元组)或无序容器(例如集合、字典)做排序,必须使用 sorted():
# 示例:使用 sorted() 处理非列表类型
tuple_data = (40, 10, 30, 20)
sorted_tuple_res = sorted(tuple_data)

dict_data = {"cherry": 3, "apple": 8, "banana": 2}
sorted_dict_keys = sorted(dict_data)

print("元组排序结果(类型为列表):", sorted_tuple_res)
print("字典默认对键排序结果:", sorted_dict_keys)元组排序结果(类型为列表): [10, 20, 30, 40]
字典默认对键排序结果: ['apple', 'banana', 'cherry']
三、核心参数解析:key 与 reverse 的实际配置
无论 list.sort() 还是 sorted(),两者接受的核心控制参数是完全一致的,都包含 key 和 reverse:
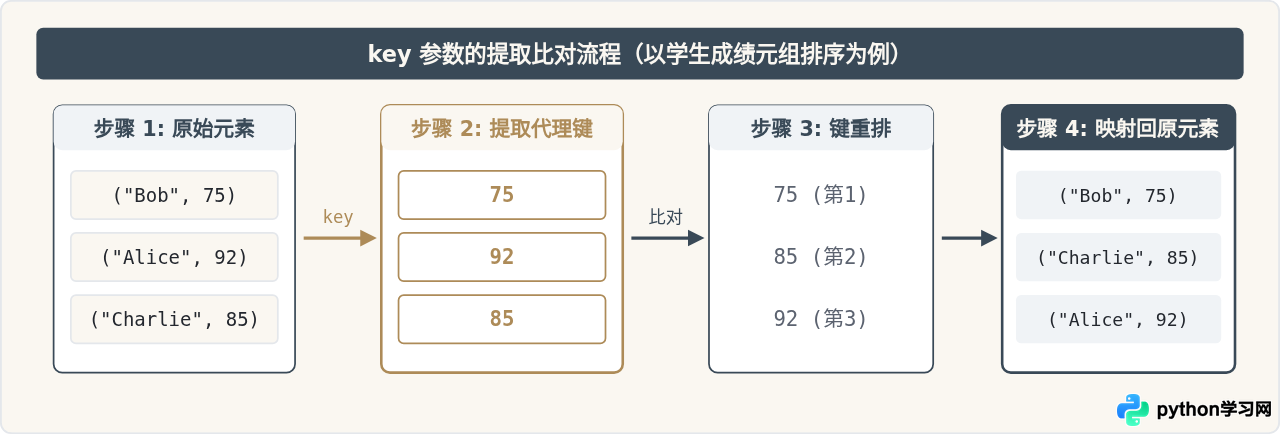
key:接收一个单参数可调用函数。该函数在每个元素参与排序比对前被调用,返回用于比较的“代理键”。reverse:布尔值,默认是False(升序),设置为True时表示降序。
复杂结构排序示例
面对嵌套字典或复杂对象列表时,通过 lambda 函数指定 key 是一种常见做法:
students = [
    {"name": "Bob", "score": 75},
    {"name": "Alice", "score": 92},
    {"name": "Charlie", "score": 85}
]

# 按分数降序排列,且不破坏原 students 列表
ranked_students = sorted(students, key=lambda s: s["score"], reverse=True)

print("排序后的新列表:")
for item in ranked_students:
print(" ", item)排序后的新列表:
{'name': 'Alice', 'score': 92}
{'name': 'Charlie', 'score': 85}
{'name': 'Bob', 'score': 75}
四、特性与维度对比
为了在开发时快速决策,以下将从调用形式、内存开销、返回值、类型限制等关键维度对二者进行并列对比:
| 比较维度 | list.sort() | sorted() |
|---|---|---|
| 语法与形态 | 列表对象方法:my_list.sort() |
内置全局函数:sorted(iterable) |
| 原始容器影响 | 修改(直接重排内存中的引用) | 完全不修改(只读访问) |
| 返回值 | 总是返回 None |
始终返回全新的 list |
| 支持类型 | 严格仅限 list 类型 |
支持所有可迭代对象(tuple、dict、set等) |
| 额外内存消耗 | $O(1)$,无需新建对象容器 | $O(n)$,需分配新列表空间 |
| 底层算法与稳定性 | Timsort,具备排序稳定性 | Timsort,具备排序稳定性 |
| 链式调用支持 | 不支持(因返回值为 None) | 支持(可紧跟 [:3] 或进一步处理) |
五、实际开发中的选型路径与使用场景
在实际代码实现中,应该基于内存容积要求、原始数据保留需求以及流式处理习惯三项条件来决定采用哪种方法。
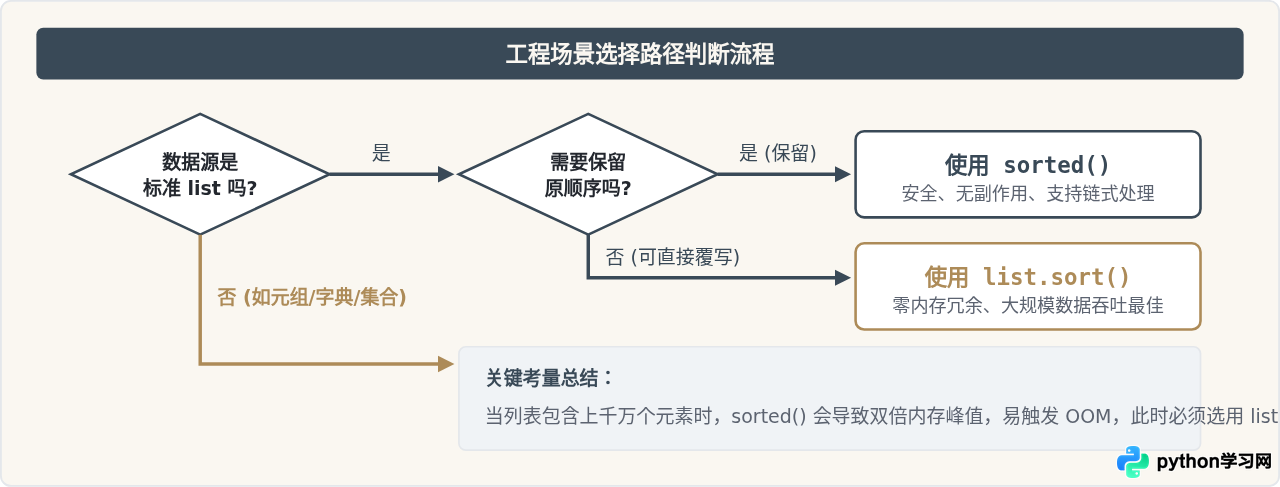
场景 1:优先选用 list.sort() 的情况
-
海量数据与内存敏感场景:
当列表数据量达到数百万级甚至更高时,如果复制一个副本,系统的内存峰值会成倍增加,极易触发操作系统的虚拟内存交换甚至导致内存溢出(OOM)。此时使用
list.sort()是更可控的做法。 -
对象内部状态维护:
在封装面向对象的类(Class)时,类的方法内部往往需要维护一个私有列表属性(如
self._records)。在更新内部状态时,直接在原地执行self._records.sort()既直观又无需重新绑定成员变量。
场景 2:优先选用 sorted() 的情况
-
保护原始输入数据:
在对外提供公共函数或服务接口时,如果函数接收调用方传来的列表,直接调用
list.sort()会无声无息地打乱调用方的原始数据结构,这属于非预期的代码副作用(Side Effect)。使用sorted()可以在完全不触碰原数据的前提下产出新结果。 -
非列表可迭代容器排序:
需要对只读的元组、或者无序的字典键/值进行排序时,
sorted()是唯一直接可行的方案。 -
链式调用与即时切片:
sorted()直接返回列表对象,允许开发者紧接着调用切片或其他函数。例如获取得分最高的前三名:# 链式切片取前三名 top_three = sorted([45, 98, 12, 67, 89], reverse=True)[:3] print("前三名成绩:", top_three)示例输出:若采用
前三名成绩: [98, 89, 67]sort(),则必须先在独立行完成排序,再在下一行执行切片。
掌握两者的区别后,在编码时可遵循一条简单规则:需要保留原序列或需对非列表容器排序时用 sorted();处理大规模列表且只需最终排序结果时用 list.sort()。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















