


Python遍历字典键和值的三种常用写法
详细解析Python中同时或分别遍历字典键与值的3种核心写法:items()解包、遍历键索引取值以及同时使用keys()与values()的适用场景与性能对比。
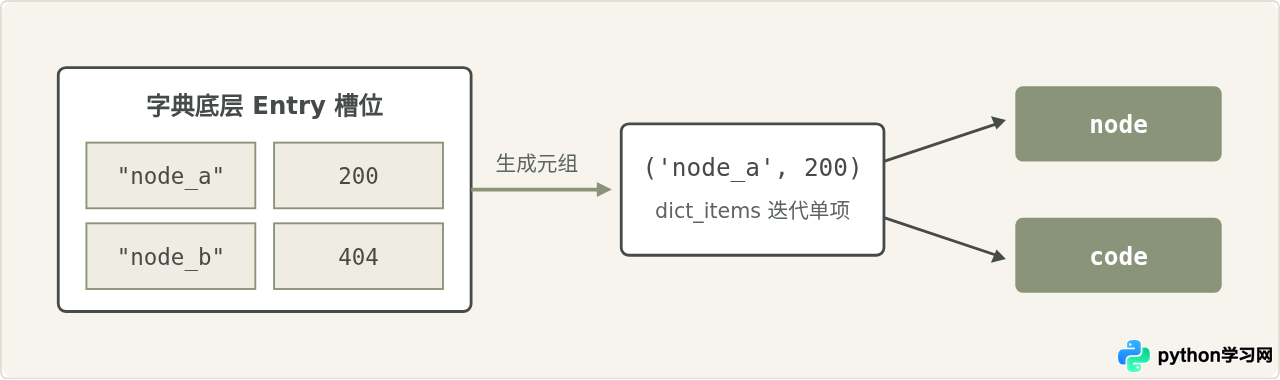
在 Python 中遍历字典时,通常需要同时读取键(Key)和它对应的值(Value)。最地道且推荐的做法是使用 dict.items() 配合元组解包;此外,还可以通过直接遍历键并在循环体内进行索引查值;在某些只读场景下,也可以用 zip(dict.keys(), dict.values()) 捆绑访问。本文结合实际代码、原理推导与流程图,逐一拆解这三种常用写法的语法细节、运行机制与边界禁忌。
准备演示数据
为了让后续代码更加直观,我们在文章中使用一个统一的字典作为操作对象。它记录了不同服务器节点的状态码与描述:
# 演示所用的标准字典
server_status = {
    "node_a": 200,
    "node_b": 404,
    "node_c": 500,
    "node_d": 502
}
写法一:利用 dict.items() 元组解包(推荐写法)
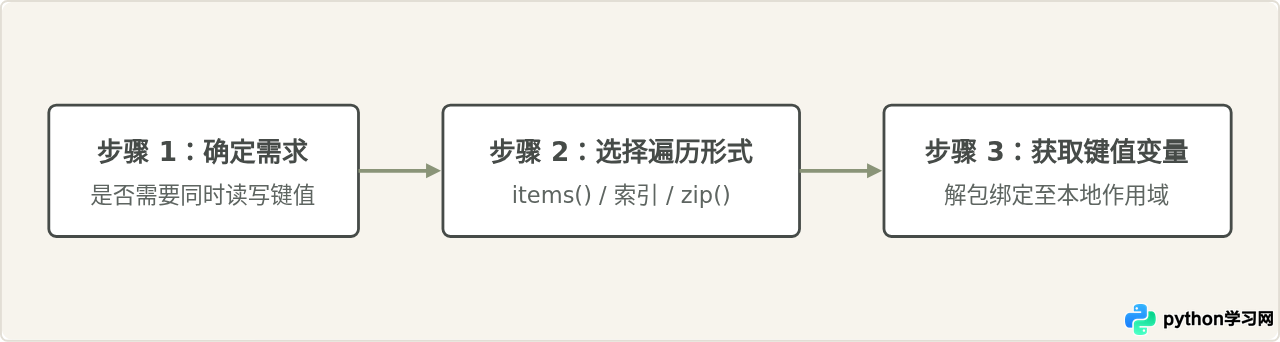
这是 Python 社区公认最简洁、执行效率最高、可读性最好的标准写法。调用字典的 items() 方法会返回一个视图对象(dict_items),该对象在每次迭代时产出一个包含 (key, value) 的双元组。通过在 for 语句中使用两个变量接收,Python 运行时会自动完成元组解包。
# 写法一:items() 配合解包
for node, code in server_status.items():
print(f"节点 [{node}] 返回状态码: {code}")节点 [node_b] 返回状态码: 404
节点 [node_c] 返回状态码: 500
节点 [node_d] 返回状态码: 502
为什么这种写法最优?在底层 CPython 实现中,字典内部使用紧凑哈希表存储键和值。items() 产生的视图迭代器可以直接遍历这些连续条目,一次性取出指向键和值的指针,不需要在每次循环时重新计算哈希值或做多余的哈希查找。
写法二:遍历键并在循环体中索引取值
这种写法是初学者经常使用的逻辑:先直接迭代字典本身(或者调用 dict.keys())取出所有的键,然后在循环体内部使用 dict[key] 来查询对应的值。
# 写法二:直接遍历键并索引查值
for node in server_status:
    code = server_status[node]
print(f"节点 [{node}] 返回状态码: {code}")节点 [node_b] 返回状态码: 404
节点 [node_c] 返回状态码: 500
节点 [node_d] 返回状态码: 502
这种写法完全正确且能达到目的,但在性能逻辑上多了一步。由于字典是通过哈希表实现的,执行 server_status[node] 时,解释器必须重新对 node 对象计算哈希、寻找哈希槽,最后定位到内存块。虽然哈希查找在平均情况下的复杂度是 $O(1)$,但相比于 items() 直接自底向上读指针,它多做了一次哈希探测和函数调用开销。当字典包含数十万条数据时,耗时通常比 items() 慢 20% 到 35% 左右。
写法三:利用 zip 捆绑 keys() 与 values()
第三种做法是使用 Python 内建的 zip() 函数,将 server_status.keys() 和 server_status.values() 两组视图绑定在一起协同推进。
# 写法三:使用 zip 组合 keys 与 values
for node, code in zip(server_status.keys(), server_status.values()):
print(f"节点 [{node}] 返回状态码: {code}")节点 [node_b] 返回状态码: 404
节点 [node_c] 返回状态码: 500
节点 [node_d] 返回状态码: 502
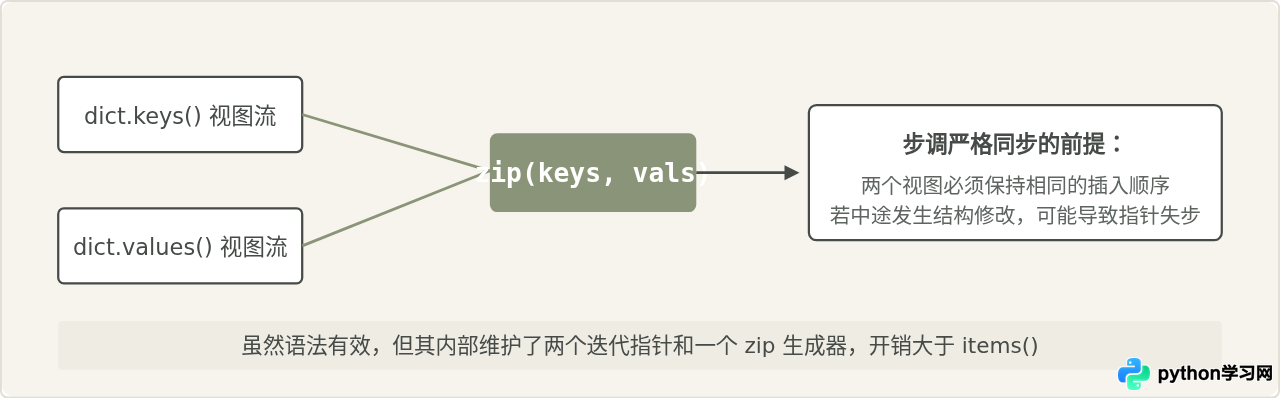
这种写法之所以能正常工作,是因为从 Python 3.7 开始,官方规范明确保证了字典保持插入顺序(Insertion Order)。因此 keys() 与 values() 返回的视图在遍历时的序列必然一一对应。
但是,这种写法并不推荐在常规业务代码中作为第一选择。它同时创建了两个视图迭代器和一个 zip 包装器,不仅增加了运行时的对象追踪负担,而且在代码语义上也不如 items() 那样直观。
容易混淆的说法辨析
辨析一:“使用 dict[key] 取值一定比 items() 慢”
这种说法在单纯读取时是成立的。但如果业务逻辑是“在循环体中根据条件动态更新字典的值”,情况就会有所变化。通过 items() 解包出来的 code 只是当前值的引用(对于不可变对象如整数、字符串,修改局部变量不会影响字典本身)。若需要就地修改字典中的值,开发者依旧需要通过 dict[key] = new_value 来赋值。因此,如果循环的主要目的是写回原字典,直接遍历键是完全合理的做法。
辨析二:“Python 2 中的 items() 会复制整个列表”
很多老旧教程会提到“避免使用 items(),要改用 iteritems(),否则会在内存中拷贝一份庞大的列表”。这个说法在 Python 2 时代确实正确,但在现代 Python(Python 3.x)中已经失效。在 Python 3 中,dict.items() 默认返回的是一个不分配额外列表空间的轻量级视图对象(View Object),与 Python 2 的 iteritems() 机制一致。老旧的 iteritems() 方法早已被彻底移除。
遍历过程中的常见问题与注意事项
无论采用上述哪种写法,都严禁在循环体内部直接增加(
dict[new_key] = val)或删除(del dict[key] / dict.pop(key))键。否则 Python 运行时会立刻抛出异常:RuntimeError: dictionary changed size during iteration。
如果业务确实需要在遍历的同时剔除某些条目,正确的做法是先将要遍历的键复制为一个固定的列表,或者构建一个新字典:
# 错误的做法:直接在循环体中 pop
# for node, code in server_status.items():
#     if code >= 500:
#         server_status.pop(node)  # 抛出 RuntimeError

# 正确做法 A:基于 list 浅拷贝 keys 进行安全删除
for node in list(server_status.keys()):
    if server_status[node] >= 500:
        server_status.pop(node)

# 正确做法 B:使用字典推导式直接生成过滤后的新字典(更优雅)
cleaned_status = {k: v for k, v in server_status.items() if v < 500}
三种遍历写法的选择依据
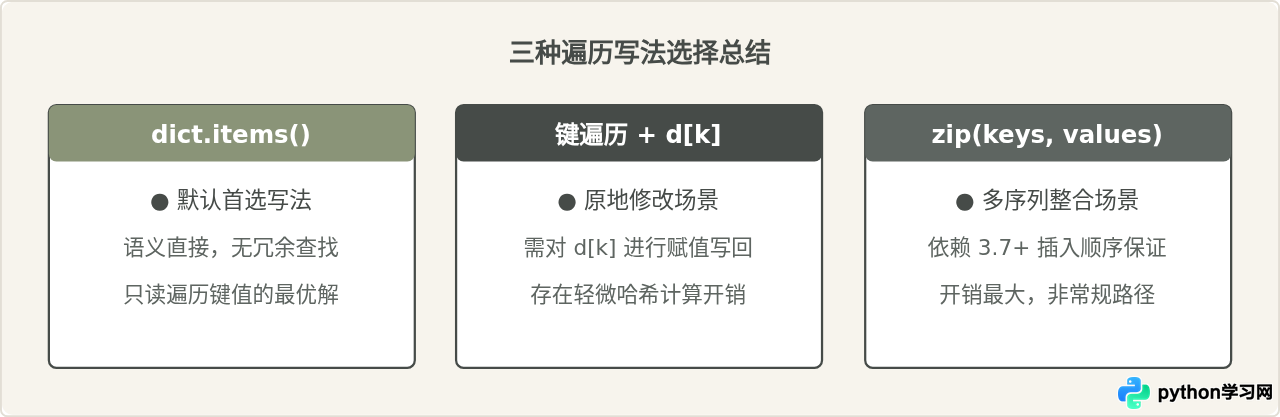
根据实际开发场景,可以参照下表做出选择:
| 遍历写法 | 典型语法 | 底层性能 | 适用场景 |
|---|---|---|---|
| items() 解包 | for k, v in d.items(): |
最高(直接读指针) | 只读访问键和值,95% 以上的标准业务逻辑推荐此写法。 |
| 键索引取值 | for k in d: v = d[k] |
中等(含二次哈希查找) | 需要在遍历过程中动态就地修改键对应的值,或者只在少数条件下才需要读值。 |
| zip 协同 | for k, v in zip(d.keys(), d.values()): |
较低(多重迭代器封装) | 特定函数签名兼容,或需要截断不同长度数据(如结合其他外部列表)时。 |
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















