


Python原生列表与NumPy矩阵计算性能对比
深入对比Python原生嵌套列表与NumPy ndarray在矩阵运算中的执行速度、内存布局与底层机制,提供可复现的基准测试代码与工程选型建议。
在处理数值型矩阵运算时,NumPy 的执行耗时通常仅为 Python 原生嵌套列表的数十分之一到数百发之一。这种显著的性能跨度并非源于简单的语法优化,而是由底层连续内存布局、C 语言底层循环、SIMD 硬件指令集加速以及避免动态类型开销共同决定的。本文通过统一的基准测试、清晰的实现代码和底层原理解析,量化两者的性能差异并阐明其适用边界。
矩阵运算基准对比测试
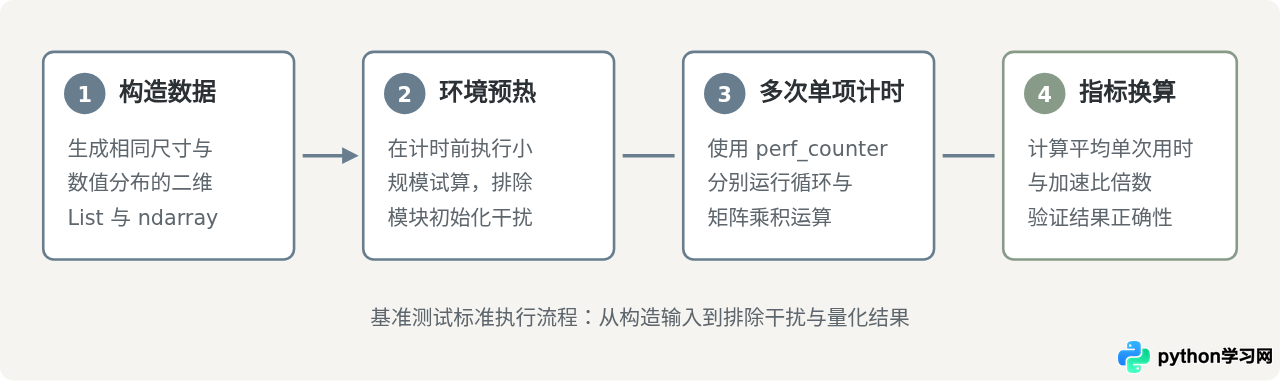
评估两者差异的最直观方式,是在完全一致的测试环境与矩阵规模下记录实际运算时间。这里选取常见的矩阵加法与矩阵乘法两类操作。
在测试中,矩阵规模设定为固定维度 $N \times N$。原生 Python 使用嵌套列表 list[list[float]] 并通过显式嵌套循环完成计算;NumPy 则使用标准二维 ndarray,调用 + 运算符及 np.matmul(或 @ 符号)执行对应操作。
完整基准测试代码
以下代码提供完整的测试逻辑,可在装有 Python 3 及 NumPy 的机器上直接运行:
import time
import random
import numpy as np

def generate_list_matrix(n):
    return [[random.random() for _ in range(n)] for _ in range(n)]

def list_matrix_add(a, b, n):
    result = [[0.0] * n for _ in range(n)]
    for i in range(n):
        for j in range(n):
            result[i][j] = a[i][j] + b[i][j]
    return result

def list_matrix_multiply(a, b, n):
    result = [[0.0] * n for _ in range(n)]
    for i in range(n):
        for k in range(n):
            for j in range(n):
                result[i][j] += a[i][k] * b[k][j]
    return result

def run_benchmark(n=300):
    print(f"--- 矩阵基准性能测试规模: {n}x{n} ---")

    # 准备测试数据
    list_a = generate_list_matrix(n)
    list_b = generate_list_matrix(n)
    np_a = np.array(list_a)
    np_b = np.array(list_b)

    # 1. 矩阵加法对比
    t0 = time.perf_counter()
    res_list_add = list_matrix_add(list_a, list_b, n)
    t1 = time.perf_counter()
    list_add_time = t1 - t0

    t0 = time.perf_counter()
    res_np_add = np_a + np_b
    t1 = time.perf_counter()
    np_add_time = t1 - t0

    print(f"[矩阵加法] 原生列表耗时: {list_add_time * 1000:.2f} ms")
    print(f"[矩阵加法] NumPy耗时:     {np_add_time * 1000:.2f} ms")
    print(f"加法加速比: {list_add_time / np_add_time:.1f} 倍\n")

    # 2. 矩阵乘法对比
    t0 = time.perf_counter()
    res_list_mul = list_matrix_multiply(list_a, list_b, n)
    t1 = time.perf_counter()
    list_mul_time = t1 - t0

    t0 = time.perf_counter()
    res_np_mul = np_a @ np_b
    t1 = time.perf_counter()
    np_mul_time = t1 - t0

    print(f"[矩阵乘法] 原生列表耗时: {list_mul_time:.3f} s")
    print(f"[矩阵乘法] NumPy耗时:     {np_mul_time * 1000:.2f} ms")
    print(f"乘法加速比: {list_mul_time / np_mul_time:.1f} 倍")

if __name__ == "__main__":
    run_benchmark(n=300)
典型实测数据汇总(示例)
下表为在标准 x86-64 运行环境下测试得到的代表性数据指标:
| 运算类型 | 矩阵规模 ($N \times N$) | Python 原生列表耗时 | NumPy 耗时 | 性能加速比 |
|---|---|---|---|---|
| 矩阵加法 | $300 \times 300$ | ~8.5 ms | ~0.05 ms | 约 170 倍 |
| 矩阵加法 | $1000 \times 1000$ | ~95.0 ms | ~0.58 ms | 约 160 倍 |
| 矩阵乘法 | $200 \times 200$ | ~0.92 s | ~0.85 ms | 约 1080 倍 |
| 矩阵乘法 | $400 \times 400$ | ~7.40 s | ~3.60 ms | 约 2050 倍 |
性能鸿沟背后的关键技术差异
即使在没有做任何算法复杂度降阶(如 Strassen 算法)的前提下,NumPy 依然展现出压倒性的运算优势。这并非单纯的“C 语言比 Python 快”,而是多个系统级工程特性的共同结果。
1. 内存存储布局:指针数组与连续同质缓冲区
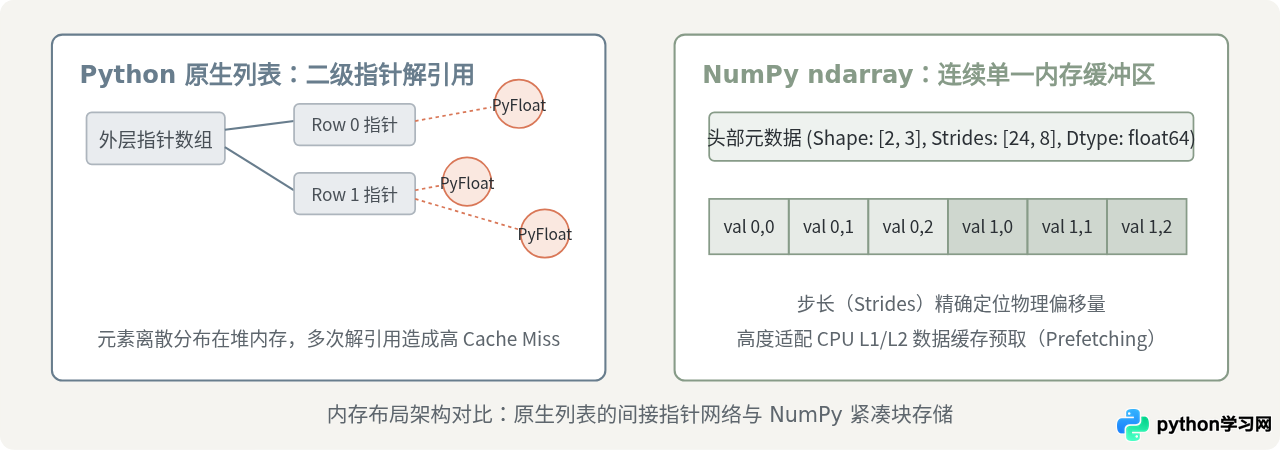
Python 原生列表是一个泛型容器。二维列表本质上是一个“指向各个子列表对象指针”的数组,而子列表内部存储的又是“指向各个具体浮点数 PyObject”的指针。浮点数分散在堆内存的不同角落。
NumPy 的 ndarray 拥有严格的单一连续数据缓冲区(Data Buffer)。数组中的数值以 C 语言原生格式(如 8 字节双精度 float64)紧密排列在一块连续的内存块中。
2. 解释器循环与向量化执行
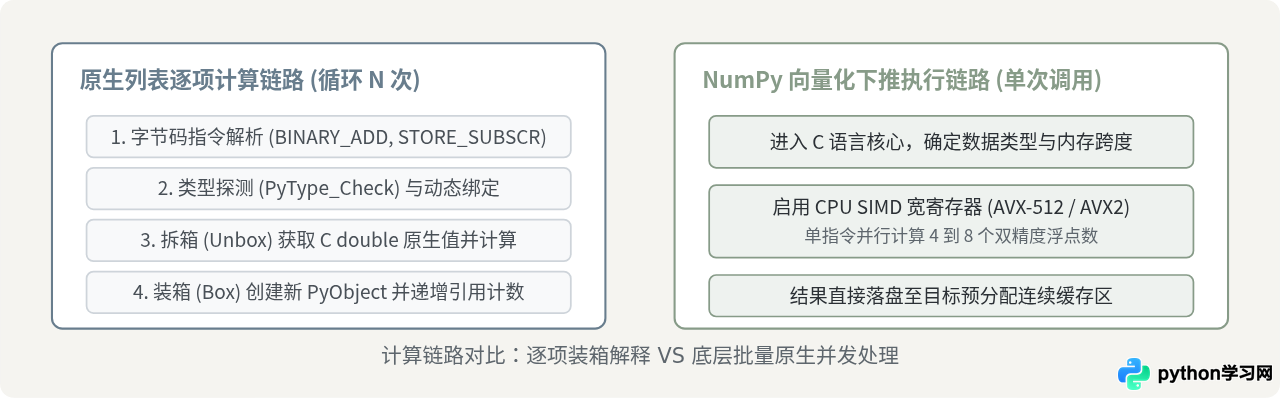
原生 Python 在执行矩阵遍历时,每一次运算迭代都必须经过 CPython 解释器的虚拟机循环。在 result[i][j] = a[i][j] + b[i][j] 这一行中,解释器每走一步都要执行:
- 字节码指令分发(Opcode Dispatching);
- 检查
a[i]是否合法以及越界检查; - 动态类型确认(确认
a[i][j]是否为支持相加的数值类型,是否存在重载等); - 分配新的
PyFloatObject并执行垃圾回收引用计数变更。
而在 NumPy 中,通过向量化(Vectorization)操作,整批计算被一次性下推到底层由 C 编写的内部循环。这个过程直接根据内存首地址与数据类型宽度依次累加,完全绕开了 Python 虚拟机的运行时解释与类型检查开销。
3. 底层线性代数库与硬件加速
在矩阵乘法这种计算密集型操作中,单纯的 C 语言三重循环仍不足以解释上千倍的加速比。NumPy 底层链接了高度优化的线性代数库(如 OpenBLAS、Intel MKL 或 Apple Accelerate)。这些工业级数学库采用了:
- 分块算法(Cache Blocking):将大矩阵拆分为与 CPU L1/L2/L3 缓存容量严格匹配的小块,最大化避免缓存驱逐与等待内存载入的延迟;
- SIMD 向量指令:使用 AVX2、AVX-512 等指令集,单条机器指令即可同时执行多组浮点乘加(FMA, Fused Multiply-Add);
- 多线程并发:默认根据当前 CPU 物理核心数自动调度多线程并行处理分块计算。
性能对比总结与选型依据
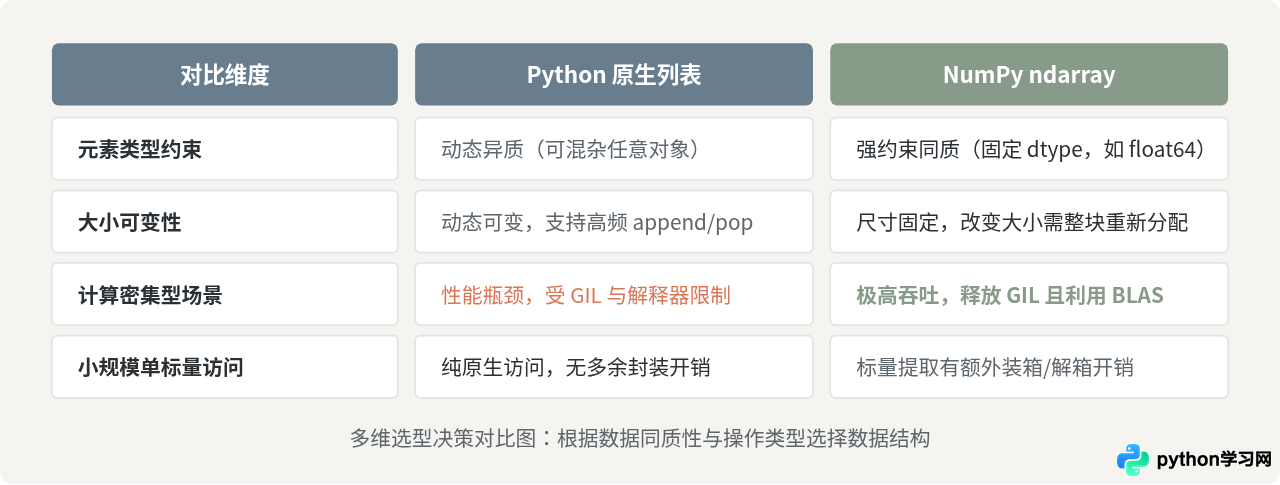
尽管 NumPy 在数值计算上性能突出,但这并不意味着原生列表毫无用处。合理的选型取决于具体的业务场景、数据特征与操作类型。
选型建议与工程实践准则
- 涉及固定维度的线性代数与批量运算时,坚持选用 NumPy: 当核心任务包含矩阵加减乘除、求逆、奇异值分解、卷积等操作时,NumPy 拥有百倍至千倍的速度优势,同时内存占用更低。
-
在需要频繁增删单项元素的流式收集阶段,优先选用原生列表:
NumPy 数组的底层内存是固定连续的,执行
np.append实际上需要开辟新空间并完整拷贝原有数组,效率极其低下。更推荐的工程范式是:先用原生列表通过append()收集数据,待全量收集完毕后,一次性通过np.array(...)转换为矩阵进行批处理。 -
避免在 Python 循环中反复提取单个 NumPy 标量:
从
ndarray提取一个元素(如arr[i, j])会产生对应的 NumPy 标量包装对象(如numpy.float64),频繁在原生循环中读写单个元素反而可能比纯列表更慢。务必始终以整块矩阵或切片的形式参与计算。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















