


Python列表排序:sort方法与sorted函数的区别及使用
深入对比Python中list.sort()方法与内置sorted()函数的核心差异,详解原地修改、返回值、适用对象及高阶排序参数的使用方法与常见错误。
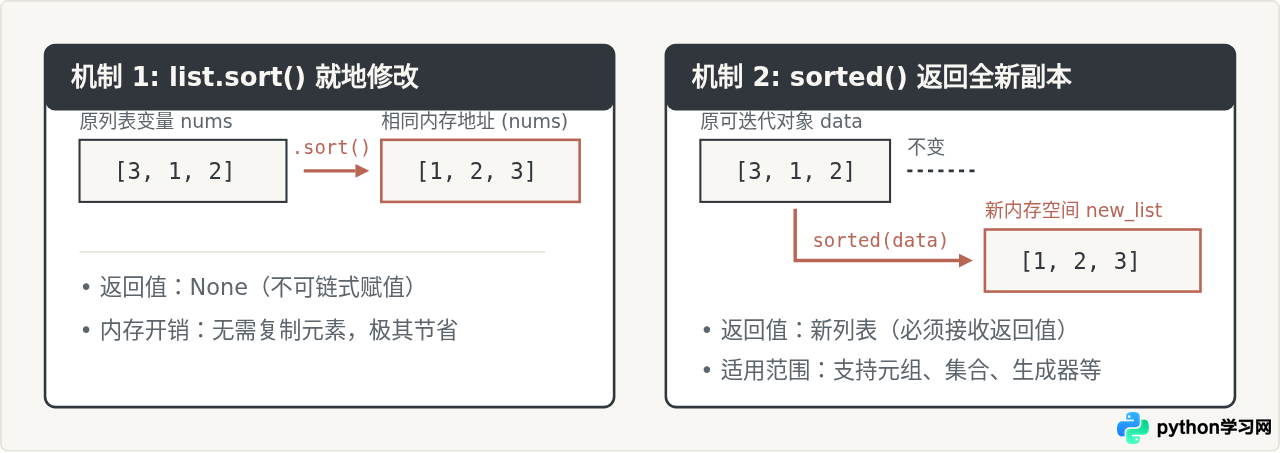
对列表数据进行排序是Python日常编程中最基础也最高频的操作之一。Python为此提供了两种主要手段:列表自有的list.sort()方法与内置全局函数sorted()。两者的核心区别在于:list.sort()是“就地排序”,直接修改原列表且返回None;而sorted()是“外部排序”,不改变输入数据,始终生成并返回一个新的已排好序的列表。理解这两种机制的工作差异与内存行为,是在实际开发中写出安全、高效代码的前提。
核心区别概览与内存机制
判断何时使用sort()或sorted(),需要明确两者的四个关键维度:调用方式、适用数据类型、对原数据的影响以及返回值。
| 比较维度 | list.sort() 方法 | sorted() 内置函数 |
|---|---|---|
| 语法形式 | list_obj.sort(...) |
sorted(iterable, ...) |
| 支持对象 | 仅支持列表(list)类型 | 任意可迭代对象(元组、字典、集合、字符串等) |
| 原对象影响 | 就地修改(In-place),原列表顺序被改变 | 无副作用,原对象内容与顺序保持不变 |
| 返回值 | 始终返回 None |
返回一个全新的已排序 list |
| 额外内存消耗 | 极低(在原列表分配的空间内重排指针) | 需要额外内存构建新列表(长度与原数据相当) |
在底层实现中,两者均基于Python自研且高效的Timsort算法(一种结合了归并排序与插入排序的稳定排序算法)。两者的性能差异主要源自内存分配:list.sort()直接在原列表底层的指针数组上重构元素引用,不需要申请新的列表头部和元素缓冲区;而sorted()必须先遍历传入的可迭代对象,开辟一块新的堆内存创建列表,再执行排序。
具体使用方法与语法规范
两个排序工具的参数列表完全一致,都支持两个可选关键字参数:key 和 reverse。但在具体调用上存在差异。
1. list.sort() 的基本操作
调用语法为 list.sort(*, key=None, reverse=False)。由于该方法属于列表专属方法,只能由列表对象来调用。
# 示例:就地升序与降序排序
numbers = [42, 12, 88, 5, 27]

# 默认从小到大升序
numbers.sort()
print(numbers)
# 示例输出: [5, 12, 27, 42, 88]

# 设置 reverse=True 实现降序
numbers.sort(reverse=True)
print(numbers)
# 示例输出: [88, 42, 27, 12, 5]初学者最易犯错的陷阱:res = numbers.sort() 会将 res 赋值为 None。切勿将 sort() 的调用结果赋给变量或作为链式调用的中间步骤。
2. sorted() 的基本操作
调用语法为 sorted(iterable, /, *, key=None, reverse=False)。第一个参数接收任意可迭代对象,并始终返回排序后的新列表。
# 示例 1:对不可变对象(元组)排序并返回列表
origin_tuple = (50, 10, 30, 20)
sorted_list = sorted(origin_tuple)
print("原元组:", origin_tuple)
print("返回的新列表:", sorted_list)
# 示例输出:
# 原元组: (50, 10, 30, 20)
# 返回的新列表: [10, 20, 30, 50]

# 示例 2:对字符串进行字典序重排
chars = sorted("python")
print(chars)
# 示例输出: ['h', 'n', 'o', 'p', 't', 'y']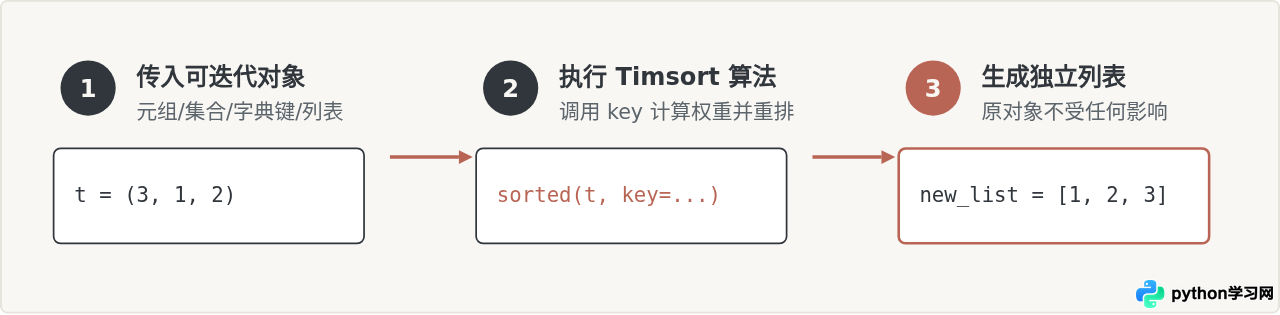
高阶进阶:使用 key 参数进行自定义排序
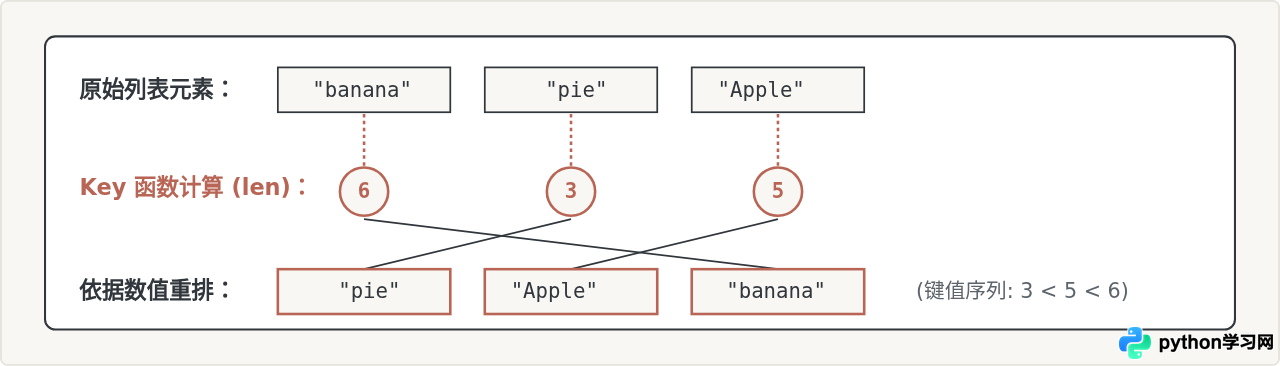
key 参数接收一个函数,这个函数只接收一个参数,并返回一个用于比较的“排序键”。在排序开始前,Python会为列表中每个元素提取一次键值,后续严格按照该键值大小进行比较。该参数在两个排序工具中的机制完全一致。
场景 1:按元素属性或计算值排序
如果想按照字符串长度、绝对值大小或忽略大小写进行排序,直接将内置函数赋给 key 即可:
words = ["banana", "pie", "Apple", "strawberry"]

# 忽略字母大小写的字典序
sorted_words = sorted(words, key=str.lower)
print(sorted_words)
# 示例输出: ['Apple', 'banana', 'pie', 'strawberry']

# 按照字符串长度排序
words.sort(key=len)
print(words)
# 示例输出: ['pie', 'Apple', 'banana', 'strawberry']
场景 2:对字典列表与复合对象进行排序
针对复杂数据结构(如包含多字段字典的列表),可以通过 lambda 表达式或 operator.itemgetter 指定排序字段:
students = [
    {"name": "Alice", "score": 88, "age": 20},
    {"name": "Bob", "score": 95, "age": 19},
    {"name": "Charlie", "score": 88, "age": 18}
]

# 按照单字段 score 降序排列
sorted_by_score = sorted(students, key=lambda x: x["score"], reverse=True)

# 多级排序:先按 score 降序,若分数相同则按 age 升序
# 利用元组比较特性:(-x["score"], x["age"])
students.sort(key=lambda x: (-x["score"], x["age"]))
print(students)
# 示例输出:
# [
#   {'name': 'Bob', 'score': 95, 'age': 19},
#   {'name': 'Charlie', 'score': 88, 'age': 18},
#   {'name': 'Alice', 'score': 88, 'age': 20}
# ]值得注意的是,Python的排序是稳定的(Stable Sort)。如果两个元素具有相同的排序键,它们在排序后的相对前后位置严格保持不变。这意味着你可以安全地通过连续调用两次排序来实现多级字段排序。
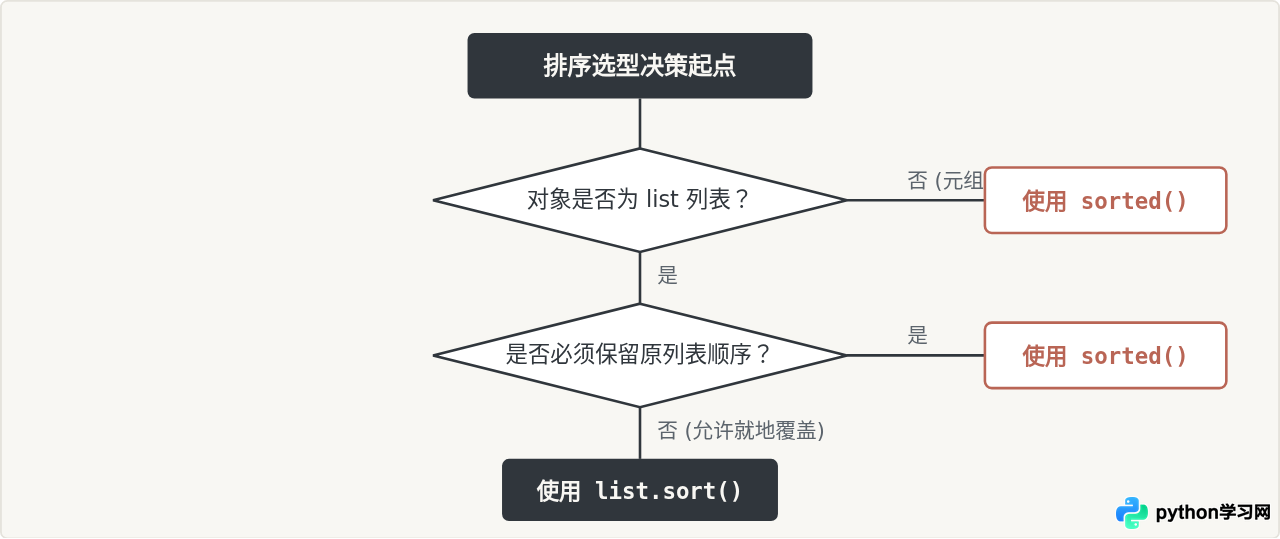
如何选择:工程场景与决策指南
在实际编码中,选择 sort() 还是 sorted() 并不取决于个人喜好,而是取决于上下文的数据安全性与效率诉求:
-
必须保留原始数据时:选择
sorted()
若后续代码逻辑还需要用到列表未经排序的原始输入顺序,或者当前列表是其他模块传入的引用参数(贸然就地修改会产生非预期的副作用),必须使用sorted()生成新列表。 -
处理非列表可迭代对象时:必须选择
sorted()
元组、字典的键/值、集合、文件对象或生成器都没有.sort()方法。要对其进行排序输出,只能通过sorted()转换为列表。 -
处理超大列表且追求内存效率时:首选
list.sort()
当列表中包含数百万条记录时,sorted()会额外申请同等规模的堆内存空间存放新列表,容易引发内存尖刺甚至内存不足(OOM)。在原列表上直接执行list.sort()能有效规避复制开销。 -
函数式链式调用或直接返回时:选择
sorted()
在写类似return sorted(data)[:10]或列表推导式配合排序时,sorted()具有直接返回可操作列表的优势,而list.sort()返回None无法直接链式操作。
总结与核心注意事项
掌握 Python 列表排序的核心并不复杂,只需记住两句关键原则:
- 要保护原数据或输入非列表:用
sorted(x)并接收返回的新列表; - 只在原有列表上重排且节省内存:用
x.sort(),同时千万不要去接收它的返回值。
在涉及包含不可比较类型(例如在 Python 3 中混有整数和未转型的字符串)的列表时,两者都会直接抛出 TypeError 异常,遇到异构类型数据排序时,务必通过 key 参数将其映射为同一种可比较的基准类型。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















