


Python sorted排序后怎么转回字典结构?
详细解析在Python中使用sorted函数对字典排序后,如何正确将其还原为字典结构,涵盖按键排序、按值排序、底层原理与版本兼容注意事项。
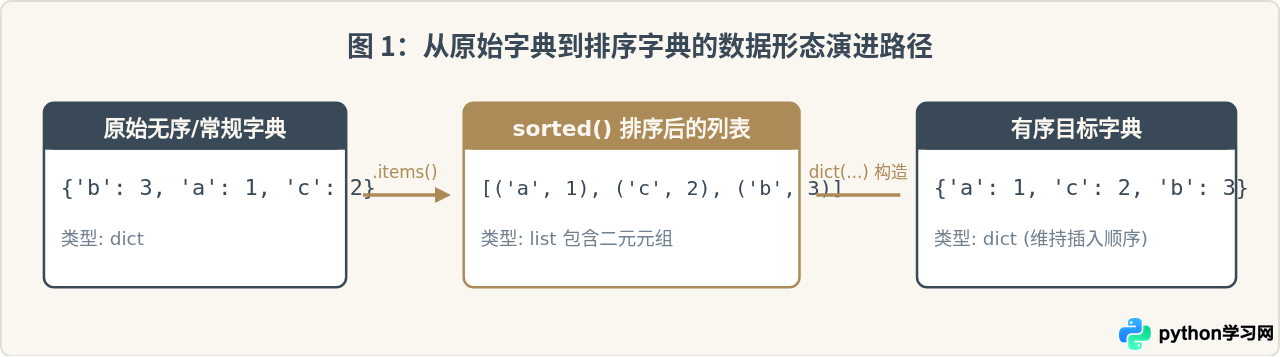
在 Python 中使用内置函数 sorted() 处理字典时,返回的永远是一个列表(list),而不是字典本身。要将其重新转回字典结构,核心做法是:先使用 dict.items() 提取出包含 (键, 值) 元组的可迭代序列,交由 sorted() 依据指定维度完成排序,再把排序后生成的二元元组列表传递给 dict() 构造函数或字典推导式即可。自 Python 3.7 起,标准字典已在语言规范层面保证保留键的插入顺序,因此转换后的字典将严整维持预期的排序结果。
一、为什么 sorted 之后会丢失字典形态?
许多初学者直接对字典执行 sorted(my_dict),结果发现仅获得了一个由所有键组成的有序列表。这是因为在 Python 的迭代协议中,直接对字典对象进行遍历或迭代,默认产生的是它的键(Keys)。
即使将完整的键值对视图 my_dict.items() 传给 sorted(),输出依然不是字典。sorted() 是一种通用内置排序算法,设计目标是接收任意可迭代对象,并始终统一返回一个排好序的全新 list。既然返回值是列表,想要继续用键值对的方式访问数据,就必须主动执行一次“还原为字典”的转换步骤。
二、标准转换操作:四步执行流程
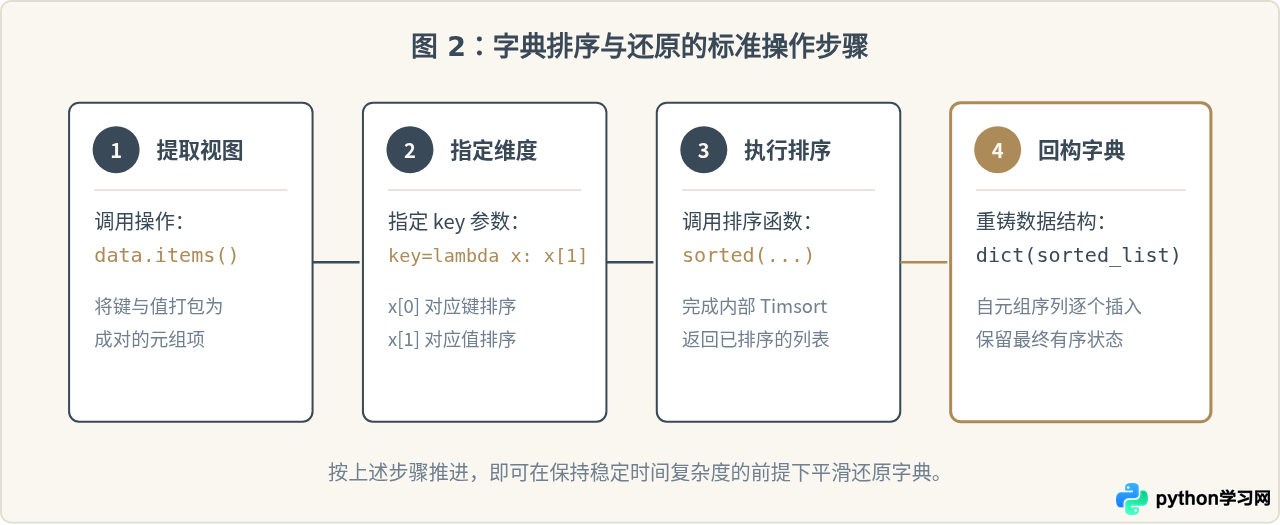
将原始字典转为有序字典,遵循固定的流程控制:提取键值对、设定排序依据、执行排序计算、构造回目标字典。以下是典型的操作执行链条:
三、核心场景与代码实现
在日常开发中,对字典重新排序并转回字典通常分为两大场景:按照字典的键排序与按照字典的值排序。以下通过具体示例分别展示对应语法。
场景 1:按照“键”(Key)排序后转回字典
当依据字典的键进行自然字母或大小排序时,可以省略排序的 key 映射函数,因为二元元组 (k, v) 默认会优先比较首位元素 k:
# 待排序的原始数据
inventory = {'orange': 14, 'apple': 35, 'banana': 8, 'pear': 21}

# 1. 提取并排序元组,2. 使用 dict() 包裹转回字典
sorted_by_keys = dict(sorted(inventory.items()))

print(sorted_by_keys)
# 输出结果示例:
# {'apple': 35, 'banana': 8, 'orange': 14, 'pear': 21}
场景 2:按照“值”(Value)排序后转回字典
若需要依据数值大小(如成绩从高到低、销量由少到多)排序,则需利用 sorted 的 key 参数指定提取元组的第二个位置项(索引为 1):
scores = {'Alice': 88, 'Bob': 95, 'Charlie': 72, 'Diana': 91}

# 升序排列:按分数由低到高转回字典
asc_scores = dict(sorted(scores.items(), key=lambda item: item[1]))
print("升序结果:", asc_scores)
# 输出结果示例:
# 升序结果: {'Charlie': 72, 'Alice': 88, 'Diana': 91, 'Bob': 95}

# 降序排列:添加 reverse=True 参数
desc_scores = dict(sorted(scores.items(), key=lambda item: item[1], reverse=True))
print("降序结果:", desc_scores)
# 输出结果示例:
# 降序结果: {'Bob': 95, 'Diana': 91, 'Alice': 88, 'Charlie': 72}
四、两种转换方式对比:dict() 还是字典推导式?
除了直接传给 dict() 构造器外,社区中还常见一种写法是借助字典推导式(Dictionary Comprehension):{k: v for k, v in sorted(...)}。二者在逻辑产物上完全相同,但在运行开销与语法适用性上各有侧重。
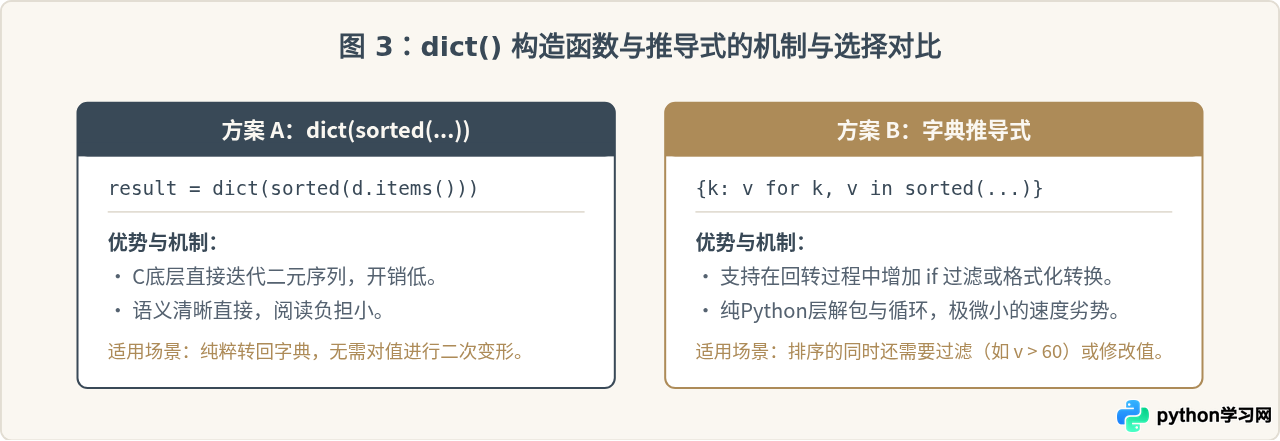
若仅仅需要改变顺序并恢复字典,推荐直接采用 dict(...);若需要在恢复字典的同时将数值四舍五入、添加单位前缀或滤除异常项,字典推导式则更为自然:
# 字典推导式在转回字典时同步过滤低分
raw_scores = {'Tom': 58, 'Jerry': 92, 'Spike': 85}
passed_dict = {k: v for k, v in sorted(raw_scores.items(), key=lambda x: x[1]) if v >= 60}

print(passed_dict)
# 输出结果示例:
# {'Spike': 85, 'Jerry': 92}
五、注意事项与性能建议
在 Python 3.6 之前,标准 dict 类型的哈希实现是无序的,即便用 dict() 重新组装,迭代时也不能百分之百保证读取顺序。如果代码必须向后兼容 Python 3.5 或更早版本,应导入标准库 collections.OrderedDict 来替代内置 dict:
from collections import OrderedDict
sorted_dict = OrderedDict(sorted(data.items(), key=lambda x: x[1]))
而对于当前主流的 Python 3.7 及以上版本,内置 dict 已经严格保证了与插入一致的遍历顺序,直接使用 dict(...) 完全可靠且内存占用更小。
另外,当字典数据量较大(例如包含数十万个键值对)时,频繁调用 lambda 函数会引入一定的 Python 字节码执行开销。此时推荐使用 Python 标准库内置的 operator.itemgetter,它由底层 C 语言实现,提取键或值时的执行效率显著优于纯 Python lambda:
from operator import itemgetter

large_data = {f"item_{i}": 1000 - i for i in range(100000)}

# 利用 itemgetter(1) 替代 lambda x: x[1],性能表现更好
sorted_large = dict(sorted(large_data.items(), key=itemgetter(1)))
六、总结
处理“sorted 排序后转回字典”的核心逻辑可以概括为一个紧凑的认知闭环:
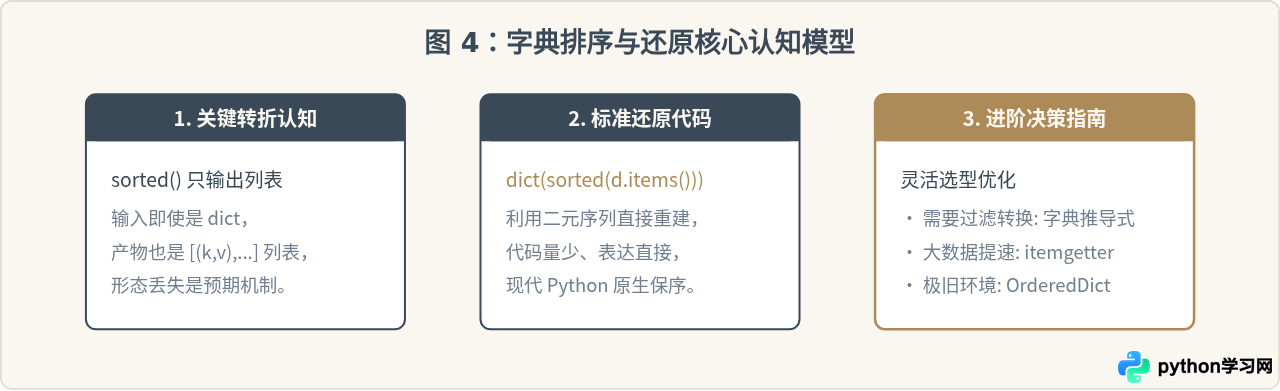
- 对字典执行排序的核心是先调用
.items()转换成二元组,切勿直接对字典名执行sorted(),否则只会得到键的列表。 - 排序后由列表转回字典,首选
dict(sorted_items);如果需要在还原过程中进行键值二次计算或条件过滤,使用字典推导式。 - 在 Python 3.7+ 的标准环境下,通过上述方法生成的字典对象天然保持正确的排序位置,无需额外引入外部模块。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















