


Python开发主要做什么:Web后端、数据分析与AI应用场景解析
全面解析Python开发在现代工程中的三大核心业务场景:Web后端服务、数据分析与清洗、AI与机器学习系统。包含真实工作流程、最小可用代码示例与技术选型建议。
很多人初学 Python 时常常陷入“什么都能做,但不知道实际在做什么”的困惑。在现代工业软件开发中,Python 的实际商业应用高度集中在三大支柱领域:处理网络请求与业务持久化的 Web 后端、将原始日志转化为商业决策支撑的 数据分析,以及驱动智能交互与预测推理的 AI 应用。本文将逐一拆解这三个核心场景的真实工作链路、典型代码实现与关键边界。
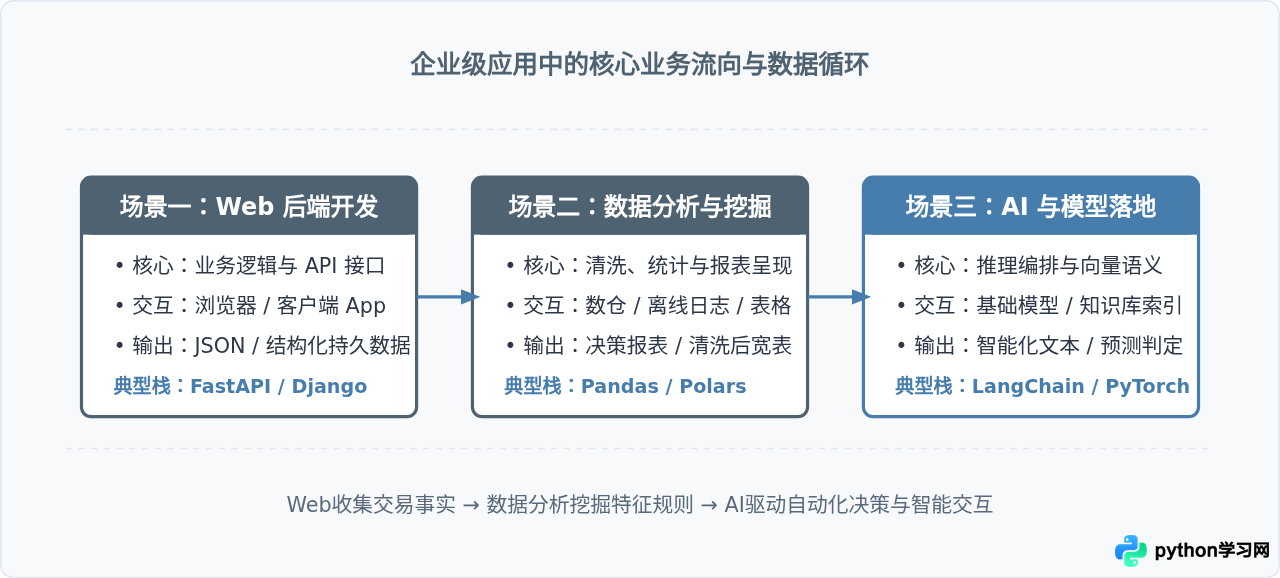
1. 业务场景总览:三大核心领域的职责分工
在企业级架构中,Python 很少作为“单一全能工具”存在,而是根据其生态库的成熟度,承担特定链路的计算与接口封装任务。理解 Python 开发的核心,首先要明确这三大领域在系统整体中的定位与输入输出形态。
Web 后端解决的是状态管理与网络通信问题,负责响应前端客户端、校验数据并操作数据库;数据分析解决的是存量数据价值提取问题,负责数据清洗、指标建模与规律呈现;AI 应用则聚焦于概率推理与模型服务化,负责将训练好的参数或大模型能力封装为生产级接口。
2. 场景一:Web 后端开发(业务交付与系统接口)
在 Web 开发中,Python 工程师主要编写运行在服务器端的程序。这包括设计 HTTP/WebSocket 接口、执行用户权限鉴权、保证高并发下的订单读写一致性,以及将业务数据持久化到 PostgreSQL、MySQL 或 Redis 中。
主流框架定位与技术选型
现代 Python Web 开发主要围绕两个派系展开:
- FastAPI:当前新项目最常用的异步框架。基于原生 Python 类型提示(Type Hints)与
pydantic构建,原生支持异步并发(async/await),自动生成 OpenAPI 接口文档,特别适合作为微服务或 AI 模型的上层调用服务。 - Django:开箱即用的重型框架。自带完整的 ORM(对象关系映射)、后台管理界面、表单验证与会话安全防护,适合业务逻辑复杂、需要快速搭建完整中后台系统的中大型应用。
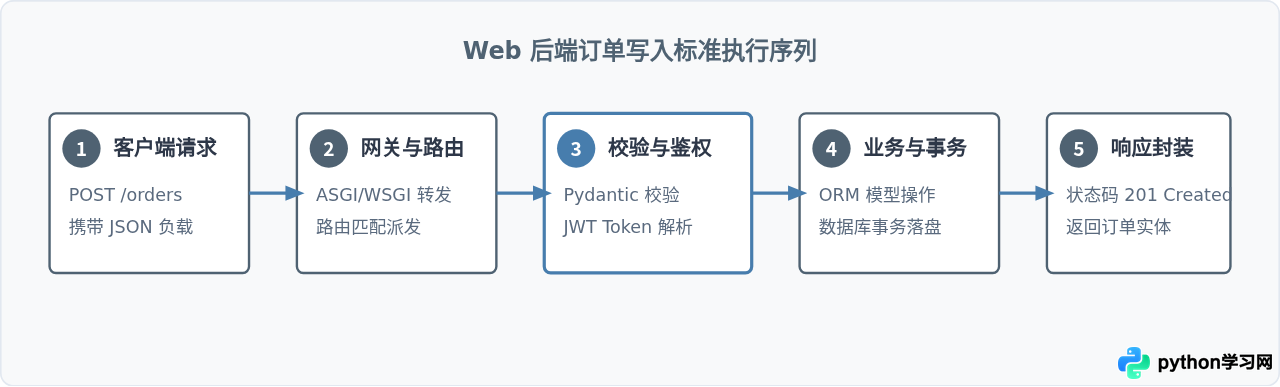
端到端执行流程:从客户端请求到数据库写入
一个标准的 Python 后端开发任务,遵循严格的层次化流水线:从反向代理接收数据,经过网关层,进入应用框架的路由匹配,再通过序列化器进行严格的类型断言,最终执行数据库事务并构建响应。
实战示例:FastAPI 接口与类型安全约束
下面是一个典型的生产级最小实现,展示了数据验证(Pydantic Schema)与接口处理逻辑的结合:
# 依赖安装:pip install fastapi uvicorn pydantic
from fastapi import FastAPI, HTTPException, status
from pydantic import BaseModel, Field

app = FastAPI(title="OrderManagementService")

# 1. 严格定义输入负载结构与校验规则
class OrderCreateRequest(BaseModel):
    user_id: int = Field(..., gt=0, description="必须为合法的正整数用户ID")
    item_sku: str = Field(..., min_length=6, max_length=20, description="物料编码")
    quantity: int = Field(1, ge=1, le=100, description="单次下单量限制为 1-100")

# 2. 路由绑定与业务处理
@app.post("/api/v1/orders", status_code=status.HTTP_201_CREATED)
async def create_order(payload: OrderCreateRequest):
    # 模拟真实场景中的业务库存判断
    if payload.item_sku == "OUT_OF_STOCK":
        raise HTTPException(
            status_code=status.HTTP_400_BAD_REQUEST,
            detail="该物料库存不足,无法生成订单"
        )

    # 模拟持久化到数据库后返回的实体信息
    saved_order_id = 9527
    return {
        "status": "success",
        "order_id": saved_order_id,
        "details": payload.model_dump()
    }
asyncio 驱动的网络 I/O 复用)或使用 gunicorn/uvicorn 启动多个工作子进程(Multi-Worker)。
3. 场景二:数据分析与清洗(生产数据转化)
真实世界中的数据往往充满缺失、异常值与不一致的格式。Python 在该场景下的核心任务不是画几张图表,而是构建可靠的数据流水线(ETL):从数据库抽取原始日志,进行行列过滤、缺失值插补、格式标准化,进而通过向量化聚合计算输出关键财务与业务指标。
核心工具库生态
数据分析依赖底层的 C/C++ 封装层以突破解释器性能瓶颈:
- NumPy:提供高性能的多维数组(
ndarray)和底层数学运算函数,是所有现代 Python 科学计算的底层基石。 - Pandas / Polars:结构化表格数据处理利器。Pandas 是目前工业界使用最广泛的标准;而新兴的 Polars 基于 Rust 编写,支持原生多线程和惰性计算(Lazy Evaluation),在大数据集上表现极佳。
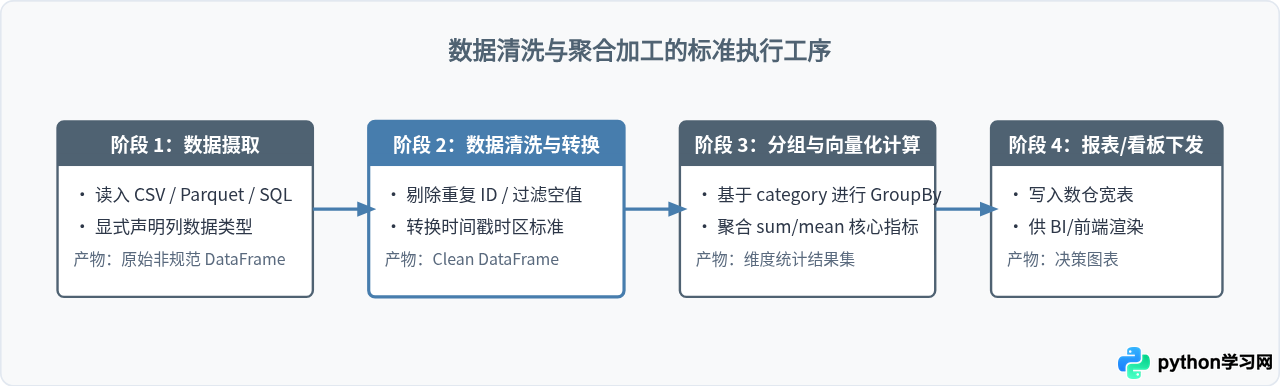
操作步骤:从原始日志到特征聚合
数据分析在开发实践中具有标准的阶段性操作逻辑,每一步操作都伴随着明确的数据结构转变:
实战示例:Pandas 处理不规则销售日志
下列代码演示了在内存中处理脏数据时的标准模式,避免使用低效的 for 循环,改用向量化算子:
# 依赖安装:pip install pandas
import pandas as pd
import numpy as np

# 模拟原始不规范日志
raw_data = {
    "order_id": [101, 102, 103, 104, 105],
    "category": ["Electronics", "Home", "Electronics", np.nan, "Home"],
    "amount": ["1200.5", "invalid_str", "3400.0", "85.0", "450.2"],
    "is_refund": [False, False, True, False, False]
}

df = pd.DataFrame(raw_data)

# 1. 清洗阶段:处理非法字符串并转换为数值型(非法值转为 NaN)
df["amount"] = pd.to_numeric(df["amount"], errors="coerce")

# 2. 过滤阶段:填充缺失类目,剔除退款订单与金额异常的空值行
df["category"] = df["category"].fillna("Unknown")
clean_df = df[(df["is_refund"] == False) & (df["amount"].notnull())].copy()

# 3. 聚合阶段:按类目计算有效销售总量与平均客单价
report = clean_df.groupby("category")["amount"].agg(
    total_sales="sum",
    avg_ticket="mean"
).reset_index()

print("清洗后产出的业务报表:")
print(report)
运行输出(示例):
清洗后产出的业务报表:
      category  total_sales  avg_ticket
0  Electronics       1200.5      1200.5
1         Home        450.2       450.2
2      Unknown         85.0        85.0
for index, row in df.iterrows())是严重的性能反模式。对于上百万行的数据,这可能导致数分钟的延迟。永远优先使用底层的向量化操作(Vectorization)或 numpy.where 逻辑。
4. 场景三:AI 与大模型应用(工程化落地)
在 AI 领域,Python 的开发者并非全都在从事基础模型的数学算法研究(这通常由算法科学家负责)。大量的 Python AI 工程师做的是工程化落地:利用现有的预训练模型权重或大语言模型(LLM)API,将其与企业私有知识库连接,构建出具备上下文理解能力的智能助手与检索增强系统(RAG)。
现代 AI 开发的技术栈下沉
- 模型训练与微调层:PyTorch 是绝对的工业界事实标准,负责神经网络结构的搭建、梯度反向传播计算以及权重微调(Fine-tuning)。
- 应用编排与落地层:以 LangChain、LlamaIndex 以及 Hugging Face 生态为主,负责文本分块(Chunking)、向量化(Embedding)、向量数据库检索(如 Milvus、Chroma)与提示词模板拼接。
RAG 系统运作机制剖析
企业应用最广泛的场景就是基于自有文档问答。大语言模型无法预知公司内部私有数据,直接问答会产生“幻觉”。因此,Python 开发者需要构建一个“检索-拼装-生成”的闭环管线。
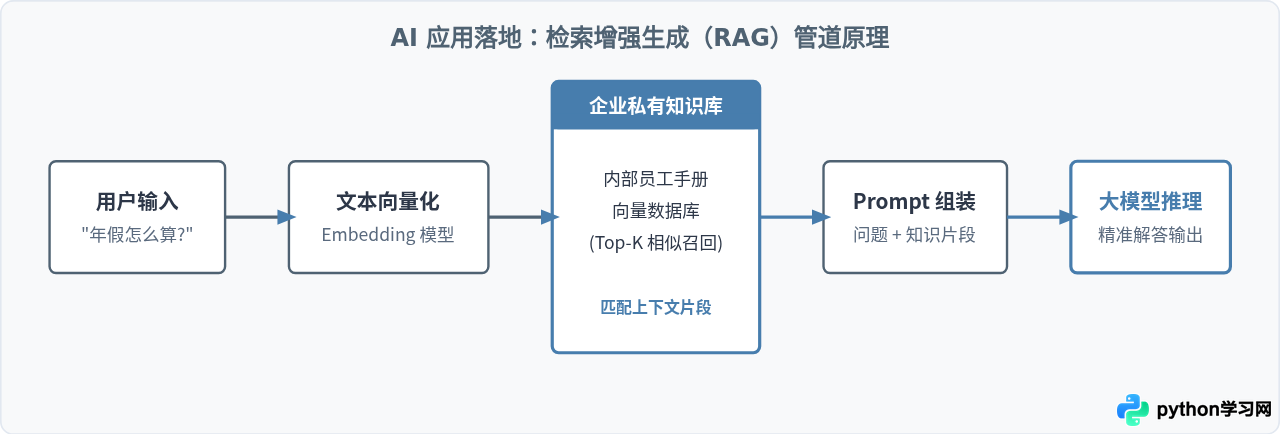
实战示例:知识注入的提示词装配
编写 AI 应用时,核心逻辑并非只是向客户端发送请求,而是严格控制 Prompt 的结构与事实边界,防止模型产生胡乱推理:
# 伪代码逻辑:演示真实应用中的 RAG 上下文装配与调用逻辑
def build_rag_prompt(user_query: str, retrieved_context: list[str]) -> str:
    """
    通过将检索到的知识注入上下文,限制大模型的思考边界
    """
    context_text = "\n".join([f"- {item}" for item in retrieved_context])

    prompt = f"""你是一名严格的企业助理。请仅根据下面提供的【参考资料】回答用户问题。
如果资料中未提及相关内容,请明确回答“对不起,现有资料未记载此信息”,严禁胡乱推断。

【参考资料】:
{context_text}

【用户问题】:
{user_query}
"""
    return prompt

# 模拟检索模块从向量库召回的相关条款
mock_knowledge = [
    "员工入职满 1 年,次年可享受 5 个工作日的带薪年假。",
    "年假申请需提前 3 个工作日在 OA 系统提交主管审批。"
]

final_prompt = build_rag_prompt("我刚来公司半年,有年假吗?", mock_knowledge)
print(final_prompt)
# 后续只需将 final_prompt 发送给模型 API,即可获得基于事实的确定性回答
5. 总结:核心技术选型与场景横向对比
对于一名 Python 开发者或技术选型负责人来说,清楚了解各个领域的痛点、边界与技术组合至关重要。下表梳理了三个核心方向的关键维度:
| 场景分类 | 典型日常开发任务 | 主流工具 / 框架 | 核心挑战与性能瓶颈 |
|---|---|---|---|
| Web 后端 | 设计 RESTful 接口、数据校验、处理高并发读写、管理数据库事务 | FastAPI, Django, SQLAlchemy, PostgreSQL, Redis | I/O 密集型并发瓶颈、GIL 对 CPU 计算的限制、数据库连接池耗尽 |
| 数据分析 | 处理脏数据、构建 ETL 清洗管线、计算核心商业指标、生成宽表 | Pandas, Polars, NumPy, DuckDB | 内存膨胀(Out of Memory)、低效的 Python 循环遍历导致的性能下降 |
| AI 与大模型 | 搭建知识库问答(RAG)、模型权重微调、Agent 工具链编排、流式接口封装 | PyTorch, LangChain, Hugging Face, Milvus / Chroma | GPU 显存占用过高、调用大模型 API 的网络延迟与输出内容的不确定性控制 |
综上所述,Python 开发的实际工作不是孤立地写语法糖,而是依据业务问题的特征选择适配的技术栈:在追求快速构建高可用服务时选择 FastAPI/Django;在面对杂乱无章的业务存量数据时借助 Pandas/Polars 进行精准提纯;在智能化浪潮下,则通过 PyTorch 与 RAG 编排工具为应用赋予上下文理解能力。明确这三个场景的工作流与边界,就掌握了现代 Python 开发的核心脉络。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















