


Python怎么使用openpyxl读取.xlsx文件内容
详细讲解在Python中使用openpyxl库读取.xlsx文件内容的方法,涵盖工作簿加载、工作表选取、单格与批量数据遍历、公式值解析及大文件读取优化。
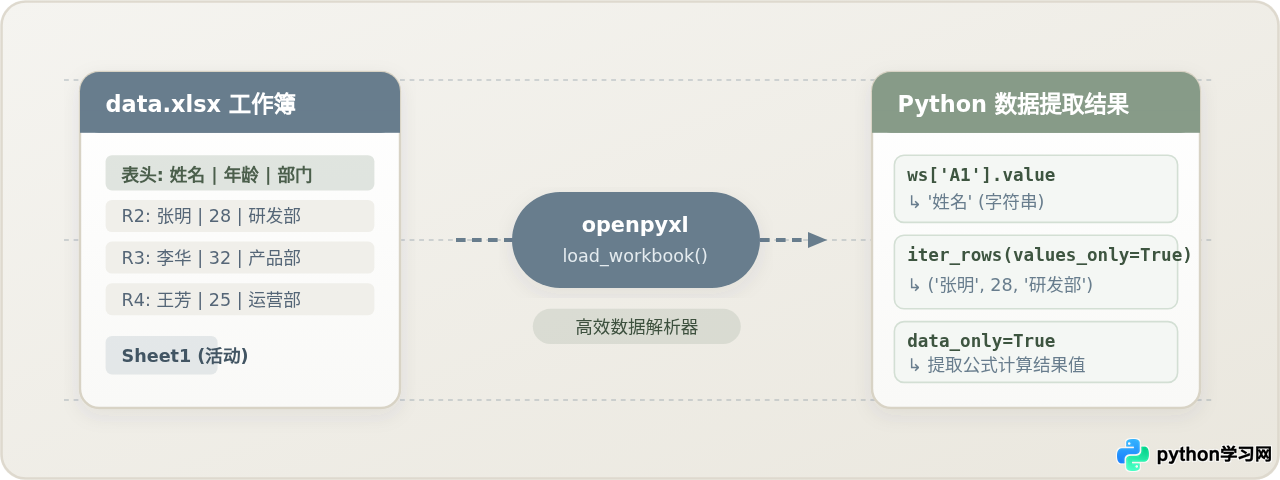
.xlsx 格式的 Excel 表格时,openpyxl 是功能最全面且无需安装额外桌面软件的标准工具库之一。读取文件的整体执行路径非常直接:首先通过 load_workbook() 将工作簿读入内存,再根据表名或默认状态获取对应的 Worksheet(工作表),最后通过坐标定位或迭代器遍历单元格提取具体内容。本文将系统拆解每一步的具体代码、批量读取的高效模式以及常见细节问题。
一、环境准备与核心操作流程
openpyxl 是一个专门针对 Office Open XML 标准(即 .xlsx、.xlsm 等扩展名)设计的 Python 第三方模块。开始操作前,需在终端或命令行中完成安装:
pip install openpyxl安装完成后,即可在 Python 脚本中导入并执行读取。整个读取过程分为四个紧密相扣的阶段:加载工作簿、选取工作表、确定读取范围、解构单元格数值。
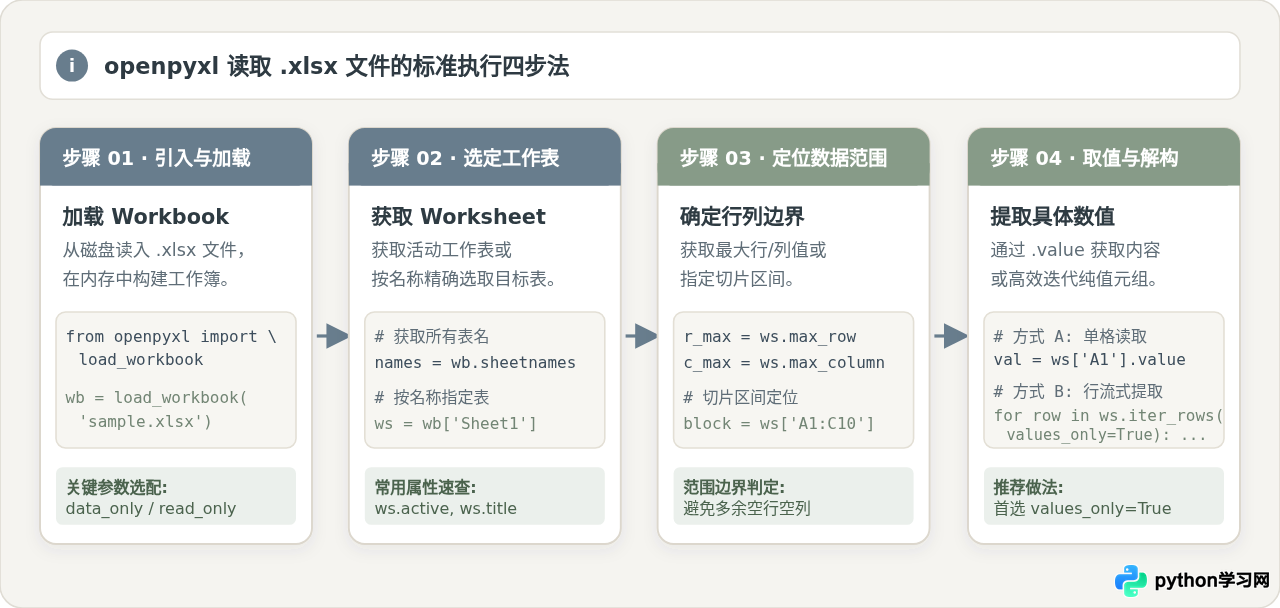
每一步都对应 openpyxl 的一个核心 API。理解这四个步骤的衔接关系后,无论是读取单个配置项还是批量抓取几万行表格,都能按照这套固定范式快速实现。
二、认识 openpyxl 的对象分层模型
初次使用 openpyxl 时,最容易产生的困惑是混淆了“文件”、“表”和“单元格”之间的访问关系。该库采用严密的面向对象树状模型:
- Workbook(工作簿):对应整个
.xlsx文件,负责管理文件的元数据、全局样式以及所有包含的子表。 - Worksheet(工作表):对应文件内部的一个具体 Sheet 页面(如“Sheet1”),负责组织二维网格及行列边界属性。
- Cell(单元格):网格中位于具体坐标(如
B3或第 2 行第 3 列)的最小存储单元,承载实际数值、数据类型与显示格式。
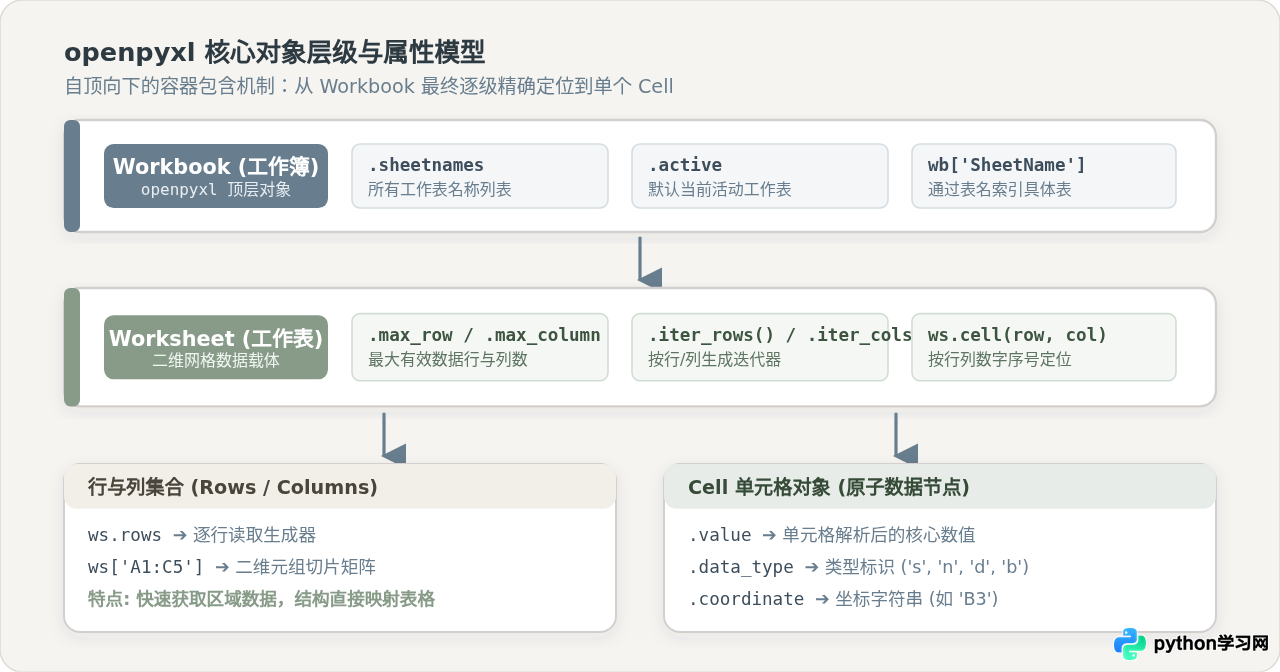
在代码中调用时,我们始终遵循这一层级递进关系:由 load_workbook() 获得 wb,由 wb[name] 获得 ws,再由 ws[coord] 或 ws.cell() 获得 cell。
三、基础读取:加载工作簿与获取工作表
首先通过 load_workbook 载入目标文件。在载入后,我们可以查看该文件内共有哪些工作表,并选定需要操作的表:
from openpyxl import load_workbook

# 1. 加载本地 .xlsx 文件
wb = load_workbook('data.xlsx')

# 2. 查看文件中所有的工作表名称
print("包含的工作表:", wb.sheetnames)

# 3. 获取指定的工作表对象(推荐方式)
ws = wb['Sheet1']

# 或者直接获取当前打开时的默认活动工作表
active_ws = wb.active

# 4. 打印工作表的有效数据边界
print(f"总行数: {ws.max_row}, 总列数: {ws.max_column}")
属性 ws.max_row 与 ws.max_column 记录了当前表中已存在内容的最大行列序号。在 openpyxl 中,行号和列号均从 1 开始计数(第 1 行即表头),与 Python 常见的从 0 索引列表不同,编写循环时需特别留意。
四、单元格数据定位与切片读取
定位具体单元格主要有两种方式:Excel 风格坐标访问与数字行列坐标访问。
1. 坐标访问方式:适合固定位置的单值读取
如果目标单元格位置固定(例如特定配置项位于 A1),直接使用方括号索引最为直观:
cell = ws['A1']
# 打印单元格原生值
print(cell.value)
# 打印单元格数据类型(如 's' 表示字符串,'n' 表示数字)
print(cell.data_type)
2. 数字行列访问方式:适合数值循环步进
当需要在循环中通过变量步进读取时,ws.cell(row=i, column=j) 更加方便,无需手动将数字转换为字母列标:
# 读取第 2 行第 3 列(对应 C2)
target_cell = ws.cell(row=2, column=3)
print(target_cell.value)
3. 区域切片读取
也可以使用切片语法读取连续矩形区域。ws['A1:C3'] 会返回一个由行构成的嵌套元组,外层元组代表每一行,内层元组包含该行中的 Cell 对象:
cell_range = ws['A1:C3']
for row in cell_range:
    row_values = [cell.value for cell in row]
    print(row_values)
五、关键差异对比:Cell 对象遍历与 values_only 纯数据流
在进行整表或多行批量遍历时,openpyxl 提供了 ws.iter_rows() 方法。这里存在两种截然不同的使用方式,也是开发中最常影响代码清晰度与运行性能的关键决策点:
| 比较维度 | 默认模式 (values_only=False) | 纯数据模式 (values_only=True) |
|---|---|---|
| 返回值类型 | tuple[Cell, Cell, ...] 单元格对象 |
tuple[Any, Any, ...] Python 原生类型元组 |
| 内存与执行效率 | 开销较大,需为每个格子构建 Python 对象 | 轻量高效,跳过 Cell 封装,速度提升明显 |
| 携带信息 | 包含值、坐标、批注、样式、字体等全部元数据 | 仅包含单元格经过转换后的实际底层数据值 |
| 解包与书写难度 | 需遍历并逐一调用 .value 属性提取 |
支持直接一行变量解构:name, age = row |
| 适用场景 | 需要检查/修改样式、读取公式原文或重写文件 | 纯数据提取、统计汇总、清洗入库、转 DataFrame |
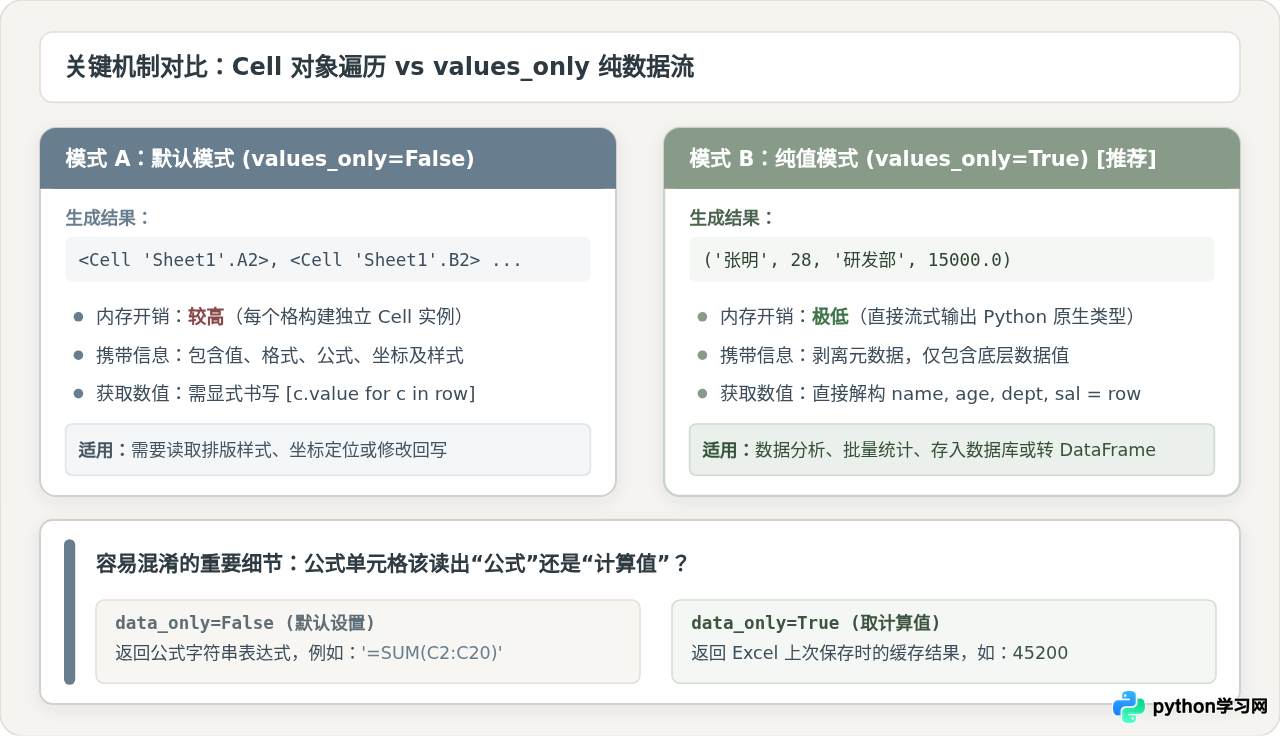
为什么这一差异非常重要?
在大多数日常业务中,读表格的目的只是为了提取其中的业务数据进行分析或入库。如果使用默认模式,代码中需要反复嵌套编写列表推导式提取 .value,当表格达到数万行时,还会产生大量的临时 Cell 对象,占用可观的内存空间。
开启 values_only=True 之后,openpyxl 会在解析内部 XML 数据流时直接提取转换后的 Python 原生数据(字符串、浮点数、整数、datetime 等),代码书写与执行效率双双达到最优:
# 推荐的批量高效读取写法:跳过首行表头,直接解包
for row in ws.iter_rows(min_row=2, max_col=4, values_only=True):
    name, age, department, salary = row
    print(f"姓名: {name}, 年龄: {age}, 部门: {department}, 薪酬: {salary}")
六、进阶技巧:公式计算结果与大文件流式读取
1. 读取公式计算结果而非公式文本(data_only 参数)
若表格中某单元格包含公式(例如 C10 的内容为 =SUM(C2:C9)),默认情况下读取 cell.value 得到的是字符串 "=SUM(C2:C9)"。
若要获取计算出的实际数值,需在加载时加入 data_only=True 参数:
wb_data = load_workbook('data.xlsx', data_only=True)
ws_data = wb_data['Sheet1']
print("公式计算值:", ws_data['C10'].value)openpyxl 本身不具备 Excel 的公式重算引擎。data_only=True 读取的是由 Excel、WPS 等软件在最后一次保存该文件时写入的计算结果缓存。如果该文件是由其他第三方脚本直接生成但从未在 Excel 中打开保存过,公式单元格可能会返回 None。
2. 超大表格的只读流式优化(read_only 参数)
当面对数万至数十万行、文件体积数十兆以上的巨大 .xlsx 文件时,完整构建 DOM 树可能会导致内存激增。此时可开启只读流式模式:
wb_huge = load_workbook('big_data.xlsx', read_only=True)
ws_huge = wb_huge.active

for row in ws_huge.iter_rows(values_only=True):
    # 流式生成器逐步输出,内存占用恒定保持在极低水平
    process_record(row)

# 只读模式处理完毕后务必手动关闭
wb_huge.close()
七、完整实战代码与常见避坑指南
下面给出一个将 .xlsx 文件读取并完整转换为 Python 结构化字典列表的通用示例工程代码:
from openpyxl import load_workbook

def read_excel_to_dict(file_path, sheet_name=None):
    """
    读取指定 excel 文件并返回字典列表(以首行为键)
    """
    wb = load_workbook(file_path, data_only=True)
    ws = wb[sheet_name] if sheet_name else wb.active

    # 获取整表数据迭代器
    rows_iter = ws.iter_rows(values_only=True)

    # 读取首行作为字典键(表头)
    headers = next(rows_iter, None)
    if headers is None:
        wb.close()
        return []

    records = []
    for row in rows_iter:
        # 跳过全空行
        if all(cell is None for cell in row):
            continue
        # 将表头与当前行数据打包为字典
        record = dict(zip(headers, row))
        records.append(record)

    wb.close()
    return records

# 示例调用
if __name__ == '__main__':
    data = read_excel_to_dict('sales.xlsx')
    print(f"成功解析 {len(data)} 条有效业务记录")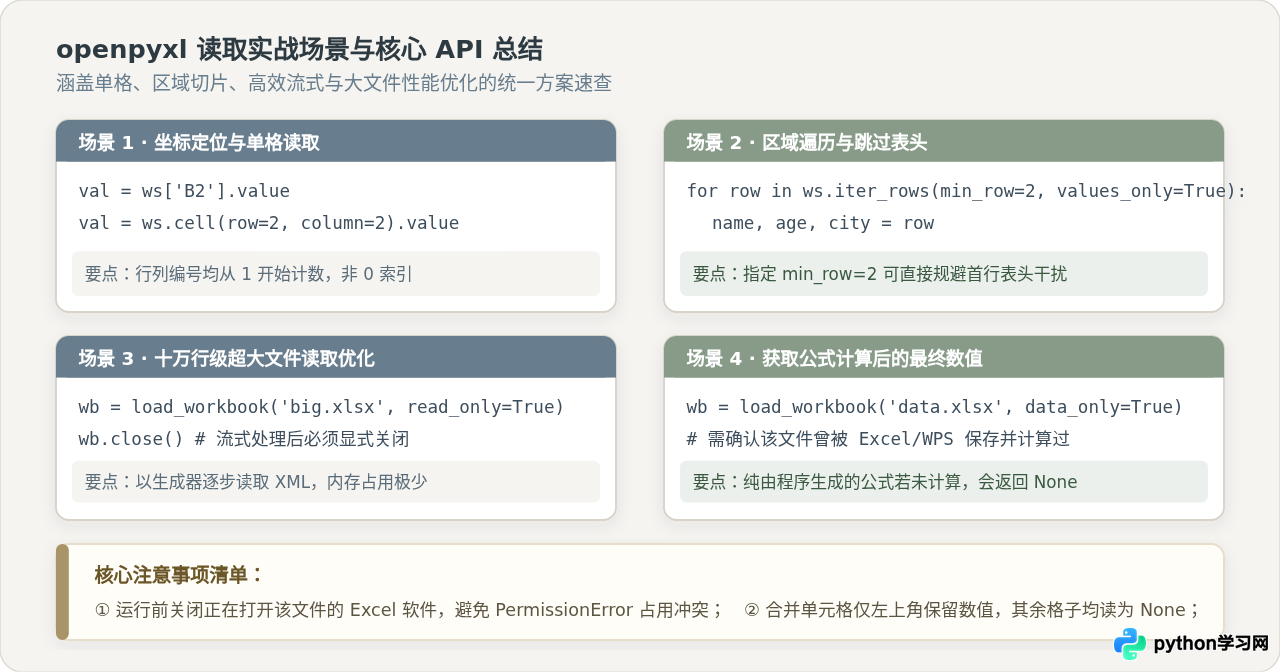
- 文件占用冲突(PermissionError):在 Windows 或 macOS 下,如果目标 Excel 文件正被 Excel 或 WPS 软件打开,脚本加载时会抛出权限拒绝错误。运行前请先保存并关闭软件中的文件。
- 合并单元格取值:对于合并后的区域(如
A1:B2),数值仅保存在左上角的首个单元格(即A1)中,其余被合并的从属单元格在 openpyxl 中读取出来均为None。 - 日期时间类型自动转换:openpyxl 会自动识别 Excel 的日期时间格式,并直接转换为 Python 原生的
datetime.date或datetime.datetime对象,无需手动解析字符串。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















