


pip与conda:Python和Anaconda在包管理上的不同
深入对比 pip 与 conda 在 Python 及 Anaconda 生态中的核心差异,涵盖管理层级边界、解释器隔离机制、依赖求解算法、二进制分发原理、常用命令对照及协同混用避坑实践。
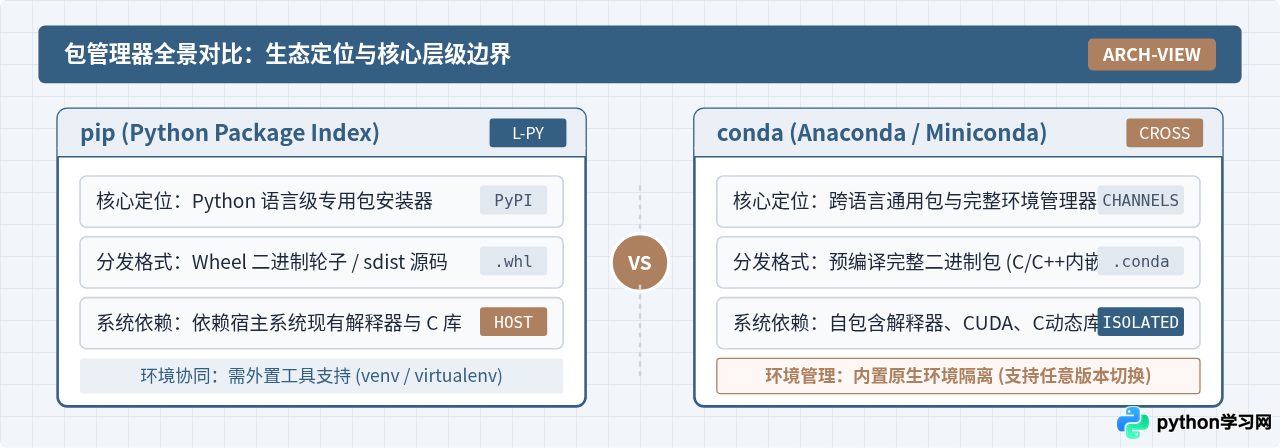
一、管理定位与管理对象:Python语言级包 vs 跨语言系统级依赖
在 Python 开发中,“包”(Package)一词常指两类不同的概念:一类是用纯 Python 编写的代码库或只包含简单扩展的模块;另一类则是需要与复杂底层 C/C++ 动态库、Fortran 数学库或 GPU 计算平台(CUDA)紧密绑定的工程依赖。这正是 pip 与 conda 产生本质分工的根源。
1. pip 的管理边界与运行假设
pip(Pip Installs Packages)是 Python 官方打包机构(PyPA)维护的标准包管理工具。它的核心定位是Python 模块分发协议的客户端。pip 的工作边界具有以下特点:
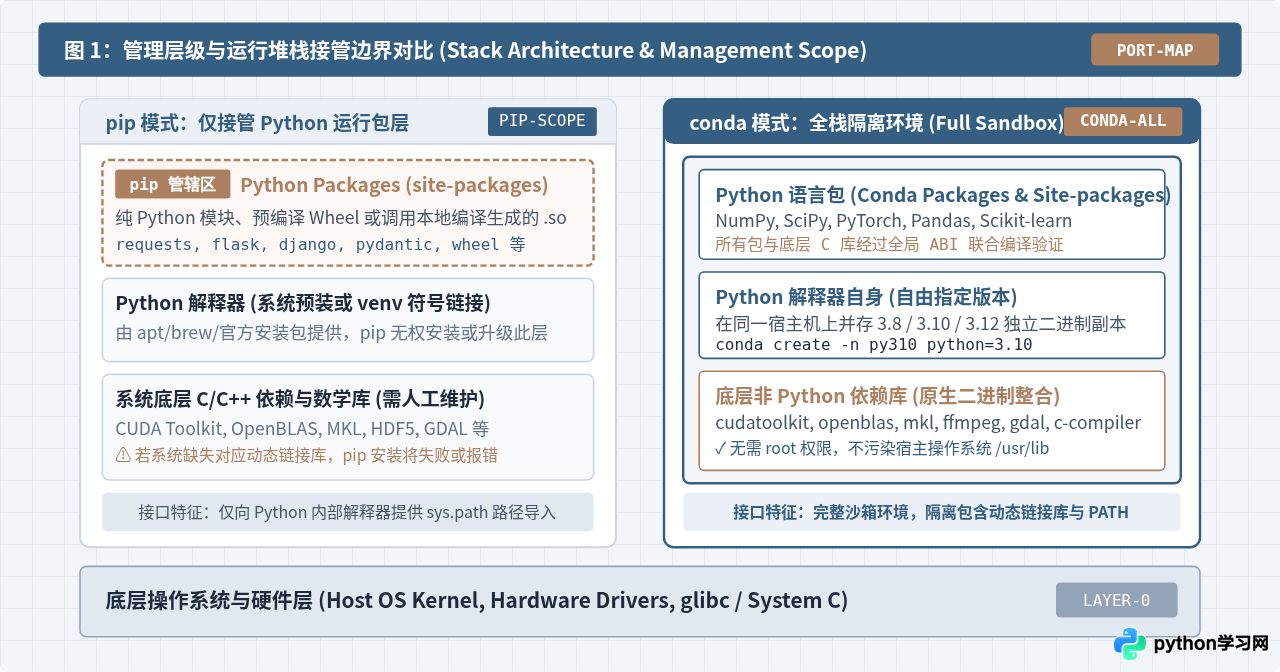
- 管理对象局限于 Python 库:pip 仅从 Python Package Index (PyPI) 或指定的私有索引源检索包。它只负责将代码或构建好的
.whl(Wheel)解压到当前 Python 解释器的site-packages目录中。 - 强依赖宿主环境已有的解释器:pip 无法自行安装、升级或更换 Python 解释器。执行
pip install时,它永远服务于调用它的那个特定python可执行程序。 - 非 Python 动态库的“假定存在”:若某个 Python 库(如大型图像处理、地理信息 GDAL 或特定数据库驱动)依赖底层操作系统的 C 动态链接库(如
libgdal.so、libstdc++.so),pip 本身并不具备跨操作系统的动态库安装能力,必须依赖开发者通过系统的apt、yum、brew手动配置,或者依赖轮子作者预先使用auditwheel打包好的manylinux镜像标准。
2. conda 的管理边界与全栈沙箱
conda 最初作为 Anaconda 发行版的核心组件诞生,如今是独立开源的通用二进制包管理器。它并不将自己局限于某一种编程语言,而是面向数据科学、科学计算以及异构系统依赖设计的完整软件分发系统:
- Python 解释器也是它管理的“包”之一:在 conda 的世界里,
python=3.10、python=3.11与普通第三方库地位完全相同。你可以在同一台机器上轻松创建多个包含不同次版本甚至不同构建补丁的 Python 独立环境。 - 跨语言与系统底层二进制统管:除了 Python 库,conda 包仓库(如 Anaconda 官方渠道与社区主力
conda-forge)直接提供了预编译好的cudatoolkit、openblas、mkl、ffmpeg、graphviz等非 Python 二进制依赖。这意味着用户不需要 root 权限去修改系统/usr/lib,即可在一个受隔离的沙箱内拥有匹配的完整 C/C++ 运行时环境。 - Anaconda 与 Miniconda 的关系:Anaconda 是一个包含了 conda 工具、基础 Python 环境以及数百个常用科学计算、机器学习预装包的庞大发行版(体积数吉字节);而 Miniconda 仅包含 conda 自身与最小化 Python 运行依赖,开发者可按需装配轻量级环境。
二、虚拟环境隔离机制:工具集成与解释器灵活性
任何严肃的工程开发都离不开环境隔离。pip 与 conda 在处理虚拟环境时的机制截然不同:一个是“组合式外挂”,另一个是“原生一等公民”。
1. pip 与 venv 的松散协同
pip 自身并不包含创建虚拟环境的功能。在标准 Python 实践中,环境隔离通常借助内置的 venv 模块或第三方工具 virtualenv 实现:
# 步骤 1:利用宿主 Python 调用 venv 模块创建环境
python3 -m venv my_web_env

# 步骤 2:激活隔离环境(改变当前终端的 PATH 环境变量)
source my_web_env/bin/activate  # Linux/macOS
# my_web_env\Scriptsctivate   # Windows

# 步骤 3:在激活环境内执行 pip 安装
pip install fastapi uvicorn核心限制:venv 创建的环境本质上是对宿主系统中某个已安装 Python 解释器的符号链接或简单副本。如果当前宿主机安装的是 Python 3.9,你无法通过 venv 直接凭空创建一个 Python 3.12 的独立环境,必须先在宿主系统上完成 Python 3.12 解释器的编译或系统包安装。
2. conda 原生的一体化环境管理
conda 将包管理与环境管理无缝整合在同一命令行接口中,环境与解释器版本彻底解耦:
# 创建任意 Python 版本的独立环境,无需宿主机预先装有对应版本
conda create -n ai_research python=3.10 numpy scipy -y

# 激活环境并进入对应沙箱
conda activate ai_research

# 查看当前环境中包括 Python 解释器在内的所有组件
conda list
在 conda 中,每个环境都位于安装目录下的 envs/<env_name>/ 目录中,拥有各自独立的 bin/、lib/、include/ 结构。conda 会完全重定向环境内的动态链接器搜索路径,从而确保环境与宿主系统之间实现真正的二进制隔离。
三、依赖解析算法与打包分发机制
为什么同一个包通过 pip 安装可能报编译错误,而通过 conda 安装却能瞬间完成?答案隐藏在两者的依赖解析算法与包分发形态中。
1. pip 的依赖解析与编译要求
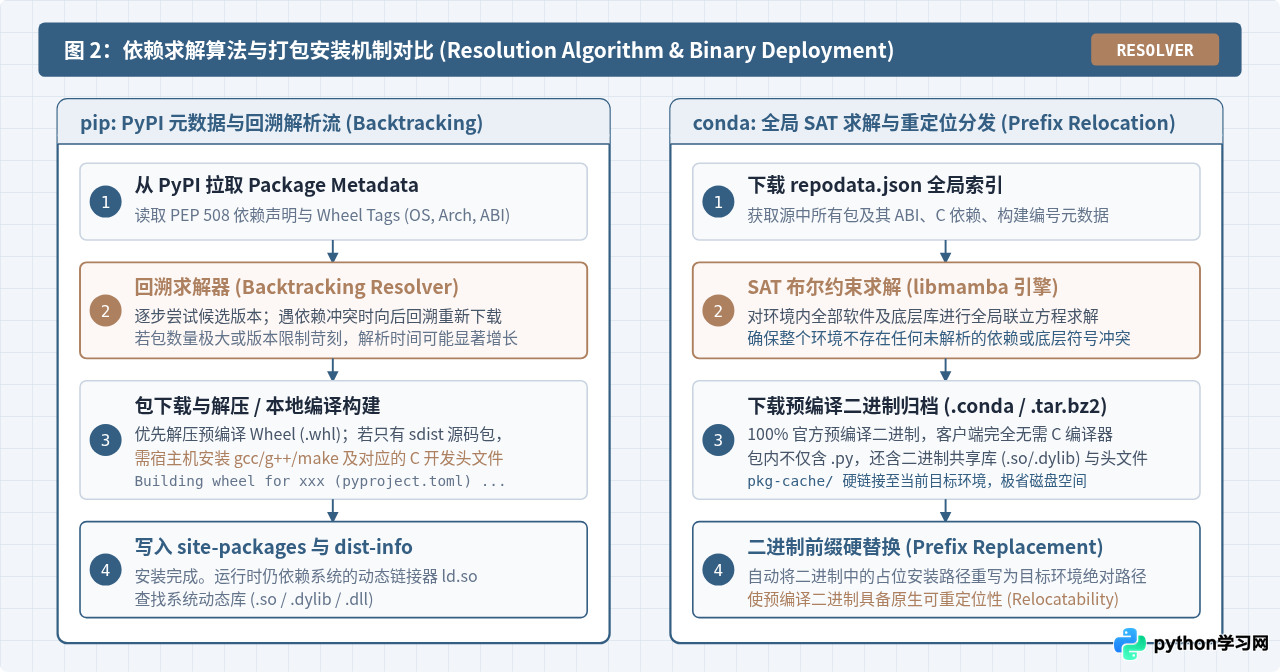
早期的 pip 采用朴素的贪婪式安装方式,容易发生“后装的包静默破坏先装包”的严重问题。从 pip 20.3 起,官方引入了基于回溯法(Backtracking)的依赖解析器:
- Backtracking 求解特点:解析器会从 PyPI 逐个拉取候选包的元数据声明(PEP 508)。当发现某个次级依赖出现版本冲突时,解析器会撤销当前选择,回退一步尝试旧版本包,直到找到满足全局约束的一组解。这种机制在依赖项庞大复杂时可能耗费较长时间。
- 源码包(sdist)的编译壁垒:PyPI 上的库主要以 Wheel(
.whl)和源码包(.tar.gz)发布。如果某个包含 C/C++ 扩展的库没有为当前操作系统或架构提供预编译 Wheel,pip 会在本地调用gcc、clang或 MSVC 进行现场编译。一旦宿主机缺少对应的 C 开发头文件(如Python.h、底层数学库头文件),安装就会立即以error: command 'gcc' failed with exit status 1告终。
2. conda 的全局 SAT 求解与预编译二进制重定位
conda 的分发理念与 Linux 发行版(如 Debian 的 APT、Arch 的 Pacman)高度一致:所有的包必须是官方构建农场预先编译好的二进制成品,用户机器上绝对不需要编译工具链。
- SAT(布尔可满足性)约束求解:conda 启动安装前,首先拉取软件源中包含全部包元数据的
repodata.json索引。随后,内置的 SAT 求解器(现代 conda 默认采用高性能 C++ 实现的libmamba求解器)将环境中全部已装软件、候选包、编译编号以及 C ABI 兼容性转化为布尔命题公式进行联合求解。这保证了装完之后整个环境所有组件的 ABI 是 100% 互相兼容的。 - 二进制前缀硬替换(Prefix Relocation):预编译好的二进制文件通常在编译阶段写死了绝对路径。为了让包能够被解压并安装在用户任意指定的本地目录中,conda 在打包时嵌入了占位路径(例如长度达到数百字节的虚拟前缀路径)。在安装时,conda 会扫描所有二进制文件和文本配置文件,直接将占位符替换为用户本地目标环境的实际绝对路径,实现了无缝且无污染的二进制重定位。
四、常用命令映射与操作对照
在日常工作流中,开发者经常需要在两种工具之间切换。下表总结了最常见操作在 pip(搭配 venv)与 conda 中的命令对照:
| 操作场景 | pip + venv 工作流 | conda 独立工作流 | 关键行为与机制差异 |
|---|---|---|---|
| 创建新环境 | python -m venv myenv |
conda create -n myenv python=3.10 |
venv 只能使用当前宿主 Python 版本;conda 可指定任意版本 |
| 激活 / 退出环境 | source myenv/bin/activatedeactivate |
conda activate myenvconda deactivate |
venv 仅修改 PATH;conda 还会注入环境专用的动态库与环境变量 |
| 安装指定包 | pip install numpy==1.24.3 |
conda install numpy=1.24.3 |
pip 使用两个等号 ==;conda 语法支持单个等号 = |
| 指定软件源安装 | pip install -i <url> requests |
conda install -c conda-forge gdal |
pip 指定 HTTP 镜像源;conda 通过 -c 指定不同的 Channel 频道 |
| 查看已安装列表 | pip list |
conda list |
conda list 会额外标注每个包是由 conda 还是 pip 安装的 |
| 导出依赖配置 | pip freeze > requirements.txt |
conda env export --from-history > env.yml |
--from-history 可剔除当前操作系统特定的构建哈希,保证跨平台可用 |
| 根据配置还原环境 | pip install -r requirements.txt |
conda env create -f env.yml |
conda 会连同环境一同创建;pip 需先手工激活新环境 |
| 卸载软件包 | pip uninstall numpy -y |
conda remove numpy -y |
conda 会连同反向依赖一起级联检查,防止破坏其他依赖包 |
五、混合使用规范与推荐流水线(操作步骤)
在实际开发中,尤其是深度学习和科研场景,开发者不可避免地会遇到这种情况:大部分底层包在 conda 中安装,但某些最新的前沿论文代码、私有 SDK 或纯应用层小工具只发布在 PyPI 上。此时必须进行pip 与 conda 的混合使用。
conda list 中标明 channel 为 pypi),但是 pip 无法完全感知 conda 的二进制依赖图谱与底层 C 动态库。如果在 pip 安装完某些包之后,再次执行 conda install 升级底层库,conda 极有可能直接覆盖或删除 pip 所依赖的底层动态链接库,导致 Python 解释器在 import 时抛出难以定位的 Segmentation fault 或 symbol lookup error。
为了保证工程的健壮性与环境可维护性,请严格遵循下方经过工业验证的标准协同流水线:
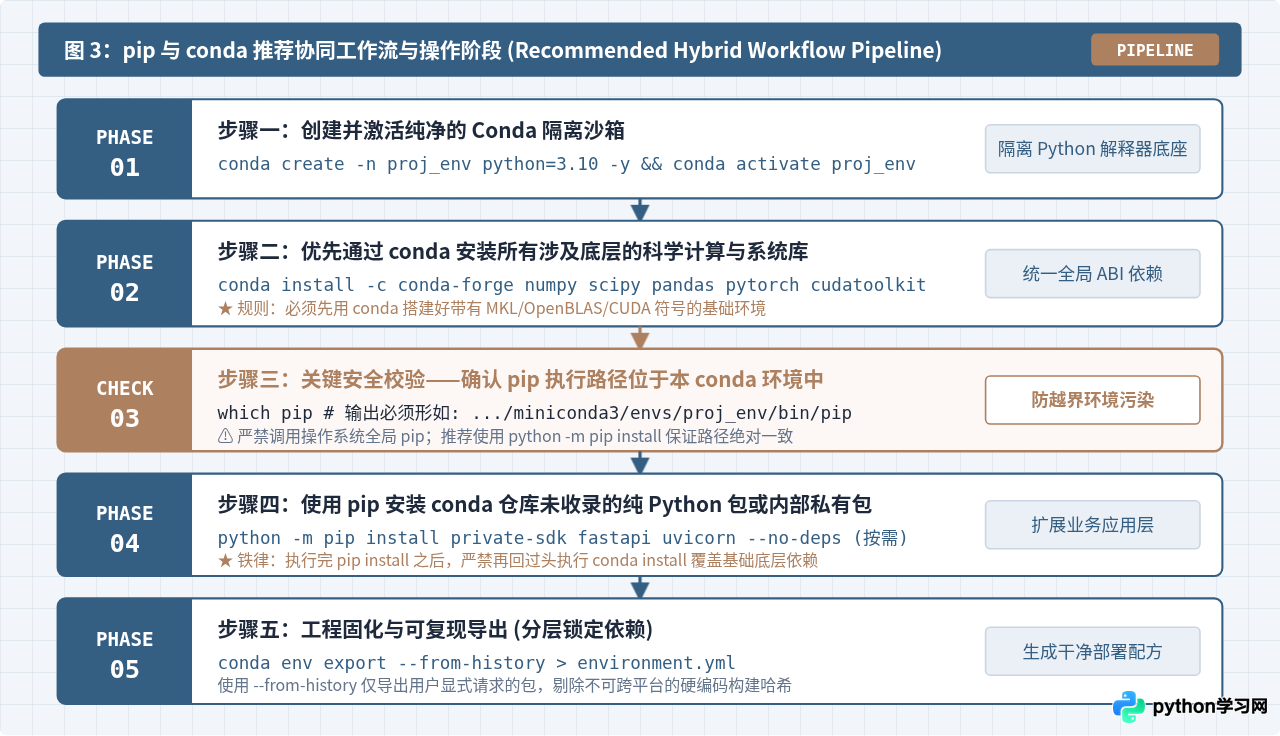
阶段 01:创建并激活纯净的 Conda 隔离沙箱
不要在 base 环境下直接进行业务开发。首先创建一个指定 Python 版本的独立环境:
conda create -n proj_pipeline python=3.10 -y
conda activate proj_pipeline
阶段 02:优先通过 conda 安装所有核心底层库
将所有计算密集、涉及 GPU/CUDA、C++ 扩展或科学计算的大型库,全部在这一阶段通过 conda(推荐使用成熟的社区源 conda-forge)一次性安装完毕:
# 在使用 pip 前,让 conda 完成全部底层 ABI 与复杂库的求解
conda install -c conda-forge numpy scipy pandas scikit-learn pytorch cudatoolkit -y
阶段 03:关键安全校验——确认 pip 执行路径
很多开发者在终端执行 pip install 时,误调了全局操作系统的 /usr/bin/pip,将包错误地装到了外部系统目录中。在调用 pip 之前必须检查:
which pip最佳实践建议:使用 python -m pip install ... 代替直接调用 pip install,这能在语法层面确保调用的是当前激活环境中解释器专属的 pip 模块。
阶段 04:调用 pip 安装 PyPI 独有包
仅在 conda 仓库中找不到该包,或者需要针对纯 Python 模块使用特定预发布版本时,才调用当前环境内的 pip 进行安装:
# 安装纯应用层包、专有 SDK
python -m pip install fastapi uvicorn pydantic-settings

# 黄金法则:此步骤之后,不要再在该环境中执行 conda install 覆写核心基础库!
阶段 05:工程固化与可复现导出
为了让同事或 CI/CD 机器能够一键复现你的混合环境,推荐采用分层导出策略,规避硬编码机器哈希:
# 导出仅包含显式安装意图的 conda 规范配置(跨平台兼容)
conda env export --from-history > environment.yml

# 导出 pip 单独管理的包列表
python -m pip list --format=freeze --not-required > requirements.txt
六、选型决策指南与全维度总结
在立项或搭建工程脚手架时,选择 pip 还是 conda 取决于项目的技术栈属性与交付部署环境。
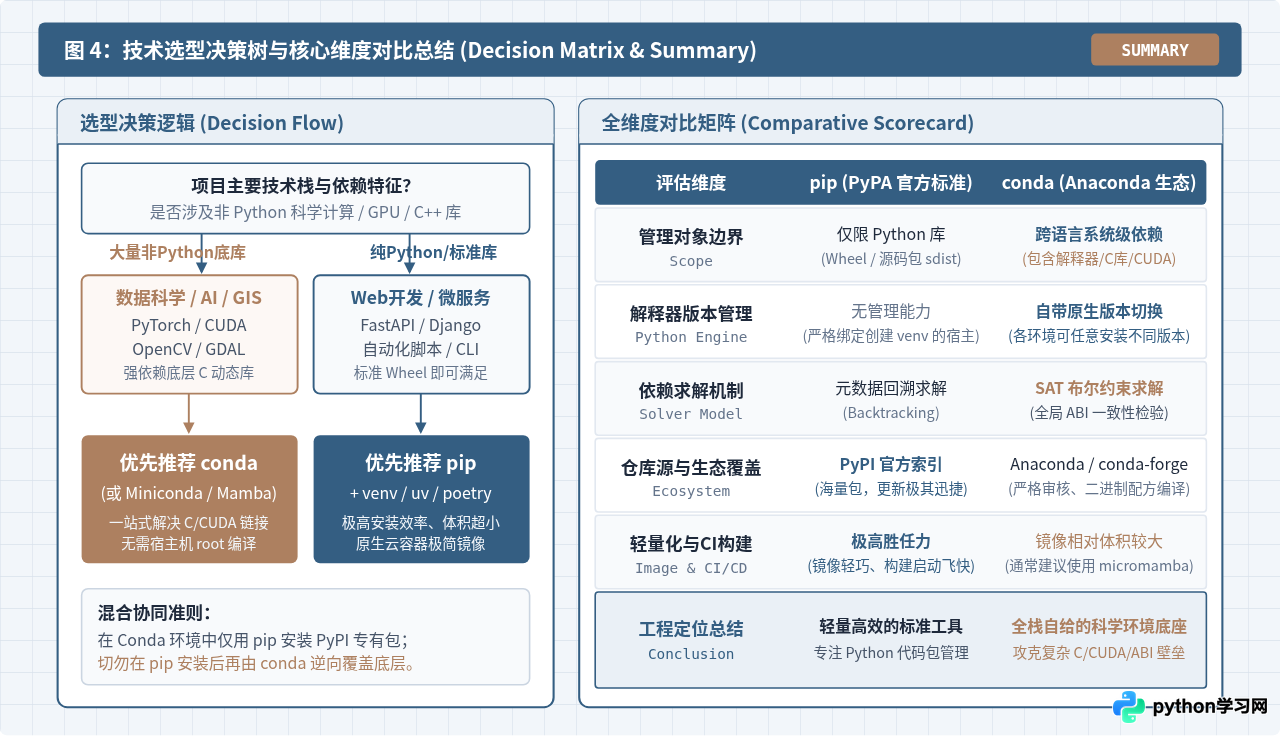
1. 优先选择 pip(+ venv / uv / poetry)的典型场景
- Web 开发与微服务架构:如基于 FastAPI、Django、Flask 构建的 RESTful 服务,依赖大多为纯 Python 库或已有跨平台二进制 Wheel 的通用库。
- 轻量化 Docker 容器与云原生交付:在构建 Docker 基础镜像时,基于官方
python:3.11-slim搭配 pip 构建的镜像通常只有 100MB~200MB,构建速度极快,适合频繁弹性扩缩容的 Kubernetes 集群。 - 追求极速依赖解析:结合现代现代化打包工具(如 Rust 编写的
uv),基于 PyPI 的依赖安装耗时可缩短至秒级。
2. 优先选择 conda(Anaconda / Miniconda / Mamba)的典型场景
- 数据科学、统计分析与机器学习研发:需要开箱即用经过 Intel MKL 或 OpenBLAS 极致硬件优化的 NumPy、SciPy。
- 深度学习与复杂 GPU 运行时:需要本地管理多套不同版本的 CUDA Toolkit、cuDNN,且不想或者没有权限在服务器操作系统上覆盖安装 NVIDIA 驱动工具链。
- 涉及非 Python 语言绑定的领域:如地理信息系统(GDAL、GEOS)、生物信息学(Bioconda 体系)、音视频底层处理(FFmpeg C 动态库绑定)。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















