


Python for循环可以遍历哪些数据类型
详细讲解Python中for循环支持遍历的所有数据类型,包括常用内置容器、数字范围、文件对象、生成器以及自定义可迭代对象,并深入剖析可迭代协议与常见遍历陷阱。
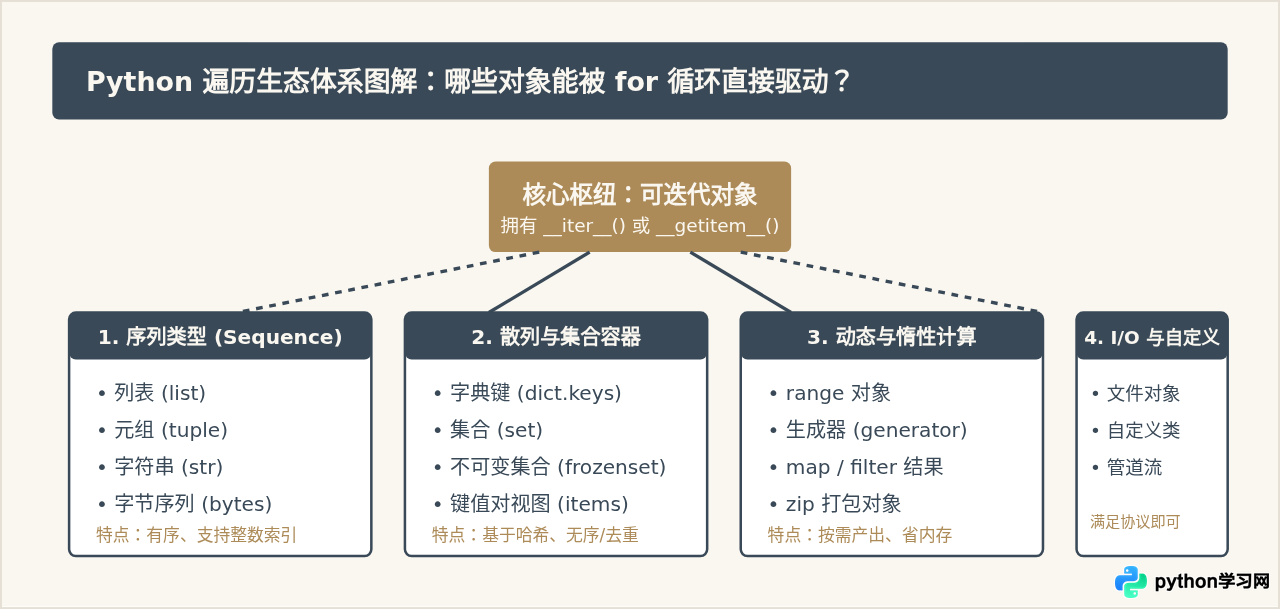
在 Python 中,for 循环不仅限于数组或简单的数值范围,它本质上可以遍历任何“可迭代对象”(Iterable)。简而言之,只要一个数据类型实现了迭代协议(即包含 __iter__() 方法,或者实现了从 0 开始索引的 __getitem__() 方法),它就可以直接作为 for 循环的遍历对象。本文将逐一梳理 Python 中支持遍历的核心内置类型、高级数据流对象,并深入解释底层的判断依据与操作细节。
一、标准序列类型:有序集合的顺次访问
序列类型是初学者最熟悉的遍历对象。它们内部的元素按照严格位置排列,for 循环在遍历时会从下标 0 开始,依次取出每个元素,直到末尾。
1. 列表(list)与元组(tuple)
列表是可变的,元组是不可变的,但两者在 for 循环中的行为完全一致:每次循环都会提取一个单元格里的对象引用。
# 列表遍历示例
frameworks = ["Django", "Flask", "FastAPI"]
for fw in frameworks:
    print(fw)

# 元组遍历示例
coordinates = (10, 20, 30)
for point in coordinates:
print(point * 2)Flask
FastAPI
20
40
60
2. 字符串(str)与字节序列(bytes)
字符串在 Python 中本质上是只读的字符序列。遍历字符串时,循环变量会逐个取出长度为 1 的单个字符子串。而在遍历 bytes 对象时,取出的则是每个字节对应的 0 到 255 之间的十进制整数。
# 遍历字符串
text = "Py"
for char in text:
    print(f"字符: {char}")

# 遍历字节序列
data = b"Py"
for byte_val in data:
print(f"字节数值: {byte_val}")字符: y
字节数值: 80
字节数值: 121
二、散列与非序列容器:字典与集合
集合与字典不以整型索引作为排列依据,但它们依然是内置的可迭代对象。由于集合和字典内部依赖哈希表组织数据,遍历时需要特别注意所获取的究竟是哪部分内容。
1. 字典(dict)的各种视图
如果直接将字典变量放在 for 循环后,默认遍历出的是字典的所有键(keys)。如果需要同时获取值,或者单独遍历值,应当使用字典提供的视图方法。
user = {"name": "Alice", "role": "Engineer"}

# 方式 1:默认直接遍历 -> 遍历键
for key in user:
    print(f"键: {key}")

# 方式 2:使用 items() -> 同时解包键与值
for key, value in user.items():
print(f"{key} => {value}")键: role
name => Alice
role => Engineer
2. 集合(set)与不可变集合(frozenset)
集合中的元素互不重复。遍历集合会取出当中的每一个成员。需要牢记的是:虽然 Python 集合在实现上会遵循某种插入留痕逻辑,但在逻辑概念上它们是无序的,因此程序逻辑绝不能依赖集合的遍历顺序。
list 或 dict)的过程中,严禁动态添加或删除元素。在遍历字典时改变其大小会直接抛出 RuntimeError: dictionary changed size during iteration;而在遍历列表时删除元素会导致索引错位,跳过后续元素。
三、数值范围与惰性计算对象
实际工程中,大量数据无法或者无需一次性存放在内存中。Python 使用惰性计算(Lazy Evaluation)对象来支持高效的循环驱动。
1. range 对象
很多初学者以为 range(1, 1000000) 会在内存中生成一个包含一百万个数字的巨大列表,但事实并非如此。range 是一种不可变序列,它在每次迭代被请求时,基于起始值、步长和索引动态算出一个整数,内存消耗固定且极小。
# 遍历动态数字区间
for num in range(1, 4):
    print(f"Step {num}")
2. 生成器与推导式迭代
使用带有 yield 语句的生成器函数,或者使用生成器表达式 (x for x in ...) 生成的对象,也是 for 循环最常见的使用场景。此类对象只能向后步进,一旦全部遍历完毕便会耗尽,无法从头重复执行。
def countdown(n):
    while n > 0:
        yield n
        n -= 1

for val in countdown(3):
print(f"倒计时: {val}")倒计时: 2
倒计时: 1
四、I/O 数据流:文件对象的逐行遍历
除了纯内存数据,操作系统提供的文件输入输出句柄也是标准的可迭代对象。当打开一个文本文件时,文件句柄会在内部封装基于换行符的缓冲区逻辑,使 for 循环可以逐行提取内容,而不需要把整个几 GB 的文件一次性读入内存。
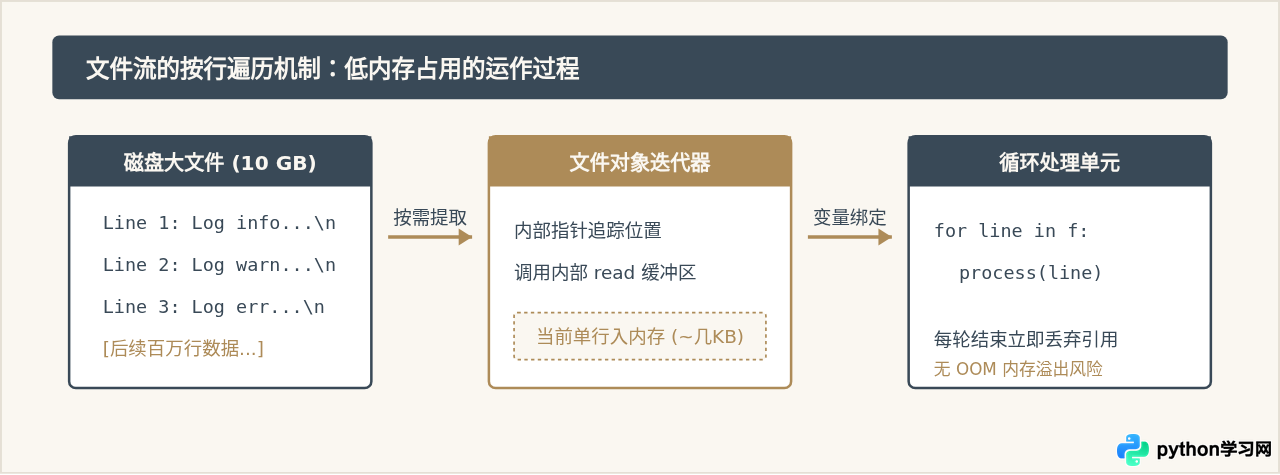
推荐的代码写法是配合上下文管理器 with 一同使用:
# 推荐的流式逐行遍历文件方式
with open("sample.log", "r", encoding="utf-8") as file:
    for line in file:
        # 去除行末换行符并处理
        cleaned_line = line.strip()
        if "ERROR" in cleaned_line:
            print(cleaned_line)
五、底层机制:for 循环究竟如何判定一个类型是否可遍历
了解具体的内置类型后,更深层的问题是:Python 的 for 循环在幕后到底对传入的对象执行了什么操作?
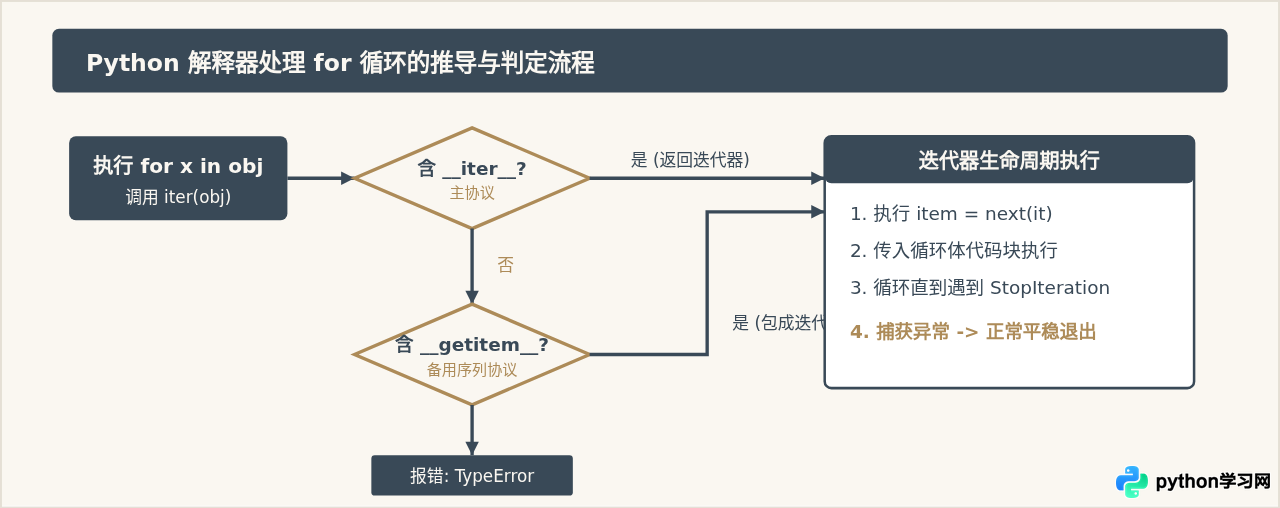
当执行 for item in obj: 时,Python 解释器并不是立刻调用类似 length 的属性,而是遵循一套标准的操作流程:
- 首先调用内置函数
iter(obj),尝试获取该对象的迭代器(Iterator)。 iter(obj)会优先检查obj是否实现了__iter__()方法。如果实现了,调用它返回一个迭代器。- 如果未定义
__iter__(),解释器会回退检查该对象是否具备__getitem__()方法。若具备,Python 会自动创建一个通过索引0, 1, 2...递增访问的序列迭代器。 - 如果两者都不存在,Python 抛出
TypeError: '...' object is not iterable,循环终止。 - 若成功拿到迭代器,
for循环在每轮中持续调用next(iterator)获取下一个元素,直到捕获到StopIteration异常并自动优雅退出。
六、扩展应用:自定义数据类型的遍历
基于上述底层协议,我们完全可以让自己编写的自定义类支持 for 循环。只需要在类中编写 __iter__() 方法,并使其返回一个满足迭代协议的对象即可。
# 编写一个能够被 for 循环直接遍历的自定义数据结构
class TaskQueue:
    def __init__(self):
        self.tasks = []

    def add(self, task_name):
        self.tasks.append(task_name)

    def __iter__(self):
        # 借助列表本身的迭代器返回
        return iter(self.tasks)

queue = TaskQueue()
queue.add("数据备份")
queue.add("日志清理")

for task in queue:
print(f"执行任务: {task}")执行任务: 日志清理
七、反例与常见误区:哪些数据类型不能直接遍历
明确了能够遍历的对象,反向识别不能遍历的类型同样重要。在日常编写代码时,以下几个类型最容易被错误地传递给 for 循环:
- 单精度/任意数值类型(
int,float,complex):数字是一个单一标量,并没有“下一个”的概念。如果写出for i in 5:,解释器会立即产生错误,必须使用for i in range(5):。 - 布尔值(
bool):True和False也是标量,不能被遍历。 - 空值(
NoneType):当某个函数没有返回值却被当作数据源直接遍历(如for item in func_without_return():),会引发TypeError: 'NoneType' object is not iterable。 - 自定义类未实现协议:普通对象如果没有定义
__iter__或__getitem__,直接放入循环会抛出不可迭代的异常。
如果需要在代码中以防御性方式提前确认一个变量能否被 for 循环使用,可以使用标准库中的抽象基类来进行检测:
from collections.abc import Iterable

data = 100
if isinstance(data, Iterable):
    for x in data:
        print(x)
else:
    print("当前变量不可被 for 循环遍历")
八、总结与速查清单
只要牢记“可迭代对象就是可被 for 循环消费的数据源”,面对任何数据类型时都可以快速得出结论。以下表格与对比图对常见数据类型及其遍历产物进行了全面总结:
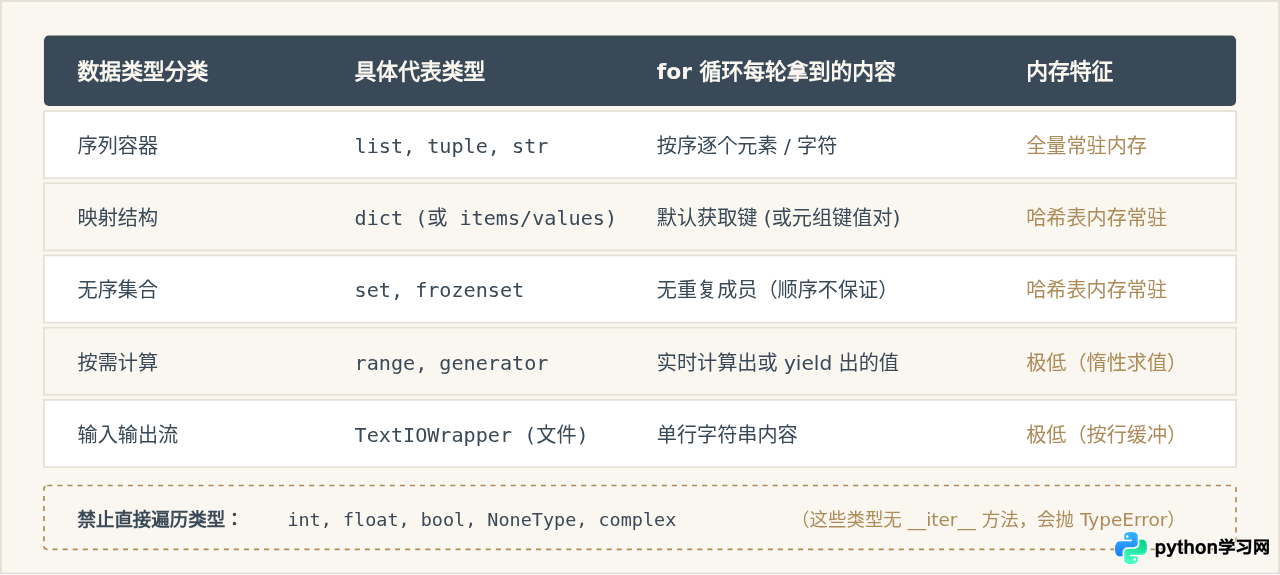
在实际编码时,如果你希望让任何数据类型进入 for 循环,只要确认该类型满足以下两个条件之一即可:内置可迭代容器,或者自身定义了规范的迭代方法。掌握这一规则后,无论是操作原生数据还是设计复杂的工程业务类,循环逻辑都能够稳定、清晰地运行。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















