


为什么Anaconda安装库更快?解析conda预编译二进制包与pip源码编译的差异

在安装 NumPy、SciPy、PyTorch、OpenCV 等科学计算与机器学习重型库时,许多开发者会明显感受到 Anaconda (conda) 的安装速度和成功率高于传统的 pip。其根本原因并非网络带宽差异,而是底层技术路径的截然不同:conda 始终分发并部署已包含 C/C++/Fortran 底层动态库的“全栈预编译二进制包”,并通过操作系统级硬链接实现极速解压与复用;而 pip 在缺少特定硬件平台 Wheel 文件或依赖系统级非 Python 运行时库时,会自动回退为本地源码编译(sdist),触发漫长的 GCC/Clang 编译构建流程。
一、包管理器的底层定位:语言层工具与系统级分发器的差异
要理解安装速度的差距,首先需要看清 pip 与 conda 在软件架构层次上的本质分工。很多初学者容易将它们简单归类为同一种“Python 下载器”,但它们在设计哲学和管辖边界上存在本质区别:
- pip 的定位是纯 Python 语言级包管理器:它主要管理符合 Python 官方打包标准(PEP 规范)的模块。pip 关注的是 Python 代码本身以及构建好的 Wheel 格式文件。对于 Python 模块所依赖的系统级动态链接库(例如系统底层的 OpenBLAS、Intel MKL 数学库、CUDA Toolkit、HDF5 或 libpng),pip 默认假设这些依赖已由操作系统预先安装并配置好。
- conda 的定位是跨语言的系统级包和环境管理器:conda 并不局限于 Python。在 conda 的视角中,Python 解释器本身也只是一个预编译好的二进制软件包(类似于与 C 语言库平级的二进制实体)。当安装一个需要底层算力加速的科学计算库时,conda 会同时拉取该库本身及其所有的底层 C/C++ 共享依赖库,甚至包括对应版本的编译器运行时(如 libgfortran、libstdc++)。
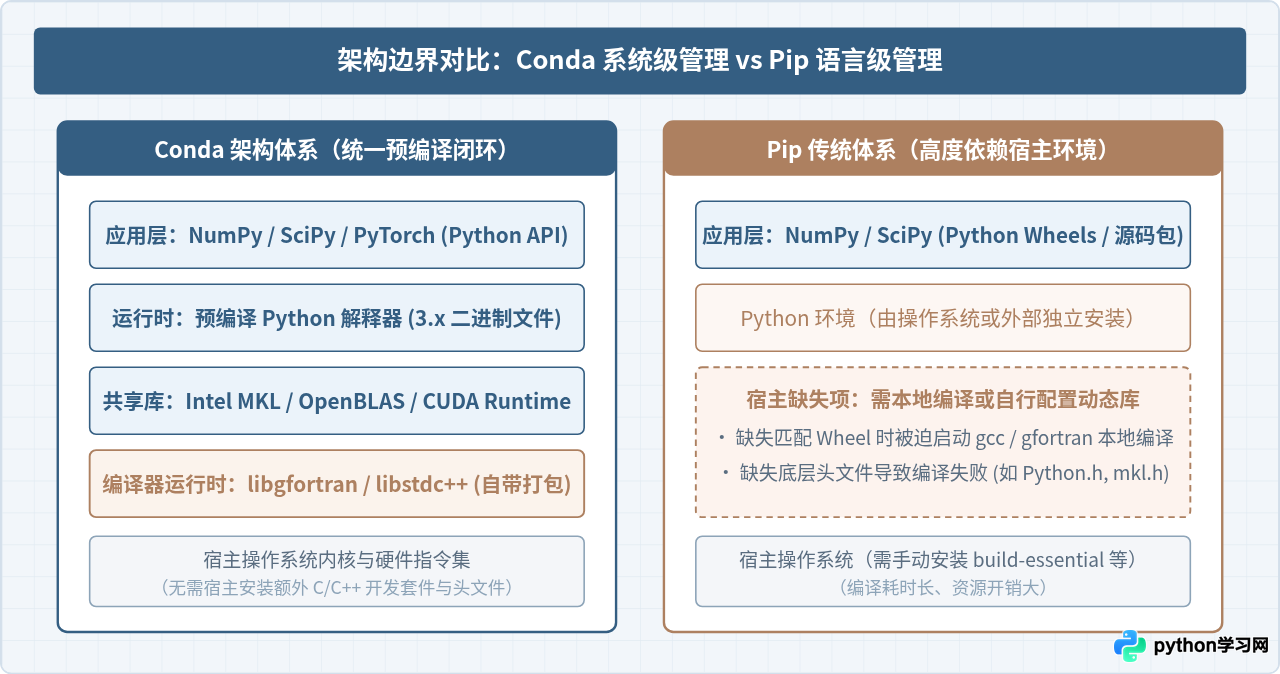
这一架构差异直接决定了安装过程的处理方式:
- 当通过
conda install scipy时,conda 仓库中已经包含了针对当前操作系统编译好的全部二进制目标文件(包含.so/.dylib/.dll以及预置的libmkl数学库)。安装过程只需下载、解包并安置在指定虚拟环境目录下。 - 当通过
pip install scipy时,如果 PyPI 上恰好有匹配当前 Python 版本与操作系统架构的 Wheel 文件,安装尚能较为顺畅;但一旦没有完全兼容的 Wheel(例如特定 Linux 发行版、新型 CPU 架构、旧版本 Python 或非标准 glibc 环境),pip 便会拉取.tar.gz源码包(sdist),在本地机器上现场配置编译环境、调用本地编译器重新构建整个 C/Fortran 扩展库。
二、安装执行全流程剖析:解压硬链接 vs 本地编译链
从用户敲下回车键到模块可以被 import 成功,两个工具在计算机后台执行的操作链条截然不同。了解这一过程可以清楚地解释为什么 pip 经常“卡在某个进度条几十秒甚至几十分钟”。
1. Conda 的执行链条:纯文件解压与原子级硬链接(Hardlink)
Conda 的安装几乎全部是I/O 读写与文件系统链接操作,计算复杂度极低:
- 依赖求解(Solving Environment):解析依赖关系图,确定与当前环境互不冲突的具体包版本组合。
- 下载预编译包:获取扩展名为
.tar.bz2或现代.conda格式的归档文件。这些文件是官方构建服务器已经编译优化完毕的纯二进制资产。 - 解压至全局包缓存池(Package Cache):解压至 Anaconda 的
pkgs/目录下。 - 创建硬链接(Hard Link):将文件从全局缓存池链接至具体虚拟环境的
site-packages和bin目录。因为硬链接只在文件系统 inode 表中增加引用计数,并不发生真实的磁盘数据块重复拷贝,耗时通常仅需几毫秒。
2. Pip 遇到源码包时的编译执行链条:CPU 与内存的极限消耗
当 pip 无法命中 Wheel 或用户指定从源码构建时,pip 必须在本地把 Python 项目当成纯 C/C++ 工程进行从头编译:
- 下载源码包(sdist):获取
.tar.gz源码,包含未经编译的.c、.cpp、.f90(Fortran)源文件及构建配置文件。 - 构建隔离环境(PEP 517/518):在临时目录建立隔离的构建环境,下载
setuptools、wheel、meson-python、cmake等构建工具链。 - 调用本地编译器(本地编译瓶颈):启动本地安装的 GCC、Clang 或 MSVC。编译器需要对数十万行甚至数百万行底层代码进行语法分析、词法分析、模板展开、优化和汇编。
- 静态/动态链接与系统库探测:编译各目标文件(
.o/.obj),并尝试寻找操作系统里的 BLAS/LAPACK、CUDA 或头文件。若找不到相应开发库(如缺少libffi-dev、python3-dev),编译直接报语法错误或链接中断。 - 打包为临时 Wheel 并解压:在本地生成临时 wheel 包后再解包到当前环境目录中。
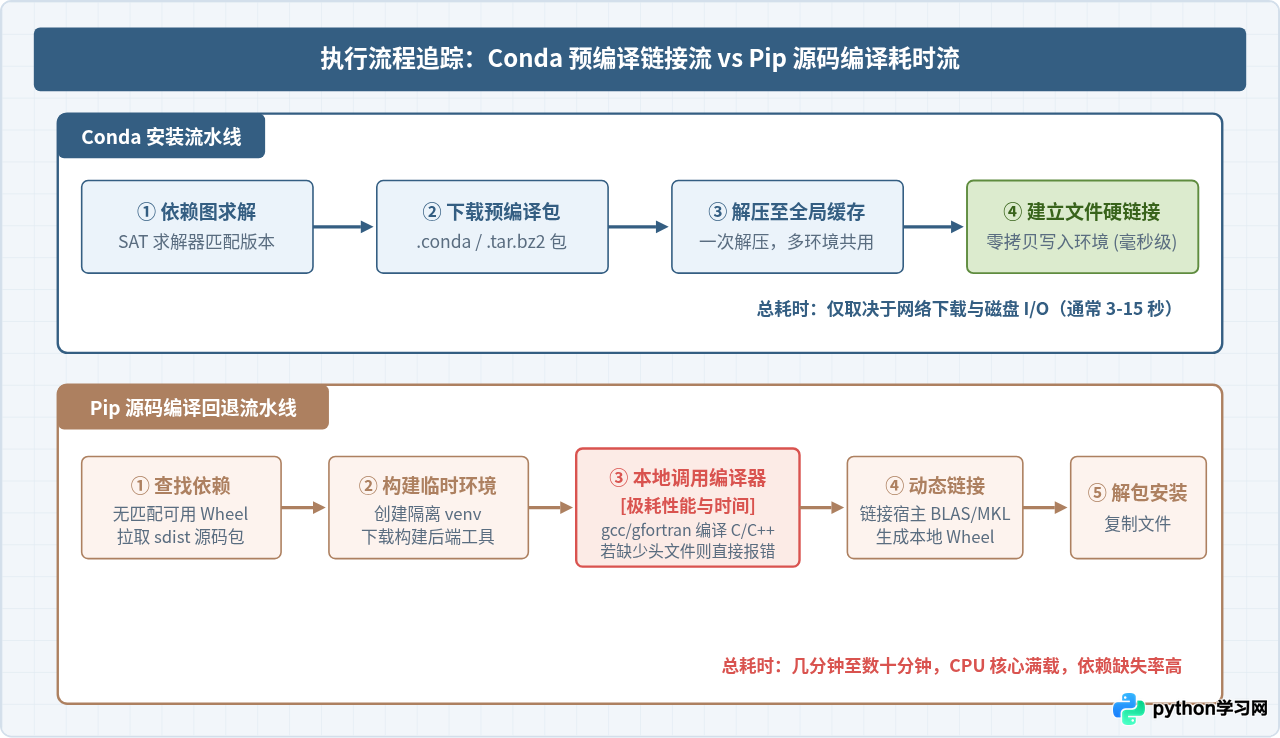
在日常使用中,当你看到终端里输出如下信息时,说明 pip 已经放弃了快速二进制安装,转入耗时的本地源码编译阶段:
# 出现如下提示意味着 pip 正在调用本地编译器构建源码:
Building wheels for collected packages: scipy
  Building wheel for scipy (pyproject.toml) ... \
  Running meson setup ...
  Compiling C++ object scipy/special/...
  Running C++ compiler: g++ -O3 -fPIC ...
对于 SciPy、Pandas 这类包含大量 C++ 模板展开或 Fortran 代码的库,单核编译常常需要持续 10 到 30 分钟。如果此时宿主系统缺少诸如 gcc、gfortran 或相应的开发头文件,终端就会在十几分钟后直接抛出长串红字 Failed building wheel for ...。
三、核心底层原理:Conda 二进制包是如何打包并解耦宿主环境的?
为什么 Conda 能做到“不管宿主系统装没装 GCC 或 MKL,拿来就能直接跑”?这依赖于 Conda 官方(及 Conda-Forge 社区)极其精密的预编译二进制构建规范:
1. 完整的非 Python 依赖图解与动态库内嵌
在 Linux/macOS 环境下,动态链接库通过符号表寻找依赖。普通应用依赖于操作系统的 /usr/lib 或 /lib64。如果系统环境中的 libstdc++.so 版本过低,程序就无法启动。
Conda 在编译每一个包时,会通过 RPATH(Run-time search path,运行时共享库搜索路径)技术,将二进制可执行文件与动态库的检索目标强制锁定在当前 Conda 环境的 lib/ 目录下(使用类似 $ORIGIN/../lib 的相对寻址)。
这意味着:Conda 环境内的每一个包都自带了它所需要的一切依赖动态库,与宿主操作系统的全局库实现物理隔离。因此,Conda 不需要借助本地编译器来适应当前系统的库版本,官方直接分发最适合该架构的优化版本。
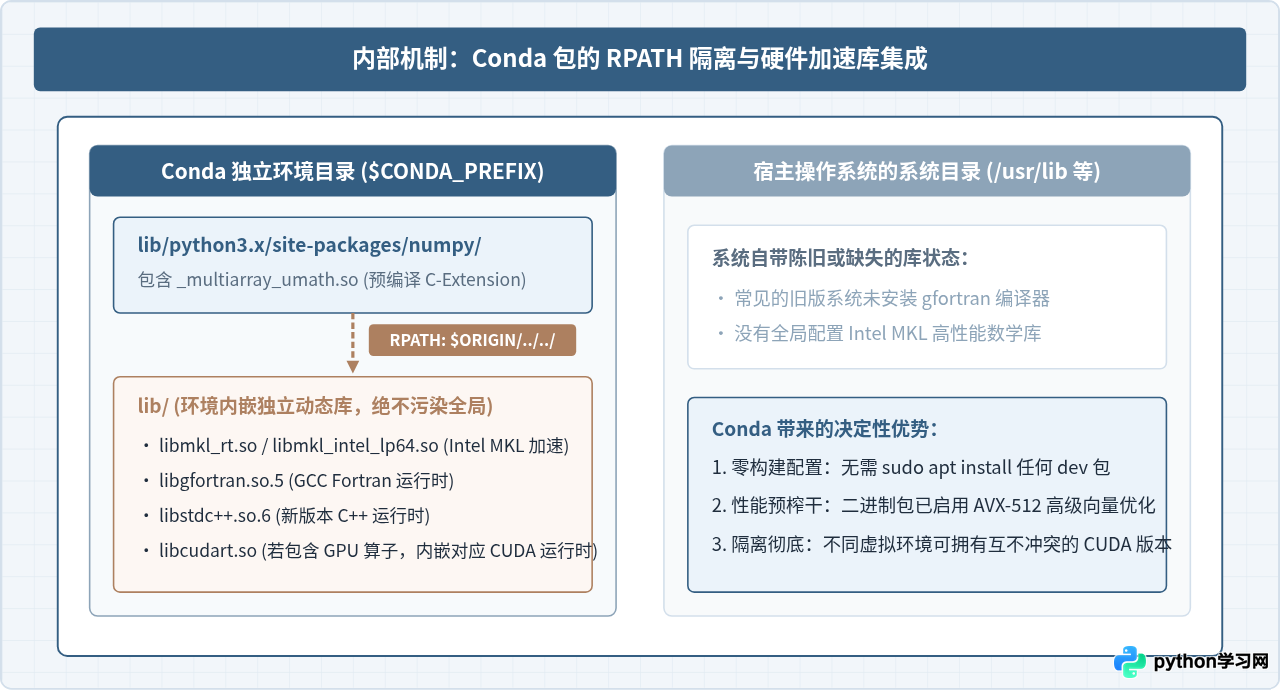
2. 数学优化加速库(Intel MKL)的默认绑定
在 Anaconda 官方通道分发的 NumPy、SciPy 中,默认直接链接了 Intel MKL(Math Kernel Library)。而在 PyPI 上,为了保证分发兼容绝大多数普通 Linux 机器,默认的 manylinux wheel 包通常链接相对保守的 OpenBLAS。如果通过 pip 源码编译安装,用户不仅需要自行下载配置 MKL,还需要配置正确的编译标志,否则只能降级运行在低速的基础数学库上。
四、现代 Pip 也有 Wheel,为什么有时依然感觉 conda 更快?
细心的读者可能会提出疑问:“现代 PyPI 已经大量普及了 .whl(Wheel)二进制包,pip 安装很多库也是直接下载 wheel,为什么依然有人觉得 conda 体验更快?”这里涉及以下三项实际工程细节:
| 影响维度 | Anaconda / Conda | Pip (即使命中 Wheel) |
|---|---|---|
| 全局缓存复用机制 | 采用硬链接(Hard Link)。无论新建多少个环境,同一版本的包只需解压一次,后续环境瞬间完成,不占用额外磁盘空间。 | 采用复制机制(Copy)。即使本地有 Wheel 缓存,创建新环境时仍需将解压后的文件物理拷贝至目标目录,I/O 开销随环境增多而线性增加。 |
| GPU/深度学习驱动套件 | 直接分发 cudatoolkit 预编译二进制包。用户机只要有 NVIDIA 基础驱动,conda 即可直接配齐 CUDA 运行环境,开箱即用。 |
虽然近年 PyTorch 提供了庞大的独立 wheel 源,但 pip 本身无法统一管理系统级 CUDA 工具链与底层 C++ 库版本,易出现驱动匹配冲突。 |
| 多包协同一致性 | 统一由 SAT 依赖图求解器在下载前完成全局锁步,确保安装后 100% 具备兼容的二进制 ABI。 | pip 早期按先后顺序单包安装,容易在多依赖复杂项目下反复覆盖并重装,现代解析器虽有改善但仍不及 conda 彻底。 |
五、综合对比与技术选型建议
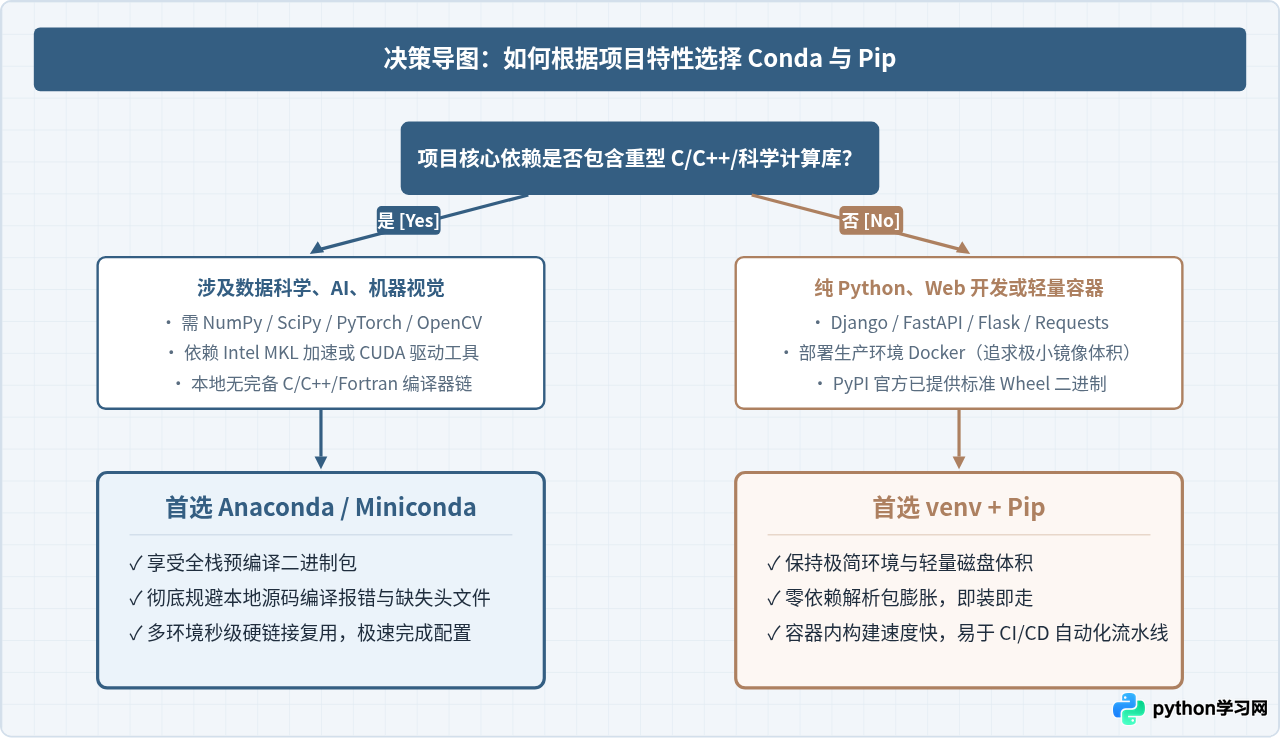
通过深入剖析,我们可以明确:Conda 的“快”建立在官方服务器提前承担了极其繁重的预编译工作、全栈打包了复杂 C/C++ 动态链接库,并借助文件系统硬链接极速落地的基础之上。但这并不意味着在所有场景下都应盲目使用 Conda:
- Conda 的代价:元数据体量庞大,解析依赖图(Solving Environment)往往需要消耗一定时间和内存(推荐升级至采用 C++ 实现的
conda-libmamba-solver解决此瓶颈);此外,Conda 基础环境体积较大,不适合追求极致轻量(几十兆)的生产 Docker 基础镜像。 - Pip 的优势:社区生态更新最快,海量第三方 Python 纯代码库首发于 PyPI;对于标准 Web 服务(如 FastAPI、Django、Requests)、自动化运维脚本或精简容器构建,使用
pip install配合 Wheel 是体积最小、启动最直接的方式。
conda config --set solver libmamba 切换为基于 C++ 实现的新一代 mamba 依赖求解引擎。这样既能保留 conda 预编译二进制免除本地编译的极速优势,又能将依赖解析时间缩短至几秒钟内。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















