


怎么编写Pythonic代码:Python 3进阶最佳实践与规范
深入解析如何编写地道的 Pythonic 代码。结合 Python 3 现代语言特性与工程实践,系统阐述迭代协议、上下文管理、四步重构方法、数据建模规范与反模式避坑指南。
编写 Pythonic 代码并不是盲目追求语法奇巧或代码行数的最短化,而是深刻理解 Python 的设计哲学(The Zen of Python),充分利用 Python 3 提供的原生协议、迭代工具、上下文机制与现代类型系统,写出意图明确、执行高效且高度可维护的代码。从初学者写出的“C/Java 方言式 Python”迈向地道的 Pythonic 风格,核心在于实现四项思维转变:从外部索引循环转向原生迭代器与惰性求值;从防御性先验检查(LBYL)转向事后宽容请求原谅(EAFP);从无序散漫字典转向结构化强约束数据模型;从分散的手动资源关闭转向确定性的上下文管理器。
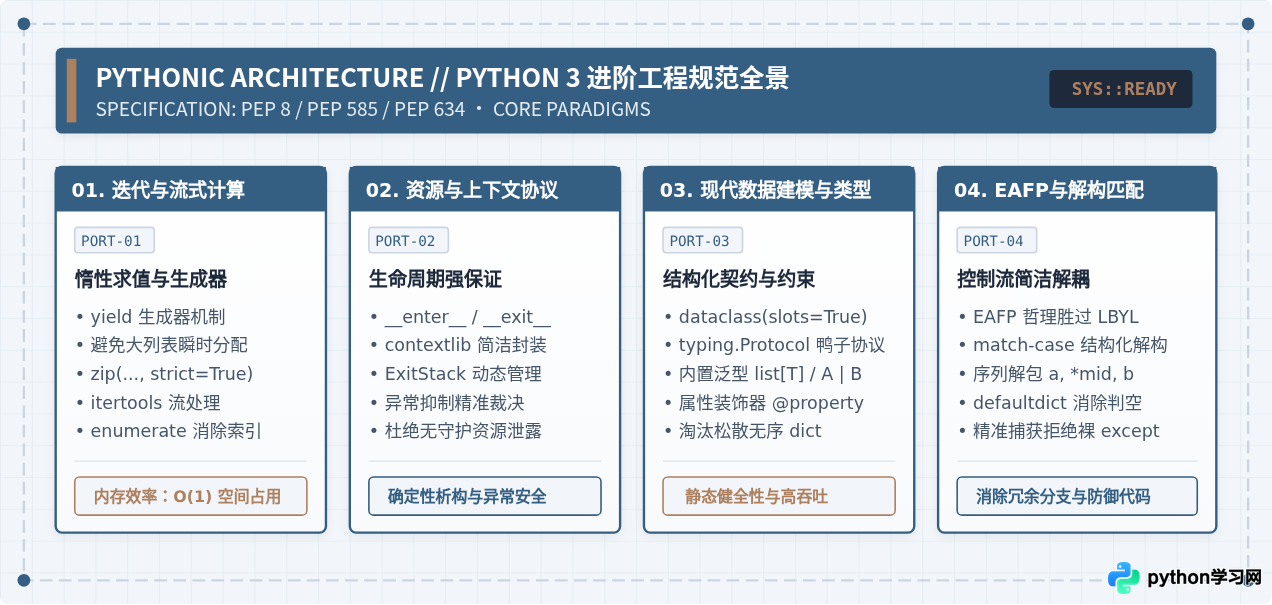
一、迭代哲学:推导式、生成器与内存高效计算
循环是业务代码中出现频率最高的结构,也是最容易暴露出非 Pythonic 风格的区域。初学者往往习惯使用 range(len(sequence)) 通过整数下标访问元素,这种写法不仅冗长,而且直接破坏了 Python 迭代器协议的优雅性与安全性。
1. 掌握解包与高级迭代原语
在 Python 3 中,容器本身就是可迭代对象。当需要同时获得下标与元素时,标准库提供了 enumerate();当需要同步遍历多个序列时,应当使用带完整性检查的 zip(..., strict=True)。
# 冗长且容易发生索引越界错误
users = ["Alice", "Bob", "Charlie"]
scores = [95, 88, 92]

for i in range(len(users)):
    user = users[i]
    score = scores[i]
print(f"Index {i}: {user} -> {score}")# 利用 zip 与 enumerate 消除下标取值
users = ["Alice", "Bob", "Charlie"]
scores = [95, 88, 92]
# strict=True (Python 3.10+) 确保长度对齐
for idx, (user, score) in enumerate(
zip(users, scores, strict=True), start=1
):
print(f"Rank {idx}: {user} -> {score}")2. 推导式的边界与滥用防范
列表推导式、字典推导式与集合推导式是 Python 极其精妙的语法糖,但“可读性优先(Readability counts)”是不可动摇的底线。推导式应当只用于纯粹的数据映射与过滤,严禁在推导式中引入带有副作用的函数调用或超过两层的深层嵌套。
- 适合推导式:一维或至多两层的过滤与转换,例如
[x.strip() for x in raw_lines if x.strip()]。 - 严禁推导式:在推导式内部调用
print()、执行socket.send()或写入数据库;若推导式逻辑超过两行,请果断重构为普通的显式for循环。
3. 列表即时加载 vs 生成器惰性拉取
处理大规模数据集时,列表推导式会一次性分配完整的连续内存数组;而生成器表达式 (x for x in data) 则仅创建一个轻量级的生成器对象,按需计算下一个值。
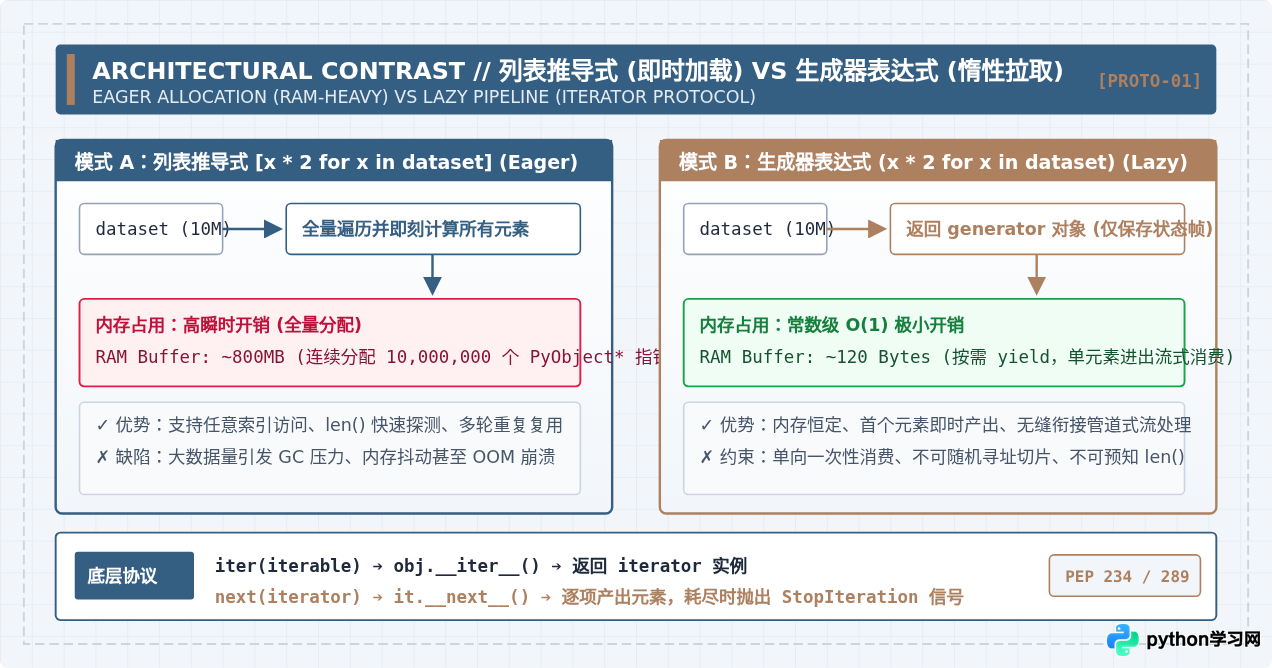
如下示例展示了处理千兆级日志文件时,生成器管道带来的内存稳定性优势:
from collections.abc import Iterator

def read_large_log(file_path: str) -> Iterator[str]:
    """生成器按行流式消费文件,内存占用恒定为 O(1)"""
    with open(file_path, "r", encoding="utf-8") as f:
        for line in f:
            yield line.rstrip("
")

def filter_error_events(lines: Iterator[str]) -> Iterator[str]:
    """管道式处理流:只在下游请求时才执行运算"""
    for line in lines:
        if "ERROR" in line:
            yield line

# 仅构建处理管道,瞬间完成且不消耗任何额外内存
raw_stream = read_large_log("/var/log/app.log")
error_stream = filter_error_events(raw_stream)

# 仅拉取前 5 条错误记录进行审查,其余日志不会被无谓解算
import itertools
for record in itertools.islice(error_stream, 5):
    print("Detected Incident:", record)
二、资源安全与生命周期:上下文管理器协议深度实践
在涉及外部文件、网络套接字、并发线程锁、临时目录及数据库事务等关键资源时,依赖 try...finally 手动关闭资源极易因代码分支疏漏导致资源句柄泄漏。Pythonic 的核心规范之一,就是将一切具有“申请-释放”生命周期的资源交由上下文管理器(Context Manager)托管。
1. 理解 __enter__ 与 __exit__ 协议内核
with 语句通过调用上下文管理对象的 __enter__() 方法准备上下文环境,并在退出代码块时(无论是正常结束还是遭遇异常)无条件调用其 __exit__(exc_type, exc_val, exc_tb) 方法。
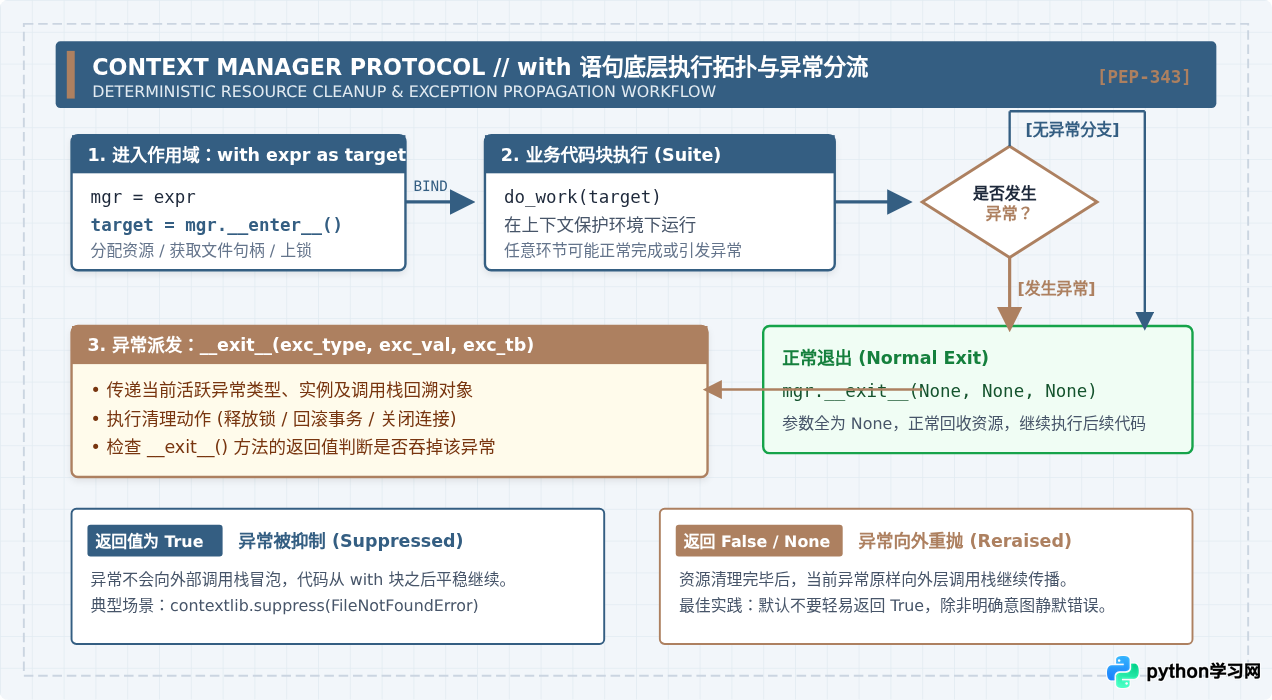
2. 使用 contextlib.contextmanager 编写轻量上下文
对于绝大多数无需维持复杂内部状态的场景,显式编写带有 __enter__ 和 __exit__ 的类显得过于沉重。标准库的 @contextlib.contextmanager 允许我们借助生成器与 yield,用极少代码实现强保障的上下文管理器:
import time
from collections.abc import Iterator
from contextlib import contextmanager

@contextmanager
def execution_timer(label: str) -> Iterator[dict[str, float]]:
    """轻量性能度量上下文管理器,保证执行时间绝对被记录"""
    metrics: dict[str, float] = {"elapsed": 0.0}
    start_time = time.perf_counter()
    try:
        # yield 将控制权交还给 with 代码块,yield 产出的对象被 as 绑定
        yield metrics
    finally:
        # 无论代码块中发生何种异常或早期 return,finally 必保执行
        metrics["elapsed"] = time.perf_counter() - start_time
        print(f"[{label}] Execution Duration: {metrics['elapsed']:.6f}s")

# 实际使用示例
with execution_timer("Matrix-Multiplication") as stat:
    total = sum(i * i for i in range(1_000_000))
    # 可在上下文中动态检查耗时数据
3. 多资源动态管理:避免 with 嵌套阶梯
当面对未知数量的资源或者动态列表时,不要写出层层缩进的嵌套 with。标准库的 contextlib.ExitStack 提供了以栈式结构动态编排多个上下文管理器的终极方案,它能够确保先打开的资源最后关闭,即使中间某个资源初始化失败,已注册的资源也能安全倒序析构。
from contextlib import ExitStack

def merge_multiple_files(input_paths: list[str], output_path: str) -> None:
    """使用 ExitStack 优雅管理动态数量的文件句柄,防止阶梯式缩进"""
    with ExitStack() as stack:
        # 统一由 stack 管理输入句柄与输出句柄的生命周期
        in_files = [stack.enter_context(open(p, "r", encoding="utf-8")) for p in input_paths]
        out_file = stack.enter_context(open(output_path, "w", encoding="utf-8"))

        for f in in_files:
            out_file.write(f.read())
    # 离开 with 块时,ExitStack 自动确保所有句柄按逆序完全关闭
三、代码重构实战:非 Pythonic 代码的四步演进
重构一段遗留代码,应当像机械工程调校一样,遵循清晰的流水线规范。下面我们将一段充满初学者残留习惯的代码,通过标准四步重构法逐步改造成高质量的 Pythonic 工程实现。
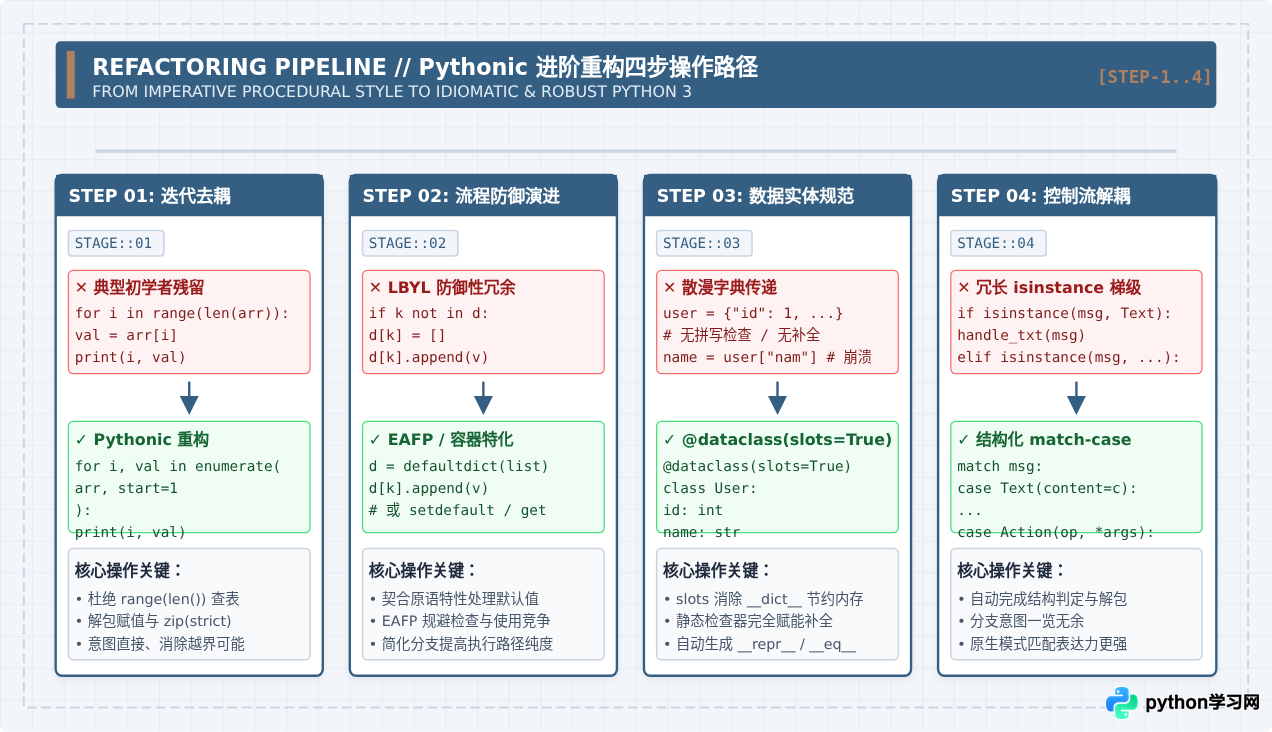
阶段 01:迭代去耦与消除下标硬编码
重构目标:彻底废除 for i in range(len(data)) 查表写法。利用直接解包或 enumerate 将业务意图直接映射在循环头部。
阶段 02:践行 EAFP 原则与使用专用容器
重构目标:减少防御性的前置条件判定(Look Before You Leap)。在 Python 中,哈希表查询、属性提取等操作在大多数场景下都是合法的,反复进行 if key in dict: 判定会造成双重哈希开销,并且在并发环境下存在检查时刻与取值时刻之间的竞态条件(TOCTOU)。应当改用 collections.defaultdict 或通过 EAFP 机制直接捕获预期异常:
# 两次哈希查询,代码冗长
word_freq = {}
words = ["python", "code", "python", "clean"]

for w in words:
    if w not in word_freq:
        word_freq[w] = 0
word_freq[w] += 1from collections import Counter, defaultdict
# 方案 A:专用聚合容器
words = ["python", "code", "python", "clean"]
word_freq = Counter(words)
# 方案 B:针对动态分类的 defaultdict
groups = defaultdict(list)
for w in words:
groups[len(w)].append(w)阶段 03:数据结构升级:用 @dataclass 淘汰松散字典
在系统内部流转数据时,使用裸 dict 极易因为键名拼写错误而在运行时引发深层 KeyError,且没有任何 IDE 代码补全支持。Python 3.7+ 引入了 dataclasses,在 3.10+ 中配合 slots=True,既获得了类属性的静态严谨性,又拥有远高于传统类的内存效率和属性访问速度:
from dataclasses import dataclass

# slots=True 大幅削减实例内存,消除每个对象自带的 __dict__ 字典
# frozen=True 使实例具有不可变特性(哈希安全,可存入 set 或作为 dict 键)
@dataclass(slots=True, frozen=True)
class EndpointConfig:
    host: str
    port: int
    timeout_seconds: float = 5.0
    use_ssl: bool = True

    def __post_init__(self) -> None:
        """用于参数合法性边界防御断言"""
        if not (1 <= self.port <= 65535):
            raise ValueError(f"Invalid network port range: {self.port}")

# 实例化获得清晰类型提示与自动 __repr__
config = EndpointConfig(host="127.0.0.1", port=8443)
print(config)  # EndpointConfig(host='127.0.0.1', port=8443, timeout_seconds=5.0, use_ssl=True)
阶段 04:控制流重构:用 match-case 结构化模式匹配
Python 3.10 引入的结构化模式匹配(PEP 634)并非普通的 C 语言 switch,而是一种强大的解构语法,能在一行内同时完成类型校验、结构析构与变量绑定:
from dataclasses import dataclass

@dataclass(slots=True)
class TextMessage:
    content: str

@dataclass(slots=True)
class MediaMessage:
    mime: str
    payload_bytes: bytes

@dataclass(slots=True)
class SystemCommand:
    action: str
    parameters: dict[str, str]

def dispatch_payload(packet: TextMessage | MediaMessage | SystemCommand) -> str:
    """使用模式匹配优雅解耦分支逻辑,消除层叠 isinstance"""
    match packet:
        case TextMessage(content=txt) if len(txt) > 0:
            return f"Render Text: {txt.strip()}"
        case MediaMessage(mime=mime, payload_bytes=data):
            return f"Process Binary [{mime}], length={len(data)} bytes"
        case SystemCommand(action="REBOOT", parameters={"force": "true"}):
            return "Executing Emergency System Reboot"
        case SystemCommand(action=act):
            return f"Executing Routine Command: {act}"
        case _:
            raise ValueError(f"Unrecognized packet structure: {packet}")
四、现代对象模型与类型系统规范
Pythonic 代码并非没有类型约束的“野蛮生长”。现代 Python 3 已经演进为拥有强大静态分析支撑的成熟生态。
1. 鸭子类型(Duck Typing)与 typing.Protocol
传统的面向对象往往依赖刚性的继承层级(如 class Dog(Animal)),而 Pythonic 遵循结构化子类型(Structural Subtyping):只要对象实现了特定方法,就可以直接充当对应的角色,无需显式继承父类。借助 typing.Protocol,可以在保持运行时灵活性的同时,为类型检查器(如 Mypy)提供 100% 的静态类型安全检查:
from typing import Protocol, runtime_checkable

@runtime_checkable
class Renderable(Protocol):
    """定义只关心行为特征的抽象协议契约"""
    def render(self) -> str: ...

class MarkdownDocument:
    """无继承关系,但实现了协议接口"""
    def render(self) -> str:
        return "# Markdown Header"

class HtmlFragment:
    """同样实现了协议接口"""
    def render(self) -> str:
        return "<div>Content</div>"

def publish_artifact(item: Renderable) -> None:
    # 既通过 mypy 严格静态检查,又完全解耦了继承结构
    output = item.render()
    print("Exported Content:", output)

publish_artifact(MarkdownDocument())
publish_artifact(HtmlFragment())
2. 属性封装准则:放弃 Java 式 Getter/Setter,拥抱 @property
在 Python 中,编写形如 get_value() 和 set_value() 的样板方法属于严重的反模式。Pythonic 规范要求直接将属性暴露为公共字段。只有当未来确实需要引入校验逻辑、缓存或延迟加载时,再在不破坏原有调用方调用方式的前提下,平滑升级为 @property:
class TemperatureSensor:
    def __init__(self, celsius: float) -> None:
        self.celsius = celsius  # 直接暴露属性,调用简洁直观

    @property
    def celsius(self) -> float:
        return self._celsius

    @celsius.setter
    def celsius(self, value: float) -> None:
        if value < -273.15:
            raise ValueError("Temperature below absolute zero is physically impossible!")
        self._celsius = value

    @property
    def fahrenheit(self) -> float:
        """动态计算衍生属性,无需显式存储冗余状态"""
        return self._celsius * 9 / 5 + 32

# 外部调用完全使用直接点号访问语法,兼顾直观性与数据校验
sensor = TemperatureSensor(25.0)
print(sensor.fahrenheit)  # 77.0
sensor.celsius = 30.0     # 触发 setter 校验
五、进阶规避:六大高频反模式与纠偏指南
很多在其他语言中看起来“理所当然”的代码,在 Python 中往往会引发致命陷阱。以下是工业级开发中最常遇到的六大反模式及其标准纠偏方案。
| 反模式现象 | 潜在隐患与破坏点 | Pythonic 修复方案 |
|---|---|---|
可变对象做默认参数def append_item(val, bucket=[]) |
默认参数在模块加载时仅求值一次,所有调用方共享同一个列表,导致严重的数据交叉污染。 | 使用 None 作为哨兵值,在函数体内部执行判定:bucket = [] if bucket is None else bucket |
裸 except: 或过宽异常except Exception: pass |
吞噬代码逻辑错误、拼写笔误,甚至抑制 KeyboardInterrupt 和 SystemExit,使得程序无法正常终止。 |
严格捕获预期异常类型:except (KeyError, ValueError) as err: 并记录具体日志。 |
在长列表中频繁使用 inif item in large_list: |
列表包含查询的时间复杂度为 O(N),在高频循环中直接导致算法退化为 O(N²)。 | 将待查集合转换为哈希结构: 使用 set 或 dict,将查询成本瞬间降至 O(1)。 |
循环内多次 += 拼接字符串s = ""; for c in chunks: s += c |
字符串是不可变对象,每次 += 都会触发全新内存申请与数据拷贝,产生巨大性能损耗。 |
收集到列表后统一使用 "".join(chunks),或者使用 io.StringIO 进行缓冲。 |
| “代码高尔夫”式单行推导 在一行内嵌套 3 层 if 和 for |
严重损害代码可读性与后续排查难度,违背“扁平优于嵌套”原则。 | 拆解为清晰的传统 for 循环,或封装为自描述的管道函数。 |
| 复杂手动合并字典 循环遍历并手动逐项 dict.update() |
代码繁琐冗长,容易在多级覆盖时出现键丢失或逻辑混乱。 | 使用 Python 3.9+ 原生字典合并运算符:merged = base_dict | override_dict |
六、总结与 Pythonic 规范自查矩阵
写出地道的 Pythonic 代码,本质是在直观可读性、执行效率与工程健壮性之间建立均衡体系。在工程日常研发中,团队可以依据以下自查矩阵评估代码质量,并借助自动化工具链实现闭环守护:
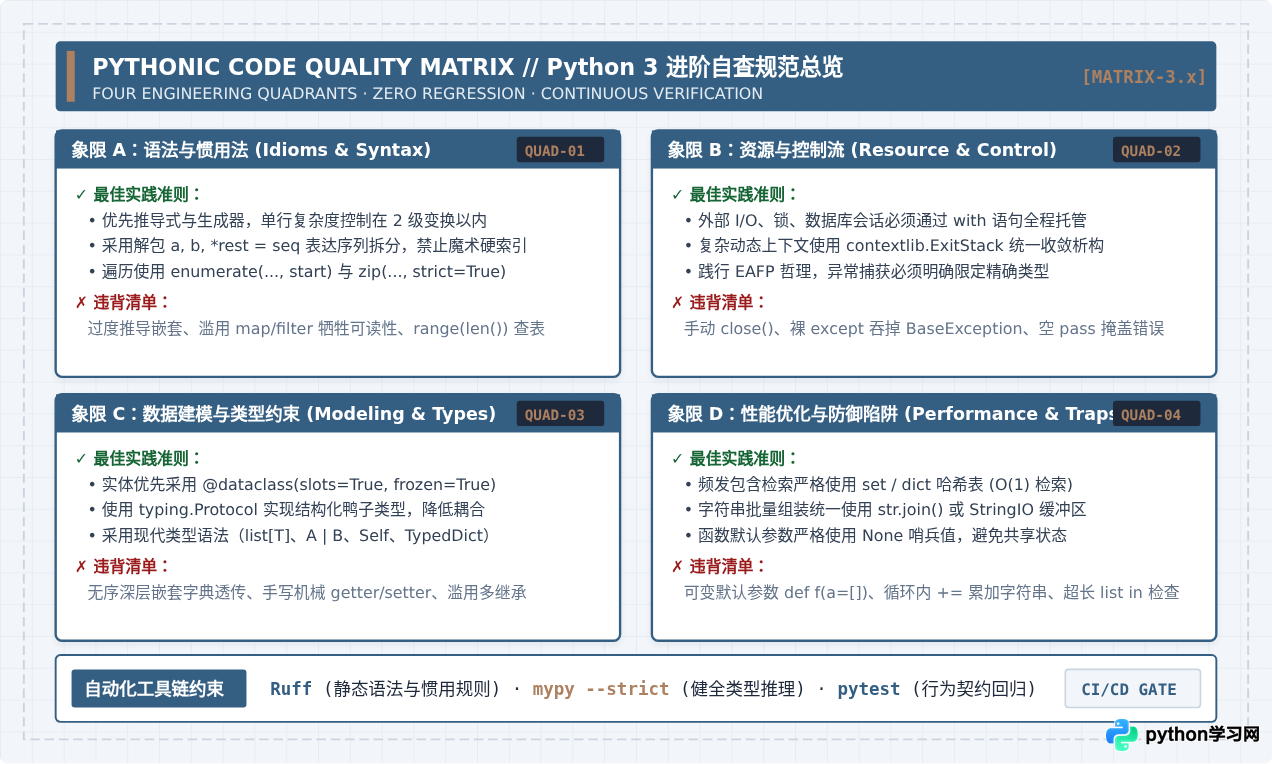
- 引入现代 Lint 工具 Ruff:在开发环境中配置
ruff check .,自动捕获 90% 以上的不良迭代、冗余语法及废弃模式。 - 开启 Mypy 严格模式:配合
typing.Protocol与dataclasses(slots=True),将类型隐患消除在编译与静态扫描阶段。 - 重构自查三问:这段代码是否能利用标准库原语(itertools、contextlib、collections)简化?资源是否全程被
with妥善管理?异常捕获是否精确且保留了调用上下文?
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















