


Python for循环与while循环实现10到1倒序对比
深入解析Python中使用for循环与while循环实现10到1倒序输出的具体方法、执行机制、边界易错点及场景选型依据。
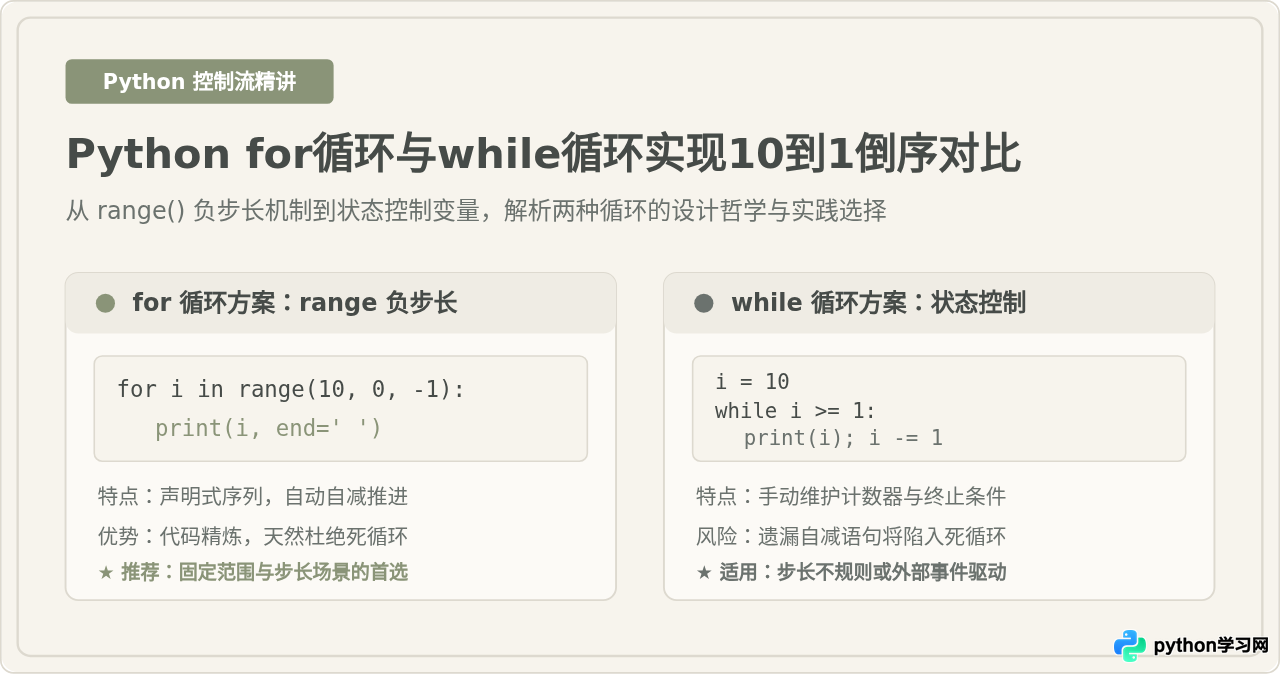
for 循环搭配内置 range(10, 0, -1) 负步长生成器,或是使用 while 循环手动管理计数器变量与递减语句(i -= 1)。虽然两者最终输出的数列完全一致,但底层的控制逻辑存在根本差异:for 循环基于声明式迭代,边界与步长由不可变序列预先约束,具备天然的安全性和更高的执行效率;while 循环基于命令式状态判断,赋予开发者随时修改循环变量的自由度,但也带来了漏写更新引发死循环的潜在风险。理解这两者的细节差异,是掌握 Python 控制流与编写健壮代码的基本功。
一、for循环实现10到1倒序与range()边界推导
Python 的 for 循环本质上是一个迭代器驱动机制,它按顺序从可迭代对象中取出元素,直至耗尽。在输出数字序列时,通常配合内置的 range() 函数使用。实现从 10 倒数到 1 的最简完整代码如下:
# 方式一:使用 for 循环与负步长 range
for i in range(10, 0, -1):
    print(i, end=' ')
print()  # 换行
这段代码由两行构成,其核心全部集中在 range(10, 0, -1) 的三个参数传递上。许多初学者在初次书写时容易产生困惑:为什么终止条件写的是 0 而不是 1?为什么不能像其他语言那样直接从 10 写到 1?这就必须深入理解 range(start, stop, step) 在负步长下的区间数学定义。
1. range() 三参数的具体含义
- start(起始值,此处为 10):序列生成的第一个数字。该值是“包含”(闭区间)的。
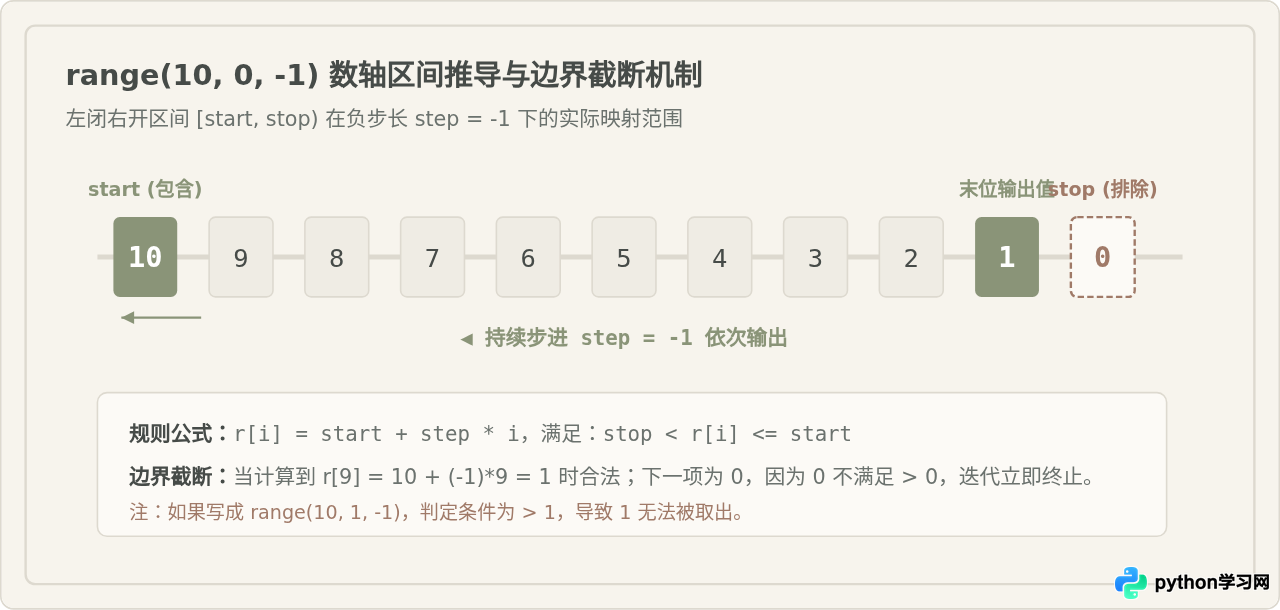
- stop(终止值,此处为 0):循环停止的哨兵边界。无论正序还是倒序,
stop永远是“排除”(开区间)的。当数字步进递减至 0 时,循环立刻终止,因此实际生成的最后一个值是0 - (-1) = 1。 - step(步长,此处为 -1):每次迭代时变量的变化量。传入负整数表示向左递减。
容易混淆的写法是
range(10, 1, -1)。部分初学者认为“既然只需要输出到 1,终止值就应该填 1”。由于右边界始终是开区间,这种写法在到达 1 时直接停止,实际输出仅为 10 9 8 7 6 5 4 3 2,漏掉了关键的 1。另一个经典错误是遗漏步长参数,直接写作
range(10, 0)。在 Python 中,未显式指定步长时默认为 +1。当 start (10) > stop (0) 且步长为正时,无法满足生成条件,Python 会静默返回一个空序列,既不输出任何数字,也不抛出异常,排查时极易被忽略。
二、while循环实现10到1倒序与状态变量管理
与 for 循环将控制权交给内部迭代器不同,while 循环是完全基于条件表达式的命令式结构。它在每一轮迭代开始前求值布尔表达式,若为真则执行循环体。实现 10 到 1 倒序的完整代码如下:
# 方式二:使用 while 循环与自减计数器
i = 10              # 步骤1:初始化计数器
while i >= 1:       # 步骤2:判断循环终止条件
    print(i, end=' ')
    i -= 1          # 步骤3:更新循环变量状态
print()
while 循环的正确运行严格依赖于“循环三要素”:初始化变量、继续条件判断以及体内的变量状态更新。缺少任何一个环节,代码就会偏离预期。
1. 为什么条件是 i >= 1 或 i > 0
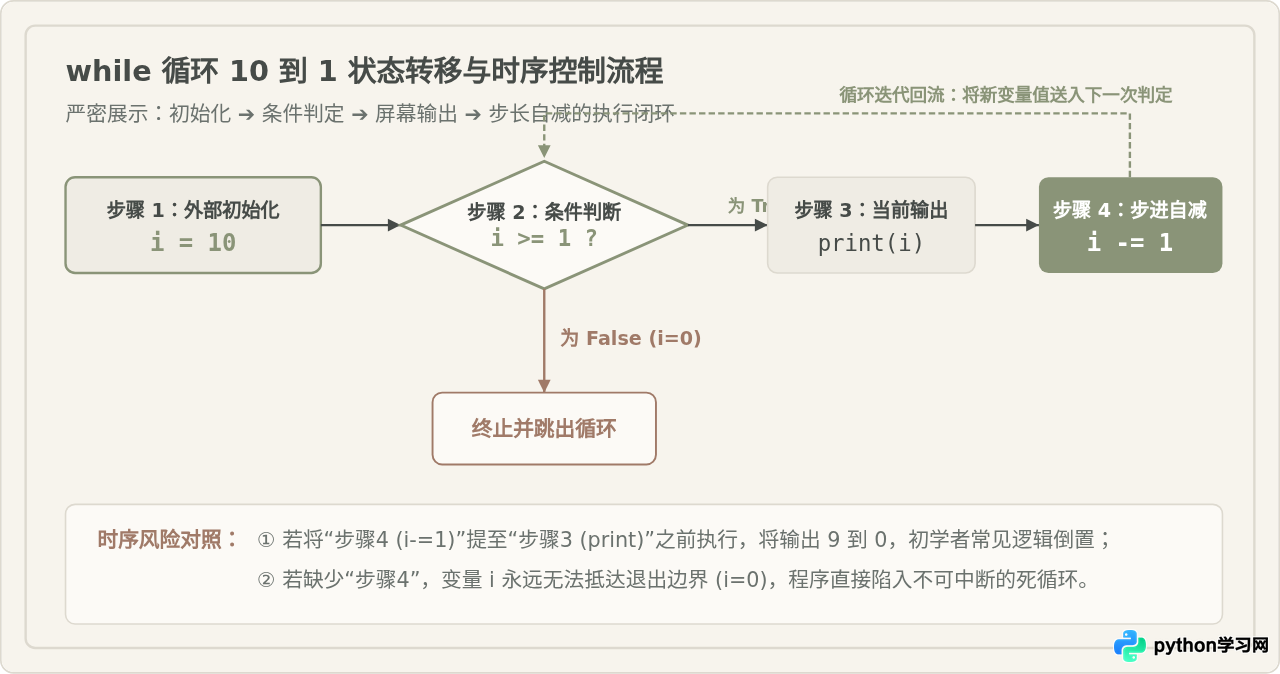
在 while 循环中,终止条件的界定比 range() 更加直观。读者既可以写成 while i >= 1:,也可以写成 while i > 0:。在整数递减的语境下,两者完全等价。当 i 递减到 1 时,1 >= 1 为 True,数字 1 被正常打印;随后执行 i -= 1,i 变为 0,再次回到顶部判断时 0 >= 1 为 False,循环体跳出。
2. 顺序倒置与漏写更新的两大陷阱
与 for 循环几乎不可能写出逻辑漏洞相比,while 循环在初学者笔下极易出现两类典型失误:
-
状态更新语句位置放错:
若将
i -= 1写在print(i)之前:
原因在于第 1 次迭代刚开始时,10 立即被减成了 9 才输出,而当# 错误示例:先自减后打印 i = 10 while i >= 1: i -= 1 print(i, end=' ') # 实际输出结果变为:9 8 7 6 5 4 3 2 1 0(完全偏离目标)i为 1 时满足条件进入循环,减为 0 后依然被输出。 -
遗漏自减语句导致死循环:
如果漏写了
i -= 1,i的值将永远停留在 10,i >= 1恒为真,程序将在控制台无限狂刷 10,耗尽 CPU 资源直至手动终止进程。
三、核心机制差异与多维度横向对比
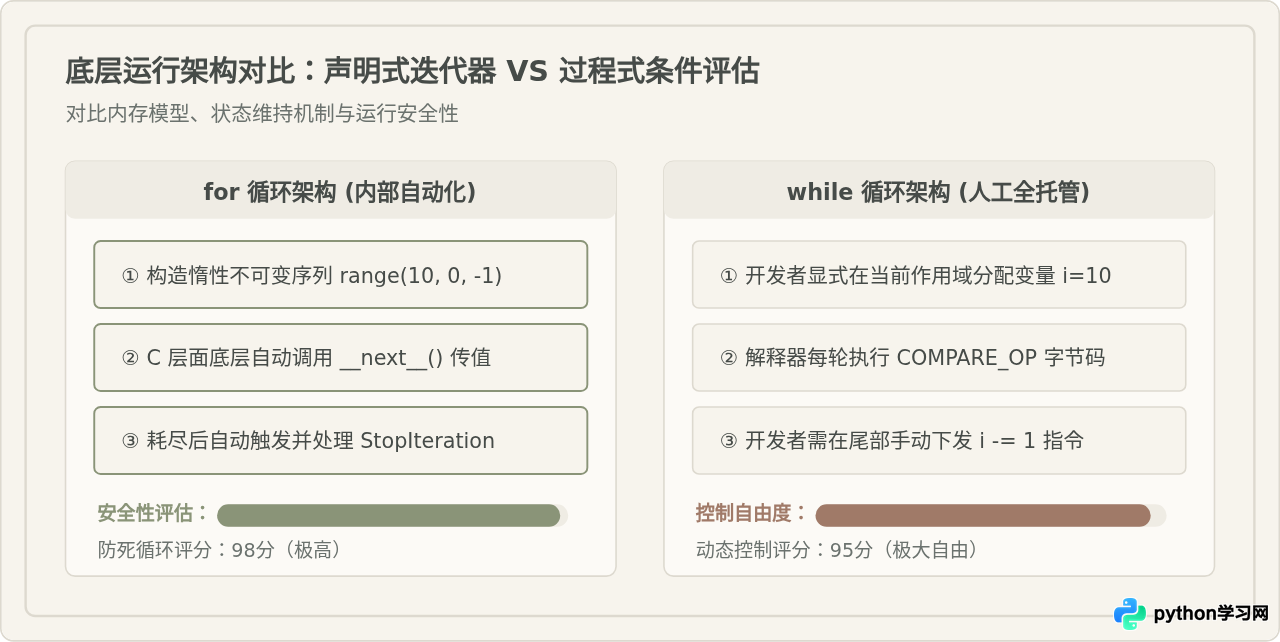
表面上看,for 循环与 while 循环只是写法上的长短差异,但在语言设计哲学与底层执行机制上,两者属于完全不同的范式:
1. 声明式范围 vs 过程式控制
在 for i in range(10, 0, -1) 中,开发者声明了“我需要遍历由 10 倒数到 1 的序列”,至于变量何时赋值、何时递减、何时终止,全部由 Python 底层的 C 实现自动料理。开发者无法在循环体内部通过给 i 重新赋值来影响下一轮 range 产出的下一个数值。例如即使你在循环体内写了 i = 100,下一轮迭代开始时,for 循环仍会坚定不移地将 range 提供的下一个数字(如 9)赋给 i。
而在 while 循环中,变量 i 完全暴露给开发者。你可以在特定条件下执行 i -= 2 实现跳跃式倒序,也可以在触发某种外部事件时直接重置 i = 0 促使循环结束。这种极高的过程控制权,正是 while 循环的价值所在。
| 对比维度 | for 循环 + range(10, 0, -1) | while 循环 + 计数器 |
|---|---|---|
| 代码精炼度 | 2 行代码即可完整搞定,结构紧凑。 | 通常需要 4 行(初始化、判断、执行、自减)。 |
| 死循环防御力 | 极高。range 序列长度有限,自动终止。 |
较低。依赖开发者手动编写更新,遗漏即死循环。 |
| 内部步长可变性 | 不可变。循环体内无法通过改写 i 跳跃序列。 |
完全可变。可在体内部动态自加、自减或跳跃。 |
| 变量生命周期 | 循环结束后 i 仍存在(值为1),但仅用于辅助。 |
i 在进入循环前就已污染局部作用域。 |
| CPython 执行速度 | 更快。range 迭代器在 C 语言层面高速运行。 |
略慢。每轮循环都涉及 Python 字节码解释求值。 |
四、选型准则与常见混淆辨析
在掌握了具体代码和运行机制后,实际开发中我们应当如何取舍?
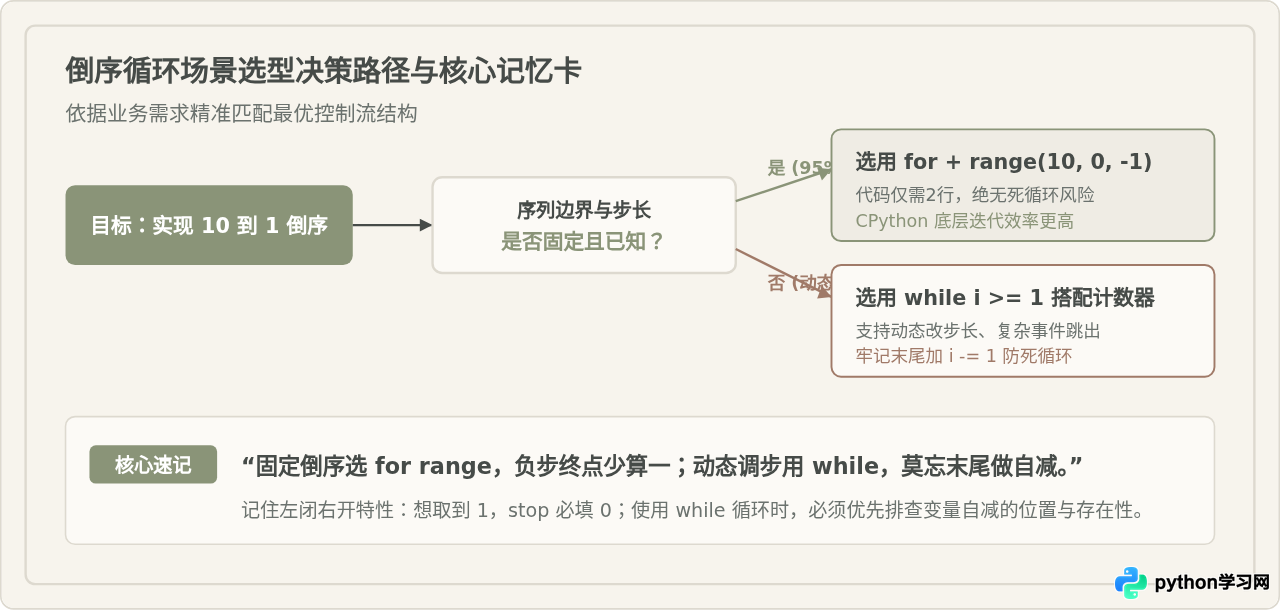
1. 为什么“固定倒序遍历”应无条件选择 for
在实际项目开发中,类似“输出 10 到 1”这种步长固定、起点终点明确、执行次数可预期的倒序任务,for i in range(...) 是绝对的标准解法。原因在于:
- 代码意图一目了然:阅读代码的人一眼就能看出该循环执行恰好 10 次,不需要去检查循环体末尾是否有
i -= 1。 - 避免污染外部变量:
while循环要求在进入前必须先写i = 10,如果函数后续还有同名变量逻辑,容易引发不必要的命名冲突。 - 执行性能更优:在 CPython 解释器中,
range对象是一个纯 C 语言编写的高性能序列类型,其迭代过程在底层高度优化;而while循环每一轮都要经过 Python 虚拟机的字节码条件判断与自减变量加载,耗时通常高于for循环。
2. 什么时候必须退回到 while 循环
while 循环并非过时的工具,在以下特定场景中,它是无法被 for 取代的:
- 非固定步长倒序:例如从 10 倒数到 1 的过程中,如果遇到偶数减 1,遇到特定质数直接跳过 2 步,这种在循环体内动态决定步长的场景,必须使用
while循环。 - 等待外部事件或非数值终止:例如倒序倒计时过程中,如果用户按下了“暂停键”或收到网络中断信号需要保持当前数字不减,
while循环能够自然地通过多重布尔表达式予以支持。
五、总结
实现 Python 中从 10 到 1 的倒序输出看似简单,实则是检验开发者对控制流细节掌控力的试金石:
for i in range(10, 0, -1) 展现了 Python 的简洁与优雅。凭借负步长参数 -1 与开区间截断 stop=0,它用两行代码提供了极佳的安全保障与执行效率,是所有固定倒序场景的首选。
while i >= 1: ... i -= 1 则展现了命令式编程的灵活与底层掌控力。虽然代码稍显冗长并伴随着死循环的防范成本,但在步长动态变化、条件复杂的场景下依然不可或缺。
在实际编写代码时,优先采用意图明确、自带安全边界的 for 循环;当且仅当遇到不可预知的动态跳转逻辑时再启用 while,这是编写稳健、易维护 Python 代码的推荐实践。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















