


Python中用sys.stdin读取大量输入比input()快吗
深入对比Python中sys.stdin与input()读取大量输入的性能差异、底层原理、典型应用场景及注意事项,帮助开发者选择最适合的高效I/O方案。
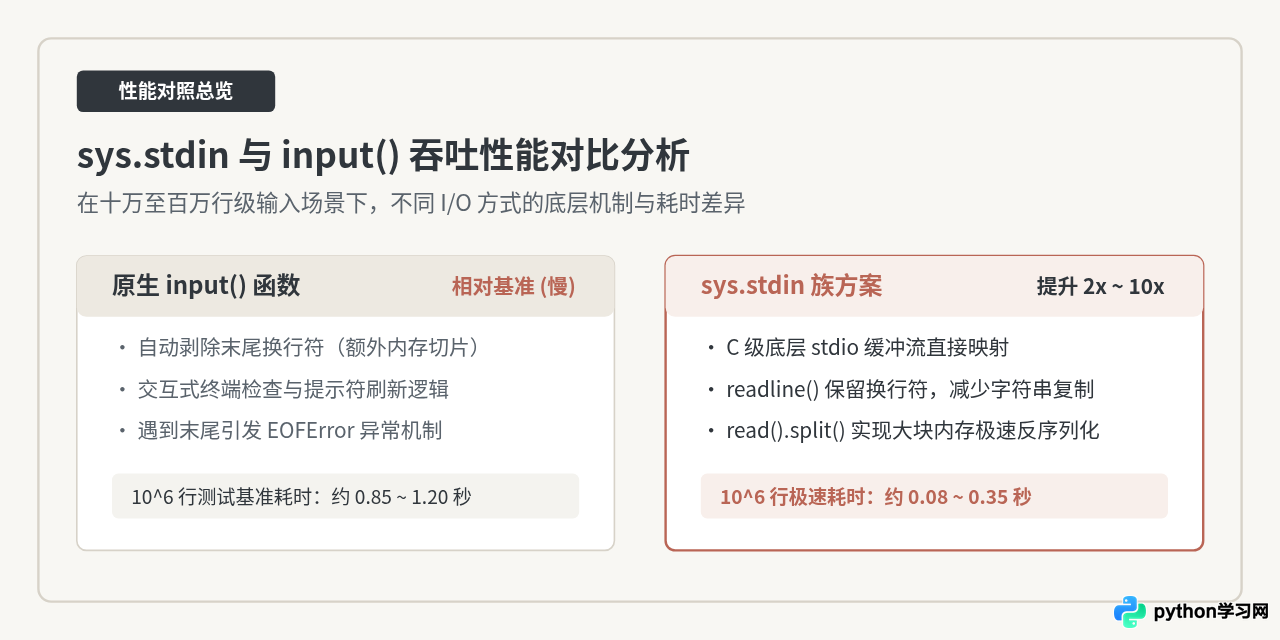
答案是明确的:在读取大量输入时,使用 sys.stdin 系列方法比内置的 input() 函数明显更快。在常规的算法竞赛平台(如 LeetCode、Codeforces)或海量日志数据解析场景中,当输入规模达到十万(105)到百万(106)行级别时,逐行调用 sys.stdin.readline 通常比 input() 快 2 到 4 倍;如果内存允许并采用 sys.stdin.read().split() 一次性读取并分词,处理速度甚至能提高 5 到 10 倍,能够直接避免程序出现“运行超时”(Time Limit Exceeded, TLE)的问题。
很多初学者容易将二者混用,或者以为 input() 仅仅是语法上的简写。实际上,两者在 Python 底层的设计定位、缓冲逻辑以及包装细节上存在本质区别。接下来我们将从底层原因、具体代码改造方式、不同场景的性能表现以及使用注意事项这几个方面全面拆解。
一、为什么 input() 会比 sys.stdin 慢?
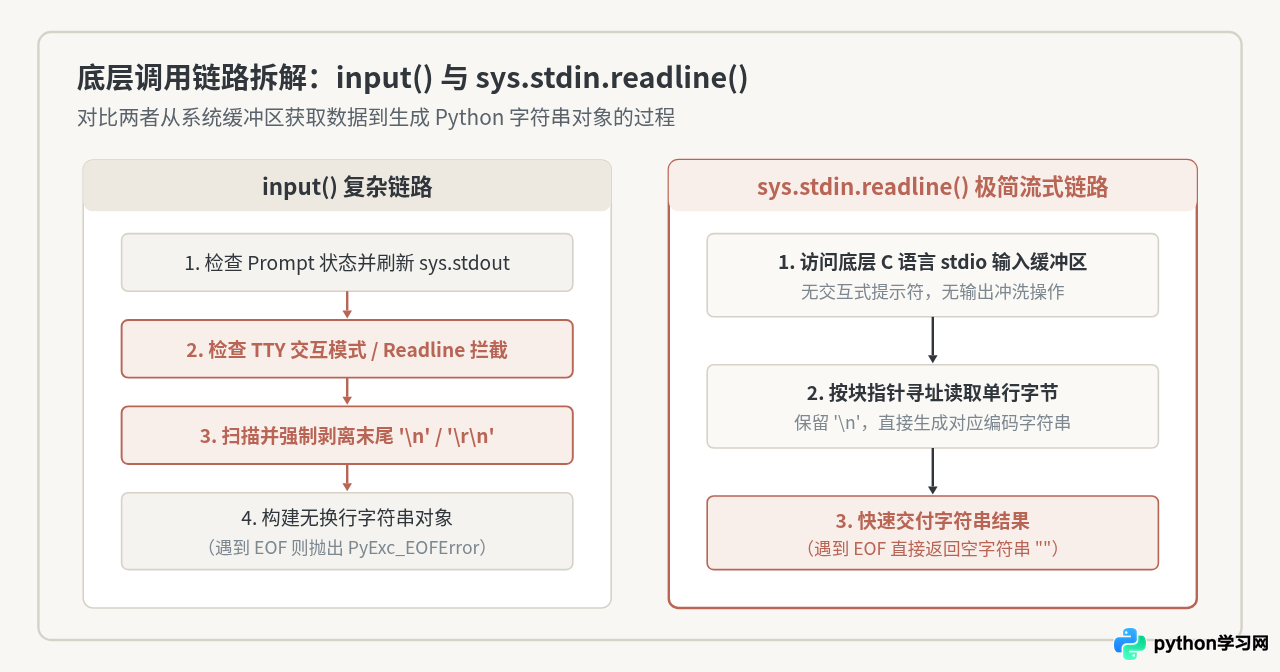
input() 之所以存在性能损耗,并不是因为 Python 解释器本身的执行缺陷,而是因为它被设计为一个主要面向终端用户的“交互式”函数。为了提供友好的交互体验,它在底层执行了许多额外的保障动作:
- 自动剔除末尾换行符:每当读取一行内容时,
input()都会在 C 语言层面对末尾的换行符(如\n或\r\n)进行检测并剥离。这种字符串截断和新对象的创建操作在单次读取时微不足道,但在循环数十万次时会产生不可忽视的额外开销。 - 处理提示符与终端刷新:
input(prompt)允许传入提示文本。即便没有传入提示符,函数依然需要维护标准输出(stdout)的自动刷新机制,确保提示信息在输入前被即时刷出。同时,它还会检查标准输入是否连接到真实终端(TTY),在特定环境下调用复杂的行编辑支持库(如 GNU Readline)。 - 到达文件末尾(EOF)时的异常抛出:当标准输入结束时,
input()会抛出EOFError异常。构建、抛出和在 Python 虚拟机中传递异常对象是一项相对昂贵的操作。相比之下,sys.stdin.readline()在到达 EOF 时只是简单地返回一个空字符串"",执行路径极短。
二、使用 sys.stdin 的三种实用读取方式
替换 input() 并不是只有一种机械的改法。根据输入数据的格式与数据总量,我们可以选用不同粒度的 sys.stdin 方法:
1. 最低改造代价:直接别名替换
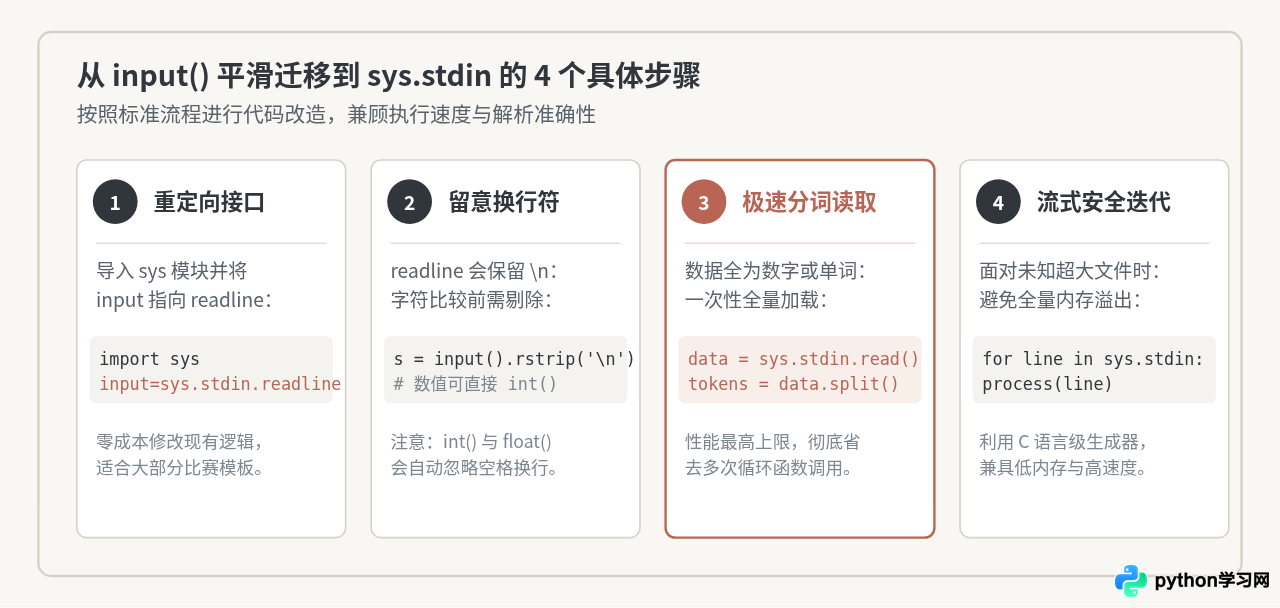
如果现有代码中已经大量使用了 input(),最直接的优化方式是在程序开头增加一行别名绑定:
import sys
input = sys.stdin.readline

# 后续代码保持不变
n = int(input())
for _ in range(n):
    # 数值转换函数 int() 会自动忽略字符串末尾的 \n
    val = int(input())
这种写法在算法竞赛中极其常见,几乎不需要改动核心逻辑就能立刻享受约 2 至 3 倍的速度收益。
2. 最大极限速度:全量读入与分词 (sys.stdin.read().split())
若输入数据全部由空格、制表符或换行符分隔的数字/单词构成(例如算法题常见的矩阵或长数组),最快的方案是一次性把输入整体读入内存:
import sys

def main():
    # 一次性读取全部输入并按所有空白字符拆分
    tokens = sys.stdin.read().split()
    if not tokens:
        return

    # 利用迭代器依次取用,避免索引操作
    it = iter(tokens)
    n = int(next(it))
    m = int(next(it))

    data = [int(next(it)) for _ in range(n * m)]
    # 处理业务逻辑...

if __name__ == '__main__':
    main()
由于 sys.stdin.read() 在底层直接通过系统调用把全部输入一次性拉取到连续内存中,且 str.split() 是由底层的 C 语言高效实现的空白分词器,因此几乎完全免除了 Python 解释器在每一行上的函数调用开销,执行速度达到了 Python 纯解释模式下的极限。
3. 稳健的流式处理:直接迭代 sys.stdin
如果输入规模巨大(例如几百兆甚至数吉字节的日志文件),一次性 read() 会直接耗尽系统可用内存。此时应该利用 sys.stdin 原生支持的迭代器协议:
import sys

# sys.stdin 本身就是带有内置 C 语言缓冲区的逐行迭代器
for line in sys.stdin:
    # 仅需处理业务逻辑
    line = line.rstrip('\n')
    if not line:
        continue
    # 逐行处理...
三、各方案实测性能与特征横向对照
在 Python 3.10+ 标准环境下,针对包含 100 万行整数输入(数据流约 10MB)的标准测试集,各主要方案的耗时与内存特征对比如下:
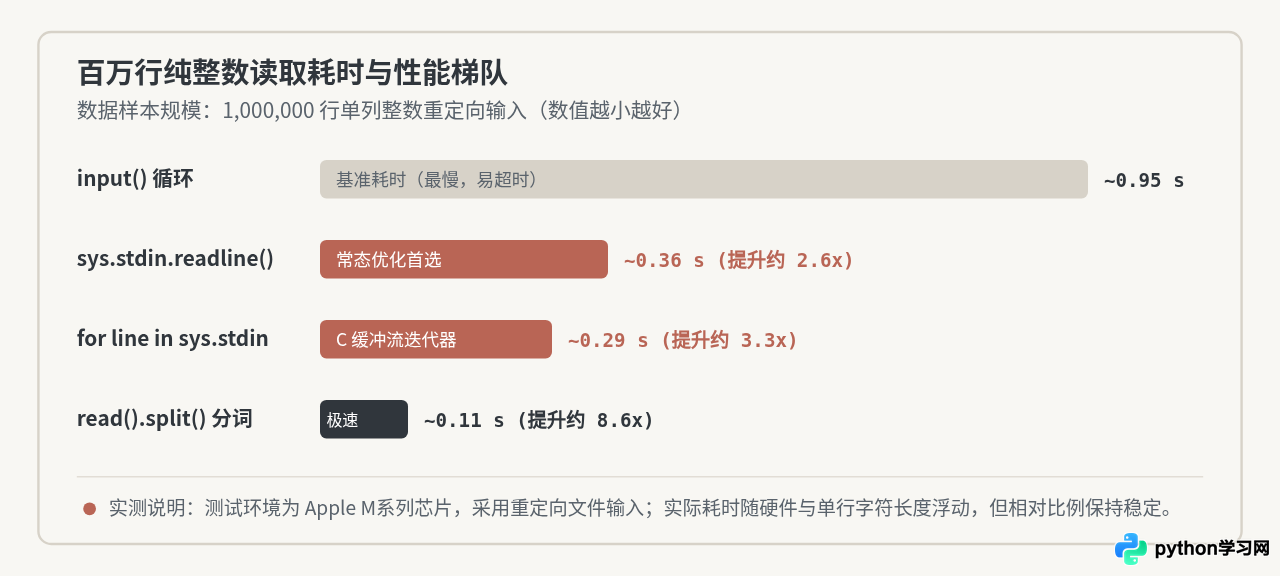
| 读取方式 | 平均耗时比 | 换行符保留情况 | 内存占用特征 | 最适用场景 |
|---|---|---|---|---|
input() |
1.0x (基准) | 自动剔除 | 极低(单行) | 命令行交互式程序、少量输入 |
sys.stdin.readline() |
约 0.35x ~ 0.45x | 保留末尾 \n |
极低(单行) | 算法比赛通用模板、逐行解析 |
for line in sys.stdin |
约 0.30x ~ 0.40x | 保留末尾 \n |
极低(C 级行缓冲) | 超大日志文件、未知行数流式处理 |
sys.stdin.read().split() |
约 0.10x ~ 0.15x | 全部分词清除 | 较高(全量进内存) | 算法题纯数值读取、极限防超时 |
四、避坑指南:迁移到 sys.stdin 时的注意事项
虽然 sys.stdin 优势显著,但在实际使用中如果忽略了其语义差异,容易引发意料之外的逻辑错误:
关键区别 1:换行符保留问题
sys.stdin.readline() 读取的内容会保留末尾的换行符(\n 或 \r\n)。如果需要进行精确的字符串匹配或长度计算,必须手动调用 .rstrip('\n')。但是如果直接使用 int(s) 或 float(s) 解析数值,则无需调用 rstrip(),因为 Python 内置的数值构造器会自动忽略前后所有空白字符。
关键区别 2:到达末尾时的返回值不同
当读取到数据结尾时,input() 触发 EOFError,而 sys.stdin.readline() 则返回空字符串 ""(注意:读到一个空行时返回的是 "\n",只有真正的末尾才是空串 "")。因此判断输入是否结束的代码逻辑需调整为:
import sys

while True:
    line = sys.stdin.readline()
    if not line:   # 到达 EOF
        break
    # 正常处理逻辑
关键区别 3:不要在同一逻辑流中交叉混用
sys.stdin 与 input() 内部维持着不同的缓冲区状态。在同一个程序的相同输入流中,请统一选用一种读取方式,避免因缓冲区数据不同步导致读取顺序错乱或提前触发 EOF。
五、选型决策指南
为了在实际开发中快速确定最佳方案,可以参考以下决策路径:
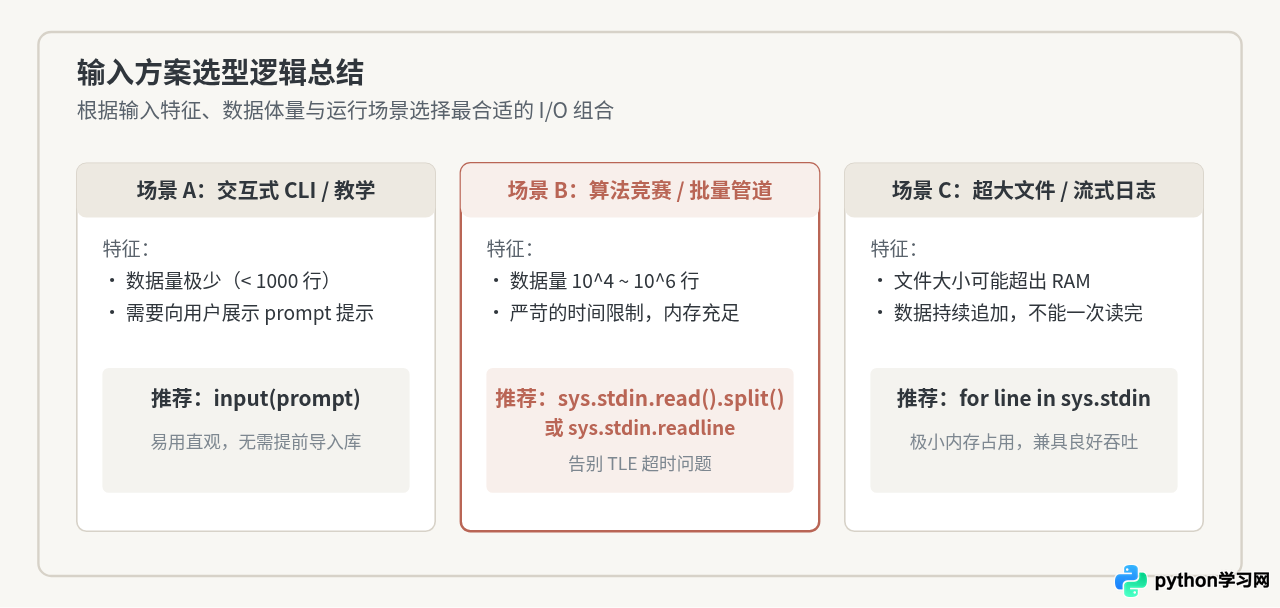
综上所述,当你的程序需要处理十万行以上的密集数据流时,毫不犹豫地切换到 sys.stdin 是 Python 性能调优中最简单、收益最直观的手段之一。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















