


Python编程初学者常见误区:代码规范与最佳实践建议
针对Python初学者在编码风格、默认参数、异常处理、资源管理及工具链上的高频误区,提供详尽的原理剖析、PEP 8规范对照、实操步骤与代码示例。
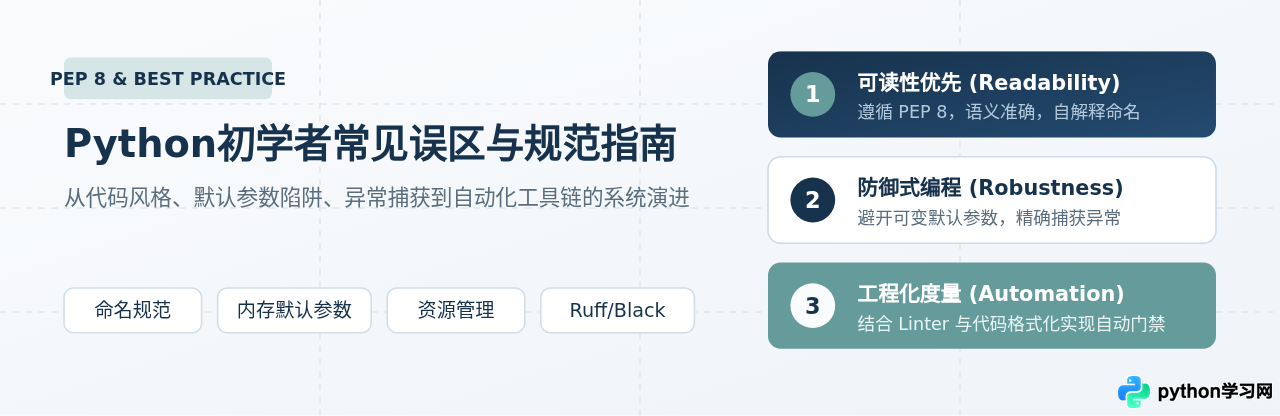
一、命名随意与风格混乱:让代码具备自我解释能力
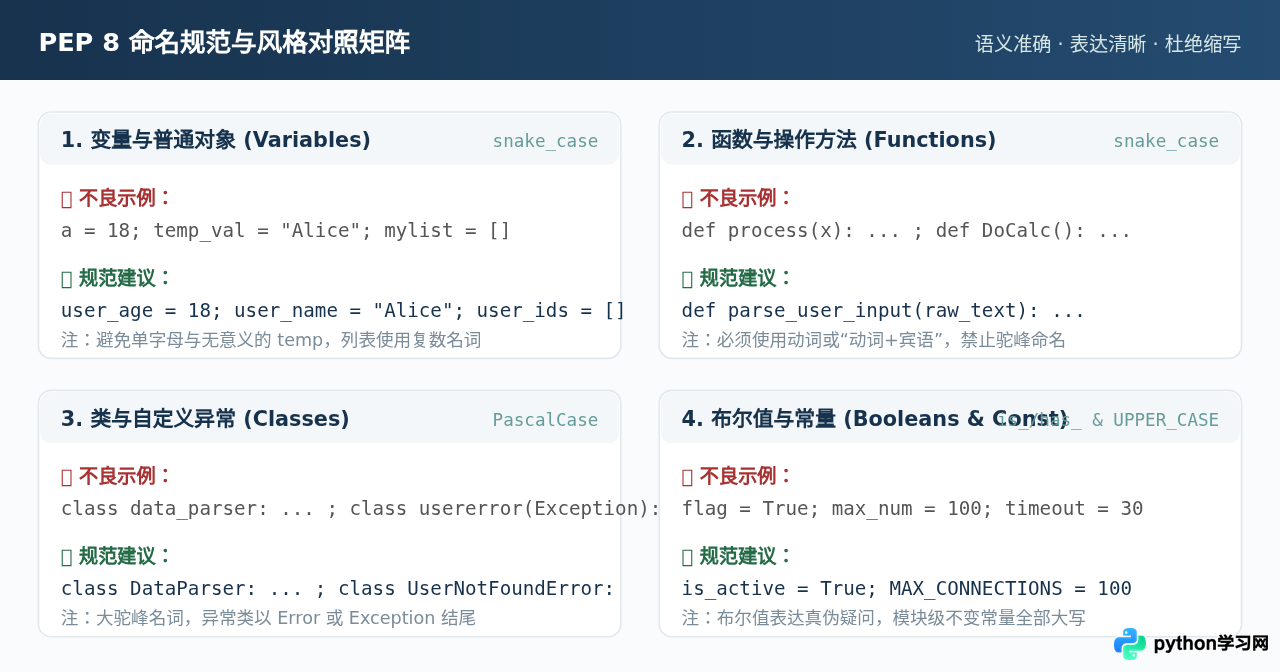
很多初学者的代码充斥着类似 a、b、data1、temp、list_result 这样缺乏语义的变量名,或是为了图方便使用汉语拼音混合缩写。这种命名方式在几小时之后就会让原作者感到费解,更谈不上团队协作。
Python官方的 PEP 8 规范 为标识符定义了清晰的风格契约:变量与函数采用蛇形命名法(snake_case),类名采用大驼峰命名法(PascalCase),常量采用全大写下划线(UPPER_CASE)。此外,好的命名应该遵循“自解释原则”:函数名应反映其动作行为,变量名应指明数据本质,布尔值变量应使用表示状态的助动词前缀。
二、危险的默认参数:为什么不可在定义中使用可变对象
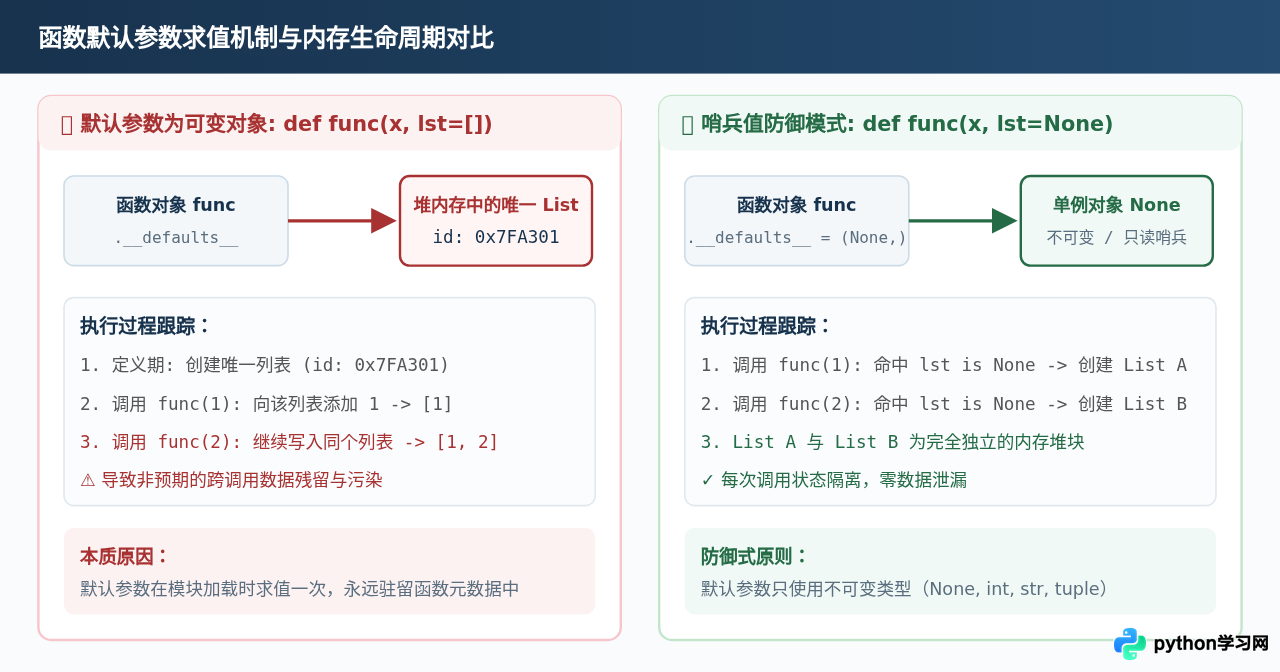
在所有初学者常犯的错误中,将可变对象(如列表 [] 或字典 {})作为函数的默认参数是最隐蔽且破坏性最大的一个。初学者往往认为“每次调用该函数时,都会新生成一个空的列表”,但实际运行结果却截然相反。
def add_item(item, basket=[]):
    basket.append(item)
    return basket

# 连续调用测试
print(add_item("苹果")) # 输出: ['苹果']
print(add_item("香蕉")) # 输出: ['苹果', '香蕉'] (状态残留!)def add_item(item, basket=None):
if basket is None:
basket = [] # 每次调用动态创建全新对象
basket.append(item)
return basket
print(add_item("苹果")) # 输出: ['苹果']
print(add_item("香蕉")) # 输出: ['香蕉'] (行为符合预期)出现这种怪异现象的根本原因在于:Python中的函数是第一类对象,默认参数表达式是在函数“定义”(即代码首次被解释器加载)时求值的,而不是在函数“每次调用”时执行。解释器将求值得到的默认对象保存在该函数对象的 __defaults__ 属性中。如果默认参数是可变对象,无论你调用多少次函数,所有缺省实参的调用都会引用同一个内存地址中的对象。
三、异常处理漏洞:杜绝宽泛捕获与“吞掉”错误
处理异常的目的是为了优雅降级或提供诊断信息,但很多初学者在写代码时为了“避免程序报错崩溃”,习惯使用没有任何限定的 except: pass。这种做法被称为“吞掉异常”(Swallowing Exceptions),是生产事故的重灾区。
try:
    with open("config.json") as f:
        data = json.load(f)
    result = data["port"]
except:
pass # 发生什么都不知道,排查问题如大海捞针import logging
try:
with open("config.json", encoding="utf-8") as f:
data = json.load(f)
result = data["port"]
except FileNotFoundError:
logging.warning("配置文件不存在,使用默认端口8080")
result = 8080
except (json.JSONDecodeError, KeyError) as e:
logging.error("配置格式损坏或缺少字段: %s", e)
raise # 重新抛出关键错误供上层感知宽泛捕获的危险主要体现在三点:
- 拦截系统控制信号:直接使用
except:甚至会捕获KeyboardInterrupt(用户按 Ctrl+C 中断程序)和SystemExit,导致程序无法正常退出。 - 掩盖代码本身的语法/拼写错误:如果在
try块内部发生了NameError(变量名手误写错)或TypeError,无差别捕获会让这些低级错误隐匿成“幽灵问题”。 - 丧失溯源能力:不记录日志直接
pass,一旦线上行为异常,开发者没有任何调用栈(Traceback)可供复盘。
四、资源管理与惯用表达:写出地道的 Pythonic 代码
从其他语言(如C/C++或旧版Java)转到Python的初学者,常常把原本繁琐的资源管理与索引循环照搬到Python中,这不仅违背了Python的简洁哲学,还容易引发资源泄露。
1. 资源未安全释放与上下文管理器
在打开文件、建立数据库连接或获取网络套接字时,手动调用 f.close() 是极不可靠的,因为在读取过程中只要抛出任何异常,close() 就永远不会被执行。
# ❌ 错误示范:异常时会导致文件句柄泄漏
f = open("data.csv", "r")
process_data(f)  # 一旦此处抛出异常,文件永远得不到关闭
f.close()

# ✅ 规范示范:使用 with 上下文管理器,离开作用域必然安全关闭
with open("data.csv", "r", encoding="utf-8") as f:
    process_data(f)
2. 避免使用 range(len(...)) 遍历集合
需要获取列表索引与元素时,使用 range(len(seq)) 既不直观又效率低下。Python 提供了内置函数 enumerate() 和 zip(),能够以非常优雅的方式同时处理序列与索引:
fruits = ["apple", "banana", "cherry"]

# ❌ 反模式:笨拙的下标索引
for i in range(len(fruits)):
    print(f"序号: {i}, 水果: {fruits[i]}")

# ✅ 规范模式:直接使用 enumerate 解包
for idx, fruit in enumerate(fruits, start=1):
    print(f"序号: {idx}, 水果: {fruit}")
五、工程化落地:自动化检查与格式化工具链
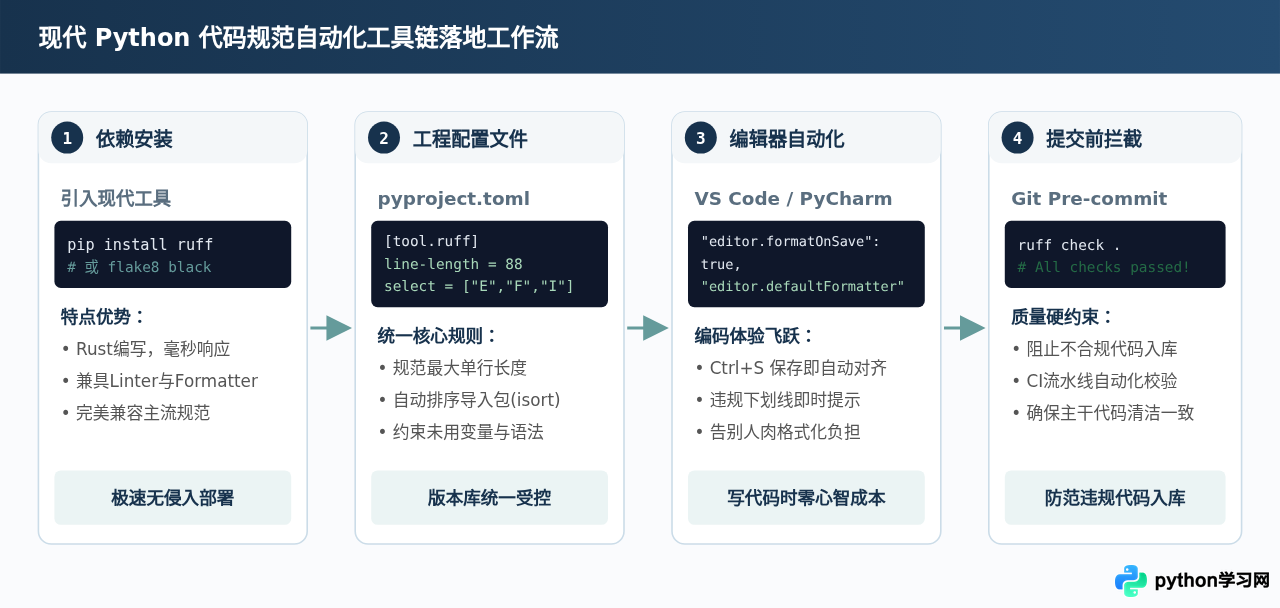
依靠开发者的记忆来保证每一个命名和缩进都符合规范是极不现实的。在实际项目开发中,成熟团队普遍采用**“工具自动化门禁”**,将代码规范检查前置到保存文件和代码提交阶段。
实操指南:配置一个标准的 pyproject.toml
在项目根目录下新建 pyproject.toml 文件,填入如下推荐配置。该配置遵循现代开发标准,将单行字符数放宽至国际通用的88字符(Black标准),并激活了语法、PEP 8样式及导入顺序自动排序检查:
[tool.ruff]
# 单行最大长度限制,建议 88 或 100
line-length = 88

# 激活规则集合:
# E: pycodestyle 错误
# W: pycodestyle 警告
# F: Pyflakes 语法与未使用变量
# I: isort 导入语句自动排序
select = ["E", "W", "F", "I"]
ignore = []

# 排除不需要检查的文件夹
exclude = [
    ".git",
    "__pycache__",
    "build",
    "dist",
    ".venv",
]

[tool.ruff.format]
quote-style = "double"
indent-style = "space"
在终端中执行以下命令,即可完成全量检测与一键修复:
# 1. 扫描当前目录下所有代码规范问题
ruff check .

# 2. 自动修复所有可安全自动处理的违规代码(如未使用的包、格式错乱)
ruff check --fix .

# 3. 按照标准风格统一格式化代码文件
ruff format .
六、总结:初学者代码质量自查决策图
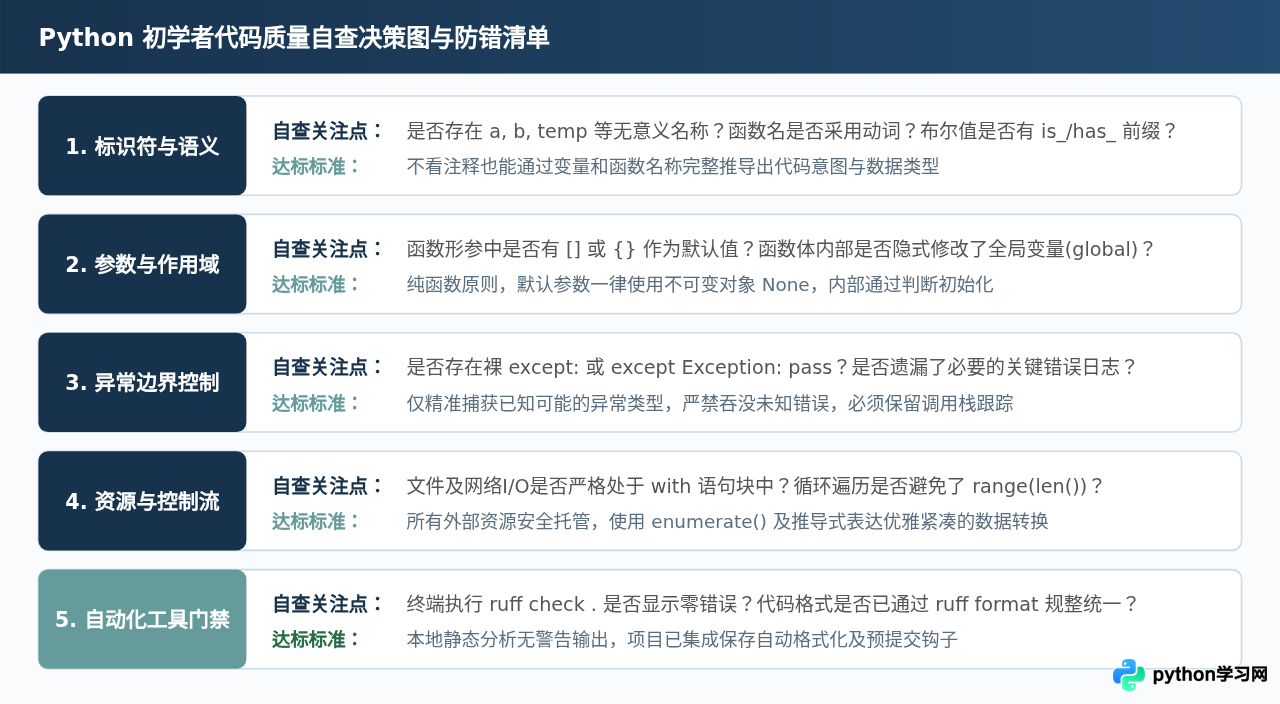
养成良好的代码规范并不是死记硬背条款,而是要在日常开发中建立起严谨的防错心智。在每一次提交或交付代码前,对照下方的**五维代码质量自查矩阵**进行核验,能够帮助你在早期过滤掉80%以上的潜在隐患。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















