


Python新手入门:5个适合练手的实战小项目
精选5个适合Python初学者独立完成的实战练手项目,涵盖流程控制、文本词频统计、JSON待办事项管理、批量文件重命名与网页数据解析。提供完整代码、执行示例、易错点分析及进阶指南。
掌握 Python 语法基础后,仅通过阅读文档或刷语法题往往难以建立完整的编程思维。本文精选 5 个由浅入深、适合新手独立完成的实战小项目,涵盖流程控制、字符串与字典处理、本地数据持久化、文件系统自动化以及网络数据获取。每个项目均包含明确的目标定位、核心知识点拆解、完整可执行代码、运行示例以及常见问题避坑指南,帮助读者通过具体的工程实践巩固编程基本功。
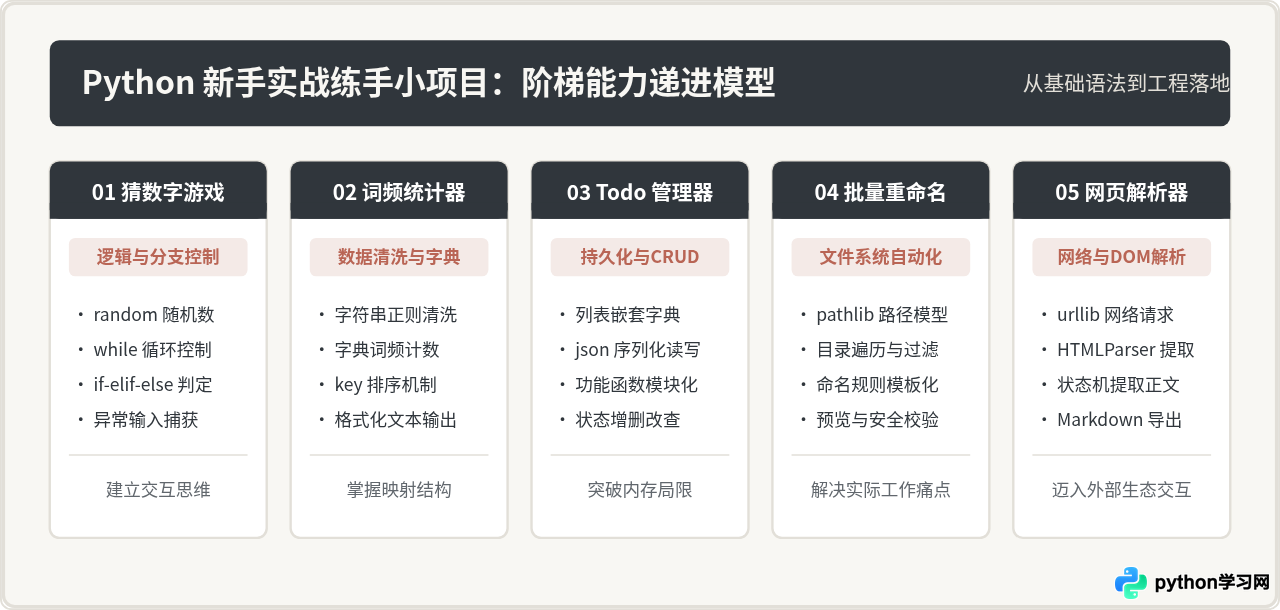
为什么选择这五个项目作为练手起点?
新手在学完变量、数据类型、条件分支与循环之后,最容易陷入“语法概念都清楚,面对空白代码文件却无从下手”的困境。出现这种现象的核心原因,在于缺乏将抽象语法转化为具体逻辑单元的工程训练。
一个优质的入门练手项目应当满足三个硬性标准:
- 代码量适中:单文件在 50 至 120 行代码之间,能够在一到两小时内理清全部逻辑并调试成功。
- 依赖最小化:优先采用 Python 标准库,避免因配置复杂的第三方环境或包版本冲突而打消学习积极性。
- 具备真实反馈:项目运行后有明确的交互输出、文件产生或结果呈现,能验证逻辑是否正确。
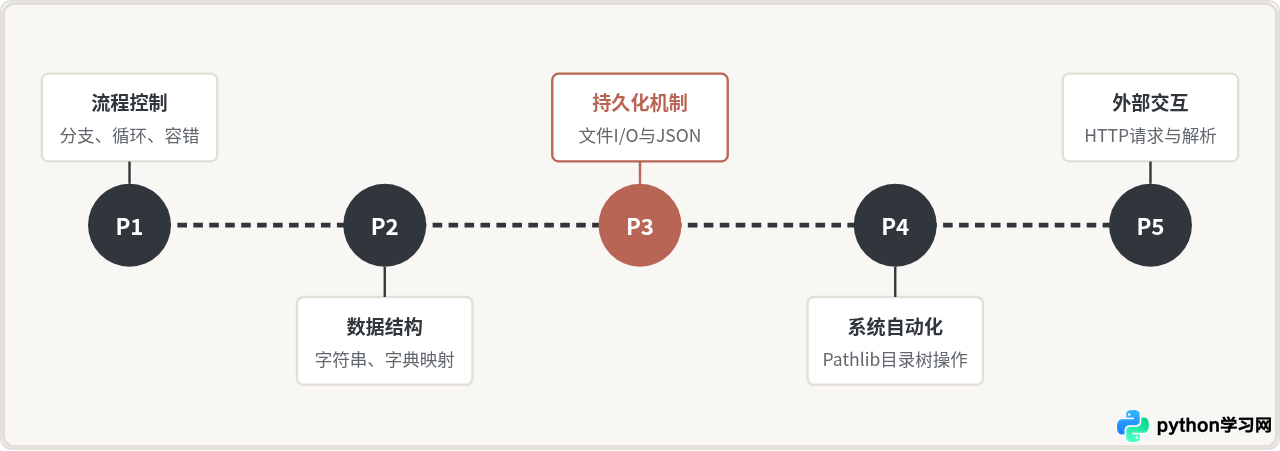
下文精选的 5 个项目按照“逻辑控制 → 内存结构 → 数据持久化 → 系统交互 → 网络处理”的梯度编排,形成循序渐进的完整技能闭环。
项目一:智能猜数字游戏
1. 项目目标与解决的问题
编写一个在终端运行的交互式猜数字游戏。程序预先在 1 到 100 之间生成一个随机目标数,玩家拥有固定次数(如 7 次)的猜测机会。每次输入后,程序会提示“猜大了”或“猜小了”,并在玩家耗尽机会或猜中时结束游戏。
该项目核心解决初学者的两大认知盲区:
- 输入流类型转换与防御性编程:
input()默认返回字符串,直接比较数值会抛出异常;若用户输入非数字字符,需要通过try-except优雅捕获,防止程序直接崩溃。 - 多分支与循环状态控制:掌握
while循环、循环计数器以及break语句在状态满足时的跳出逻辑。
2. 完整源码实现
# guess_number.py
import random

def play_guess_game(max_attempts=7, lower_bound=1, upper_bound=100):
    secret_number = random.randint(lower_bound, upper_bound)
    attempts_left = max_attempts

    print("=== 猜数字游戏已启动 ===")
    print(f"目标数字位于 {lower_bound} 到 {upper_bound} 之间,你共有 {max_attempts} 次机会。")

    while attempts_left > 0:
        user_input = input(f"\n[剩余机会: {attempts_left}] 请输入你的猜测: ").strip()

        # 防御性校验:检查输入是否为有效整数
        try:
            guess = int(user_input)
        except ValueError:
            print("【错误】请输入有效的正整数,本次不扣除机会。")
            continue

        # 检查是否在规定区间内
        if guess < lower_bound or guess > upper_bound:
            print(f"【提醒】数字超出范围,请输入 {lower_bound} 到 {upper_bound} 之间的数值。")
            continue

        attempts_left -= 1

        if guess == secret_number:
            used_attempts = max_attempts - attempts_left
            print(f"恭喜猜中!正确答案就是 {secret_number}。你总共尝试了 {used_attempts} 次。")
            return True
        elif guess > secret_number:
            print("偏大了!再试一个小一点的数字。")
        else:
            print("偏小了!再试一个大一点的数字。")

    print(f"\n遗憾,机会已用尽!正确答案是: {secret_number}。下次加油!")
    return False

if __name__ == "__main__":
    play_guess_game()
3. 运行方式与示例输出
执行命令:
python3 guess_number.py终端运行示例(以猜中为例):
=== 猜数字游戏已启动 ===
目标数字位于 1 到 100 之间,你共有 7 次机会。

[剩余机会: 7] 请输入你的猜测: 50
偏小了!再试一个大一点的数字。

[剩余机会: 6] 请输入你的猜测: abc
【错误】请输入有效的正整数,本次不扣除机会。

[剩余机会: 6] 请输入你的猜测: 75
偏大了!再试一个小一点的数字。

[剩余机会: 5] 请输入你的猜测: 62
恭喜猜中!正确答案就是 62。你总共尝试了 3 次。continue 提前结束本轮迭代,同时不要扣除 attempts_left,避免因为手误输错字符而直接浪费猜测机会。
项目二:文章词频统计与文本分析器
1. 项目目标与解决的问题
给定一段长英文文本或读取文本文件,分析该文本的总单词量、不同单词数(词汇量),并统计出现频次最高的前 10 个高频词,按数量从高到低格式化输出为排列表格。
该项目解决的问题包括:
- 文本规范化清洗:处理大小写差异(如
The与the应归为同一词)以及逗号、句号、连字符等标点符号的剥离。 - 核心数据结构应用:理解 Python 字典(
dict)作为哈希表的计数优势,掌握dict.get()或collections.Counter的底层逻辑。 - 基于键值的自定义排序:使用
sorted()配合lambda表达式对字典的items()进行降序排列。
2. 完整源码实现
# word_frequency.py
import re

def analyze_text(text: str, top_k: int = 5):
    if not text.strip():
        print("传入文本为空,无法进行分析。")
        return

    # 1. 文本预处理:转为小写并使用正则表达式过滤标点符号
    cleaned_text = text.lower()
    # 仅保留英文字母和数字,将标点符号与空白替换为单个空格
    words = re.findall(r'[a-zA-Z0-9]+', cleaned_text)

    total_word_count = len(words)
    if total_word_count == 0:
        print("未提取到有效单词。")
        return

    # 2. 词频统计(使用字典映射)
    freq_map = {}
    for word in words:
        freq_map[word] = freq_map.get(word, 0) + 1

    unique_word_count = len(freq_map)

    # 3. 排序:按频次降序,频次相同时按字母序升序
    sorted_freq = sorted(
        freq_map.items(),
        key=lambda item: (-item[1], item[0])
    )

    # 4. 格式化输出
    print("-" * 45)
    print(f"总计单词数: {total_word_count:<8} 唯一单词数: {unique_word_count}")
    print("-" * 45)
    print(f"{'排名':<6}{'单词':<16}{'出现频次':<10}{'占比(%)'}")
    print("-" * 45)

    for rank, (word, count) in enumerate(sorted_freq[:top_k], start=1):
        ratio = (count / total_word_count) * 100
        print(f"{rank:<6}{word:<16}{count:<10}{ratio:>6.2f}%")
    print("-" * 45)

sample_article = (
    "Python is an easy to learn, powerful programming language. It has efficient high-level "
    "data structures and a simple but effective approach to object-oriented programming. "
    "Python's elegant syntax and dynamic typing, together with its interpreted nature, "
    "make it an ideal language for scripting and rapid application development in many "
    "areas on most platforms. Python is widely used in data science, automation, and web backends."
)

if __name__ == "__main__":
    analyze_text(sample_article, top_k=5)
3. 运行方式与示例输出
执行命令:
python3 word_frequency.py终端运行示例:
---------------------------------------------
总计单词数: 62       唯一单词数: 47
---------------------------------------------
排名    单词              出现频次      占比(%)
---------------------------------------------
1     and             4             6.45%
2     python          3             4.84%
3     in              2             3.23%
4     is              2             3.23%
5     language        2             3.23%
---------------------------------------------str.split(" ") 分词时,若遇到连续空格或换行符会产生空字符串项;若单词末尾包含句号(如 language.),也会被错误算作新词。务必使用正则表达式 re.findall(r'[a-zA-Z0-9]+', text) 清理。
项目三:轻量级待办事项管理程序(Todo CLI)
1. 项目目标与解决的问题
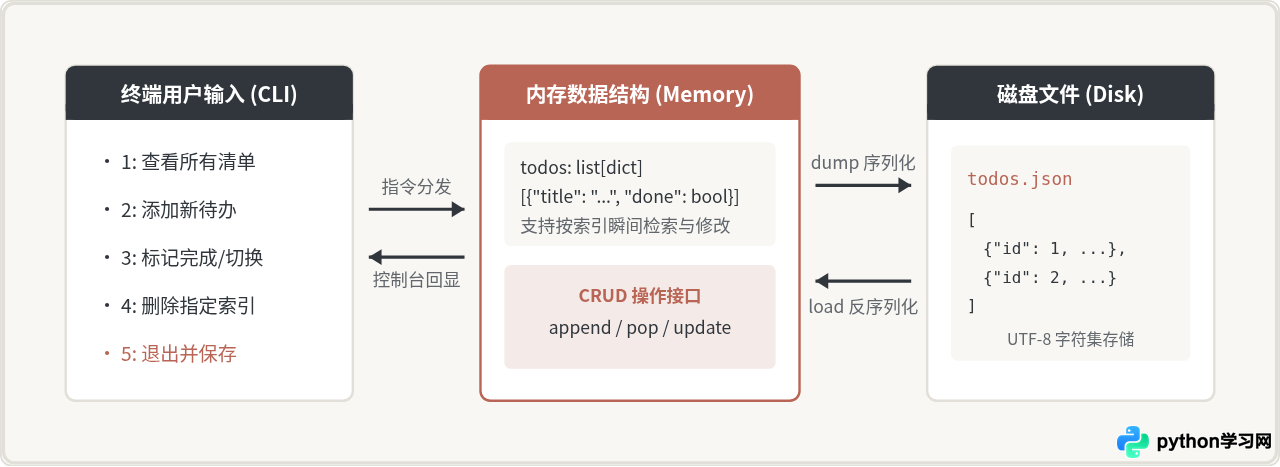
大部分新手写出的程序在终端关闭后数据便荡然无存。本项目实现一个命令行任务管理器,具备“添加任务、查看任务、完成任务、删除任务”四大核心功能,并在程序退出时将数据持久化保存到本地的 todos.json 文件中。下次启动时自动加载历史数据。
该项目核心训练以下能力:
- 程序状态持久化:使用标准库
json模块完成内存数据(Pythonlist/dict)与磁盘物理文件之间的序列化和反序列化。 - 函数化模块设计:将不同业务动作(加载、保存、新增、显示、修改状态)封装为独立的纯函数,体会职责分离与函数复用。
- 文件异常容错机制:针对首次运行文件不存在(
FileNotFoundError)以及文件内容损坏(json.JSONDecodeError)提供安全回退。
2. 完整源码实现
# todo_manager.py
import json
import os

STORAGE_FILE = "todos.json"

def load_todos(filepath: str = STORAGE_FILE) -> list:
    """从磁盘读取待办任务列表,若文件不存在则返回空列表"""
    if not os.path.exists(filepath):
        return []
    try:
        with open(filepath, "r", encoding="utf-8") as f:
            return json.load(f)
    except (json.JSONDecodeError, OSError):
        print("【警告】数据文件损坏,已初始化为空列表。")
        return []

def save_todos(todos: list, filepath: str = STORAGE_FILE) -> None:
    """将待办列表写回磁盘"""
    with open(filepath, "w", encoding="utf-8") as f:
        json.dump(todos, f, ensure_ascii=False, indent=2)

def list_todos(todos: list) -> None:
    """打印当前所有任务列表"""
    if not todos:
        print("\n当前没有待办事项。")
        return
    print("\n" + "=" * 40)
    print(f"{'序号':<6}{'状态':<10}{'内容'}")
    print("-" * 40)
    for idx, item in enumerate(todos, start=1):
        status = "[已完成]" if item.get("done") else "[待办]"
        print(f"{idx:<6}{status:<10}{item['title']}")
    print("=" * 40)

def main():
    todos = load_todos()
    while True:
        print("\n--- 任务管理系统 ---")
        print("1. 查看待办列表")
        print("2. 添加待办事项")
        print("3. 标记任务为已完成")
        print("4. 删除待办事项")
        print("5. 退出系统")
        choice = input("请输入功能序号 (1-5): ").strip()

        if choice == "1":
            list_todos(todos)
        elif choice == "2":
            title = input("请输入待办内容: ").strip()
            if title:
                todos.append({"title": title, "done": False})
                save_todos(todos)
                print(f"已添加: {title}")
            else:
                print("内容不能为空。")
        elif choice == "3":
            list_todos(todos)
            if not todos:
                continue
            idx_str = input("请输入要标记完成的任务序号: ").strip()
            if idx_str.isdigit() and 1 <= int(idx_str) <= len(todos):
                idx = int(idx_str) - 1
                todos[idx]["done"] = True
                save_todos(todos)
                print(f"任务 [{todos[idx]['title']}] 已标记为完成!")
            else:
                print("输入的序号无效。")
        elif choice == "4":
            list_todos(todos)
            if not todos:
                continue
            idx_str = input("请输入要删除的任务序号: ").strip()
            if idx_str.isdigit() and 1 <= int(idx_str) <= len(todos):
                idx = int(idx_str) - 1
                removed = todos.pop(idx)
                save_todos(todos)
                print(f"已删除任务: {removed['title']}")
            else:
                print("输入的序号无效。")
        elif choice == "5":
            save_todos(todos)
            print("数据已安全同步到本地,再见!")
            break
        else:
            print("无效指令,请输入 1 到 5 之间的数字。")

if __name__ == "__main__":
    main()
3. 运行方式与示例输出
执行命令:
python3 todo_manager.py终端运行交互示例:
--- 任务管理系统 ---
1. 查看待办列表
2. 添加待办事项
3. 标记任务为已完成
4. 删除待办事项
5. 退出系统
请输入功能序号 (1-5): 2
请输入待办内容: 学习 Python 标准库 pathlib
已添加: 学习 Python 标准库 pathlib

--- 任务管理系统 ---
1. 查看待办列表
2. 添加待办事项
3. 标记任务为已完成
4. 删除待办事项
5. 退出系统
请输入功能序号 (1-5): 1

========================================
序号    状态        内容
----------------------------------------
1     [待办]      学习 Python 标准库 pathlib
========================================ensure_ascii=False 与 encoding="utf-8"。否则中文文本会被编码为 \u4e60\u8bf4 形式的 Unicode 转义字符,丧失本地文件的可读性。
项目四:自动化批量文件重命名器
1. 项目目标与解决的问题
日常工作和数据处理中经常会遇到数百张照片或文档命名混乱的问题(例如 IMG_2026_01.JPG、test.bak.png)。直接手动修改费时费力且容易出错。
该项目实现一个安全、可控的文件自动化重命名脚本:
- 支持指定目标文件夹与扩展名过滤(如只处理
.jpg文件)。 - 采用
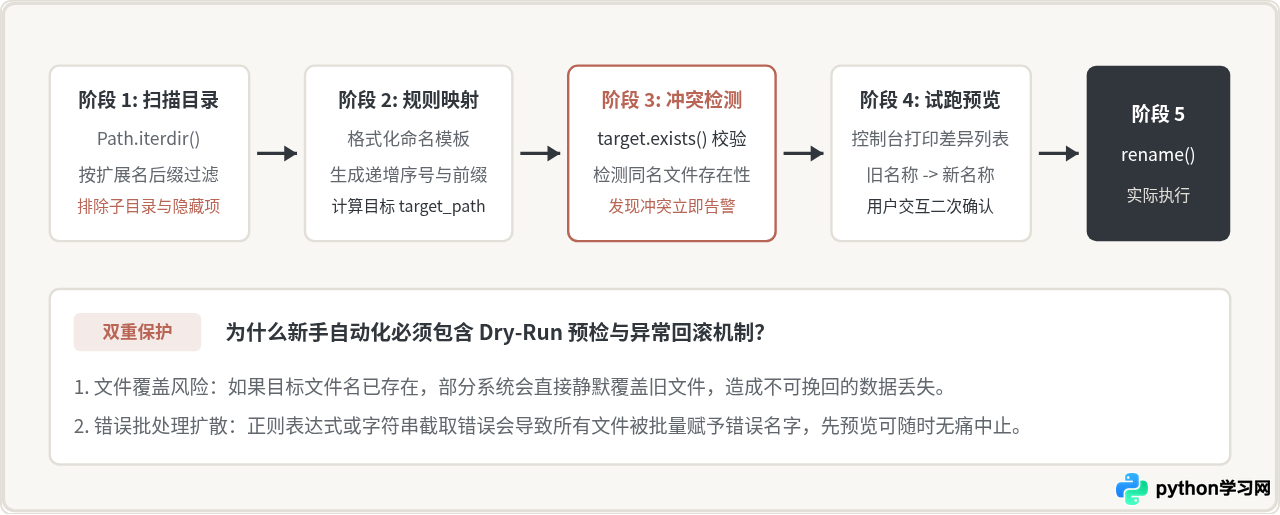
pathlib.Path替代传统的低级字符串路径拼接,兼顾 Windows 反斜杠与 Linux 正斜杠的跨平台兼容性。 - 实现“预检试跑(Dry-Run)”双重安全机制:重命名属于危险的不可逆文件操作,必须先在终端列出“修改前 → 修改后”的新旧名称对照,待用户显式输入
y确认后才执行实际落盘重命名,从根源杜绝误覆盖。
2. 完整源码实现
# batch_rename.py
import sys
from pathlib import Path

def batch_rename(dir_path: str, extension: str, prefix: str, dry_run: bool = True):
    target_dir = Path(dir_path)

    # 1. 验证目标目录是否存在
    if not target_dir.exists() or not target_dir.is_dir():
        print(f"【错误】路径不存在或不是有效目录: {dir_path}")
        return

    # 规范化扩展名后缀(如 'jpg' 转为 '.jpg')
    if not extension.startswith('.'):
        extension = f".{extension}"
    extension = extension.lower()

    # 2. 检索并按原有文件名排序,保证重命名顺序的一致性
    files_to_rename = [
        f for f in target_dir.iterdir()
        if f.is_file() and f.suffix.lower() == extension
    ]
    files_to_rename.sort(key=lambda p: p.name)

    if not files_to_rename:
        print(f"在目录 [{target_dir}] 中未找到后缀为 [{extension}] 的文件。")
        return

    print(f"找到 {len(files_to_rename)} 个匹配的文件。开始规划重命名任务...\n")

    planned_actions = []
    # 3. 规划新文件名并进行冲突检验
    for index, file_path in enumerate(files_to_rename, start=1):
        # 格式为: prefix_001.jpg
        new_name = f"{prefix}_{index:03d}{extension}"
        destination = target_dir / new_name

        # 检查是否与非待处理的已有文件冲突
        if destination.exists() and destination not in files_to_rename:
            print(f"【冲突阻止】目标文件已存在,为防覆盖已中止任务: {new_name}")
            return

        planned_actions.append((file_path, destination))

    # 4. 打印预检预览表格
    print("-" * 65)
    print(f"{'序号':<6}{'原文件名':<26} -> {'新文件名'}")
    print("-" * 65)
    for idx, (src, dst) in enumerate(planned_actions, start=1):
        print(f"{idx:<6}{src.name:<26} -> {dst.name}")
    print("-" * 65)

    if dry_run:
        print("\n【当前处于试跑模式 (Dry-Run)】未对实际文件进行任何修改。")
        confirm = input("确认要按上述方案执行实际重命名吗?(输入 y 确认,其他取消): ").strip().lower()
        if confirm != 'y':
            print("操作已取消。")
            return

    # 5. 执行真正的重命名落盘操作
    success_count = 0
    for src, dst in planned_actions:
        try:
            src.rename(dst)
            success_count += 1
        except OSError as e:
            print(f"【重命名失败】{src.name} -> {dst.name}: {e}")

    print(f"\n重命名完成!成功处理: {success_count} / {len(planned_actions)} 个文件。")

if __name__ == "__main__":
    # 示例调用:默认试跑模式,可传入指定目录
    target_folder = "./test_data"
    batch_rename(dir_path=target_folder, extension="txt", prefix="doc_archive", dry_run=True)
3. 运行方式与示例输出
执行命令:
python3 batch_rename.py终端运行示例(Dry-Run 及确认执行):
找到 3 个匹配的文件。开始规划重命名任务...

-----------------------------------------------------------------
序号    原文件名                       -> 新文件名
-----------------------------------------------------------------
1     draft_notes.txt            -> doc_archive_001.txt
2     meeting_v1.txt             -> doc_archive_002.txt
3     todo_summary.txt           -> doc_archive_003.txt
-----------------------------------------------------------------

【当前处于试跑模式 (Dry-Run)】未对实际文件进行任何修改。
确认要按上述方案执行实际重命名吗?(输入 y 确认,其他取消): y

重命名完成!成功处理: 3 / 3 个文件。os.system('mv ...') 依赖操作系统的 shell 命令改名,该方式在 Windows 与 Unix 上命令不同,且存在注入风险。使用 pathlib.Path.rename() 是现代 Python 最标准、最跨平台的实践。
项目五:网页正文提取与结构化归档工具
1. 项目目标与解决的问题
学习 Python 爬虫时,很多初学者一上来就被复杂的 JavaScript 逆向、反爬风控或重量级爬虫框架劝退。实际上,初学者最需要掌握的是 标准 HTTP 协议交互 与 HTML 树状节点流式解析 的基本过程。
该项目使用 Python 原生内置的 urllib.request 和 html.parser.HTMLParser,实现对静态网页的请求,过滤所有脚本、样式标签,提取出指定标签(如 <h1>、<p>)中的纯文本内容,并自动保存为本地 Markdown 归档文件。
2. 完整源码实现
# webpage_extractor.py
import urllib.request
import urllib.error
from html.parser import HTMLParser

class SimpleArticleParser(HTMLParser):
    def __init__(self):
        super().__init__()
        self.in_title = False
        self.in_target_tag = False
        self.ignore_tags = {'script', 'style', 'nav', 'footer', 'header'}
        self.current_ignore = False
        self.title = ""
        self.paragraphs = []
        self._current_tag = None

    def handle_starttag(self, tag, attrs):
        self._current_tag = tag.lower()
        if self._current_tag in self.ignore_tags:
            self.current_ignore = True
        elif self._current_tag in ('h1', 'h2', 'h3', 'p'):
            self.in_target_tag = True
        elif self._current_tag == 'title':
            self.in_title = True

    def handle_endtag(self, tag):
        t = tag.lower()
        if t in self.ignore_tags:
            self.current_ignore = False
        elif t in ('h1', 'h2', 'h3', 'p'):
            self.in_target_tag = False
        elif t == 'title':
            self.in_title = False

    def handle_data(self, data):
        if self.current_ignore:
            return
        cleaned_text = data.strip()
        if not cleaned_text:
            return

        if self.in_title and not self.title:
            self.title = cleaned_text
        elif self.in_target_tag:
            self.paragraphs.append((self._current_tag, cleaned_text))

def fetch_and_save_as_markdown(url: str, output_path: str):
    headers = {
        'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) SimplePythonBot/1.0'
    }
    req = urllib.request.Request(url, headers=headers)

    print(f"正在请求页面: {url}")
    try:
        with urllib.request.urlopen(req, timeout=10) as response:
            charset = response.headers.get_content_charset() or 'utf-8'
            html_bytes = response.read()
            html_text = html_bytes.decode(charset, errors='replace')
    except urllib.error.HTTPError as e:
        print(f"【HTTP错误】状态码: {e.code}, 原因: {e.reason}")
        return
    except urllib.error.URLError as e:
        print(f"【网络连接失败】原因: {e.reason}")
        return
    except Exception as e:
        print(f"【未知异常】{e}")
        return

    # 解析 HTML 内容
    parser = SimpleArticleParser()
    parser.feed(html_text)

    # 组装为 Markdown 格式
    lines = [f"# {parser.title or '未命名文章'}", f"\n> 来源URL: {url}\n"]
    for tag, content in parser.paragraphs:
        if tag == 'h1':
            lines.append(f"\n# {content}\n")
        elif tag == 'h2':
            lines.append(f"\n## {content}\n")
        elif tag == 'h3':
            lines.append(f"\n### {content}\n")
        elif tag == 'p':
            lines.append(f"{content}\n")

    markdown_result = "\n".join(lines)

    with open(output_path, "w", encoding="utf-8") as f:
        f.write(markdown_result)

    print(f"提取完成!共提取 {len(parser.paragraphs)} 个段落。")
    print(f"已保存至本地: {output_path}")

if __name__ == "__main__":
    # 以 Python 官方网站主页为例
    target_url = "https://www.python.org"
    output_file = "python_org_archive.md"
    fetch_and_save_as_markdown(target_url, output_file)
3. 运行方式与示例输出
执行命令:
python3 webpage_extractor.py终端运行示例:
正在请求页面: https://www.python.org
提取完成!共提取 18 个段落。
已保存至本地: python_org_archive.mdUser-Agent: Python-urllib/3.x 直接拦截并返回 403 Forbidden。因此在发起网络请求时,必须显式在 headers 中配置通用浏览器标识,以模拟合法客户端。
项目复盘与综合能力总结
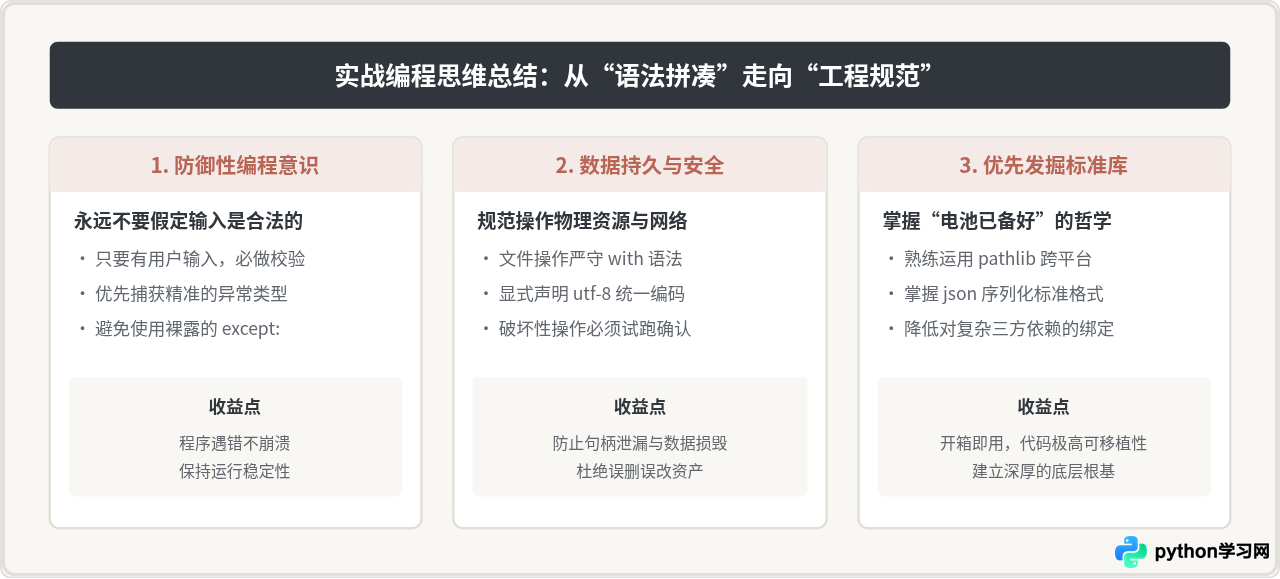
完成上述 5 个小项目的编写与排错后,初学者所掌握的技术栈将由零散的概念整合成一个有机的整体。下表对比了这 5 个实战项目的能力维度与学习收益:
| 序号 | 项目名称 | 核心应用场景 | 关键标准库 / 知识点 | 典型容易出现的 Bug |
|---|---|---|---|---|
| 01 | 智能猜数字游戏 | 交互逻辑与边界条件判断 | random, while, try-except |
字符串直接与数值比对、非整数输入导致崩溃 |
| 02 | 文本词频统计分析器 | 数据结构组合与文本清洗 | re, 字典计数, lambda 排序 |
未剔除标点符号造成脏词、空文本处理异常 |
| 03 | Todo 待办事项管理器 | 轻量级数据存储与业务CRUD | json, open() 上下文管理 |
文件未指定 UTF-8 导致乱码、JSON损坏崩溃 |
| 04 | 自动化批量文件重命名器 | 文件系统与跨平台脚本 | pathlib.Path, 预检机制 |
重复命名覆盖同名文件、误删系统只读文件 |
| 05 | 网页正文提取与归档工具 | 网络请求与结构化解析 | urllib.request, HTMLParser |
403 Forbidden 反爬拦截、编码格式识别错误 |
下一步的练习与拓展建议
完成这五个项目的编写后,建议读者不要立刻开启全新的理论学习,而是尝试对现有项目进行“增量功能重构”:
- 拓展项目一:为猜数字游戏增加“排行榜”功能,记录在相同难度下花费尝试次数最少的前三名玩家,并将成绩保存至本地。
- 拓展项目二:引入停用词表(Stop Words),在统计英文词频时自动剔除
a、the、is等没有实际信息量的虚词,提取文章核心关键词。 - 拓展项目三:为待办事项加入“截止日期”与“优先级(高/中/低)”字段,并在列表展示时支持按优先级或完成状态进行过滤筛选。
- 拓展项目四:将命令行批量重命名工具改造为支持正则表达式替换复杂名称规则(例如提取名称中的日期并移动至文件名前缀)。
- 拓展项目五:结合
concurrent.futures或threading模块,尝试同时抓取多个页面的正文,体验并发编程的基本魅力。
通过有意识地在现有可运行代码上进行“小步快跑”式迭代,你将更快摆脱新手期,建立起独立设计与实现软件功能的技术自信。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















