


Python网络编程常用库盘点:requests、socket与aiohttp选型指南
深入对比Python网络编程中socket、requests与aiohttp的核心差异。结合协议分层、运行机制、代码示例与决策树,全面解析不同场景下的技术选型与工程化落地策略。
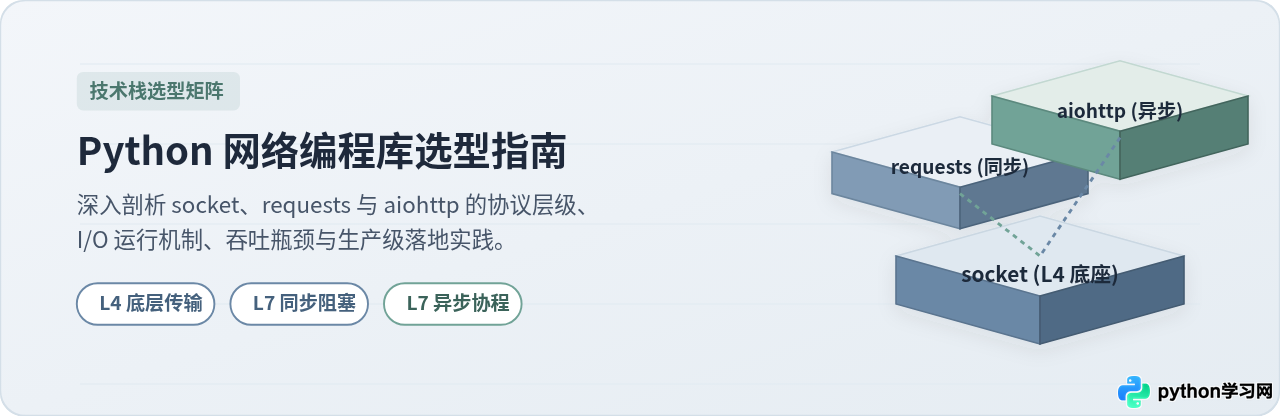
一、网络分层与运行时架构:三者究竟有何本质区别?
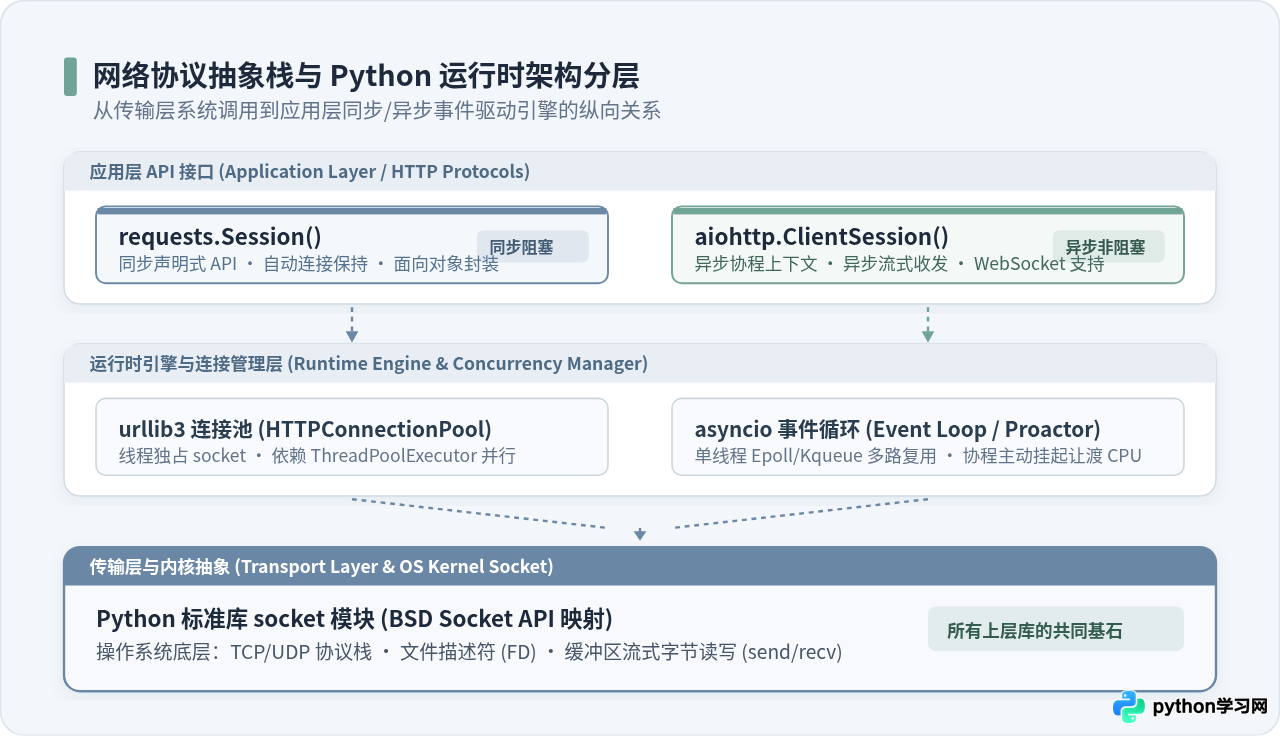
很多初学者容易将 socket、requests 和 aiohttp 放在同一个平面进行“好与坏”的简单对比,这在工程架构上是不准确的。三者在网络协议栈中所处的层级、面向的业务抽象以及底层事件调度模型完全不同。
从协议栈来看,标准库 socket 处于传输层(L4),直接封装了操作系统的套接字接口,处理的是无格式的原始字节流(TCP)或数据报(UDP);而 requests 和 aiohttp 则处于应用层(L7),封装了 HTTP/1.1 与 WebSocket 协议规范,自动处理 HTTP 请求行、头信息、Cookie、连接重用及 Chunked 传输编码。
从调度机制来看,requests 底层基于 urllib3 连接池,采用同步阻塞 I/O 模型。当一个线程发起网络请求时,该线程将被内核挂起,直到远端服务器返回全部响应数据。如果想用 requests 实现并发,必须依赖多线程(ThreadPoolExecutor)或多进程。然而在 CPython 的全局解释器锁(GIL)与线程上下文切换开销制约下,单机可支撑的并发线程数通常在数百以内。而 aiohttp 运行于 Python 3 的 asyncio 事件循环之上,利用操作系统的多路复用系统调用(Linux 下的 epoll、macOS 下的 kqueue),单线程即可管理成千上万个非阻塞网络连接,在等待远端 I/O 时主动让渡 CPU,从而获得极高的并发吞吐效率。
二、基础底座 socket:原生传输层通信与私有协议实现
socket 是 Python 标准库自带的核心模块,它是所有上层网络库(包括 urllib3、requests、aiohttp、twisted)能够与网卡进行交互的技术基石。
1. 典型应用场景
当满足以下任意条件时,通常需要直接使用 socket:
- 非 HTTP 协议通信:例如工业物联网(IoT)设备上报的自定义 Hex/Binary 报文、金融私有行情推送协议、DNS 探测与 Syslog 日志上报。
- 精细化流控与长连接保持:需要直接干预 TCP 窗口大小、设置底层
TCP_NODELAY禁用 Nagle 算法以降低微秒级延迟,或发送原始 UDP 组播广播。 - 学习网络底层机理:深入理解 TCP 三次握手、四次挥手、滑动窗口及缓冲区流控机制。
2. 完整客户端通信示例
以下代码展示了一个健壮的基础 TCP 客户端实现。重点演示了设置超时时间、循环接收数据以应对流式传输,以及异常关闭的完整生命周期:
import socket

def send_tcp_message(host: str, port: int, payload: bytes, timeout: float = 5.0) -> bytes:
    # 建立 IPv4 + TCP 原始套接字
    with socket.socket(socket.AF_INET, socket.SOCK_STREAM) as client_sock:
        # 设置连接与读写超时,防止由于网络断开导致线程永久阻塞
        client_sock.settimeout(timeout)

        try:
            # 发起三次握手连接目标服务端
            client_sock.connect((host, port))

            # 完整发送指定字节流 (sendall 内部自动处理分包循环)
            client_sock.sendall(payload)

            # 循环接收远端响应流
            chunks = []
            while True:
                # 每次最多从内核缓冲区提取 4KB 数据
                data = client_sock.recv(4096)
                if not data:
                    # 远端对端已正常关闭连接 (EOF)
                    break
                chunks.append(data)

            return b"".join(chunks)

        except socket.timeout:
            raise TimeoutError(f"对端主机 {host}:{port} 通信超时(超过 {timeout} 秒未响应)")
        except socket.error as err:
            raise ConnectionError(f"底层套接字网络异常: {err}")

if __name__ == "__main__":
    # 向公共网络服务发送基础 HTTP 探测报文(演示传输层原始文本流交互)
    request_data = b"HEAD / HTTP/1.1
Host: example.com
Connection: close

"
    response = send_tcp_message("example.com", 80, request_data, timeout=3.0)
    print("接收到的原始响应报文长度:", len(response))
    print(response.decode("utf-8", errors="replace")[:120])
接收到的原始响应报文长度: 368
HTTP/1.1 200 OK
Accept-Ranges: bytes
Content-Type: text/html; charset=UTF-8
Server: ECS (dcb/7F82)
recv() 读取的数据恰好对应对端的一次 send()。在生产环境下手写 socket 服务,必须在业务层设计边界协议(例如:固定包头携带 Packet Length、以特定换行符
截断,或采用 Protocol Buffers / MessagePack 封包),否则在网络抖动或大包传输时必然发生粘包导致数据解析错乱。此外,切勿在生产环境使用原生 socket 手写 HTTP 服务,HTTP 规范的复杂性(Transfer-Encoding、TLS 证书验证、HTTP/2 多路复用)非个人维护代码所能安全覆盖。
三、敏捷开发标准库代名词 requests:同步 HTTP 请求的黄金标准
requests 在 Python 开发者生态中享有极高的声誉,其设计哲学是“HTTP for Humans”。它把复杂的 HTTP 规范、Cookie 持久化、重定向跟踪、多部分文件上传和身份认证抽象成了极具人性化的面向对象 API。
1. 典型应用场景
- 日常研发与自动化运维:部署触发、CI/CD 状态同步、服务器巡检通知推送。
- 常规第三方服务集成:微信支付回调、短信网关对接、企业内部 ERP/CRM 系统数据接口交互。
- 中小规模数据爬取与数据分析:爬取目标站防爬严格需要精细模拟 Cookie、代理及请求头,但总并发量在数十到数百之间的场景。
- 快速原型验证与脚本编写:单机脚本在 5 分钟内完成功能开发,调试直观。
2. 完整企业级请求示例(会话池与指数退避重试)
在实际工程中,切忌直接调用无连接池管理的 requests.get(),而应使用 requests.Session 搭配 HTTPAdapter 确保连接复用和失败重试:
import requests
from requests.adapters import HTTPAdapter
from urllib3.util.retry import Retry

def create_resilient_session(total_retries: int = 3, backoff_factor: float = 0.5) -> requests.Session:
    """构建具备连接池复用与指数退避重试的生产级 Session 对象"""
    session = requests.Session()

    # 定义重试策略:仅针对瞬时网络波动或 5xx 服务端错误实施重试,跳过 4xx 客户端错误
    retry_strategy = Retry(
        total=total_retries,
        backoff_factor=backoff_factor,  # 间隔公式: backoff_factor * (2 ** (retry_number - 1))
        status_forcelist=[500, 502, 503, 504],
        allowed_methods=["HEAD", "GET", "OPTIONS"] # 仅对幂等方法开启重试,保护写接口安全
    )

    # 将重试适配器挂载至 http 与 https 协议,配置连接池上限
    adapter = HTTPAdapter(max_retries=retry_strategy, pool_connections=10, pool_maxsize=20)
    session.mount("https://", adapter)
    session.mount("http://", adapter)

    # 统一设定通用 User-Agent
    session.headers.update({
        "User-Agent": "EnterpriseWorker/1.0 (Integration; Internal-API)",
        "Accept": "application/json"
    })
    return session

def fetch_json_resource(url: str, params: dict = None) -> dict:
    session = create_resilient_session()
    try:
        # 分离 connect 超时 (3.05s) 与 read 超时 (15.0s)
        # 连接超时建议略大于 3 的倍数(应对 TCP 重发 SYN 包的时间间隔)
        response = session.get(url, params=params, timeout=(3.05, 15.0))

        # 严格校验 HTTP 状态码,如果为 4xx/5xx 则直接抛出 HTTPError
        response.raise_for_status()

        return response.json()

    except requests.exceptions.Timeout:
        raise RuntimeError(f"请求服务超时: 远端接口未在规定时间内响应: {url}")
    except requests.exceptions.HTTPError as err:
        raise RuntimeError(f"服务端响应状态码异常 ({response.status_code}): {err}")
    except requests.exceptions.RequestException as err:
        raise RuntimeError(f"底层网络传输失败: {err}")
    finally:
        session.close()

if __name__ == "__main__":
    test_url = "https://httpbin.org/get"
    result = fetch_json_resource(test_url, params={"category": "network", "page": 1})
    print("接口调用成功,返回 IP 节点:", result.get("origin"))
    print("URL 查询参数:", result.get("args"))
接口调用成功,返回 IP 节点: 203.0.113.42
URL 查询参数: {'category': 'network', 'page': '1'}
ThreadPoolExecutor(max_workers=200),系统内存中需要维护 200 个真实的操作系统线程(每个线程栈占用数 MB 内存),操作系统内核在大量线程间频繁进行寄存器现场切换,导致大量 CPU 时间耗费在上下文调度上。因此,requests 的并发上限通常在每秒数百次请求,超过此规模应考虑向协程迁移。
三、高并发利器 aiohttp:asyncio 生态下的异步非阻塞网络引擎
aiohttp 是基于 Python 官方异步框架 asyncio 构建的完整 HTTP 客户端与服务端解决方案。与 requests 不同,aiohttp 内部所有 I/O 操作均通过 await 挂起协程,使单个 Python 进程能够以极低的内存开销维持数万个并发网络请求。
1. 典型应用场景
- 海量并发网页数据抓取:全网新闻、电商价格监控、舆情采集等单机日吞吐量达百万级的网络爬虫系统。
- 异步 Web 服务的上游依赖聚合:在 FastAPI、Tornado 或 Sanic 服务内部,并行调用多个后端微服务接口进行聚合。
- WebSocket 长连接网关:构建低延迟双向推送服务,如即时聊天服务器、行情实时广播等。
2. 完整并发抓取与限流保护示例
在异步并发场景中,最容易犯的错误是无节制地向远端目标瞬间打出上万个请求,导致本地文件描述符耗尽(Too many open files)或对方服务器直接 429/拉黑。生产环境必须结合 asyncio.Semaphore 信号量进行并发限流:
import asyncio
import aiohttp

async def fetch_item(session: aiohttp.ClientSession, url: str, item_id: int, semaphore: asyncio.Semaphore) -> dict:
    """使用信号量保护并发粒度"""
    async with semaphore:
        try:
            # 单次请求超时设置:total 为整体上限,connect 为连接握手上界
            timeout_setting = aiohttp.ClientTimeout(total=10.0, connect=3.0)

            async with session.get(url, params={"id": item_id}, timeout=timeout_setting) as resp:
                if resp.status == 200:
                    payload = await resp.json()
                    return {"id": item_id, "status": "success", "data": payload.get("args")}
                else:
                    return {"id": item_id, "status": "failed", "http_code": resp.status}
        except asyncio.TimeoutError:
            return {"id": item_id, "status": "timeout"}
        except Exception as exc:
            return {"id": item_id, "status": "error", "reason": str(exc)}

async def run_batch_crawler(target_urls: list, max_concurrent: int = 5):
    # 限制并发任务数,避免瞬时网络洪峰
    sem = asyncio.Semaphore(max_concurrent)

    # 配置底层 TCPConnector 连接池限制
    connector = aiohttp.TCPConnector(limit=50, limit_per_host=10, keepalive_timeout=30.0)

    async with aiohttp.ClientSession(connector=connector) as session:
        tasks = []
        for index, base_url in enumerate(target_urls):
            # 将每个抓取动作封装为一个 Coroutine
            tasks.append(fetch_item(session, base_url, index, sem))

        # 并发执行全部任务并回收结果
        results = await asyncio.gather(*tasks, return_exceptions=False)
        return results

if __name__ == "__main__":
    # 模拟 10 个需要并行请求的目标接口
    urls = ["https://httpbin.org/get"] * 10

    # 启动 Python 3 原生事件循环
    final_output = asyncio.run(run_batch_crawler(urls, max_concurrent=4))

    print(f"并发请求执行完毕,共完成 {len(final_output)} 个任务")
    for row in final_output[:3]:
        print("  任务明细:", row)
并发请求执行完毕,共完成 10 个任务
任务明细: {'id': 0, 'status': 'success', 'data': {'id': '0'}
任务明细: {'id': 1, 'status': 'success', 'data': {'id': '1'}
任务明细: {'id': 2, 'status': 'success', 'data': {'id': '2'}
asyncio 的高并发全部依赖于单线程事件循环的快速流转。如果你在某个协程函数中执行了 time.sleep(5)、requests.get() 或密集的大 JSON 解析,整个事件循环线程将被彻底卡死 5 秒,期间成千上万个其他并发网络连接都会因此发生超时断连!如果在异步服务中必须调用同步库,必须通过 asyncio.to_thread() 或 run_in_executor 将其卸载至独立后台线程池中执行。
四、选型决策指南:如何根据业务特征推导最优技术栈?
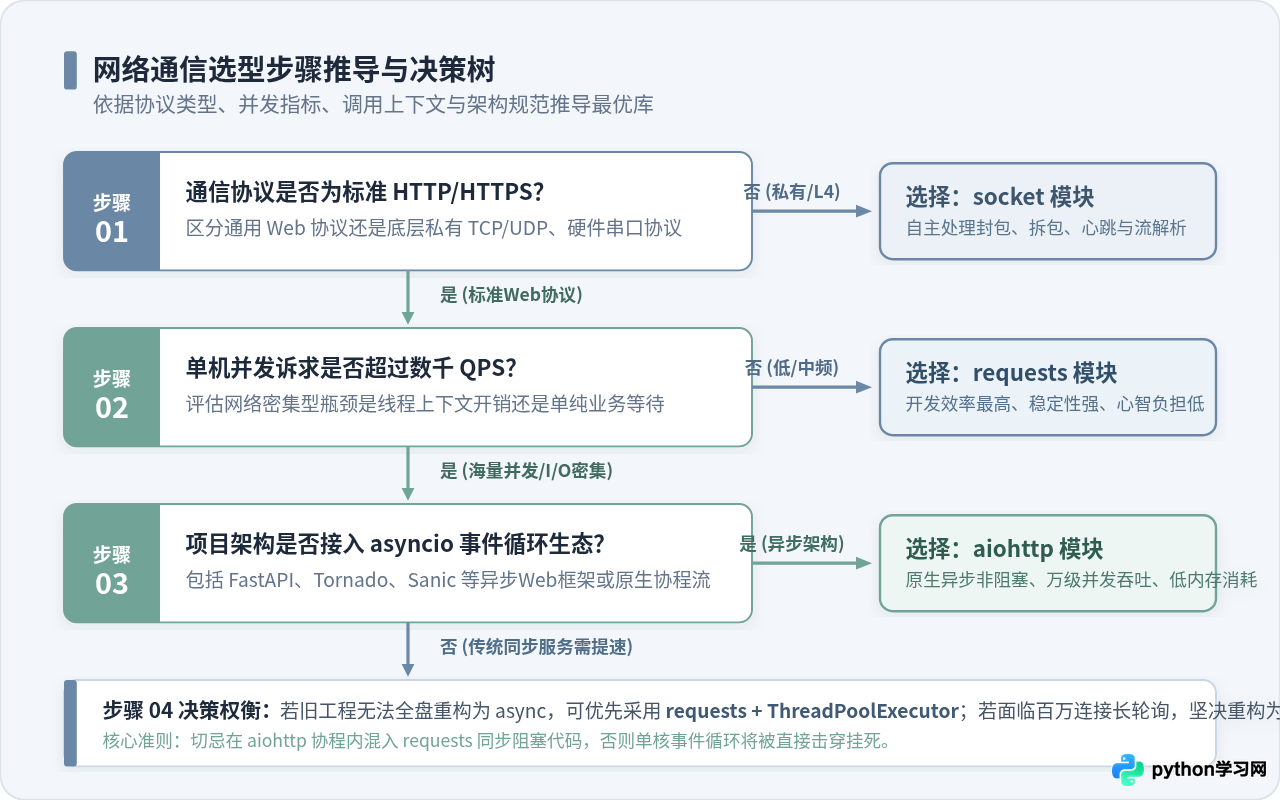
技术选型从来不是追逐“最新”或“吞吐最高”,而是基于团队成本、维护门槛和真实业务瓶颈做出合理的权衡。以下四步推导决策树可帮助你在立项时快速锁定最佳方案:
核心维度对比矩阵
为了让不同维度的差异一目了然,下表汇总了三个库在协议、运行模型与工程落地时的量化对比:
| 对比维度 | socket | requests | aiohttp |
|---|---|---|---|
| 协议层级 | 传输层 (L4 TCP/UDP) | 应用层 (L7 HTTP/1.1) | 应用层 (L7 HTTP/1.1 & WebSocket) |
| I/O 模型 | 阻塞/非阻塞原生字节流 | 同步阻塞(线程级调度) | 异步非阻塞(协程事件驱动) |
| 并发吞吐表现 | 由应用层自行实现的多路复用决定 | 中低吞吐 (通常 < 300 QPS) | 超高吞吐 (单机可达数千至上万 QPS) |
| 内存资源占用 | 极低 (字节缓冲区) | 较高 (多线程并发时线程栈开销大) | 极低 (协程对象仅占用数 KB) |
| 开发心智门槛 | 高(需处理粘包、编码、心跳保活) | 极低(直观易用,开箱即用) | 中等(需熟悉 async/await 异步范式) |
| 依赖管理 | Python 官方标准库(零依赖) | 第三方生态 (依赖 urllib3、certifi 等) | 第三方生态 (依赖 yarl、multidict、aiosignal) |
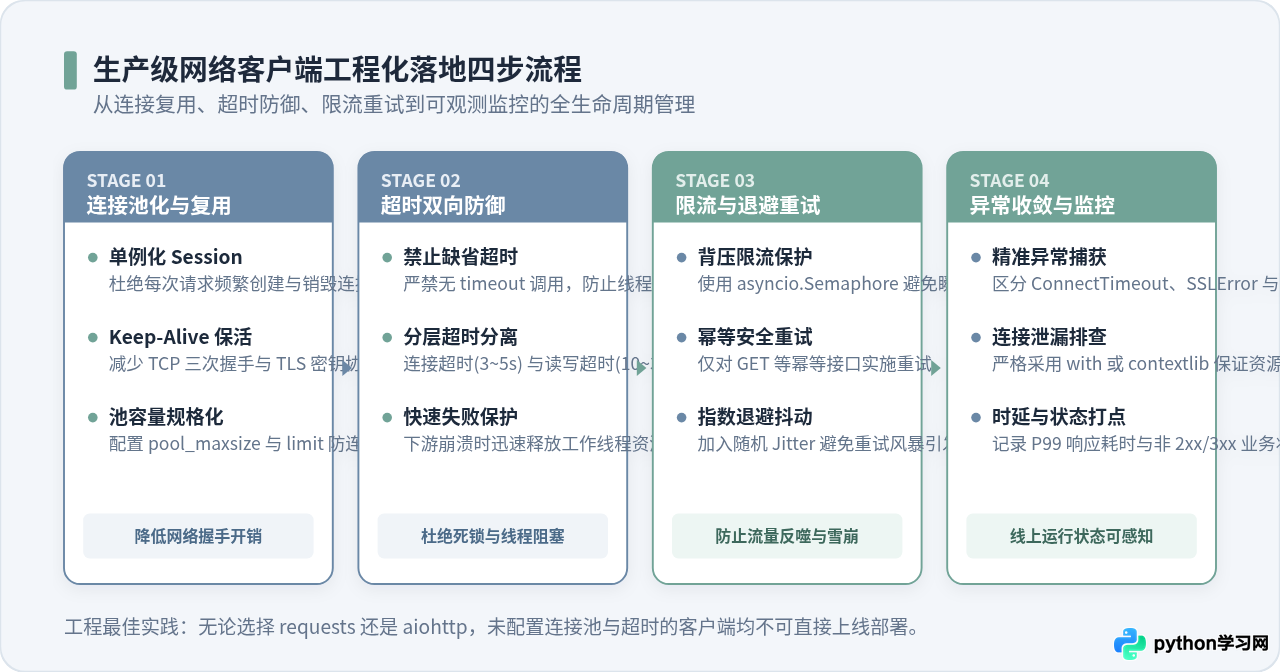
五、生产级网络客户端工程化实施流程
无论选定哪个库,在真实线上生产环境中部署网络客户端,都必须遵循一套标准的工程防护流程。很多网络偶发故障、雪崩事故都来源于未遵循这些最佳实践:
- 阶段一:连接复用与连接池治理
严禁在循环体内部反复执行requests.get()或频繁实例化aiohttp.ClientSession()。这不仅会消耗大量本地临时端口,导致短时间内产生海量的TIME_WAIT状态套接字,还会因反复进行 TCP 三次握手和 TLS 握手显著拖慢业务吞吐。全局或模块级单例复用连接池是生产环境的铁律。 - 阶段二:分层超时防御机制
永远不要发起没有设置timeout的请求。必须区分连接超时(Connect Timeout)和读取超时(Read Timeout)。连接超时通常设置在 3 到 5 秒(应对路由抖动或防火墙丢包),读取超时则根据后端接口的计算耗时设置在 10 到 30 秒。 - 阶段三:背压限流与退避重试
在进行批量抓取或高频调用时,必须通过信号量(Semaphore)或令牌桶(Token Bucket)限制并发突发速率。网络瞬时抖动发生时,只对幂等方法(GET、HEAD)实施重试,且必须加入指数退避与随机抖动(Jitter),防止几十个客户端同时重试形成“惊群效应”打垮下游服务。 - 阶段四:精准异常收敛与指标监控
不可用宽泛的except Exception掩盖所有网络错误。应区分 DNS 域名解析失败、连接重置(Connection Reset)以及 HTTP 业务 5xx 状态码。在监控侧记录网络调用的 P95、P99 耗时分布,及时捕获网络退化迹象。
六、综合总结与技术选型速查
在 Python 的网络编程版图中,socket、requests 与 aiohttp 各有其明确的历史定位与技术优势:
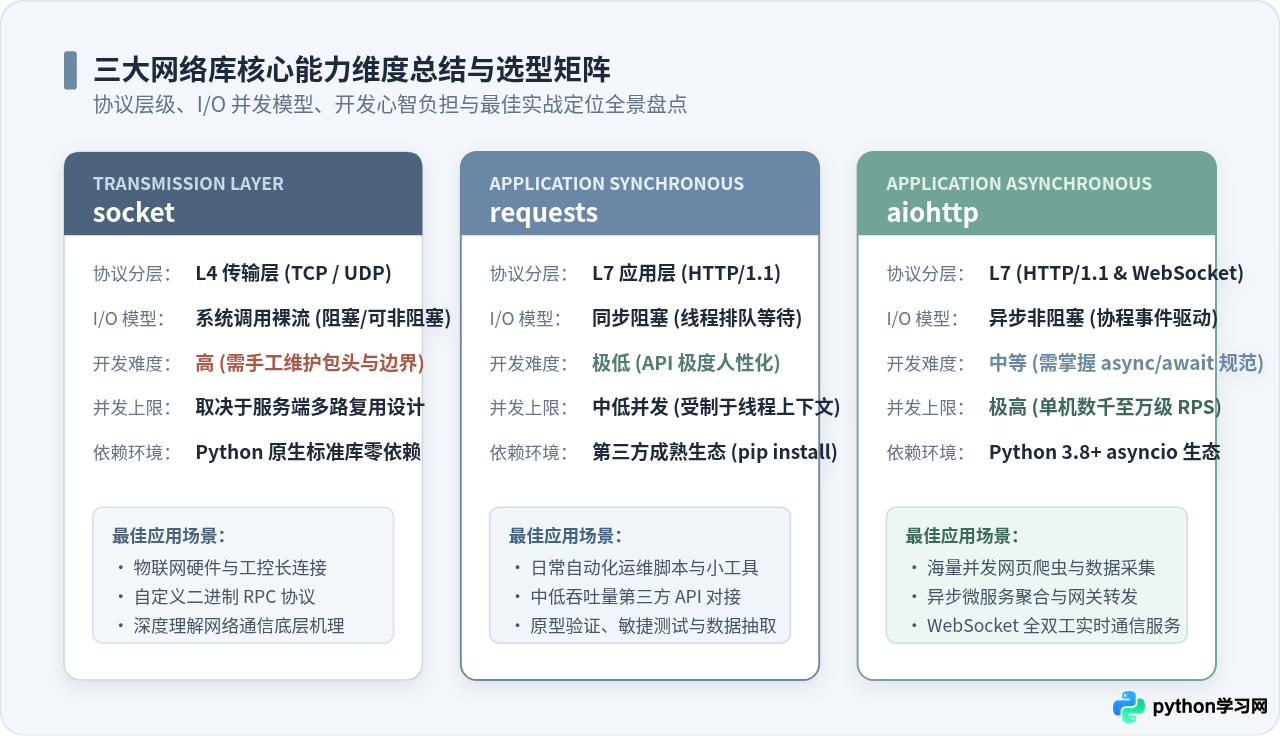
总结一句话选型法则:底层协议与长连接交互用 socket,单机常规调用与高敏捷开发用 requests,高并发 I/O 密集型场景与现代异步生态用 aiohttp。合理匹配业务指标与框架生态,才能在保障代码可维护性的同时,最大化发挥 Python 系统的并发潜力与运行稳定性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















