


Pandas DataFrame怎么实现字符串模糊匹配
系统介绍在Pandas DataFrame中实现字符串模糊匹配的核心方法与工程实践。涵盖标准库difflib、高性能RapidFuzz及TF-IDF余弦相似度三种方案,详解唯一值映射与大规模数据关联优化技巧。
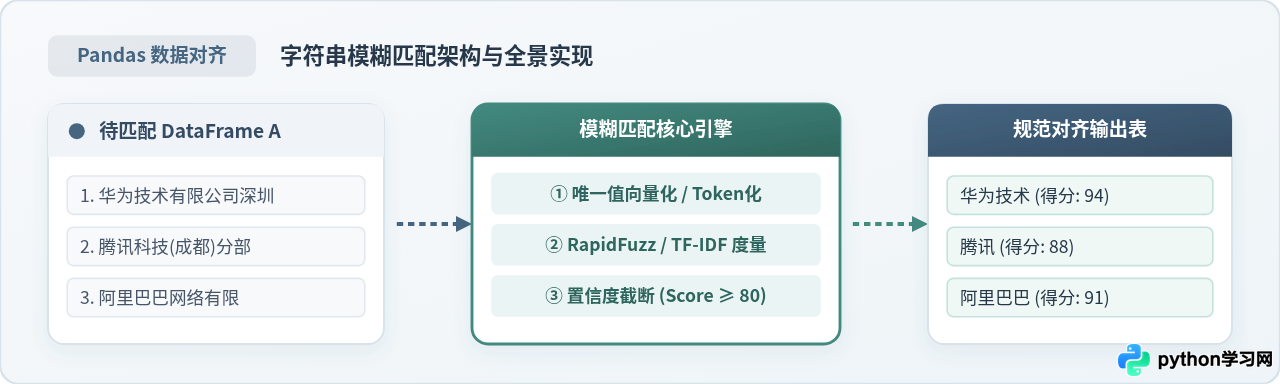
在实际数据分析与清洗过程中,合并两张表格通常使用 pd.merge()。但当关联字段(如公司名称、商品型号、用户地址等)存在缩写、别名、拼写错漏或词序颠倒时,精确关联往往无法命中。Pandas 自身虽然提供了 Series.str.contains() 等基于正则表达式的子串检索工具,但并没有内置直接对两列文本做近似度量与合并的 fuzzy_merge 函数。解决该问题的标准路径是:先利用文本相似度算法(如 difflib、RapidFuzz 或 TF-IDF)为待清洗项匹配出标准基准项与置信度得分,再通过 Pandas 的 Series.map() 或 pd.merge() 完成最终关联。本文将针对不同数据规模与业务场景,逐一讲解具体实现方法与性能调优策略。
一、字符串模糊匹配的标准处理流程
很多初学者在遇到模糊匹配任务时,常常直接使用两层嵌套循环对整个 DataFrame 进行逐行比较。当两张表各有一万行时,比较次数将高达一亿次,导致程序假死。规范的工业级实现流程应当严格拆分为四个阶段:
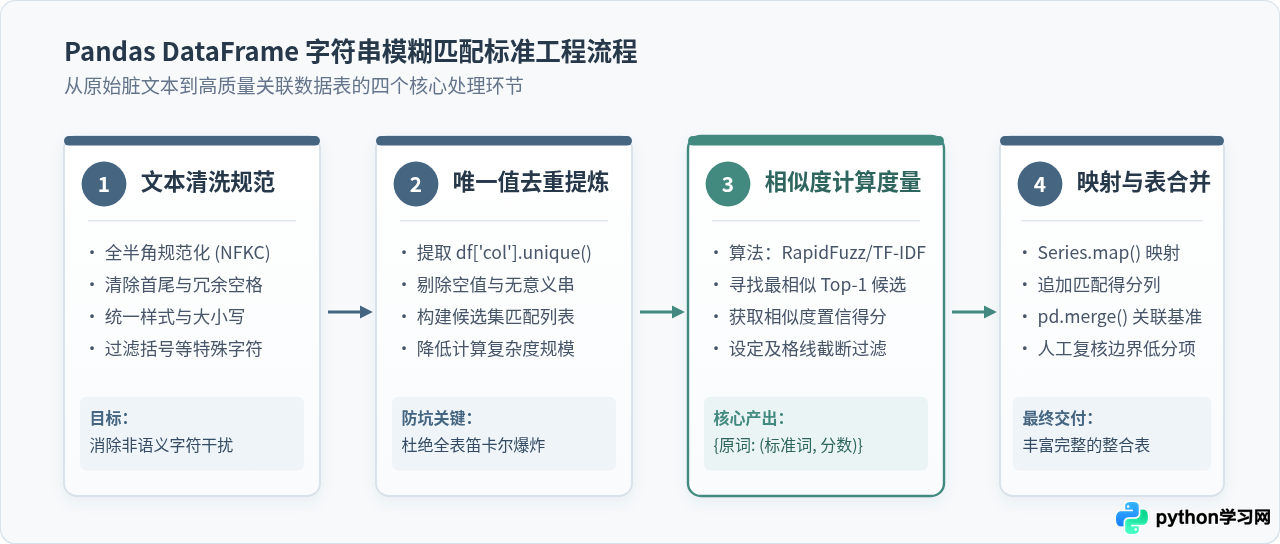
- 文本清洗与规范化:在比对之前,剔除所有无关干扰。包括统一全角半角字符(通过
unicodedata.normalize)、清除首尾和连续多余空格、统一英文大小写,以及剔除“()”、“/”等标点符号。 - 提取唯一值列表(关键性能点):绝不要在含有重复项的完整 DataFrame 间做两两比对。先使用
df['col'].dropna().unique()提取出互不相同的字符串列表。通常数万行的业务表,去重后往往只有几百到几千个独立实体,可使计算量成百上千倍下降。 - 相似度度量与阈值截断:选用适合数据量级的算法,计算待匹配词与候选基准词之间的相似度分值(通常在 0 到 100 之间),筛选出最佳候选(Top-1)并设定及格线(例如 80 分)。低于阈值的项归类为未匹配,避免引入错误匹配。
- 字典映射与回填关联:将计算得到的
{待匹配词: 匹配标准词}构建为 Python 字典,调用Series.map()毫秒级回填到原始 DataFrame,随后再执行常规的pd.merge()完成多列属性的拼接。
二、方案一:使用 Python 标准库 difflib(轻量无依赖)
如果当前环境受到限制不能安装第三方依赖,或者待比对的独立字符串数量较少(通常在 1,000 条以内),Python 自带的 difflib 模块是最快捷的工具。其内置函数 difflib.get_close_matches 基于 Ratcliff/Obershelp 算法计算相似度。
代码实现
import pandas as pd
import difflib

# 1. 构造演示用的两个 DataFrame
df_source = pd.DataFrame({
    'customer_input': ['苹果科技', '华为终端有限公司', '腾讯网讯', '微软中国分公司', '未知小铺'],
    'order_id': [1001, 1002, 1003, 1004, 1005]
})

df_standard = pd.DataFrame({
    'std_name': ['苹果公司', '华为技术有限公司', '腾讯科技有限公司', '微软公司', '阿里巴巴集团'],
    'std_code': ['A01', 'H02', 'T03', 'M04', 'B05']
})

# 2. 提取标准名称列表作为匹配池
standard_choices = df_standard['std_name'].tolist()

# 3. 定义匹配辅助函数
def match_name_difflib(name, choices, cutoff=0.5):
    # cutoff 为相似度阈值,范围 0~1,n=1 表示只取最相似的第一项
    matches = difflib.get_close_matches(name, choices, n=1, cutoff=cutoff)
    return matches[0] if matches else None

# 4. 在唯一值上构建映射字典
unique_inputs = df_source['customer_input'].unique()
mapping = {name: match_name_difflib(name, standard_choices, cutoff=0.45) for name in unique_inputs}

# 5. 映射回原始 DataFrame 并进行关联
df_source['matched_std_name'] = df_source['customer_input'].map(mapping)
df_result = pd.merge(df_source, df_standard, left_on='matched_std_name', right_on='std_name', how='left')

print(df_result[['order_id', 'customer_input', 'matched_std_name', 'std_code']])difflib 是纯 Python 实现,计算复杂度较高,且不支持词序打乱。当比对规模超过数千条时耗时明显增加,如果数据量较大,推荐使用更专业的 RapidFuzz。
三、方案二:使用 RapidFuzz 库(工业级高性能首选)
RapidFuzz 是目前 Python 生态中综合表现最优的模糊匹配库。它是 FuzzyWuzzy / thefuzz 的现代替代品,底层由 C++ 实现,算法经过 AVX2 和 SIMD 优化,执行速度比旧库快数十倍,且协议更友好(MIT 开源协议)。
安装命令:pip install rapidfuzz
算法度量模式的选择
在 RapidFuzz 中,选择正确的评分器(Scorer)对中文和英文业务实体的匹配效果至关重要。常见的三种算法原理与表现差异如下:
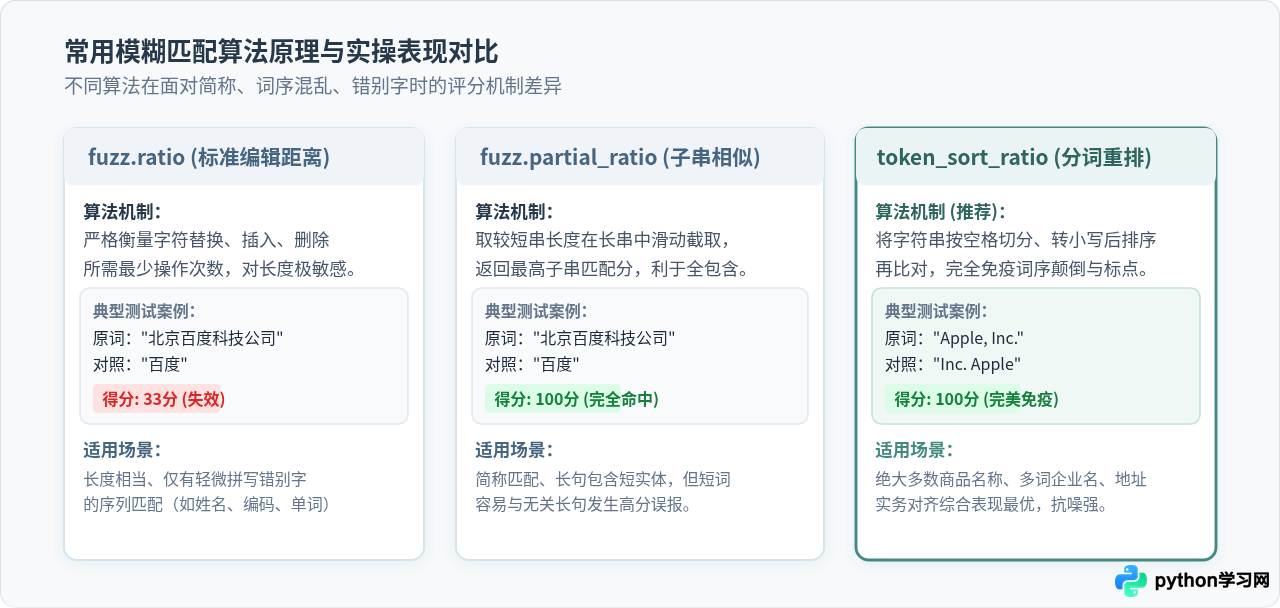
fuzz.ratio:严格的最短编辑距离比值。要求两个字符串长度相近且字符顺序一致,适合检查纯错别字。fuzz.partial_ratio:滑动窗口子串比对。只要短串完全出现在长串中即得满分,适合长文本中提取实体,但短词容易发生误匹配。fuzz.token_sort_ratio(强烈推荐):先对字符串进行分词、清洗标点并字母排序后再计算相似度。能完美解决“Apple Inc.”与“Inc. Apple”、“北京 百度”与“百度 北京”这类词序倒置问题。
在 DataFrame 中批量计算最佳匹配与相似度得分
在实际业务中,我们不仅要得到最佳匹配名称,还必须保留具体的相似度分数,以便于后期筛选和核验。
import pandas as pd
from rapidfuzz import process, fuzz

# 准备包含词序颠倒和增删字的待清洗数据
df_raw = pd.DataFrame({
    'raw_title': [
        'Python编程:从入门到实践 (第2版)',
        '流畅的Python 第二版',
        '算法导论 原书第3版',
        '机器学习实战 纯Python实现',
        '无效测试书籍ABCD'
    ]
})

# 标准书库
df_library = pd.DataFrame({
    'isbn': ['978-1', '978-2', '978-3', '978-4'],
    'book_title': [
        'Python编程从入门到实践',
        '流畅的Python',
        '算法导论',
        '机器学习'
    ]
})

std_titles = df_library['book_title'].tolist()

# 提取唯一值进行快速匹配
unique_raw = df_raw['raw_title'].dropna().unique()

match_results = {}
# process.extractOne 内部具备快速剪枝机制
for text in unique_raw:
    # 返回结构: (匹配文本, 得分, 在列表中的索引)
    res = process.extractOne(
        text,
        std_titles,
        scorer=fuzz.token_sort_ratio,
        score_cutoff=60  # 设定最低及格分,低于此分直接返回 None
    )
    if res:
        match_results[text] = (res[0], round(res[1], 1))
    else:
        match_results[text] = (None, 0.0)

# 将匹配名称与得分分别解包回原始数据表
df_raw['matched_book'] = df_raw['raw_title'].map(lambda x: match_results[x][0])
df_raw['match_score'] = df_raw['raw_title'].map(lambda x: match_results[x][1])

# 与标准书库合并
df_merged = pd.merge(df_raw, df_library, left_on='matched_book', right_on='book_title', how='left')
print(df_merged[['raw_title', 'matched_book', 'match_score', 'isbn']])四、跨表关联的工程架构与性能倍增技巧
当待关联的 DataFrame 数据量达到数万至数十万行时,直接对整列执行 apply 会导致灾难性的耗时。必须采用“抽取唯一值 ➔ 核心比对 ➔ 字典映射 ➔ 整体合并”的拓扑架构。
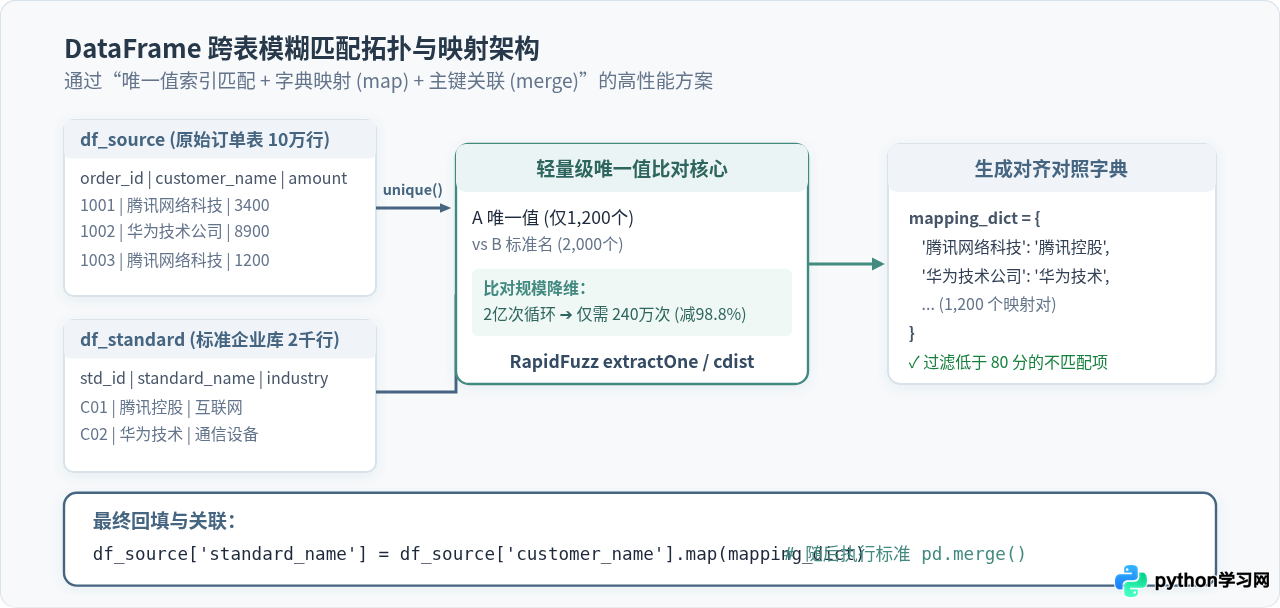
利用 RapidFuzz cdist 进行矩阵级批量加速
如果待匹配列表和标准库都在数千级别,可以使用 rapidfuzz.process.cdist 直接生成距离矩阵,利用底层 C++ 多线程计算,效率进一步提升:
import numpy as np
import pandas as pd
from rapidfuzz import process, fuzz

def fast_fuzzy_merge(df_left, df_right, left_col, right_col, threshold=75):
    # 1. 抽取唯一值
    left_unique = df_left[left_col].dropna().unique()
    right_unique = df_right[right_col].dropna().unique()

    # 2. 批量计算相似度矩阵 (len(left_unique) x len(right_unique))
    matrix = process.cdist(left_unique, right_unique, scorer=fuzz.token_sort_ratio, workers=-1)

    # 3. 寻找每行的最大值及其位置
    best_match_indices = np.argmax(matrix, axis=1)
    best_scores = np.max(matrix, axis=1)

    # 4. 组装结果映射字典
    mapping_dict = {}
    for i, left_val in enumerate(left_unique):
        score = best_scores[i]
        if score >= threshold:
            mapping_dict[left_val] = (right_unique[best_match_indices[i]], score)
        else:
            mapping_dict[left_val] = (None, score)

    # 5. 回填
    res_df = df_left.copy()
    res_df['_matched_key'] = res_df[left_col].map(lambda x: mapping_dict.get(x, (None, 0))[0])
    res_df['match_score'] = res_df[left_col].map(lambda x: mapping_dict.get(x, (None, 0))[1])

    # 关联标准表属性
    return pd.merge(res_df, df_right, left_on='_matched_key', right_on='right_col'.replace("'", ""), how='left').drop(columns=['_matched_key'])
五、方案三:超大规模数据匹配(TF-IDF + 字符 N-Gram 余弦相似度)
当两张表的唯一实体量级均超过 3 万到 10 万条时,无论是 Levenshtein 还是 RapidFuzz,其计算复杂度都是 $O(M \times N)$。十万乘以十万需要进行 100 亿次编辑距离计算,耗时将从分钟级延长至数小时甚至数天。
此时的标准工业级方案是转用 字符级 N-Gram 向量化 + 稀疏矩阵乘法:利用 scikit-learn 的 TfidfVectorizer 将文本转换为词频稀疏矩阵,通过稀疏点积在数秒内算出全量余弦相似度,筛选出候选匹配项。
import pandas as pd
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.metrics.pairwise import cosine_similarity
import numpy as np

# 模拟十万级商品数据中的两个样本切片
source_names = pd.Series(['Apple iPhone 15 Pro Max 256G 黑色', '华为 Mate 60 Pro 12GB+512GB 雅川青'])
target_catalog = pd.Series(['苹果 iPhone 15 Pro Max 256GB 暗黑', '华为 Mate60 Pro 512G 青色', '小米 14 Ultra'])

# 1. 采用字符级 2~3 元切分 (char_wb 兼顾词边界)
vectorizer = TfidfVectorizer(analyzer='char_wb', ngram_range=(2, 3))
tfidf_matrix = vectorizer.fit(target_catalog)

# 2. 变换两张表的文本为稀疏特征矩阵
target_tfidf = vectorizer.transform(target_catalog)
source_tfidf = vectorizer.transform(source_names)

# 3. 稀疏矩阵点积计算余弦相似度 (毫秒级)
sim_matrix = cosine_similarity(source_tfidf, target_tfidf)

# 4. 获取最相似候选索引与分值
best_idx = np.argmax(sim_matrix, axis=1)
best_sim = np.max(sim_matrix, axis=1)

for i, src in enumerate(source_names):
    score = round(best_sim[i] * 100, 1)
    matched_target = target_catalog.iloc[best_idx[i]]
print(f"原项: {src} ➔ 匹配: {matched_target} (相似度: {score}%)")六、技术选型决策与落地避坑指南
面对具体的业务需求,应结合数据量、准确率要求及运行环境选择合适的技术栈:
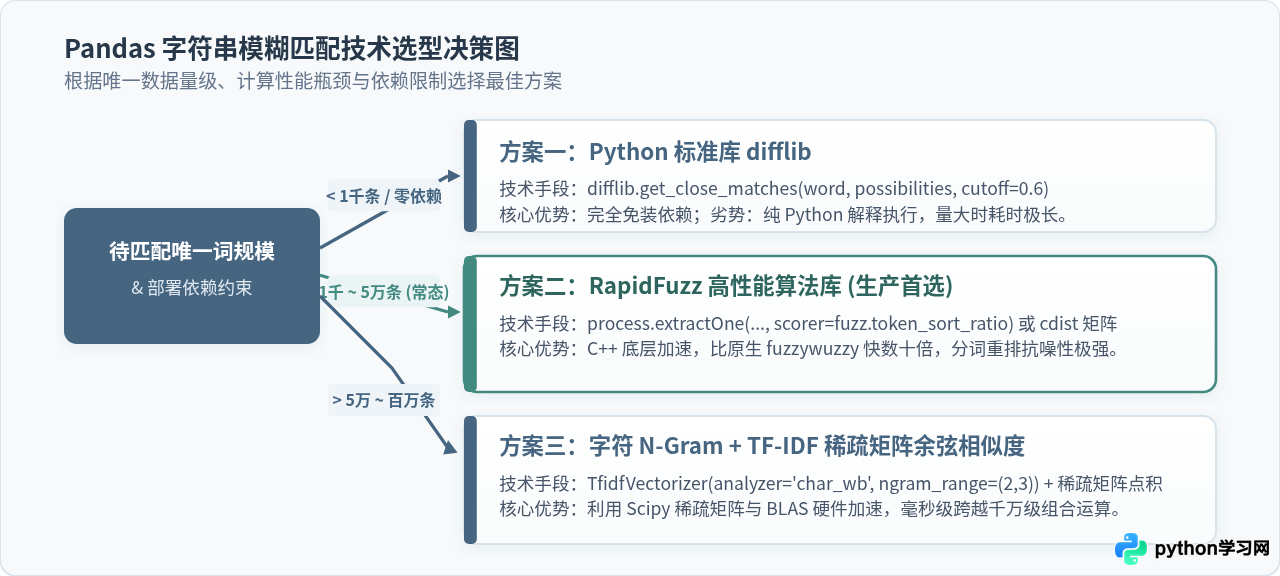
三种方案的核心指标综合对比
| 技术方案 | 依赖项 | 适用唯一数据规模 | 计算耗时 (万条量级) | 抗噪特点 |
|---|---|---|---|---|
| difflib | Python 内置无依赖 | < 1,000 条 | 极慢 (> 10 分钟) | 仅支持简单顺序相近文本 |
| RapidFuzz (推荐) | pip install rapidfuzz |
1,000 ~ 50,000 条 | 快 (几秒至半分钟) | 支持分词重排、子串匹配,极抗噪 |
| TF-IDF + 余弦相似 | scikit-learn, scipy |
50,000 ~ 1,000,000+ 条 | 极快 (矩阵并行秒级完成) | 对超长文本、海量商品库对齐效果卓越 |
实务操作中的三个关键避坑规则
不要盲目相信算法得出的最高分。在生产环境中,建议设立三段式分流规则:
- 得分 ≥ 88 分:高置信度区间,系统自动完成关联。
- 75 分 ≤ 得分 < 88 分:疑似区间,生成复核表,由人工点击确认或抽检。
- 得分 < 75 分:低置信度区间,判定为未匹配(置为
None / NaN),防止污染统计报表。
在企业名称或地址匹配中,像“有限公司”、“网络科技”、“大厦”、“室”等词汇在每个样本中高频出现,会大幅拉高无关实体的基础分。匹配前应先通过正则替换清洗掉这部分高频噪音词,直接比对核心品牌词(如“腾讯”、“华为”),准确率可提升 30% 以上。
始终坚持先提取
df['col'].unique(),计算映射字典后再通过 Series.map() 赋值。这一步是保证 Python 脚本能在几十秒内跑完而不是卡死崩溃的核心关键。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















