


Python使用numpy批量生成随机数组的代码
本文详细讲解如何使用 Python 的 NumPy 库批量生成随机数组。文章介绍现代 default_rng 架构规范、多维形状参数设定、均匀分布、正态分布、离散整数与带权抽样的完整代码示例,并解析内存连续布局与种子复现注意事项。
np.random.default_rng)的完整可运行代码,涵盖一维到高维批次张量的构建方法,详解连续均匀、正态分布、离散整数与带权抽样的具体实现,并剖析可复现随机种子与连续内存性能优化策略。
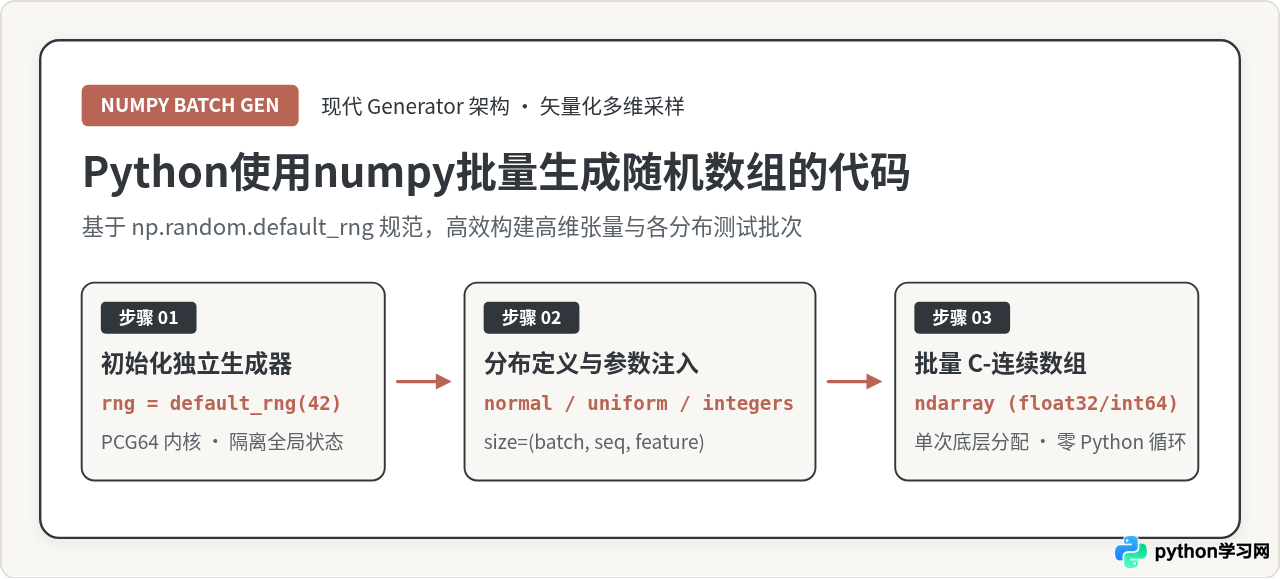 图 0:NumPy 批量随机数组生成的核心架构与处理管线缩略图
一、核心思路与现代 API 初始化
在 Python 中使用 NumPy 批量生成随机数组,核心关键在于直接向分布函数传递期望的张量形状元组(size 参数)。NumPy 底层通过 C 语言循环在单次系统调用中分配整块连续物理内存并完成随机数填充,从而彻底避免在 Python 层面使用 for 循环追加列表或反复拼接数组带来的严重性能损耗。
从 NumPy 1.17 开始,官方推荐并全面转向基于面向对象的 default_rng() 架构,替代传统的 np.random.rand() 或 np.random.seed()。现代方法采用 PCG64 伪随机位生成器,不仅具备更优异的统计随机质量和生成速度,还实现了随机状态的实例隔离,杜绝全局状态被其他第三方模块意外篡改。
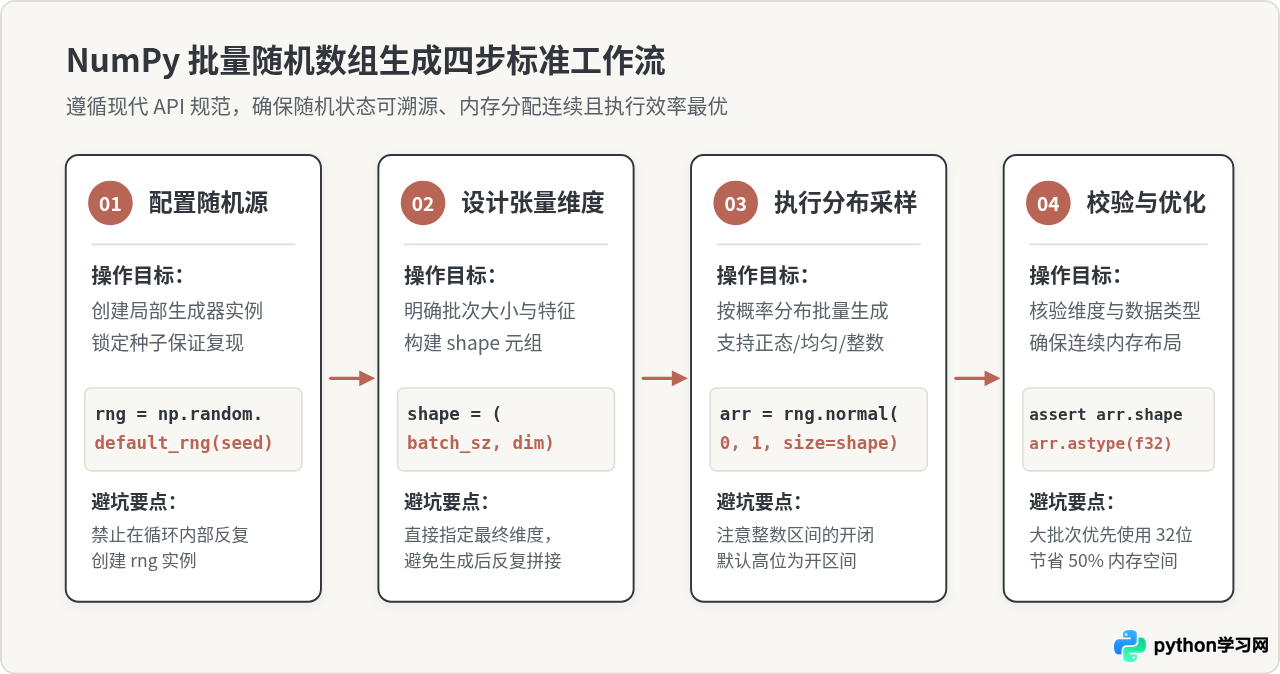 图 1:NumPy 批量随机数组生成的四步标准操作流程
初始化生成器并准备环境的标准代码如下:
import numpy as np

# 1. 设定随机种子以确保结果严格可复现(若不需要固定结果,留空参数即可)
SEED = 42
rng = np.random.default_rng(seed=SEED)

# 2. 查看生成器内核类型
print("当前使用的随机生成器:", type(rng))rng = np.random.default_rng()。创建生成器对象伴随一定的初始化开销,正确的做法是在模块级别或主流程开始处创建一次 rng 实例,并在后续批量生成中复用该实例。
二、常见分布的批量生成代码与示例
1. 批量生成标准均匀分布浮点数组 [0.0, 1.0)
rng.random(size) 是最基础的批量生成函数,用于生成在半开区间 [0.0, 1.0) 内均匀分布的浮点数组。参数 size 可以是单个整数(一维),也可以是由多个维度大小构成的元组(二维、三维乃至更高维)。
# 设定批次参数:批量大小为 5,每个样本包含 4 个特征
batch_size = 5
num_features = 4

# 一次性批量生成 (5, 4) 的二维浮点数组
uniform_batch = rng.random(size=(batch_size, num_features))

print("数组形状 (shape):", uniform_batch.shape)
print("数组数据类型 (dtype):", uniform_batch.dtype)
print("批量数组内容:
", uniform_batch)数组数据类型 (dtype): float64
批量数组内容:
[[0.77395605 0.43887844 0.85859792 0.69736803]
[0.09417735 0.97562235 0.7611397 0.78606431]
[0.12811363 0.45038594 0.37079802 0.92676499]
[0.64386512 0.82276161 0.4434142 0.22723872]
[0.55458479 0.06381726 0.82763117 0.6316644 ]]
若需要任意区间 [low, high) 内的均匀分布浮点数,直接调用 rng.uniform(low, high, size):
# 批量生成范围在 [-5.0, 5.0) 之间的 3x3 随机矩阵
custom_uniform = rng.uniform(low=-5.0, high=5.0, size=(3, 3))
print("区间 [-5.0, 5.0) 的批量矩阵:
", custom_uniform)
2. 批量生成正态(高斯)分布数组
正态分布是仿真真实世界噪声、物理测量误差及深度学习权重初值的核心分布。通过 rng.normal(loc, scale, size) 可以直接批量输出指定均值(loc, μ)和标准差(scale, σ)的高斯随机数组。
# 设定高斯分布参数:均值 0.0,标准差 1.5,批次形状为 (1000, 10)
mu, sigma = 0.0, 1.5
normal_batch = rng.normal(loc=mu, scale=sigma, size=(1000, 10))

print("正态批量数组形状:", normal_batch.shape)
print(f"统计检验 -> 样本均值: {normal_batch.mean():.4f}, 样本标准差: {normal_batch.std():.4f}")统计检验 -> 样本均值: -0.0031, 样本标准差: 1.4982
如输出所示,大批量生成的数组在统计指标上与设定的期望值高度吻合,体现了向量化随机数采样的稳定性。
3. 批量生成离散整数随机数组
在图像分类标签模拟、离散状态采样或掩码构造时,需批量生成离散整数。现代 API 使用 rng.integers(low, high, size, endpoint=False),它彻底取代了旧接口 np.random.randint()。
# 模拟一个批次大小为 8 的多分类任务真实标签(共 5 个类别,标签为 0, 1, 2, 3, 4)
labels_batch = rng.integers(low=0, high=5, size=8)
print("分类标签一维批次:", labels_batch)

# 生成包含上下界两端的闭区间 [1, 100] 的 (3, 4) 批次数组
closed_interval_batch = rng.integers(low=1, high=100, size=(3, 4), endpoint=True)
print("包含端点的整数二维批次:
", closed_interval_batch)包含端点的整数二维批次:
[[ 87 12 64 39]
[ 51 98 27 73]
[ 6 44 100 82]]
4. 批量有限集合抽样(支持权重与放回控制)
当候选值是非连续数字或离散集合时,使用 rng.choice(a, size, replace, p)。通过 replace=False 可以实现无放回抽样(如不重复打乱索引);通过 p 参数可以指定各个元素被抽中的概率分布。
candidates = np.array(['A', 'B', 'C', 'D'])
probabilities = [0.1, 0.6, 0.2, 0.1] # 各类别先验概率
# 按先验概率批量采样 10 个数据样本
sampled_batch = rng.choice(candidates, size=10, replace=True, p=probabilities)
print("加权随机抽样批次:", sampled_batch)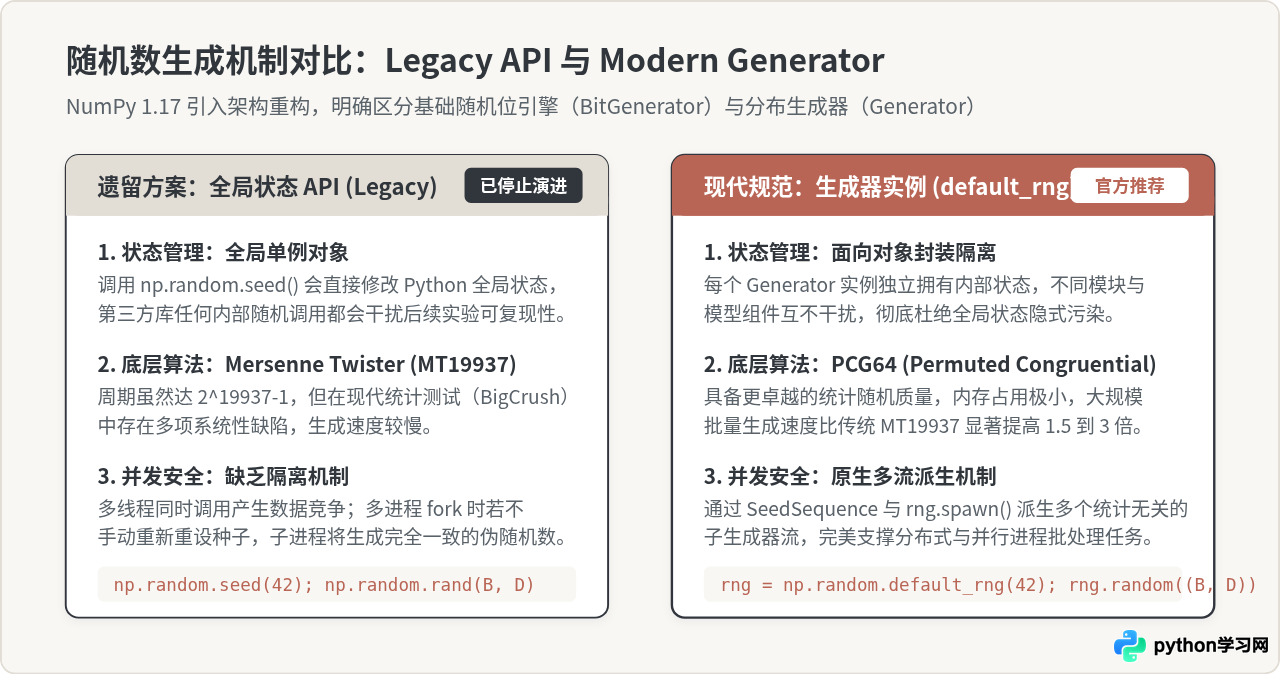 图 2:遗留全局 API 与现代 Generator 实例架构对比
三、高维张量批次构建与内存布局优化
在计算机视觉(CV)与自然语言处理(NLP)场景中,随机数组往往呈现为 3 维或 4 维张量。例如:
- 时序 / NLP 批次:形状为
(batch_size, sequence_length, embedding_dim) - 图像张量批次:形状为
(batch_size, channels, height, width)
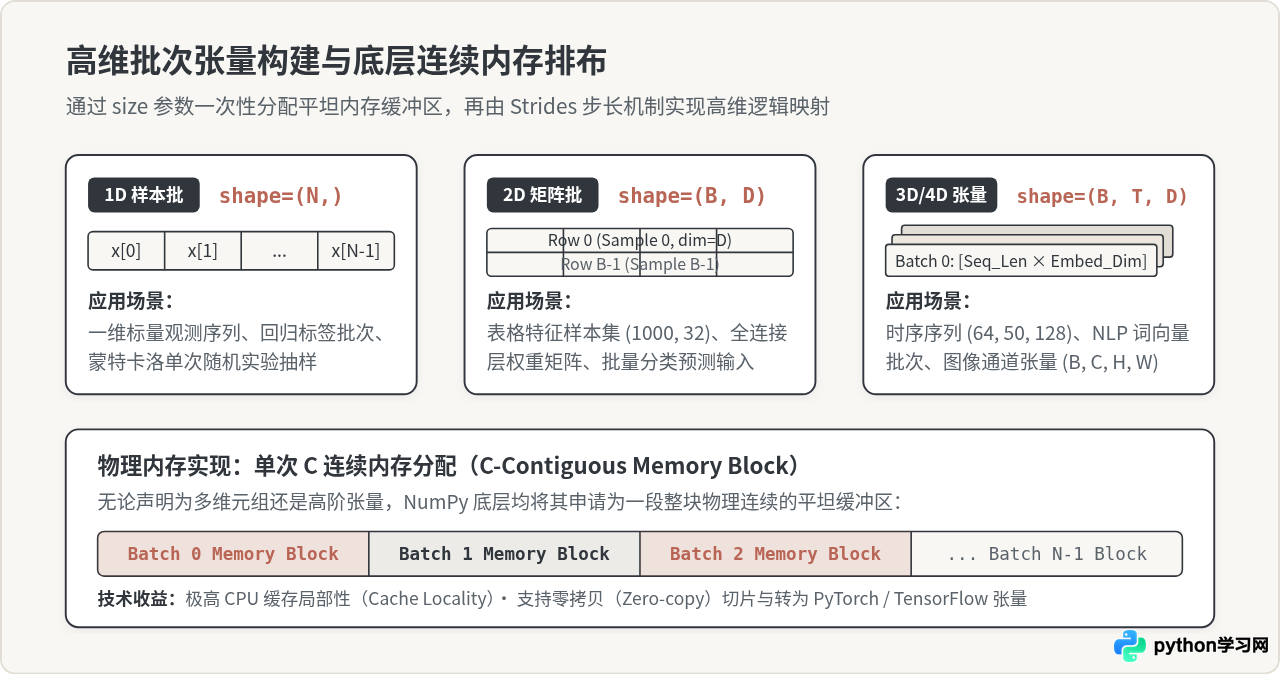 图 3:高维批次张量设计与底层物理内存连续布局原理
高维张量批次生成与数据类型精简的完整代码如下:
# 设定参数:批次大小 16,通道数 3,图像尺寸 32x32
batch_size = 16
channels = 3
height, width = 32, 32

# 一次性构建 4D 图像随机噪声批次,直接转换为 float32 节省内存
image_batch = rng.normal(loc=0.0, scale=1.0, size=(batch_size, channels, height, width)).astype(np.float32)

print("张量维度 (shape):", image_batch.shape)
print("元素总数 (size):", image_batch.size)
print("内存占用大小 (bytes):", image_batch.nbytes)
print("内存是否连续 (C_CONTIGUOUS):", image_batch.flags['C_CONTIGUOUS'])元素总数 (size): 49152
内存占用大小 (bytes): 196608 (约 192 KB)
内存是否连续 (C_CONTIGUOUS): True
对于大规模批次计算,NumPy 默认生成的 float64 占用 8 字节;使用 .astype(np.float32) 转换为单精度浮点数后,内存消耗直降 50%,且能直接对接 GPU 加速框架(如 PyTorch、TensorFlow 或 JAX),避免不必要的中间数据拷贝。
四、多进程与并发场景下的安全生成方案
在多进程并行数据加载(例如 DataLoader 的 num_workers > 0)中,若直接通过 fork 复制父进程的全局随机状态,多个工作进程会生成完全相同的“假随机”数据。现代 NumPy 通过 SeedSequence 与派生生成器彻底解决了这一问题。
from numpy.random import SeedSequence, default_rng

# 创建高熵种子序列
ss = SeedSequence(123456)

# 派生 4 个完全独立的子序列,分配给 4 个工作进程
child_seeds = ss.spawn(4)
worker_rngs = [default_rng(s) for s in child_seeds]

# 各工作进程独立批量生成,保证统计不相关
for worker_id, worker_rng in enumerate(worker_rngs):
    batch = worker_rng.integers(0, 100, size=3)
print(f"工作进程 {worker_id} 生成独立批次: {batch}")工作进程 1 生成独立批次: [13 55 62]
工作进程 2 生成独立批次: [49 82 3]
工作进程 3 生成独立批次: [90 31 47]
五、常用方法选型总结
在实际编码中,应根据数据类型、值域边界和分布特征精准选择生成函数。下表与图示总结了最常用的核心 API 决策依据:
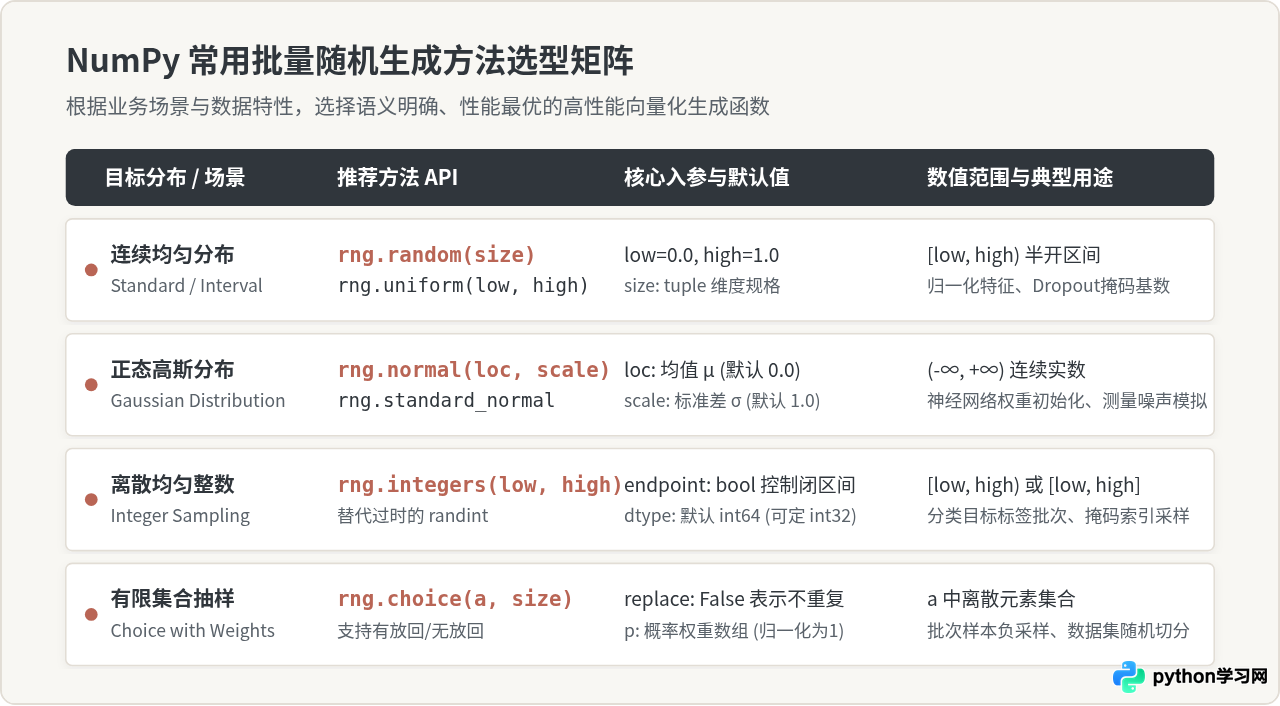 图 4:NumPy 常用批量随机生成方法决策选型与关键参数矩阵
| 方法与签名 | 支持数据分布 | 典型参数设置 | 常用业务场景 |
|---|---|---|---|
rng.random(size) |
标准连续均匀 [0.0, 1.0) | size=(B, D) |
特征初值归一化、随机丢弃率基数 |
rng.uniform(low, high, size) |
区间连续均匀 [low, high) | low=-1.0, high=1.0 |
物理参数模拟、超参数网格扰动 |
rng.normal(loc, scale, size) |
正态高斯分布 (-∞, +∞) | loc=0.0, scale=1.0 |
线性权重初始化、高斯白噪声注入 |
rng.integers(low, high, size) |
离散均匀整数 | endpoint=True/False |
离散类别标签、样本索引随机化 |
rng.choice(a, size, replace, p) |
有限集合加权采样 | replace=False (无放回) |
不重复样本抽取、负采样、分类混淆测试 |
掌握以上代码范式与 size 维度映射机制,能够帮助开发者在科学计算与工程建模中快速写出兼具可读性、高性能与高可靠性的随机数组生成代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















