


解决Python脚本运行时的中文乱码问题
针对Python脚本在执行过程中出现的源码语法报错、控制台终端打印问号、文件读写解码失败以及网络接口乱码等问题,提供由表及里的原因剖析、分步排查路径与标准解决方案。
一、为什么会出现中文乱码?核心原理快速弄懂
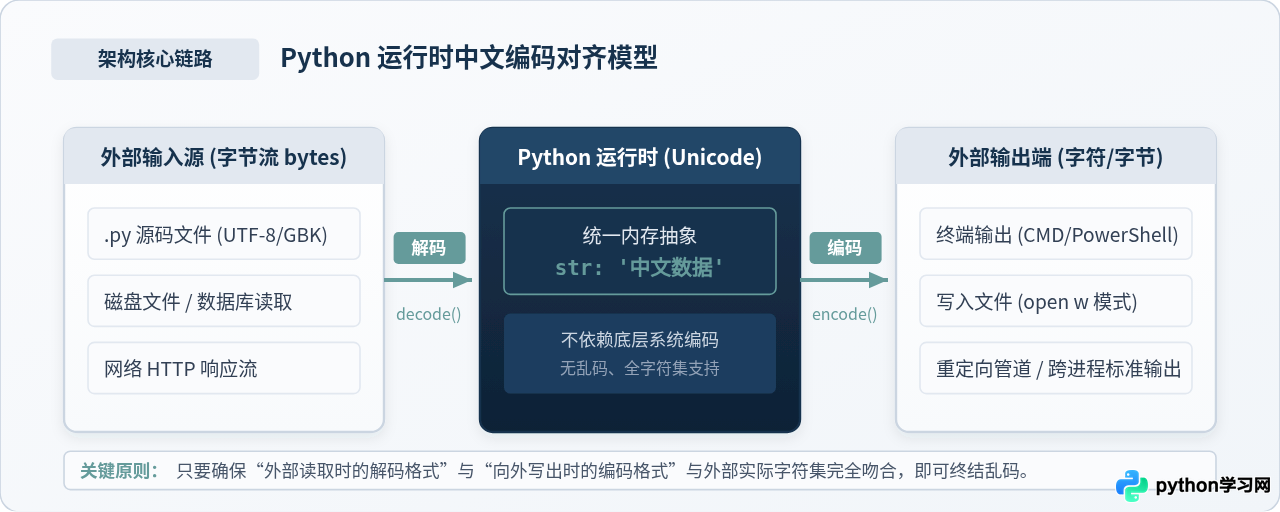
很多开发者在刚刚遇到中文乱码时,往往会尝试在代码中到处添加 encode('utf-8') 或 decode('gbk'),甚至把原本正确的字符串转换成一串难以理解的十六进制,结果问题反而更加复杂。要想彻底解决这个问题,必须先明确Python处理文本的基本机制。
计算机在磁盘、网络或管道中传输和保存数据时,永远只能处理由二进制字节构成的 bytes(字节序列)。而在Python 3程序内部,所有的文本变量(如 str)都是一种抽象的Unicode字符实体。也就是说,数据从外部进入Python程序,必须经过“解码”(decode);而Python程序把数据输出到外部世界时,必须经过“编码”(encode)。
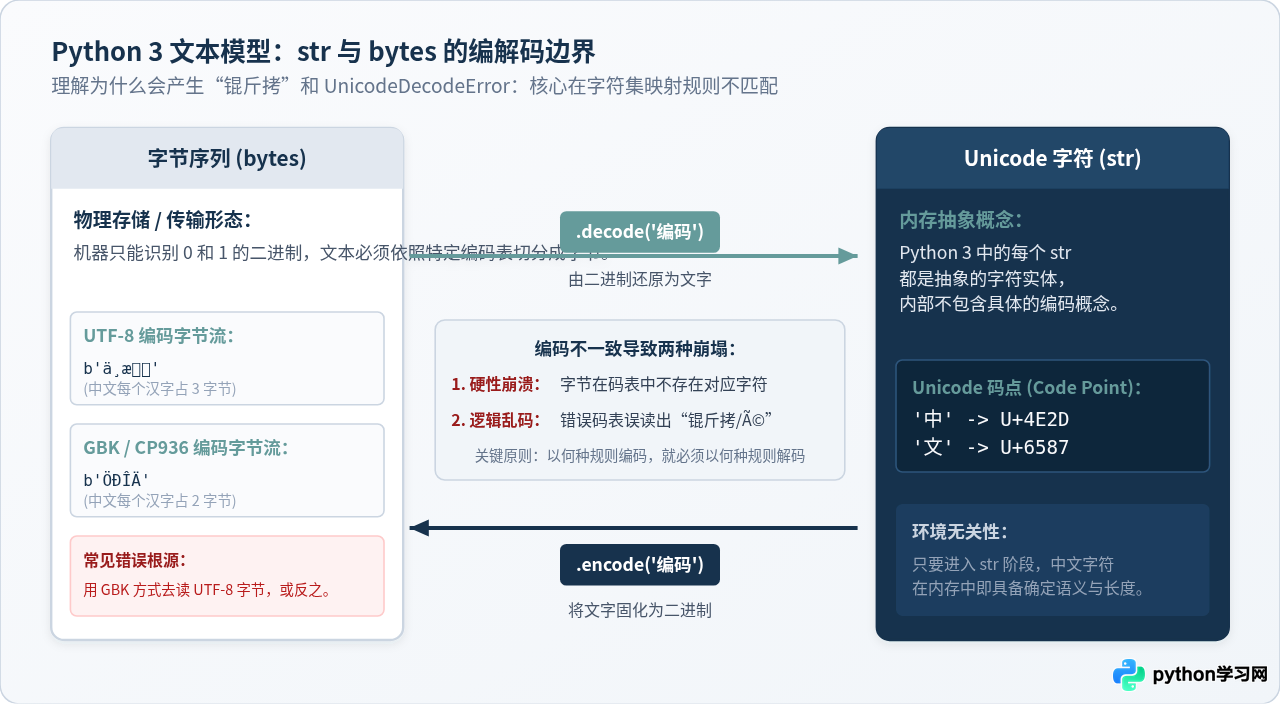
当外部数据采用 UTF-8 编码保存(中文通常占 3 个字节),而程序用 Windows 系统默认的 GBK 编码(中文占 2 个字节)去解释它时,对应的字节序列在 GBK 码表中找不到有效映射,就会抛出常见的 UnicodeDecodeError;如果恰好碰巧映射到了生僻字或者控制符号,屏幕上就会出现诸如“锟斤拷”、“é”之类的乱码。解决这一系列问题的原则非常简单:用什么规则编码,就必须用对应规则解码。
二、Python 脚本中文乱码排查四步法
当你的Python脚本在运行过程中出现乱码或编码报错时,不要盲目修改代码,建议按照下面的逻辑步骤逐层排查,迅速定位问题出在哪一个环节。
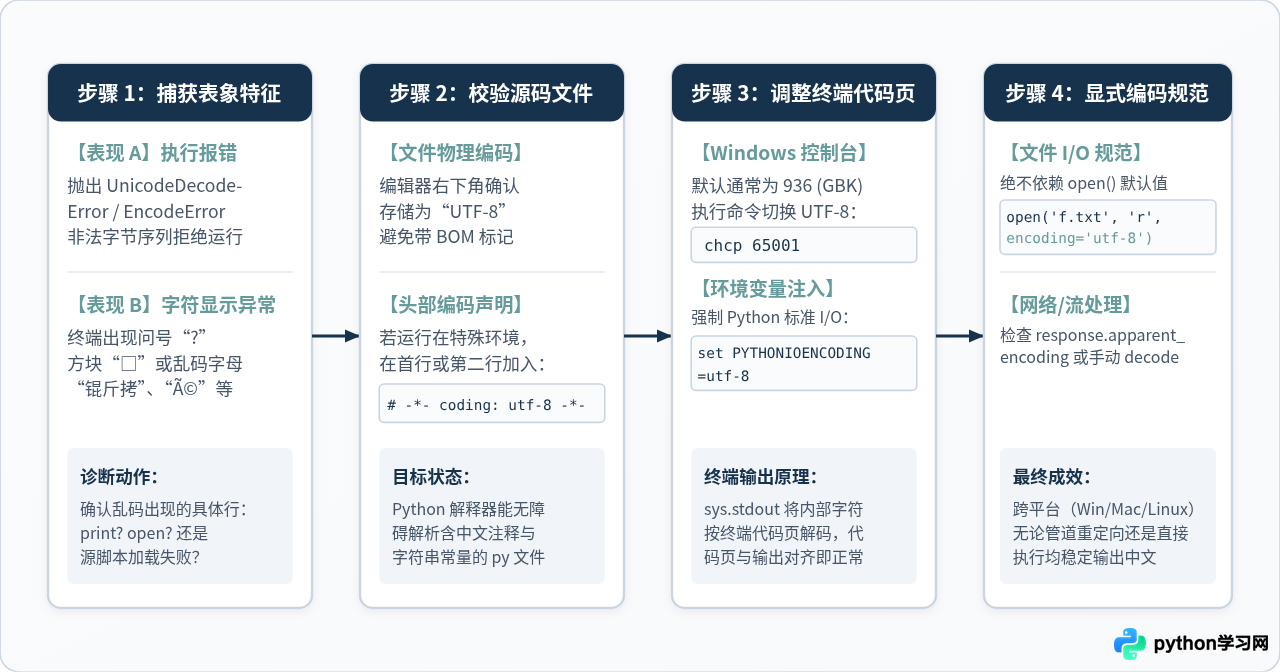
- 步骤一:捕获异常类型与表象特征 —— 确认是程序直接崩溃抛出
SyntaxError或UnicodeError,还是程序执行完毕但终端字符显示为问号或乱码。 - 步骤二:检查源码文件存储格式 —— 确认
.py脚本本身的保存编码是否为无 BOM 的 UTF-8。 - 步骤三:检查终端与运行环境代码页 —— 确认命令提示符(CMD)、PowerShell 或 IDE 内部终端的标准输出字符集设置。
- 步骤四:规范数据读写与接口调用 —— 检查外部文件打开操作和网络请求是否显式传入了正确的编码参数。
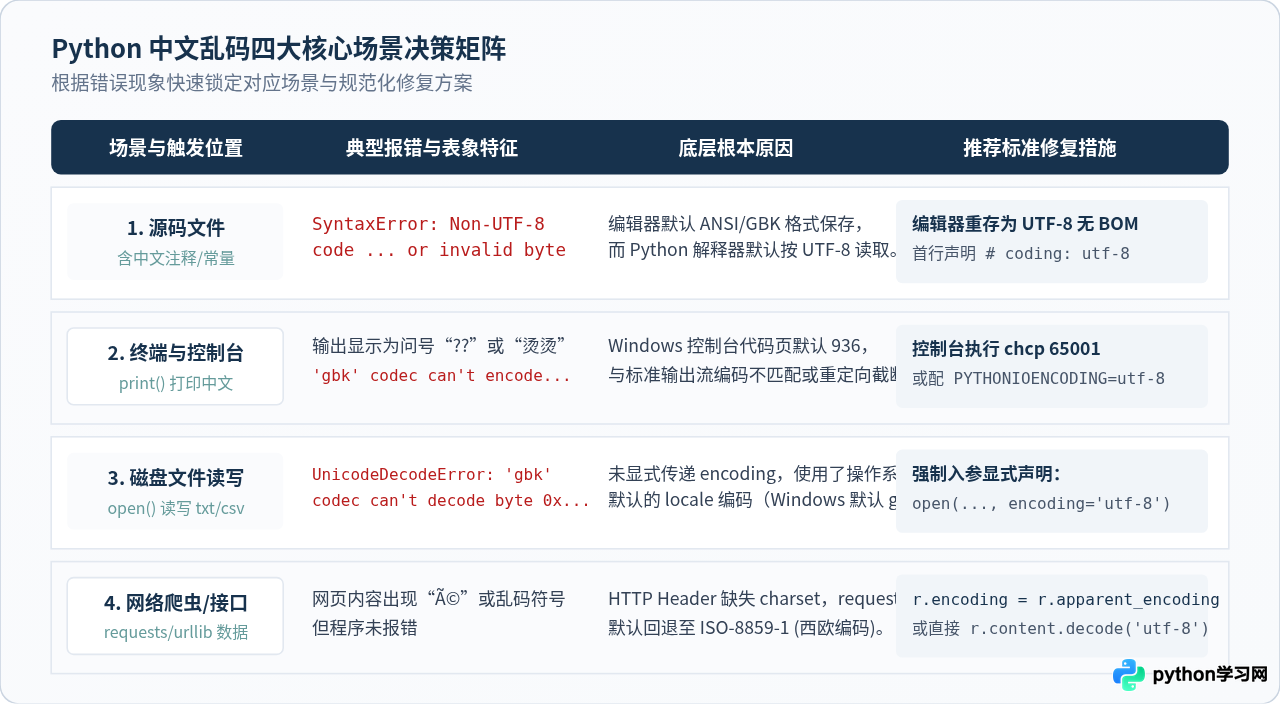
三、场景一:脚本源码本身包含中文时报错
在编写代码时,我们经常会在脚本中写入中文注释,或者定义包含中文的字符串常量。如果在运行脚本的第一步就直接报错中断,说明问题出在源文件本身的读取解析阶段。
典型表现
原因与具体解法
Python 3 默认假定源码文件采用 UTF-8 编码。如果使用某些特定的本地编辑器(如 Windows 早期记事本或配置了 GBK 的编辑器)保存了脚本,文件实际是以 ANSI/GBK 格式存放在磁盘上的。当 Python 解释器读到非 UTF-8 格式的中文汉字时,就会直接拒绝继续解析。
修复步骤:
- 在 VS Code、PyCharm 或 Sublime Text 等现代编辑器中,查看右下角的状态栏编码指示,若显示为“GBK”或“Windows 1252”,点击并选择“通过编码重新保存”(Save with Encoding),指定为 UTF-8。
- 若需要兼容较旧的运行环境或特定历史项目,可以在
.py文件的首行或第二行加入符合 PEP 263 标准的编码声明:
# -*- coding: utf-8 -*-
# 这是一个包含中文注释的脚本
greeting = "你好,世界!"
print(greeting) 有时会导致部分第三方解析工具或早期解释器报错。
四、场景二:终端控制台输出中文出现乱码或问号
在代码内部逻辑完全正确的情况下,执行 print("你好,世界") 屏幕上却显示为一连串问号 ??、方框 □,或者形如 'gbk' codec can't encode character 的异常。这种情况在 Windows 系统的 CMD 或 PowerShell 中尤为高发。
典型原因
在 Windows 操作系统中,中文简体版本的控制台默认活动代码页通常是 936(即 GBK/CP936 编码)。当 Python 准备将内存中的 Unicode 文本打印至屏幕时,它会尝试依据当前终端代码页将文本转换为字节流。若终端代码页与输出流期望不一致,或者通过管道(Pipe)重定向输出至文件时丢失了终端编码信息,就会导致乱码或编码转换失败。
具体修复操作
可以通过以下几种方式解决控制台输出环境的不匹配:
方法 1:临时切换控制台代码页为 UTF-8(65001)
在运行脚本之前,在 CMD 或 PowerShell 窗口中先执行以下命令:
chcp 65001
python test.py方法 2:设置全局环境变量强制 Python I/O 采用 UTF-8
在 Windows 命令行下运行命令(仅对当前窗口生效):
set PYTHONIOENCODING=utf-8
python test.py
在 Python 3.7+ 中,还可以启用官方推荐的 UTF-8 运行模式,该模式会强制将所有系统 I/O 默认编码重设为 UTF-8:
set PYTHONUTF8=1
python test.py
方法 3:在代码内动态重新配置标准输出流(针对特定重定向脚本)
若脚本经常作为后台服务运行或被其他程序重定向抓取,可以在脚本初始化时重新封装标准输出的编码:
import sys

# 针对 Python 3.7 及以上版本,使用 reconfigure 重新指定标准输出流编码
if hasattr(sys.stdout, 'reconfigure'):
    sys.stdout.reconfigure(encoding='utf-8')

print("【执行完成】所有输出流已稳定对齐为 UTF-8 编码")
五、场景三:本地文件读写时的中文乱码
使用 open() 函数读写包含中文的文本文档(如 .txt、.json、.csv)时,是开发者最常遭遇中文乱码的重灾区。很多初学者写出如下代码:
# 不推荐的写法:省略了 encoding 参数
with open("data.txt", "r") as f:
    content = f.read()
报错分析与原因
当 open() 函数没有显式传入 encoding 参数时,Python 会调用系统的 locale.getpreferredencoding() 来决定使用何种编码。在 Windows 操作系统上,默认通常是 GBK(CP936),而在 macOS 和大多数 Linux 发行版上则是 UTF-8。这意味着:一段没有指定 encoding 的文件读写代码,在 Mac 上能够正常运行,拿到 Windows 机器上读取 UTF-8 文件时就会立即崩溃。
标准规范代码
在进行任何文本文件读写时,永远显式传入 encoding="utf-8" 参数,彻底消除跨平台差异:
# 规范写入操作
data = "用户姓名:张三\n状态:已完成"
with open("report.txt", "w", encoding="utf-8") as f:
    f.write(data)

# 规范读取操作
with open("report.txt", "r", encoding="utf-8") as f:
    result = f.read()
print("读取内容示例:", result)encoding="utf-8-sig"(即带有 BOM 签名的 UTF-8),Excel 会据此自动以正确的编码渲染中文。
六、场景四:网络请求与外部数据接口乱码
在使用 requests 或 urllib 抓取中文网页或调用第三方接口时,有时返回的字典或文本中汉字被转义成了乱码,例如 å¼ ä¸ 或包含大量反斜杠十六进制字符。
典型原因与修复
在使用 requests.get() 获取网页时,response.text 属性依赖 response.encoding 来决定如何把返回的字节数组转换为文字。若目标服务器返回的 HTTP 响应头中只写了 Content-Type: text/html 而没有标明 charset=utf-8,requests 会依据 HTTP 规范将编码默认推测为 ISO-8859-1(拉丁西欧编码),汉字随即产生乱码。
正确的处理方案有两种:
import requests

url = "https://example.com/api/data"
res = requests.get(url)

# 方案 A:让 requests 借助 chardet 根据页面二进制流自动嗅探真实编码
res.encoding = res.apparent_encoding
print("修正后文本:", res.text)

# 方案 B(更推荐):若已知目标明确为 UTF-8,直接从原始字节流 decode
text_content = res.content.decode("utf-8", errors="replace")
print("安全解码文本:", text_content)decode() 函数的 errors 参数提供了容错机制:errors="replace" 会将无法识别的字节替换为占位字符(如 ),保证脚本不崩溃;errors="ignore" 则会直接跳过问题字节。在排查问题时建议保持默认的 errors="strict",以便及时暴露问题源头。
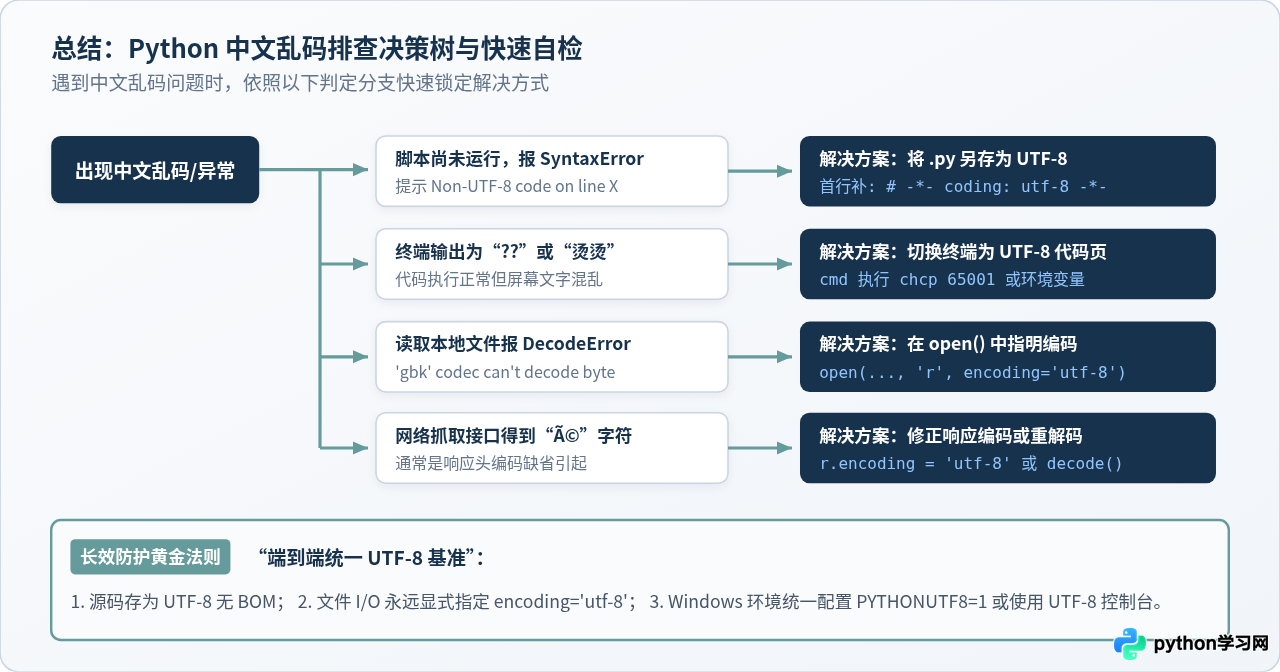
七、终极决策树与长效防错清单
为了在实际开发中不再反复被中文乱码困扰,可以将以下思维模型与排查清单沉淀到日常习惯中:
日常开发的“三不”原则
- 不使用默认编码:无论是
open()、subprocess.Popen()还是流重定向,绝不省略encoding参数。 - 不混淆数据类型:清楚区分哪些变量是
str(用来在逻辑中分析、计算、展现),哪些变量是bytes(用来传输、存储和散列校验),绝不对同一个变量做无意义的重复 encode/decode。 - 不忽视运行平台差异:在 Windows 开发环境下,务必将常用终端环境(CMD/PowerShell/Terminal)配置为 UTF-8(代码页 65001),并在工程中统一配置
PYTHONUTF8=1。
只要在数据入口处明确解码格式、在业务处理中统一保持 Unicode 实体、在数据写出端显式指定目标编码,Python 脚本运行时的中文乱码问题就能在源头上得到根本解决。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















