


Python IDE怎么选?PyCharm、VS Code与Jupyter对比
面对PyCharm、VS Code和Jupyter三大主流Python开发工具,开发者该如何选择?本文从底层架构、环境管理、运行机制、适用场景四个维度进行深度横向对比,并提供实际配置指南与明确的选型决策树。
一、三大工具的底层架构与核心设计哲学
在探讨功能优劣之前,必须先理清三者在软件工程形态上的根本不同。许多初学者感到选择困惑,正是因为把本质完全不同的“完整集成开发环境”、“可扩展代码编辑器”和“交互式文学化编程笔记本”放在了同一个维度进行粗暴比对。
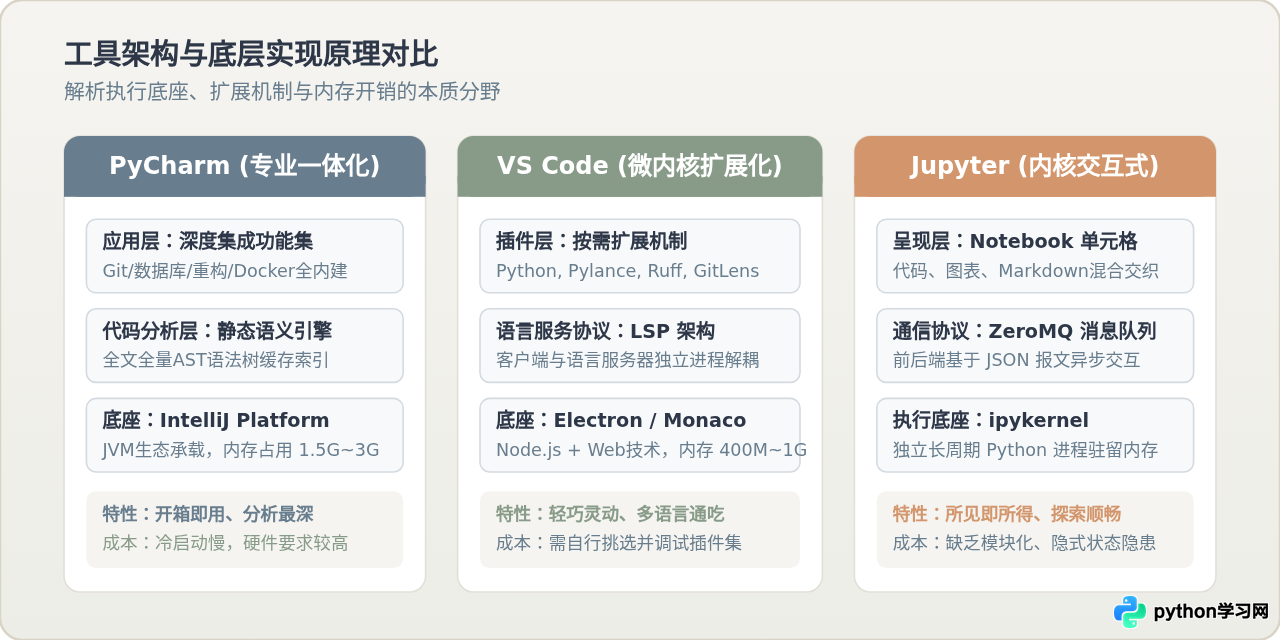
PyCharm 出自 JetBrains,属于典型的“开箱即用型(Batteries-Included)重型 IDE”。从底层看,它基于 Java 虚拟机与 IntelliJ 平台开发,启动时会对项目中的所有 Python 文件、系统库和依赖包进行全量语法树(AST)扫描与建立缓存索引。正因为拥有完整的代码拓扑图,PyCharm 可以在你敲下代码前就识别出深层类型错误、未声明变量以及循环引用风险。
Visual Studio Code(VS Code) 本质是一个基于 Electron 和 Monaco 编辑器核心的“轻量代码编辑器”。它的核心设计哲学是“微内核 + 插件生态”。微软只负责提供轻快的编辑外壳与语言服务协议(LSP),Python 的语法高亮、自动补全(Pylance)、调试支持(Python Debugger)乃至格式化规范,都是作为独立扩展按需运行在隔离进程中的。这种解耦架构保证了主界面轻快,但在初次使用时需要开发者自行挑选配置。
Jupyter(Notebook 与 JupyterLab) 源于 IPython 项目,它不是传统意义上的文件编辑器,而是一个“交互式计算环境”。它的架构分为两层:前端是运行在浏览器或编辑器内的交互界面,负责渲染文字、公式与富媒体输出;后端是常驻内存的 Python 解释器内核(ipykernel),两者通过 ZeroMQ 消息队列进行异步 JSON 通信。代码以“单元格(Cell)”为单位提交执行,运算产生的所有变量和对象都会常驻于内存之中,直到内核被显式重启。
二、核心维度深度横向对比
评估一款工具是否称手,关键在于它能否在你的核心工作流中消除摩擦。以下围绕代码智能辅助、依赖与虚拟环境管理、调试体验以及硬件消耗四个关键维度展开比对。
1. 代码智能提示与工程重构能力
在工程级代码维护中,重构(Refactoring)是检验工具专业度的试金石。当你在拥有数十个包、上百个文件的项目中重命名一个核心类方法时:
- PyCharm:能够根据动态继承链和作用域精准区分同名方法,自动同步修改所有调用点、导入声明乃至文档字符串,几乎不会产生误伤。
- VS Code:依赖 Pylance 语言服务器,在安装了静态类型提示(Type Hints)的代码库中表现优异,但在超大型无类型标注的复杂动态 Python 库中,全局符号跳转和跨模块重构有时会出现遗漏。
- Jupyter:主要服务于当前 Notebook 内部的单文件逻辑,跨文件符号索引和重构能力较弱,不适合用来重构大型包结构。
2. 运行模型与调试(Debug)机制的本质分野
代码运行机制直接决定了排查 Bug 的方式。很多从数据科学转向工程开发的人,常常会因为调试习惯的冲突而感到不适。
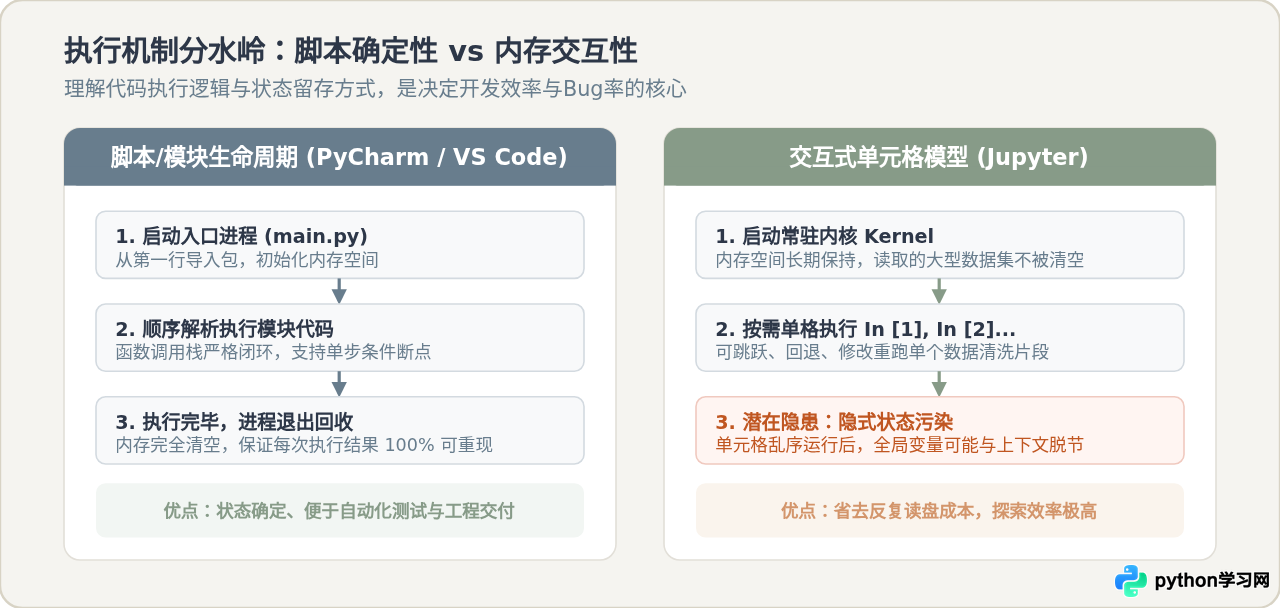
传统脚本执行(PyCharm 与 VS Code 的标准模式)遵循严谨的生命周期:从 python main.py 开始,逐行加载、逐层入栈,运行结束即彻底销毁内存。这种机制保证了状态的确定性——只要代码不变、输入数据相同,运行结果就 100% 可重现。开发者通过在代码行打上红点断点,在运行时单步步入(Step Over / Step Into),实时观察调用栈与局部变量。
而 Jupyter 采用的是内存常驻的单元格交互模型。其最大优势是避免了重复读盘与重复计算:例如加载一个 2GB 的 CSV 文件或初始化一个复杂的深度学习模型,只需要在第一个单元格执行一次,耗时 30 秒,随后的所有数据清洗、绘图、调参都可以直接复用内存中的对象,秒级得到反馈。然而,这种模型的暗礁在于隐式状态污染:如果用户跳跃执行单元格,或者修改了前面的代码却未重新执行后续单元格,内存中的变量可能已经与屏幕上可见的代码完全脱节,造成“无法复现的诡异 Bug”。
3. 资源开销与启动性能
| 对比维度 | PyCharm (Community / Pro) | Visual Studio Code | Jupyter (Notebook / Lab) |
|---|---|---|---|
| 底层技术栈 | Java (IntelliJ Platform) | TypeScript (Electron / Node.js) | Python + Web (ZeroMQ / Tornado) |
| 空载常驻内存 | 约 1.2 GB ~ 2.5 GB | 约 350 MB ~ 800 MB | 约 150 MB (服务端) + 内核消耗 |
| 冷启动速度 | 较慢(需载入JVM与扫描索引) | 极快(毫秒级展开编辑器) | 极快(浏览器直接访问) |
| 远程与容器开发 | Pro 版支持良好(社区版受限) | Remote-SSH / Dev Containers 天花板 | 原生支持远程挂载与分布式部署 |
| 商业授权模式 | 社区版免费开源 / 专业版订阅收费 | 完全免费开源 (MIT) | 完全免费开源 (BSD) |
三、真实工作流实操:虚拟环境与解释器配置规范
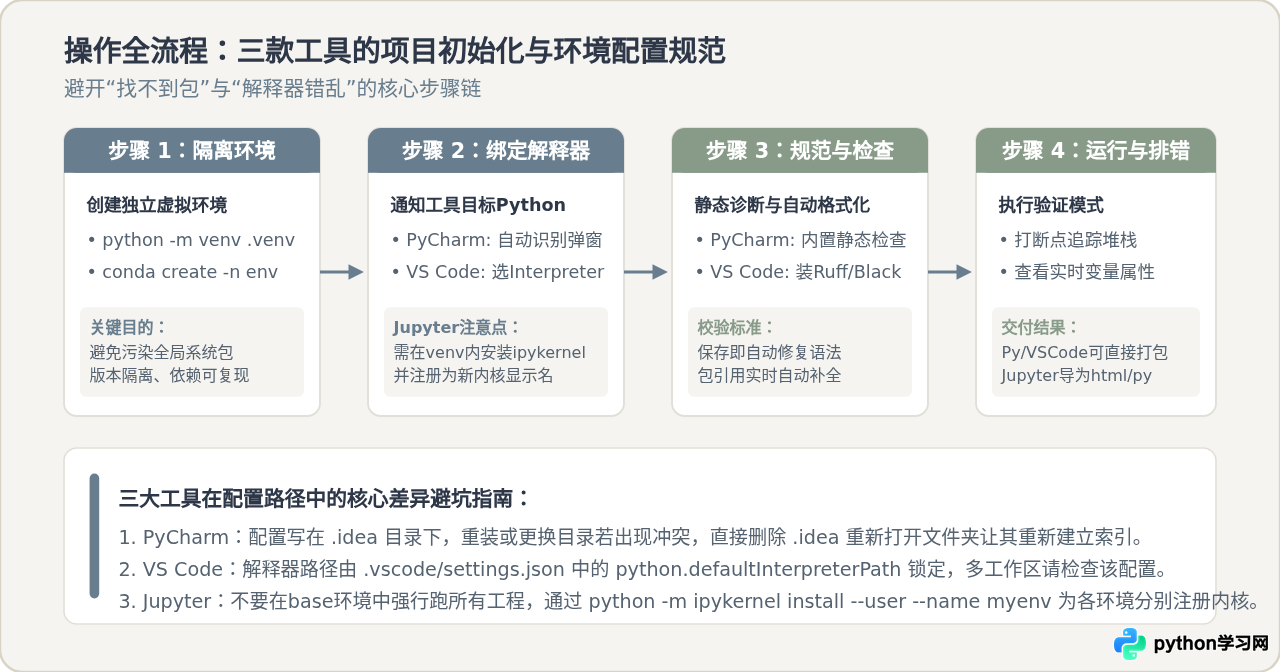
无论选择哪款工具,Python 新手最常踩到的坑就是“在命令行里 pip install 安装了依赖,但在编辑器里却提示 ModuleNotFoundError”。要彻底根治这个问题,必须理解如何在各自工具中正确绑定虚拟环境。
步骤 1:在项目根目录下创建标准虚拟环境
在操作系统的终端中进入你的项目目录,使用 Python 内置模块创建独立的虚拟环境目录:
# 进入工程根目录
cd my_project

# 创建名为 .venv 的虚拟环境目录
python3 -m venv .venv

# 激活环境并更新基础打包工具
source .venv/bin/activate      # Linux / macOS
# 或者 Windows 下执行: .venv\Scriptsctivate

pip install --upgrade pip
步骤 2:在各工具中绑定对应的解释器路径
创建好虚拟环境后,各工具的识别方式存在明确的差异:
- PyCharm 的操作:
打开项目文件夹时,PyCharm 通常会自动探测到项目根目录下的
.venv并弹出提示询问是否将其设置为项目解释器。如果未弹出,可进入Preferences (Settings) -> Project -> Python Interpreter,点击Add Interpreter -> Add Local Interpreter,选择Existing,定位到项目内的.venv/bin/python(Windows 为.venv\Scripts\python.exe)即可完成全自动化符号构建。 - VS Code 的操作:
使用快捷键
Ctrl+Shift+P(macOS 为Cmd+Shift+P)调出命令面板,输入并选择Python: Select Interpreter。VS Code 会扫描出当前工作区内的.venv,点击选中后,底部状态栏会显示当前生效的环境名称。同时,VS Code 会在项目根目录生成.vscode/settings.json记录此选择。 - Jupyter 的操作:
Jupyter 并不会自动穿透并识别任意目录下的独立虚拟环境。如果你想在 Notebook 中使用这个特定环境,必须在该环境内安装内核注册组件:
刷新 Jupyter 界面后,在右上角的# 确保在已激活的虚拟环境下执行 pip install ipykernel # 为当前环境向全局 Jupyter 注册一个专属内核名称 python -m ipykernel install --user --name=my_project_env --display-name="Python (my_project)"Kernel -> Change Kernel列表中即可选择刚绑定的项目独立内核。
conda install 上百个包。随着依赖增多,极易出现包冲突(Dependency Hell)导致环境整体瘫痪。务必坚持“一个项目一个独立虚拟环境”的原则。
四、选型决策指南与落地建议
选择工具时,应当从“你当前最需要解决的核心矛盾”出发,而不是盲目追求“功能最多”或“体积最轻”。结合团队协作形态与日常研发任务,以下是一套经过实战检验的决策路径:
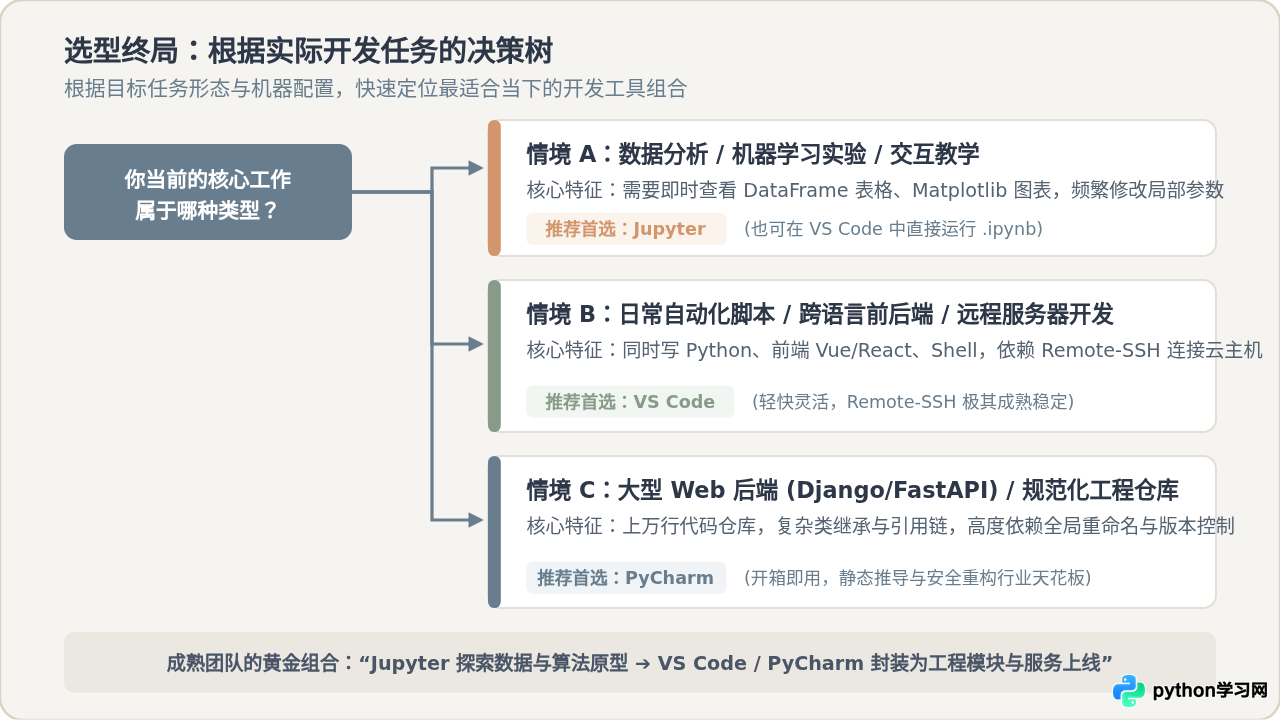
1. 选 PyCharm 的典型画像
- 项目类型:中大型后端服务(Django、FastAPI、Flask 企业项目)、微服务集群、大型自动化测试套件。
- 开发痛点:代码结构复杂,需要频繁跳转接口实现、自动重构重命名、检查死代码和变量类型隐患。
- 开发团队:团队统一使用 Python 技术栈,追求“开箱即用”,希望新员工 clone 代码后无需繁琐折腾插件即可获得一致的代码审查与调试环境。
- 硬件配置:开发机内存建议在 16GB 或以上,CPU 性能充裕。
2. 选 VS Code 的典型画像
- 项目类型:日常自动化脚本、全栈开发(Python 后端 + Vue/React 前端)、跨语言混合项目(如 Python + C++ 扩展、Python + Rust)。
- 开发痛点:需要频繁通过 Remote-SSH 连接远程云服务器、AWS EC2 或 Docker 容器进行开发;机器内存有限(如 8GB 笔记本),希望工具随开随关,不占后台。
- 开发风格:喜欢极简界面,乐于根据个人编码习惯挑选 Ruff(极速代码检查)、Black(格式化)、GitLens(版本追踪)等组合。
3. 选 Jupyter 的典型画像
- 项目类型:探索性数据分析(EDA)、量化金融研究、深度学习模型调优、学术论文实验复现、教学课件编写。
- 开发痛点:数据处理链路长,不希望每次改一行代码就重新从数据库读几千万行数据;需要直接将 Pandas 数据帧(DataFrame)和可视化图表内嵌在代码行下方展示给团队审阅。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















