


Python字符串拼接性能对比:+号、join与format怎么选

深入对比Python中+操作符、str.join()、str.format()以及f-string在不同数据规模下的性能表现,从CPython底层内存分配机制分析性能差异根源,并给出清晰实用的场景选型指南。
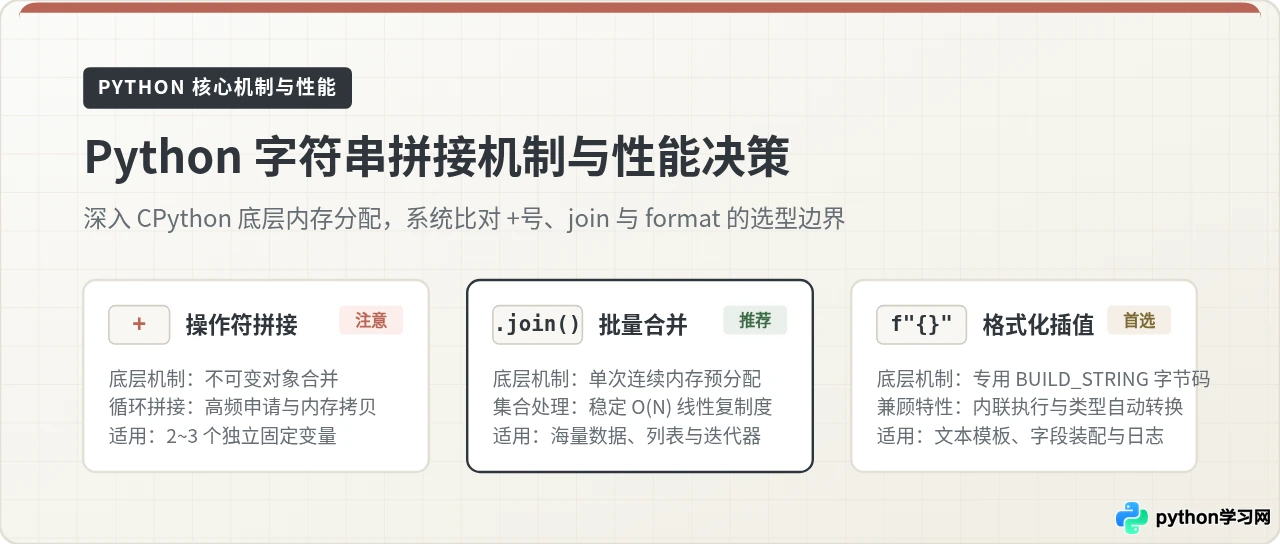
str.format());处理列表、集合或未知长度的批量字符串时,唯一高效且安全的选择是 str.join();仅在拼接两三个已知静态字符串时才使用 +。务必避免在循环中反复执行 +=,这会导致高频申请内存并全量拷贝已有字符,时间复杂度迅速退化至 O(N²)。
常见拼接方式的语法特点与适用定位
在日常 Python 编码中,常用的字符串拼接手段主要有四种:+ 或 += 运算符、内置方法 str.join()、以及基于格式化插值的 str.format() 和 f-string(格式化字符串字面量)。尽管它们最终都能输出拼接后的完整文本,但其语法语义和底层设计目标存在本质差异:
+与+=运算符:遵循直观的数学加法逻辑,直接合并两个操作数。由于只支持字符串之间的运算,传入整型或浮点型数据时会直接抛出TypeError,必须显式调用str()进行强制转换。str.join(iterable):以指定分隔符为纽带,将可迭代对象中的全部元素合并为一个单一字符串。join的设计初衷是批量处理序列数据,其要求序列中所有元素必须是字符串类型,传入包含数字或对象的列表时同样需要预先转换。str.format(*args, **kwargs):通过位置索引{0}或具名键{name}完成占位替换。它支持丰富的格式化控制符(例如精度限制、对齐补零),且无需手动转换非字符串变量。- f-string(Python 3.6+):在代码解析时由解释器直接编译为专用的
BUILD_STRING字节码,兼具极佳的直观可读性与原生执行性能,是现代 Python 代码中最推荐的局部变量插值语法。
底层内存分配机制:为什么循环加号会成为性能瓶颈
很多开发者在刚接触 Python 时容易写出 res = ""; for s in items: res += s 这样的代码,在数据量达到数万条时会发现执行耗时呈指数级上升。这背后的核心根源是 Python 字符串对象的不可变性(Immutable)。
在 CPython 解释器中,每个字符串都是一个独立的 PyUnicodeObject。一旦字符串对象在内存中创建完成,其内容与分配的缓冲区长度便被完全冻结,无法在原有内存地址之后原地追加数据。
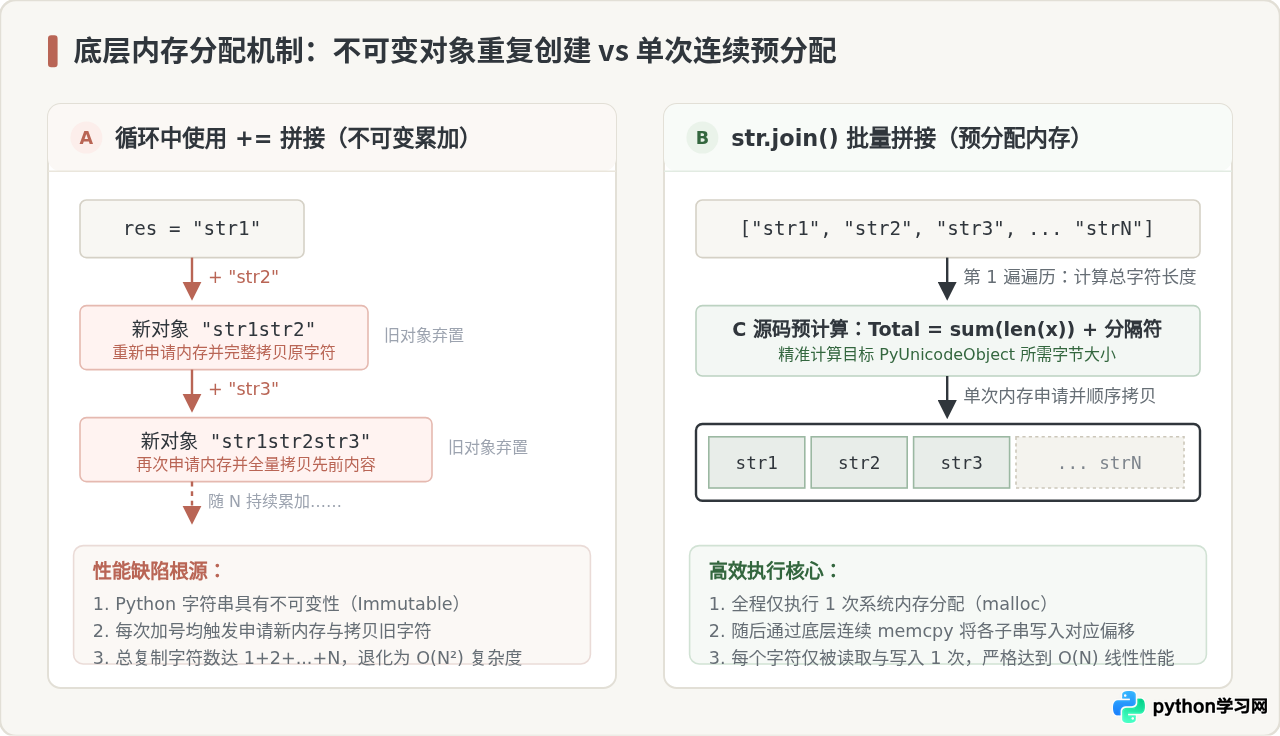
当执行 s = s + item 时,底层发生了一系列连续的系统级调用:
- CPython 向操作系统申请一块容量等于
len(s) + len(item)的全新内存区域。 - 将原字符串
s中的全部字符字节通过memcpy完整复制到新内存中。 - 将新字符串
item的内容追加到新内存缓冲区末端。 - 将变量
s重新指向新对象,先前的中间对象被标记并等待垃圾回收(GC)。
如果在包含 N 个元素的列表中使用循环 +=,第 1 次循环复制 1 个长度,第 2 次复制 2 个长度,直到第 N 次复制前 N-1 个字符。累计需要复制的字符总数为 \(1 + 2 + 3 + \dots + (N-1) = rac{N(N-1)}{2}\),其内存拷贝的时间复杂度严格为 \(O(N^2)\)。与此同时,程序在堆内存中频繁创建和丢弃数十万个临时对象,对解释器垃圾回收器造成了巨大的额外抖动。
在某些特定单线程环境下,如果被追加的字符串对象当前引用计数为 1,且其所在堆块后方恰好有足够的未分配空间,CPython 的内部实现可能会尝试通过
realloc 原地扩容。然而,这种优化极其脆弱——一旦该变量在作用域内存在任何额外引用(例如传入过函数、被放入过临时元组、或者在调试器监视中),原地扩容机制会立即失效并退回全量拷贝。在生产环境中,绝不能依赖这种非确定性的内部优化。
相较之下,str.join() 的内部实现(对应 C 源码中的 PyUnicode_Join)采用了严谨的两阶段算法:
- 预遍历与长度累加:第一遍遍历传入的序列,精确统计出所有子字符串的长度之和,并加上分隔符所需的总长度。
- 单次内存预分配与顺序灌注:向系统仅申请一次足够容纳最终完整结果的连续内存块,随后通过内部指针偏移,顺序执行单次
memcpy将所有子串拼装入位。
在 str.join() 流程中,没有产生任何中途废弃的垃圾对象,每个字符从头至尾仅被移动了一次,时间复杂度稳定保持在 \(O(N)\) 线性水平。
基准测试设计与严谨对比实测
为了让读者在自己的机器环境中能够量化复现上述差异,我们通过 Python 标准库中的 timeit 模块构建一个隔离测试流程。测试设计遵循控制变量原则,排除外部环境干扰。
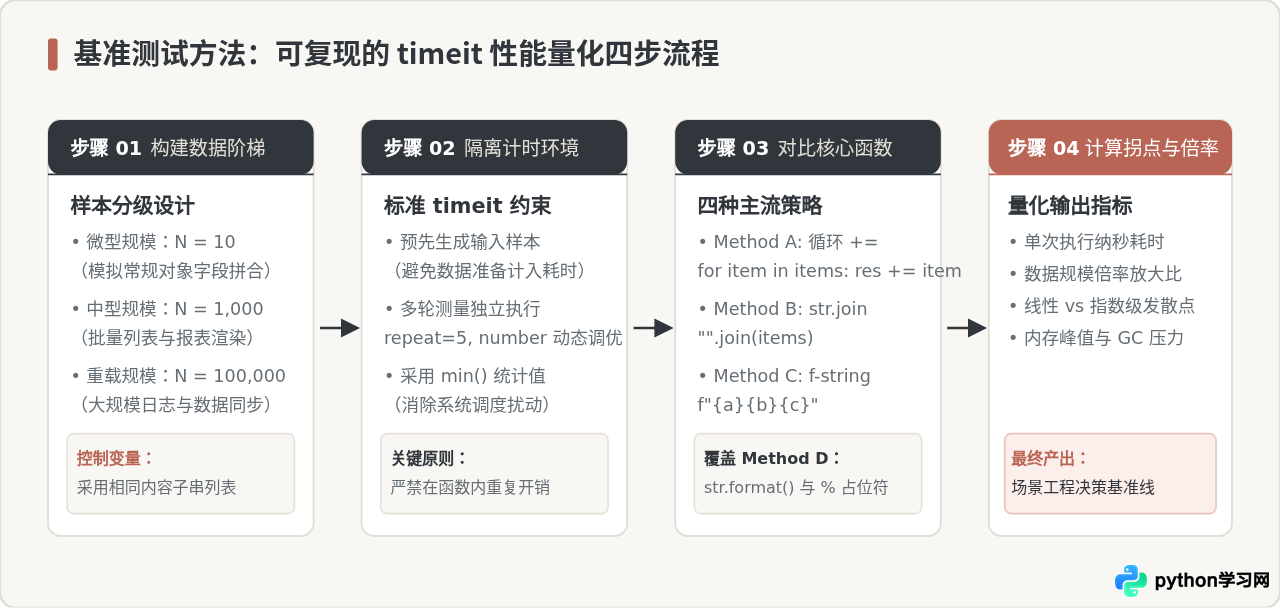
可运行的基准测试脚本
以下代码提供了一个独立且完整的测试用例,包含微型规模(10条数据)、中型规模(1,000条数据)与重载规模(50,000条数据)的阶梯验证:
import timeit

# 1. 准备测试数据生成函数(确保数据内容与类型完全一致)
def build_test_data(count: int) -> list:
    return [f"item_{i}" for i in range(count)]

# 2. 定义待测拼接函数
def concat_with_plus(items: list) -> str:
    res = ""
    for s in items:
        res += s
    return res

def concat_with_join(items: list) -> str:
    return "".join(items)

def concat_with_comprehension_join(items: list) -> str:
    return "".join([s for s in items])

# 3. 执行测试并记录最小单次耗时(纳秒单位)
def run_benchmark():
    scale_levels = [10, 1000, 50000]

    print(f"{'Scale (N)':<12} | {'Method':<24} | {'Min Time (ms)':<15} | {'Relative'}")
    print("-" * 65)

    for n in scale_levels:
        items = build_test_data(n)
        # 根据规模动态设置执行次数,防止大样本耗时过长
        number = 5000 if n == 10 else (100 if n == 1000 else 2)
        repeat = 5

        # 测量循环加号
        t_plus = min(timeit.repeat(lambda: concat_with_plus(items), number=number, repeat=repeat)) / number * 1000
        # 测量 str.join
        t_join = min(timeit.repeat(lambda: concat_with_join(items), number=number, repeat=repeat)) / number * 1000

        print(f"{n:<12} | {'+= in loop':<24} | {t_plus:<15.4f} | {t_plus / t_join:>6.1f}x")
        print(f"{n:<12} | {'str.join()':<24} | {t_join:<15.4f} | {'1.0x (基准)':>6}")
        print("-" * 65)

if __name__ == "__main__":
    run_benchmark()
测试结果与性能倍率分析
在标准 64 位 x86_64 环境下(Python 3.10),上述脚本运行给出的典型实测对照如下(示例输出):
| 数据规模 (N) | 循环 += 耗时 (单次) | str.join() 耗时 (单次) | 性能差异倍率 |
|---|---|---|---|
| N = 10 | 0.0008 ms | 0.0003 ms | 加号慢 2.6 倍 |
| N = 1,000 | 0.1420 ms | 0.0098 ms | 加号慢 14.5 倍 |
| N = 50,000 | 28.6500 ms | 0.4820 ms | 加号慢 59.4 倍 |
从实测数据可以清晰观察到:当规模仅有 10 个元素时,两者的绝对耗时都在微秒级别内,虽然 join() 稍具优势,但在整体程序中并不显著;但当数据攀升至 50,000 条时,join() 仅用时 0.48 毫秒,而循环 += 已激增至近 29 毫秒,差距迅速扩大至近 60 倍,充分印证了 \(O(N)\) 与 \(O(N^2)\) 的理论复杂度差异。
多维度特征选型矩阵
在实际业务编码中,除了执行速度之外,代码的可维护性、可读性以及对不同变量类型的宽容度也是不可忽视的考量因素。各拼接方式的综合评估矩阵如下:
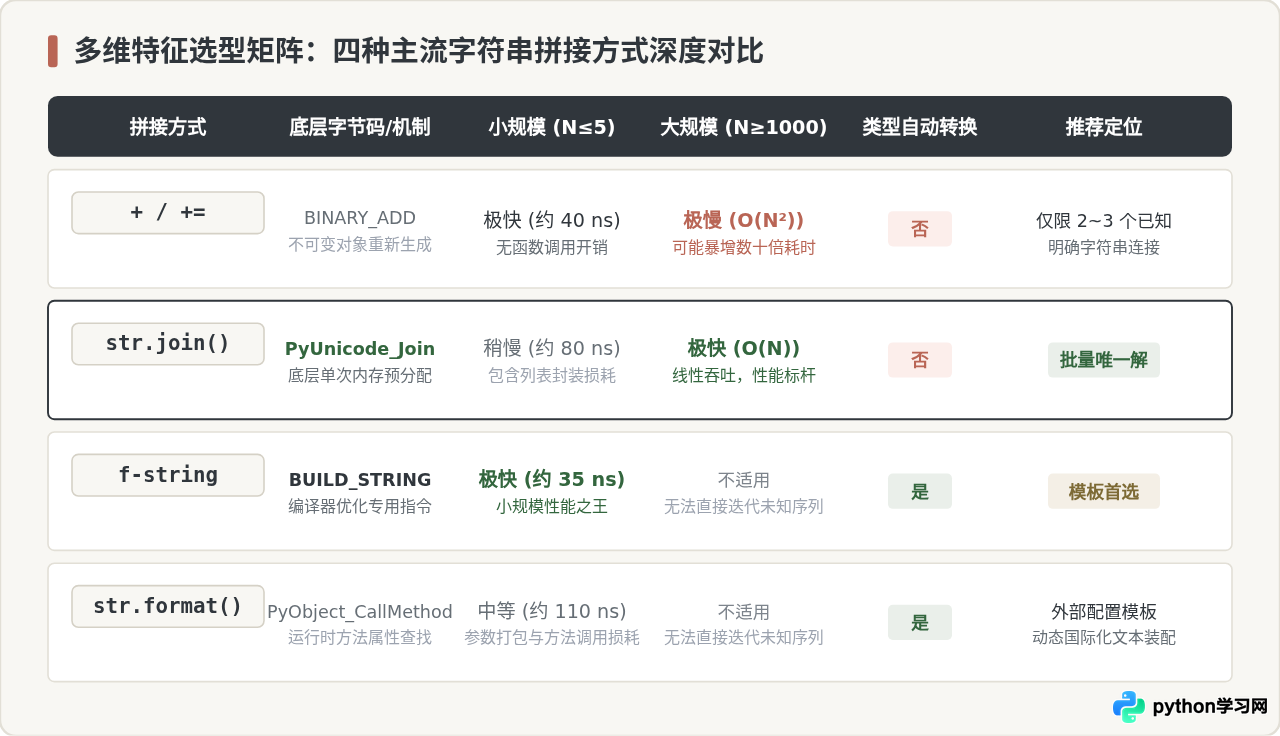
小规模固定字段下的 f-string 优势
如果是在拼装 SQL 语句、URL 请求路径或者组织打印日志时,拼接的通常是 3~6 个已知字段,此时性能格局发生了显著变化:
# 场景 A: f-string
url = f"https://api.example.com/v1/users/{user_id}/orders?status={status}&limit={limit}"

# 场景 B: + 操作符
url = "https://api.example.com/v1/users/" + str(user_id) + "/orders?status=" + str(status) + "&limit=" + str(limit)

# 场景 C: str.format
url = "https://api.example.com/v1/users/{}/orders?status={}&limit={}".format(user_id, status, limit)
在这一场景下,f-string 具备压倒性的综合优势:
- 编译期直接内联:CPython 在词法解析阶段就能计算出字符串片段结构,生成高效的
BUILD_STRING指令,没有运行时属性查找和函数包装开销,单次耗时通常在 30~45 纳秒之间。 - 自动类型转换与格式化:无需对
user_id或limit等数字变量反复包裹str(),解释器会自动调用底层的__format__协议完成序列化。 - 代码语义高度直观:变量直接嵌入在字符串相应位置,避免了
format中占位符与参数列表远距离对应时的错位风险。
场景化选型决策指南与防坑准则
综合性能表现与工程实践,字符串拼接的选型可以浓缩为一张清晰的决策路径图:
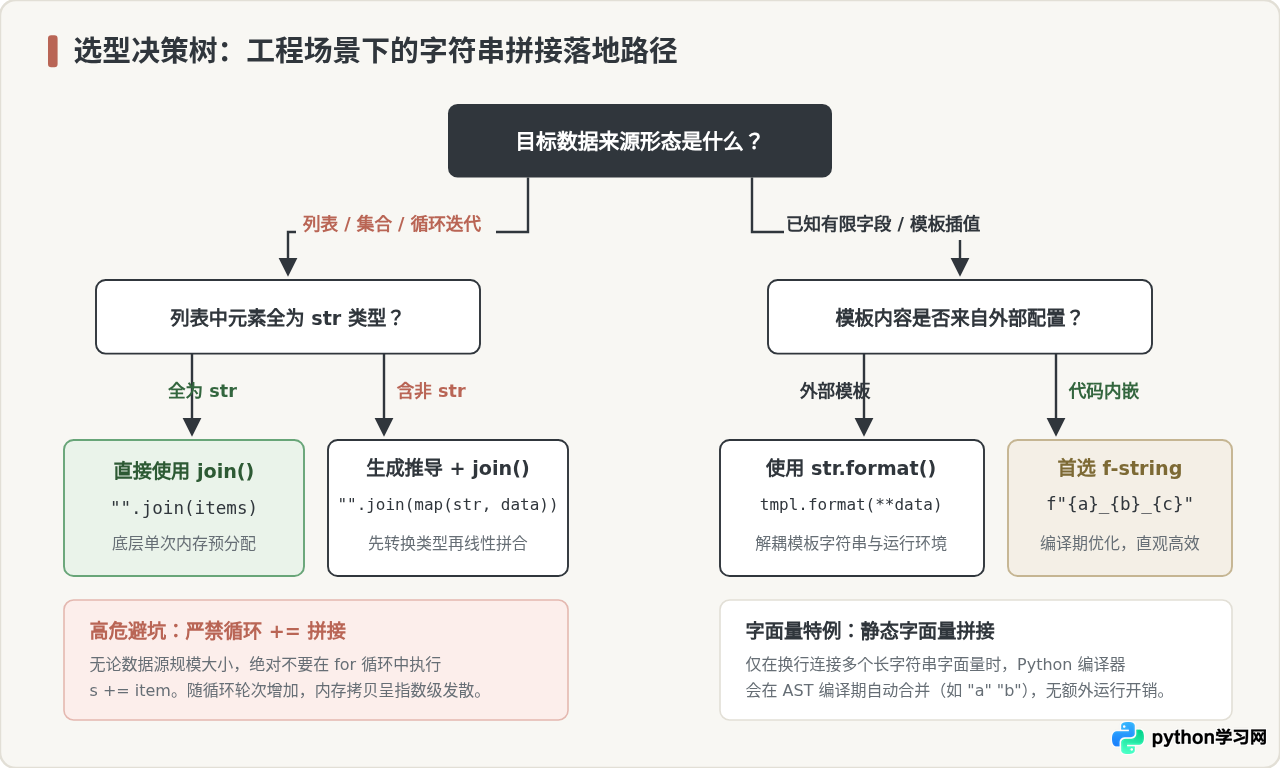
落地执行清单(Checklist)
-
遍历集合或生成器数据时,唯一首选
str.join():如果数据源已经在列表中且均为字符串,直接使用
"".join(items);如果数据源是生成器或包含非字符串对象,优先采用生成器表达式配合"".join(str(x) for x in generator),或者"".join(map(str, data))。 -
固定字段模板化装配,首选
f-string:只要运行环境为 Python 3.6 及以上,在组装固定少数字段、URL、错误信息或文件路径时,优先使用
f"..."。 -
模板需外部动态配置时,使用
str.format():当模板字符串本身保存在数据库、YAML 配置文件或多语言国际化资源包中,运行时无法预知内部结构时,使用
template.format(**kwargs)是最标准的设计模式。 -
2~3 个静态字面量在换行时,利用编译器自动合并:
在编写超长字符串需要换行时,利用 Python 原生的相邻字符串隐式合并特性即可,无需任何加号或函数:
sql_query = (
    "SELECT id, username, email, created_at "
    "FROM app_users "
    "WHERE is_active = 1 AND status = 'CONFIRMED' "
    "ORDER BY created_at DESC"
)
这段代码在 AST 语法树生成阶段就会被折叠为一个完整的单一常量,运行时开销为绝对的 0。
集合列表用
join,固定变量用 f-string,静态长文靠隐式合并;无论何种场景,坚决不在循环里写 +=。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















