


Python怎么同时遍历字典的键和值并打印
详细讲解在Python中如何使用dict.items()和元组解包同时遍历字典的键和值并格式化打印,深入解析底层视图机制、格式化排版技巧、常见报错RuntimeError与避坑指南。
items() 方法,并结合 for 循环进行元组解包:for key, value in my_dict.items(): print(f"{key}: {value}")。该方法单次扫描字典内部结构即可同时取出成对的键与值,既避免了重复查表的性能损耗,又保持了语法的高可读性。
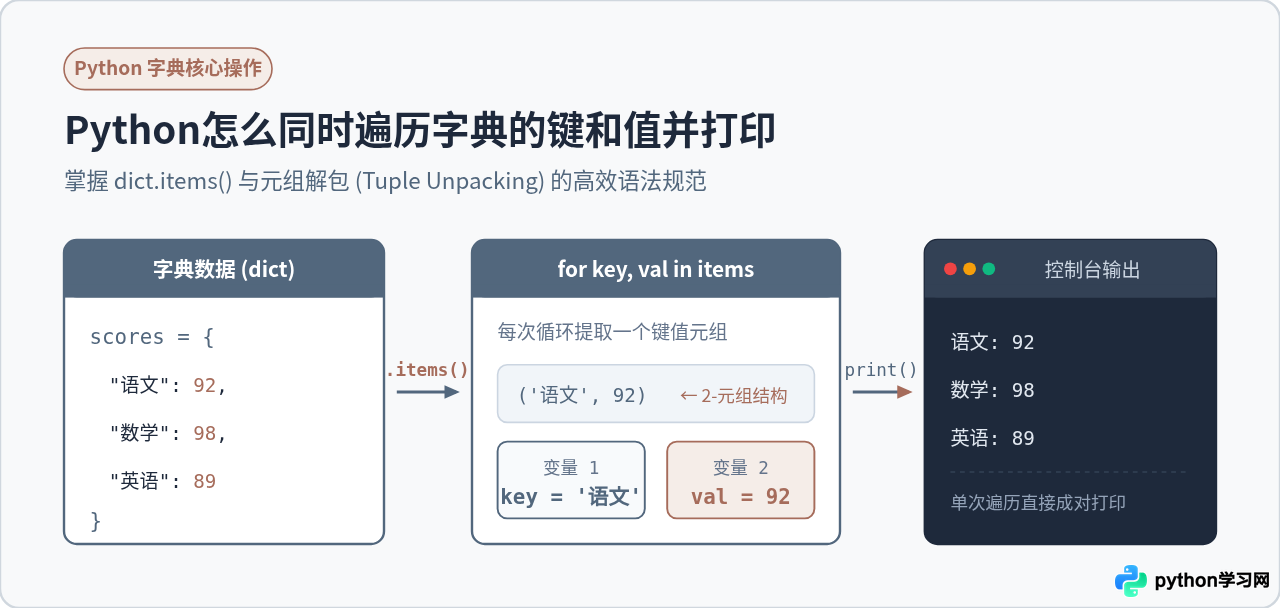
初学 Python 操作字典时,很多人写出的第一版遍历代码通常是 for k in my_dict:。然而运行后会发现,这种写法只迭代了字典的“键”。为了把对应的值也打印出来,初学者往往会习惯性地在循环体里加上 my_dict[k],写成 print(k, my_dict[k])。
这段代码虽然能跑出正确结果,但在实际项目中并不推荐:每次通过 my_dict[k] 获取数值,Python 都要在底层重新计算键的哈希值并在哈希表中检索一次,造成了不必要的性能浪费;同时代码略显繁琐。Python 针对这种普遍需求,专门提供了 dict.items() 接口。
一、标准做法:使用 items() 与元组解包
要同时拿到键和值,只需要在 for 循环左侧声明两个变量,右侧遍历 dict.items() 即可。Python 的元组解包(Tuple Unpacking)机制会自动将每次迭代吐出的二元组分别拆分赋值给这两个变量。
# 准备一个包含服务器配置信息的字典示例
server_config = {
    "host": "127.0.0.1",
    "port": 8080,
    "protocol": "HTTPS",
    "debug": True
}

# 标准遍历并打印:key 接收键,value 接收值
for key, value in server_config.items():
    print(f"{key} -> {value}")
port -> 8080
protocol -> HTTPS
debug -> True
在上述代码中,key 和 value 只是形式参数名,可以根据具体业务场景起更有含义的名字,例如 for name, score in student_scores.items(): 或 for ip, status in node_status.items():,这样能使业务逻辑一目了然。
二、深入底层:items() 返回的是什么?
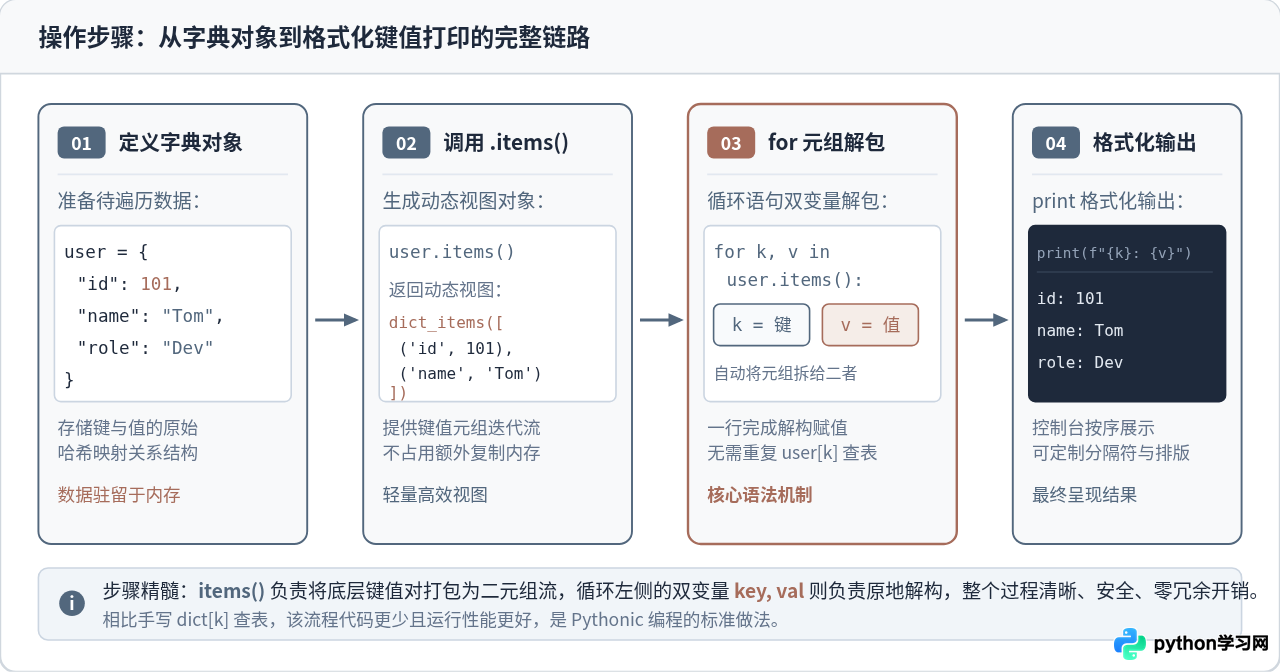
很多读者好奇:server_config.items() 到底生成了什么数据?我们可以直接在交互式终端中查看它的返回值:
info = {"apple": 5, "banana": 3}
print(info.items())
# 输出:dict_items([('apple', 5), ('banana', 3)])
在 Python 3 中,items() 返回的是一个名为 dict_items 的视图对象(Dictionary View Object)。这个对象有几个非常关键的技术特征:
- 动态联动性:视图对象并不复制字典中的数据,而是直接作为原字典的一面“镜子”。如果原字典内容改变,视图对象所展现的内容也会即时随之变动。
- 内存轻量高效:由于不产生新的键值列表副本,无论字典包含几千条还是几百万条记录,调用
.items()都几乎不耗费额外内存,时间复杂度为 \(O(1)\)。 - 元素为 2-元组:视图在遍历时,每次产生一个形如
(key, value)的双元素元组。for key, value in ...利用了 Python 的解构赋值特性,直接将元组的第 0 项赋给key、第 1 项赋给value。
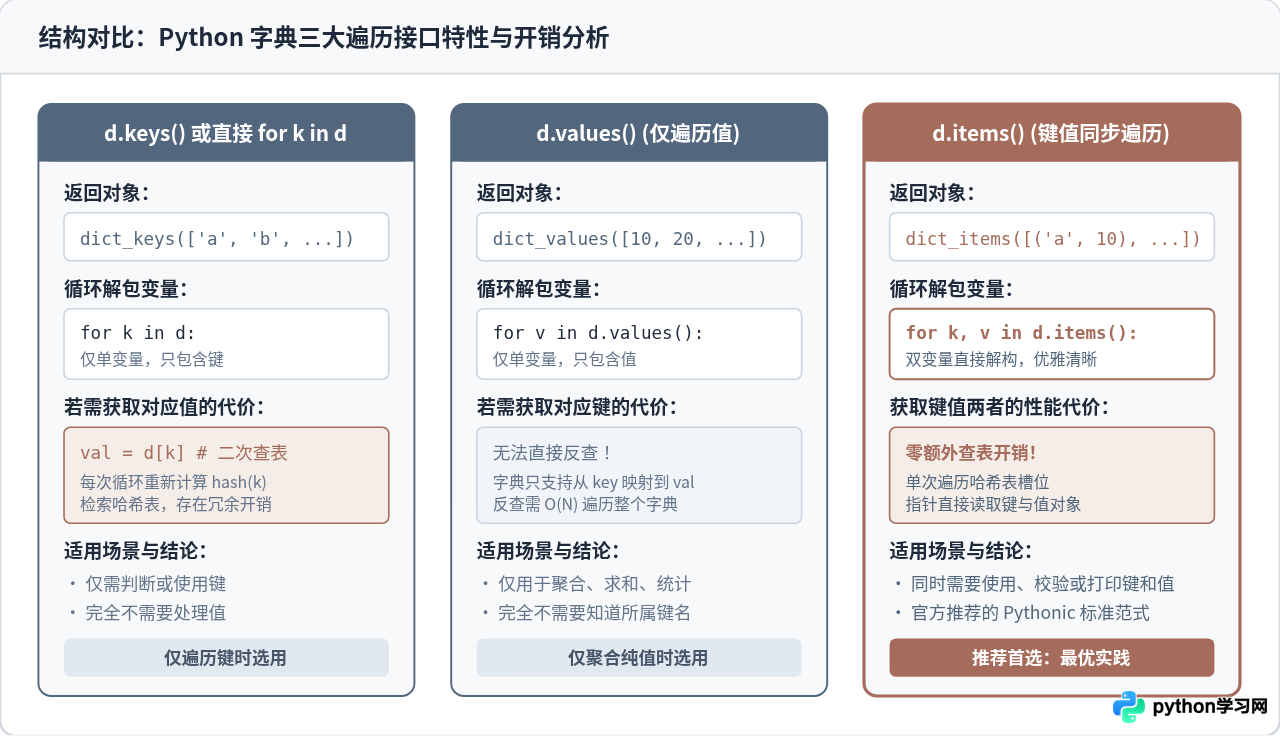
通过上图对比可以看出,如果确实同时需要键和值,items() 是唯一的全优解。而直接 for k in dict: 搭配 dict[k] 查表虽然语法直观,但在底层哈希表较大时,频繁计算哈希与冲突寻址会带来多余 CPU 消耗。
三、实用输出技巧:如何把键值打印得清晰美观
在实际编写脚本或调试日志时,除了最基础的输出,往往还需要对排版、序号以及长列表做针对性格式化。以下是几种最实用的打印场景:
1. 带有序号的键值打印(结合 enumerate)
如果需要像菜单或排行列表那样给每个键值对前加上数字编号,可以结合内置函数 enumerate() 使用。需要特别注意:此时解包存在两层嵌套,必须给 key, value 加上小括号:
products = {"手机": 3999, "平板": 2599, "耳机": 699}

# enumerate 的第二个参数指定起始序号(此处从 1 开始)
for index, (item, price) in enumerate(products.items(), 1):
    print(f"第 {index} 项: {item},标价 {price} 元")
第 2 项: 平板,标价 2599 元
第 3 项: 耳机,标价 699 元
(item, price) 外层的括号,写成 for index, item, price in enumerate(...),Python 会报 ValueError: not enough values to unpack (expected 3, got 2)。因为 enumerate 每次只产出 (index, (key, value)) 两个顶层元素。
2. 使用 f-string 进行整齐对齐与制表
当字典中的键名长短不一时,普通的 print(key, value) 会导致冒号和数值参差不齐。利用 f-string 的格式控制符,可以设定最小宽度并指定对齐方式:
metrics = {
    "cpu_usage": "45.2%",
    "mem": "78.0%",
    "disk_io_read_rate": "1.2MB/s"
}

# {key:<20} 表示左对齐且占宽 20 字符;{val:>10} 表示右对齐且占宽 10 字符
print(f"{'指标名称':<20} | {'实时数值':>10}")
print("-" * 35)
for key, val in metrics.items():
    print(f"{key:<20} | {val:>10}")
-----------------------------------
cpu_usage | 45.2%
mem | 78.0%
disk_io_read_rate | 1.2MB/s
3. 单行拼接输出(join 与推导式)
有时需要把所有键值对整理成一行文本(如拼接 URL 查询参数或单行简报),不需要显式写 for 循环块,使用 str.join() 配合生成器表达式更具表现力:
query_params = {"page": 1, "limit": 20, "sort": "desc"}
result_line = "&".join(f"{k}={v}" for k, v in query_params.items())
print(result_line)
# 示例输出:page=1&limit=20&sort=desc
四、避坑指南:必须注意的高频错误与边界条件
在掌握基本遍历之后,有两处极其关键的工程陷阱需要格外重视。
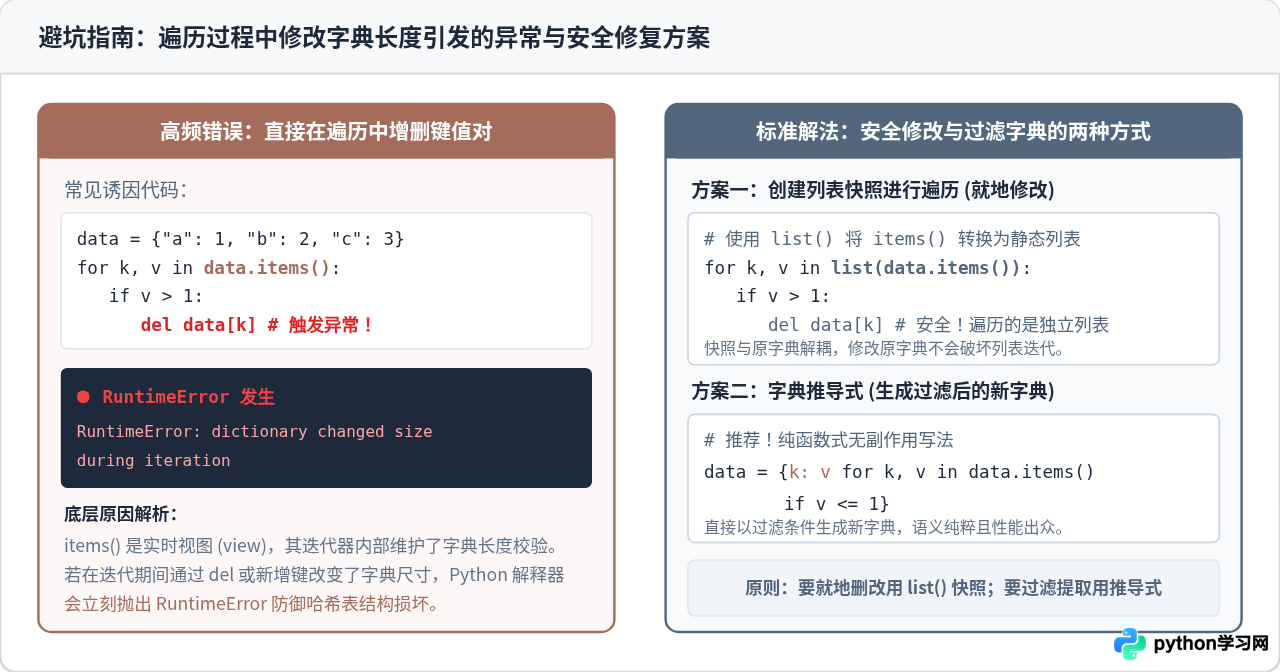
1. 致命错误:在遍历过程中直接增删字典键值
这是 Python 开发者最常踩的坑之一。如果一边使用 for k, v in d.items(): 遍历字典,一边在循环体内部直接执行 del d[k] 或 d[new_k] = val,Python 解释器会当场崩溃并抛出以下异常:
# 错误示范
inventory = {"apple": 0, "orange": 12, "peach": 0}
for k, v in inventory.items():
    if v == 0:
        del inventory[k]  # 报错:RuntimeError: dictionary changed size during iteration
这是因为 items() 提供的是动态视图。当字典哈希表在迭代中发生增删,尺寸改变会导致迭代器指针无法准确定位下一个哈希槽位。为了防止出现脏读或死循环,Python 会立即进行保护性报错。
正确解法有两种:
- 使用
list()固化快照:写成for k, v in list(inventory.items()):。list()会在循环开始前将所有键值对复制为一个独立的列表对象,后续对原字典执行del完全不会影响列表自身的遍历。 - 使用字典推导式重新生成(推荐):写成
inventory = {k: v for k, v in inventory.items() if v != 0},以过滤逻辑直接生成新字典,代码干净利落。
2. 解包变量数量必须严格匹配
如果只写了一个变量,例如 for item in my_dict.items():,那么变量 item 接收到的是完整的 (key, value) 元组。打印时会输出形如 ('host', '127.0.0.1') 的元组格式,而不是单独的键和值。若想单独使用,仍需手动取 item[0] 和 item[1]。因此,同时遍历时务必始终写全两个解包变量。
3. Python 2 与 Python 3 的历史遗留兼容
在很早期的 Python 2 中,items() 会在内存中复制一份完整的列表,当时为了节约内存推荐使用 iteritems()。但在现行的所有 Python 3 版本中,iteritems() 已经被彻底移除,items() 本身就已经是轻量级的视图迭代器。现在编写 Python 代码,直接使用 items() 即可,无需任何历史包袱。
五、场景决策与速查总结
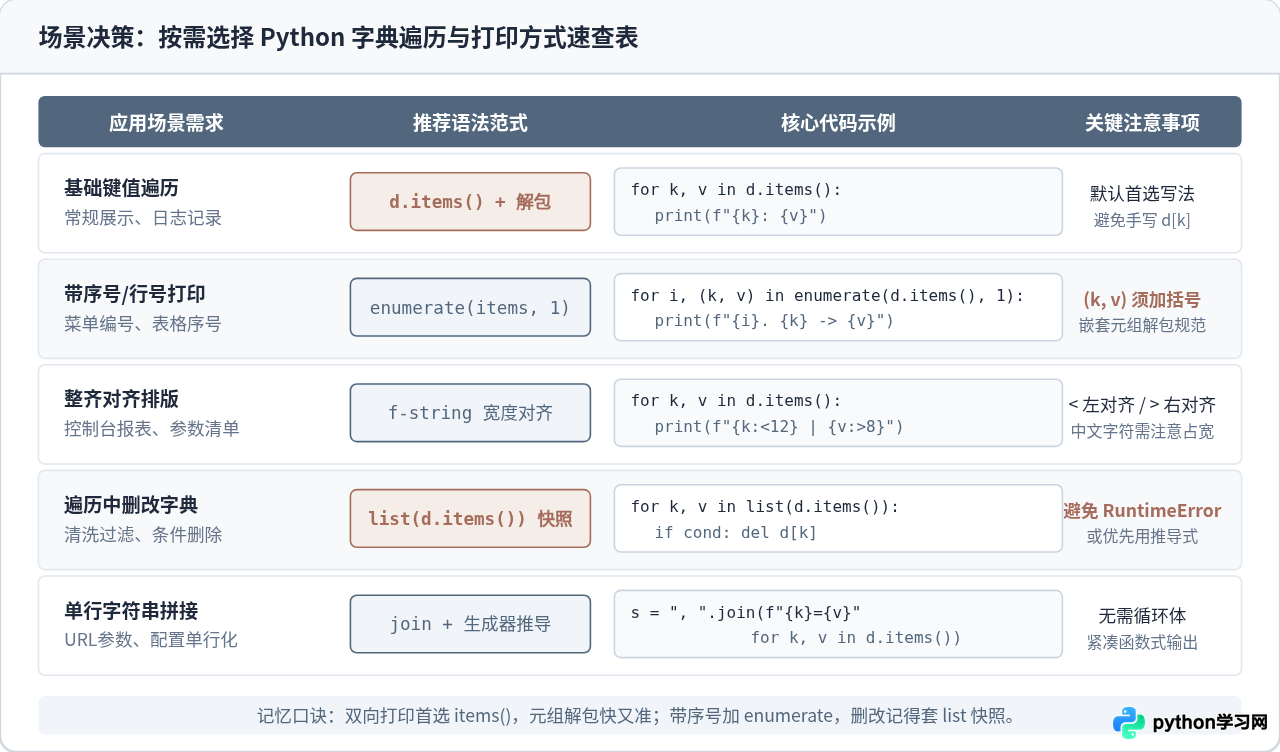
为了在日常开发中能根据不同需求快速选用最合适的方法,下表整理了针对字典遍历的场景决策清单:
| 业务需求 | 推荐遍历方式 | 核心代码范式 | 设计考量 |
|---|---|---|---|
| 同时打印键和值 | d.items() 解包 |
for k, v in d.items(): print(f"{k}: {v}") |
一步到位,无额外哈希查表损耗,最符合 Pythonic 风格。 |
| 带序号输出 | enumerate(d.items()) |
for i, (k, v) in enumerate(d.items(), 1): ... |
注意 (k, v) 需要外层括号进行嵌套元组解构。 |
| 规整表格排版 | f-string 对齐宽度 |
print(f"{k:<15} : {v:>8}") |
按字段长度统一指定占宽,输出美观易读。 |
| 边遍历边删除/新增 | list(d.items()) 快照 |
for k, v in list(d.items()): if ...: del d[k] |
避免 RuntimeError 异常;或改用字典推导式。 |
| 仅需要键 | 直接遍历字典 | for k in d: ... |
不产生冗余数据,字典默认即按键迭代。 |
| 仅需要值进行汇总 | d.values() |
for v in d.values(): ... |
适用于求和、最值、统计等不关心键名的运算。 |
总结来说,遇到“同时遍历字典键和值”的问题,核心结论就是一句话:牢记使用 d.items() 搭配 k, v 两个变量进行元组解包。在此基础上,根据具体格式需求搭配 f-string 或 enumerate,若遇到增删需求则用 list() 转换为快照,即可在各种场景下写出既健壮又优雅的 Python 代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















