


Requests、Scrapy与Selenium在Python数据采集中的代码对比
深入对比Requests、Scrapy与Selenium在Python数据采集中的核心代码实现、架构设计、执行流程与性能差异,通过同一基准任务的代码实操演示,帮助开发者厘清技术选型边界。
一、统一比对基准:多页图书信息采集任务
为了排除目标站点不同带来的代码干扰,我们设定一个标准的基准采集场景:爬取公开演练测试站点 http://books.toscrape.com/ 目录下的图书信息。任务要求遍历前2页列表,提取每本图书的书名(Title)、价格(Price)以及库存状态(Availability),并将结果以统一的数据字典结构产出。
该目标站点采用标准的服务端HTML渲染机制,结构稳定且分页明确。通过在同一业务需求下对照三种工具的实际实现,能够清晰展现各自的语法特征、组件分工和心智模型差异。
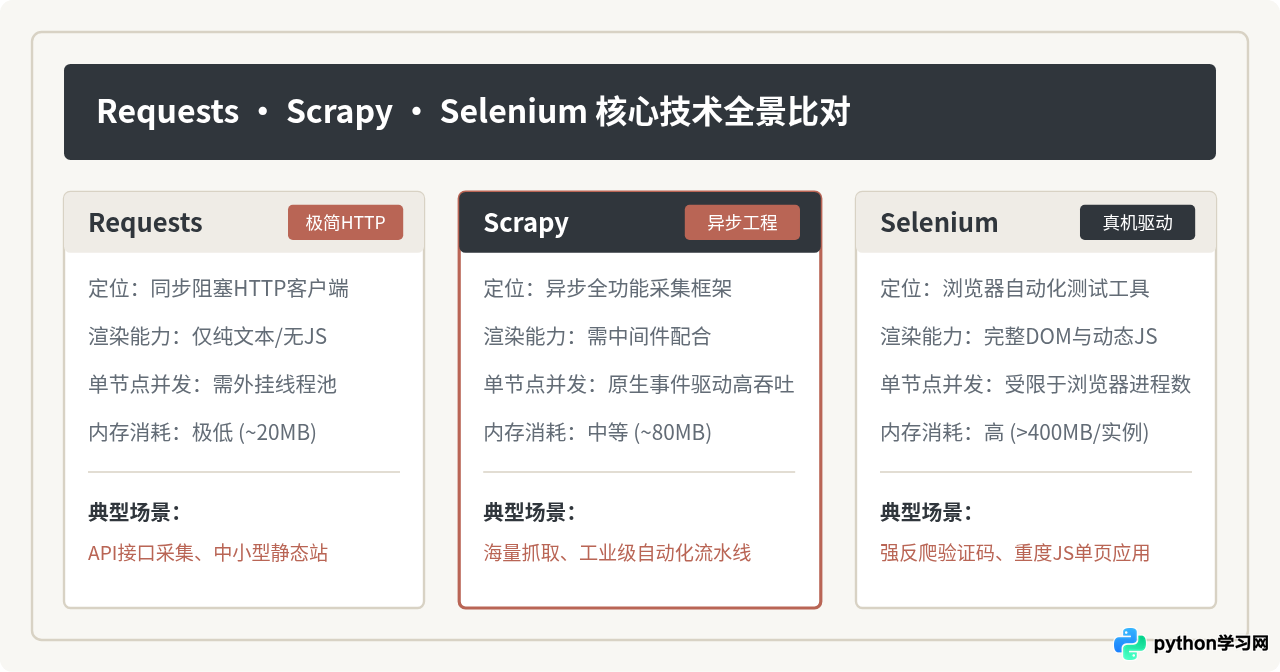
二、Requests:极简同步流与底层逻辑拼接
Requests是Python生态中最为广泛使用的HTTP客户端库。它的设计哲学是“为人类构建”,通过精炼的API隐藏了连接池建立、Cookie传递与重定向处理的复杂性。但需要注意:Requests自身仅负责网络传输,不具备任何HTML解析能力,必须与外部解析器(如 BeautifulSoup4 或 lxml)配合使用。
1. 完整采集代码示例
import re
import requests
from bs4 import BeautifulSoup

def scrape_with_requests(max_pages=2):
    base_url = "http://books.toscrape.com/catalogue/page-{}.html"
    results = []

    # 建立持久化会话对象,复用底层的 TCP 连接
    with requests.Session() as session:
        session.headers.update({
            "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36"
        })

        for page in range(1, max_pages + 1):
            url = base_url.format(page)
            try:
                # 阻塞式同步发起 HTTP GET 请求
                response = session.get(url, timeout=10)
                response.raise_for_status()
                response.encoding = response.apparent_encoding
            except requests.exceptions.RequestException as e:
                print(f"[Requests 错误] 请求第 {page} 页失败: {e}")
                continue

            # 使用 BeautifulSoup 将 HTML 文本解析为内存 DOM 树
            soup = BeautifulSoup(response.text, "html.parser")
            articles = soup.find_all("article", class_="product_pod")

            for article in articles:
                # 提取书名、价格及库存信息
                title_tag = article.find("h3").find("a")
                title = title_tag.get("title", "").strip() if title_tag else ""

                price_tag = article.find("p", class_="price_color")
                price = price_tag.text.strip() if price_tag else ""

                stock_tag = article.find("p", class_="instock availability")
                stock = re.sub(r"\s+", " ", stock_tag.text).strip() if stock_tag else ""

                results.append({
                    "title": title,
                    "price": price,
                    "stock": stock,
                    "source": "Requests"
                })

    return results

if __name__ == "__main__":
    items = scrape_with_requests()
    print(f"[Requests] 采集完成,共获取 {len(items)} 条记录。首条数据: {items[0] if items else None}")
2. 代码与运行特征评析
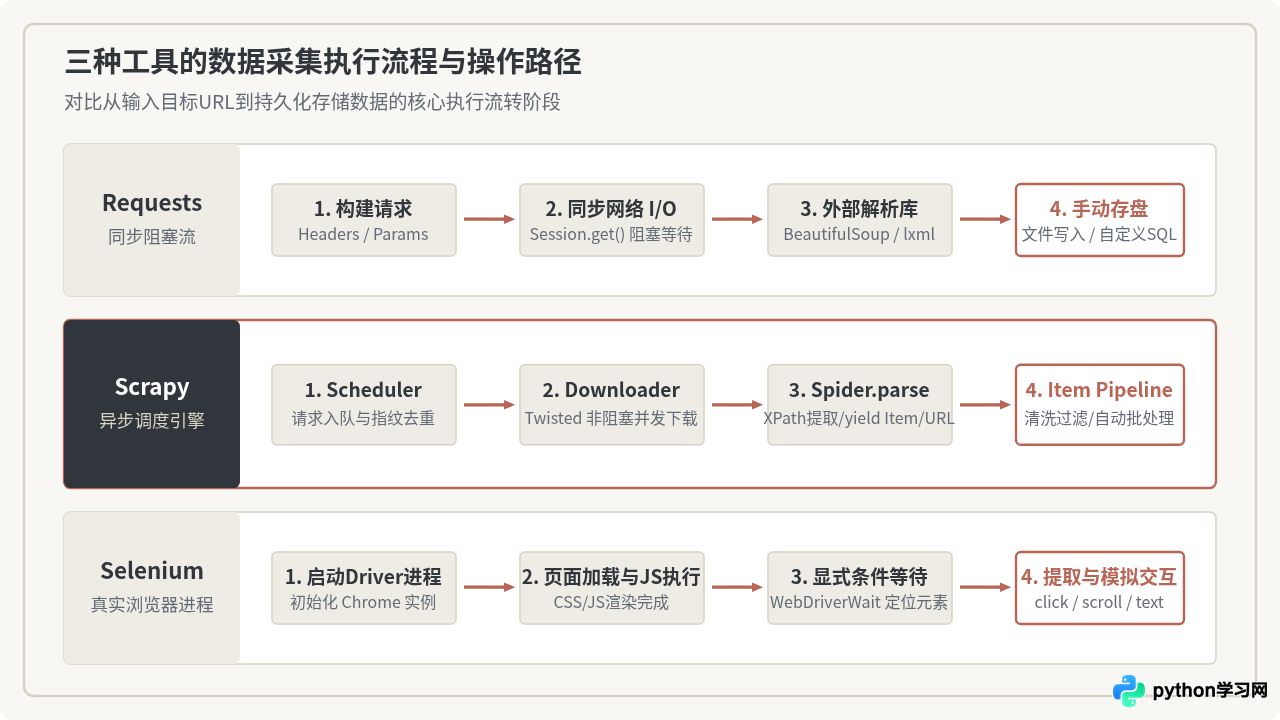
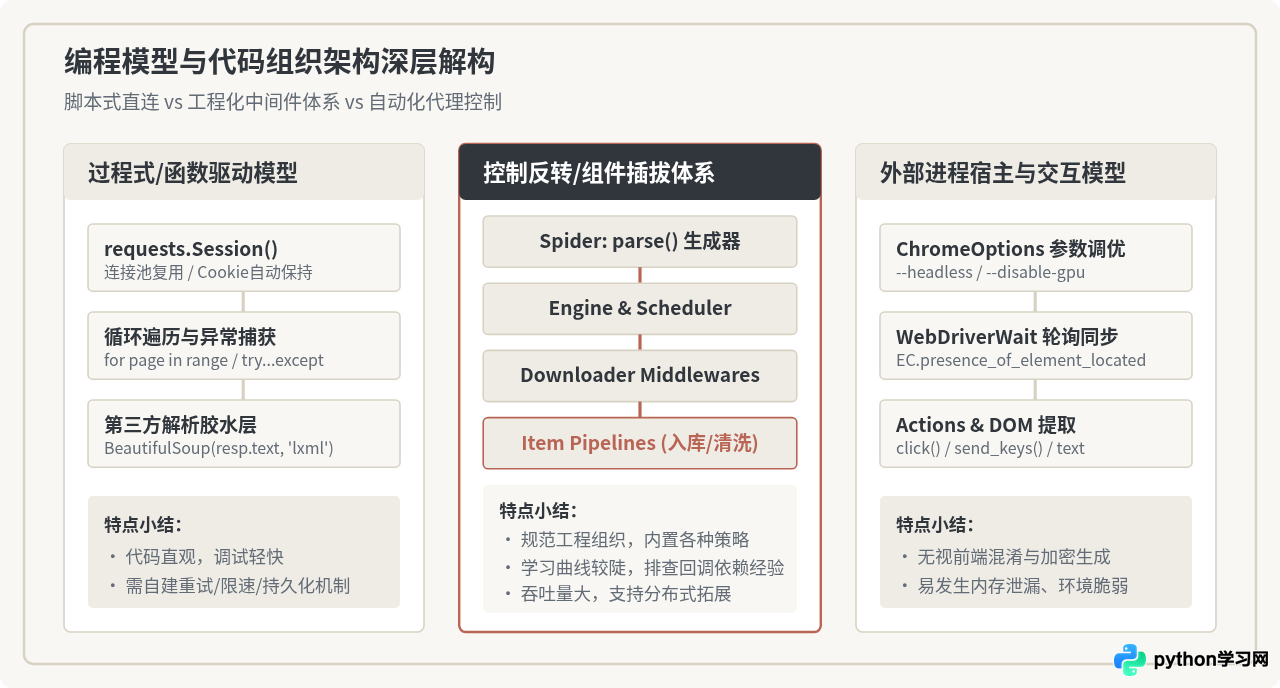
从代码中可以看出,Requests的控制流是纯线性的:循环构造URL -> 发起请求 -> 等待响应 -> 传入解析器 -> 提取字段 -> 放入列表。这种架构优势在于没有任何框架样板代码,调试时可以在任意行打断点或单步执行,异常捕获直截了当。但缺点同样明显:如果抓取1000个页面,单线程循环将处于漫长的网络I/O等待中;开发者必须自行手动编写多线程池(如 concurrent.futures)、失败重试循环以及持久化入库逻辑。
三、Scrapy:工业级异步事件驱动框架
Scrapy并不是一个简单的库,而是一个完备的采集工程框架。它基于Twisted事件驱动引擎构建,将网络下载、请求去重、页面解析、数据管道清洗与入库彻底解耦。在Scrapy中,开发者编写的代码主要是声明式的解析规则,调度与并发完全交由框架内核管理。
1. 完整采集代码示例
import scrapy
from scrapy.crawler import CrawlerProcess

# 1. 声明数据模型
class BookItem(scrapy.Item):
    title = scrapy.Field()
    price = scrapy.Field()
    stock = scrapy.Field()
    source = scrapy.Field()

# 2. 声明爬虫逻辑
class BooksSpider(scrapy.Spider):
    name = "books_spider"
    allowed_domains = ["books.toscrape.com"]
    start_urls = ["http://books.toscrape.com/catalogue/page-1.html"]
    max_pages = 2
    current_page = 1

    def parse(self, response):
        # 原生使用 XPath 或 CSS 选择器高效提取节点
        for article in response.css("article.product_pod"):
            item = BookItem()
            item["title"] = article.css("h3 a::attr(title)").get("").strip()
            item["price"] = article.css("p.price_color::text").get("").strip()
            raw_stock = article.css("p.instock.availability::text").getall()
            item["stock"] = " ".join("".join(raw_stock).split())
            item["source"] = "Scrapy"
            yield item

        # 处理翻页逻辑
        self.current_page += 1
        if self.current_page <= self.max_pages:
            next_url = f"http://books.toscrape.com/catalogue/page-{self.current_page}.html"
            # 异步将新 URL yield 给引擎调度器
            yield response.follow(next_url, callback=self.parse)

# 3. 独立入口与框架配置运行
if __name__ == "__main__":
    collected_items = []

    # 自定义管道收集数据
    class MemoryPipeline:
        def process_item(self, item, spider):
            collected_items.append(dict(item))
            return item

    settings = {
        "LOG_LEVEL": "ERROR",
        "CONCURRENT_REQUESTS": 16,
        "DOWNLOAD_DELAY": 0.25,
        "ITEM_PIPELINES": {MemoryPipeline: 300},
        "USER_AGENT": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36"
    }

    process = CrawlerProcess(settings=settings)
    process.crawl(BooksSpider)
    process.start() # 启动 Twisted Reactor 循环

    print(f"[Scrapy] 采集完成,共获取 {len(collected_items)} 条记录。首条数据: {collected_items[0] if collected_items else None}")
2. 代码与运行特征评析
Scrapy的代码形态与Requests有根本不同:parse 方法是一个Python生成器,通过 yield item 交付数据,通过 yield response.follow() 交付后续抓取任务。开发者不需要写 for 循环去阻塞请求每一页,Twisted会在后台维持一个高效的非阻塞Socket连接池。此外,内置的选择器直接在C语言层级的 lxml 树上求值,内存利用率极高,天然适合数十万级页面的高吞吐量采集。
四、Selenium:真实浏览器内核驱动与动态仿真
Selenium最初是为Web应用程序的端到端自动化测试而诞生的。它不直接向服务器发送裸HTTP报文,而是通过WebDriver接口向底层的无头浏览器(如 Google Chrome 或 Firefox)下发指令。浏览器会执行所有外部JavaScript代码、渲染CSS样式表、发起AJAX子请求,并构建完整的实时DOM树。
1. 完整采集代码示例
import re
from selenium import webdriver
from selenium.webdriver.chrome.options import Options
from selenium.webdriver.chrome.service import Service
from selenium.webdriver.common.by import By
from selenium.webdriver.support.ui import WebDriverWait
from selenium.webdriver.support import expected_conditions as EC

def scrape_with_selenium(max_pages=2):
    chrome_options = Options()
    # 启用无头模式,避免弹出图形界面窗口
    chrome_options.add_argument("--headless=new")
    chrome_options.add_argument("--disable-gpu")
    chrome_options.add_argument("--no-sandbox")
    chrome_options.add_argument("--disable-dev-shm-usage")
    chrome_options.add_argument("user-agent=Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36")

    driver = webdriver.Chrome(options=chrome_options)
    results = []

    try:
        base_url = "http://books.toscrape.com/catalogue/page-{}.html"

        for page in range(1, max_pages + 1):
            url = base_url.format(page)
            driver.get(url)

            # 显式等待:确保图书列表节点已经挂载到 DOM 中(至多等待 10 秒)
            wait = WebDriverWait(driver, 10)
            wait.until(EC.presence_of_element_located((By.CSS_SELECTOR, "article.product_pod")))

            articles = driver.find_elements(By.CSS_SELECTOR, "article.product_pod")
            for article in articles:
                # 定位当前节点下的子元素
                title_elem = article.find_element(By.CSS_SELECTOR, "h3 a")
                title = title_elem.get_attribute("title") or title_elem.text

                price_elem = article.find_element(By.CSS_SELECTOR, "p.price_color")
                price = price_elem.text.strip()

                stock_elem = article.find_element(By.CSS_SELECTOR, "p.instock.availability")
                stock = re.sub(r"\s+", " ", stock_elem.text).strip()

                results.append({
                    "title": title,
                    "price": price,
                    "stock": stock,
                    "source": "Selenium"
                })

    finally:
        # 必须显式关闭 driver 进程,防止僵尸 Chrome 进程耗尽内存
        driver.quit()

    return results

if __name__ == "__main__":
    items = scrape_with_selenium()
    print(f"[Selenium] 采集完成,共获取 {len(items)} 条记录。首条数据: {items[0] if items else None}")
2. 代码与运行特征评析
Selenium的代码围绕 WebDriver 实例展开。它的核心开销在于驱动真实的浏览器子进程:每一个页面跳转都涉及HTML解析、样式计算、JS脚本引擎执行及重绘过程。正因如此,代码中必须严谨使用 WebDriverWait 进行显式同步等待,否则极易发生 NoSuchElementException 或 StaleElementReferenceException 异常。在任务结束时,必须在 finally 块中调用 driver.quit() 释放进程资源。
五、多维度技术差异对照
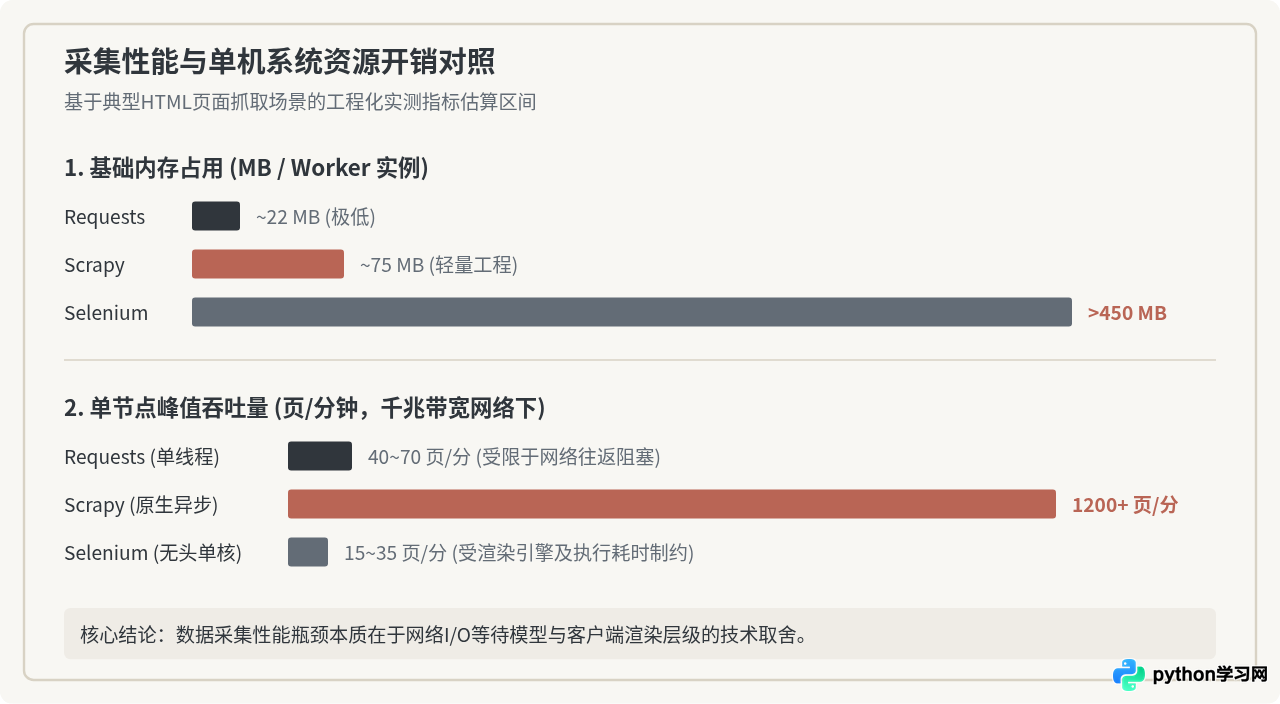
为了直观评估三者在工程落地中的适配性,我们从编程接口、执行机制、资源占用与维护成本四个核心维度进行系统性对比:
| 比对维度 | Requests | Scrapy | Selenium |
|---|---|---|---|
| 本质定位 | 协议层同步 HTTP 传输客户端 | 分布式就绪的异步采集框架 | 自动化测试与浏览器驱动平台 |
| JavaScript 执行 | 不支持(只能获取初始字节流) | 原生不支持(需集成无头中间件) | 原生完全支持(V8/Blink 引擎执行) |
| 并发模型 | 单线程同步阻塞(需自建多线程) | Twisted 事件循环非阻塞 I/O | 依赖多浏览器进程池(开销巨大) |
| 内存开销 (单节点) | 极小(15MB ~ 30MB) | 低至中等(50MB ~ 100MB) | 极高(每个标签页/实例 300MB+) |
| 网络吞吐性能 | 中等(受制于网络延迟往返) | 极高(数千请求/分钟级别) | 较低(每分钟数十页为常见上限) |
| 代码与调试成本 | 极低,单脚本即写即测 | 需遵循项目规范与组件声明 | 中等,需处理环境驱动与元素等待 |
| 反爬防御对抗 | 易被基于指纹、TLS及JS的屏障拦截 | 支持自定义中间件伪装请求特征 | 具备真实浏览器指纹,天然克制JS混淆 |
六、工程实践中的选型原则与混合架构建议
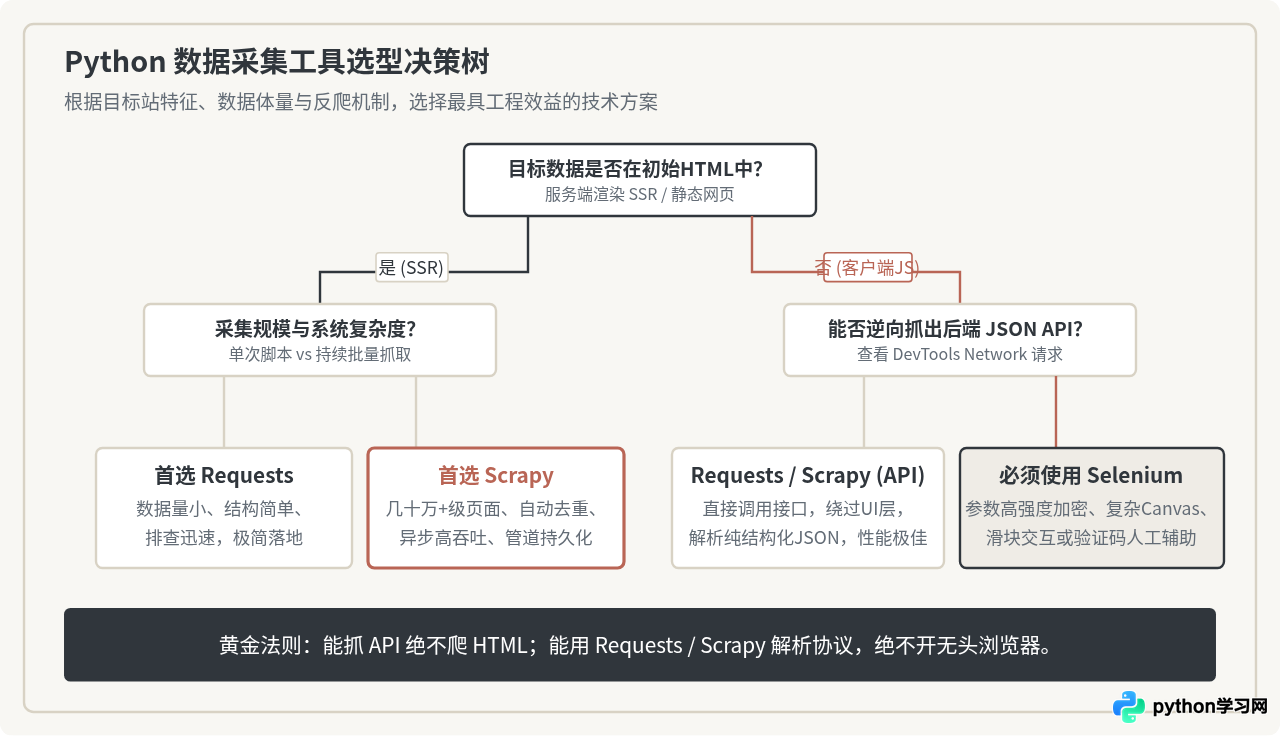
在实际生产研发中,切忌盲目依赖单一工具。合理的选型应当建立在充分分析目标站协议特征的基础之上:
现代单页应用(SPA)虽然在前端使用复杂的 Vue 或 React 框架渲染,但其底层数据绝大多数来自干净的 RESTful JSON 接口。在启动 Selenium 之前,首先应打开浏览器的开发者工具(F12),切换至 Network 标签页观察 XHR/Fetch 请求。如果能直接捕获其接口规律并构造请求头,使用 Requests 或 Scrapy 直接读取 JSON 数据的效率比无头浏览器高出数十倍。
如果只是临时采集几百个网页或单次分析,编写一个包含几十行代码的 Requests 脚本是最快交付的选择。而一旦目标页面上升至数十万、几百万量级,需要自动去重、失败重试、自动限速防封、断点续爬以及直接对接 MySQL/MongoDB 时,Scrapy 提供的成熟工程脚手架能够大幅减少系统维护的复杂度。
当大型采集任务中仅有 5% 的关键页面(如滑块验证码页面、动态签名计算逻辑)需要执行 JavaScript 时,不要将整个项目切换为纯 Selenium。最佳实践是将 Selenium(或现代的 Playwright)作为
Downloader Middleware 嵌入 Scrapy 框架:大部分静态页面由 Scrapy 高速下载,仅对特定 URL 交由无头浏览器中间件拦截渲染,从而实现吞吐效率与渲染能力的最佳平衡。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















