


Python数据分析常用库函数名汇总:Pandas、NumPy与Matplotlib核心方法
系统梳理Python数据分析三大利器Pandas、NumPy与Matplotlib的核心方法与常用函数名汇总。涵盖数组运算、表格清洗切片、分组聚合、面向对象绘图及三库协同实战,提供高可用的工程实践参考。
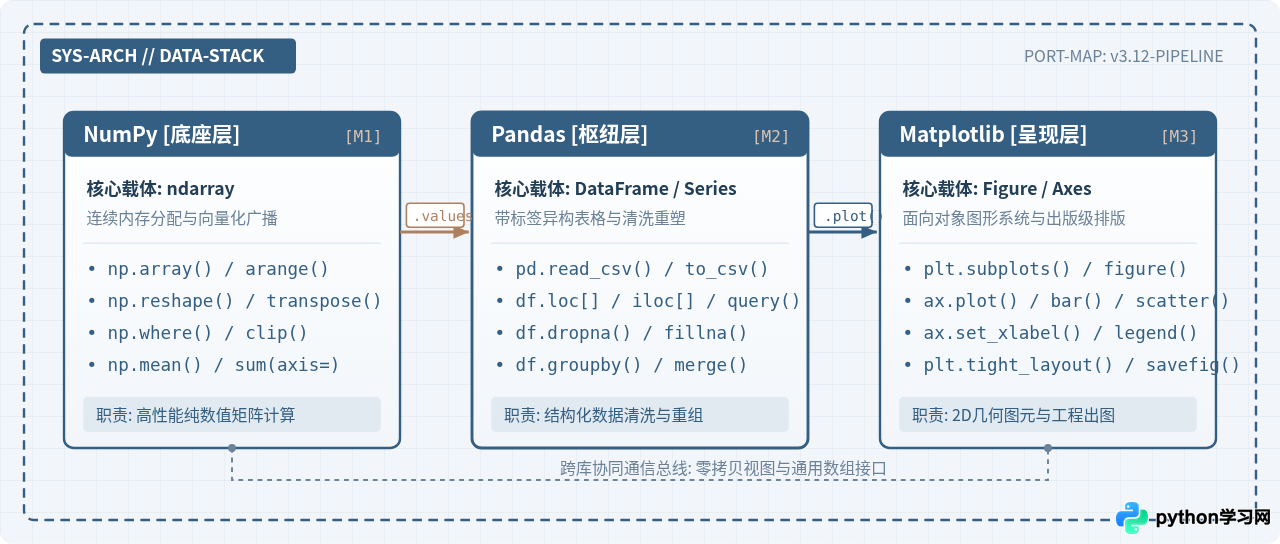
在Python数据科学与分析工程中,解决实际分析任务主要依托三大基础设施:NumPy提供底层高性能多维数组(ndarray)与向量化线性代数计算;Pandas以二维带标签数据帧(DataFrame)为核心,承担结构化数据的导入、清洗、缺失值处理、切片与分组聚合;Matplotlib则负责将提取好的数值与统计指标映射为各类工程出版级可视化图表。本文梳理三者在实际工作中最核心、最高频的函数名与核心方法,按功能归类并给出典型代码范式与避坑提示,帮助读者建立系统清晰的方法索引。
一、标准数据分析链路与三库协作机制
面对一份业务原始数据,典型的数据分析并非割裂地调用某个库,而是形成一条闭环的工程流水线:首先由Pandas从文件或数据库载入异构表格并完成缺失排查与过滤;接着利用NumPy对特定数值列进行高效向量化逻辑运算、极值截断或矩阵变换;最后将聚合得到的统计序列传入Matplotlib的面向对象绘图接口输出高清图表。
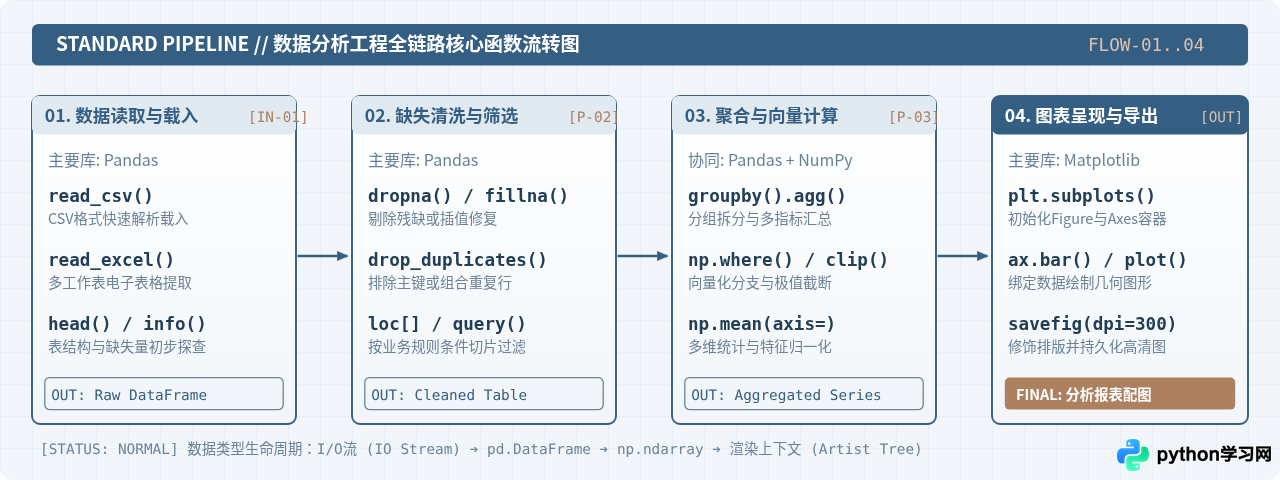
以下是体现该全链路协作的最小可用代码骨架:
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt

# 1. 载入与初步检查
df = pd.read_csv("sales_records.csv")

# 2. 清洗:剔除缺失、多条件筛选并用NumPy处理业务标签
df = df.dropna(subset=["amount", "region"])
df["tier"] = np.where(df["amount"] >= 1000, "High", "Standard")

# 3. 聚合:计算各区域平均销售额
summary = df.groupby("region")["amount"].mean().sort_values(ascending=False)

# 4. 可视化呈现:面向对象绘制柱状图
fig, ax = plt.subplots(figsize=(8, 4.5), dpi=120)
ax.bar(summary.index, summary.values, color="#345E82", width=0.55)
ax.set_title("Average Sales by Region", fontsize=12, pad=10)
ax.set_ylabel("Mean Amount (USD)")
ax.grid(True, linestyle="--", alpha=0.5, axis="y")
fig.tight_layout()
fig.savefig("sales_by_region.png", dpi=300)
plt.close(fig)
二、NumPy核心方法:多维数组与向量化计算
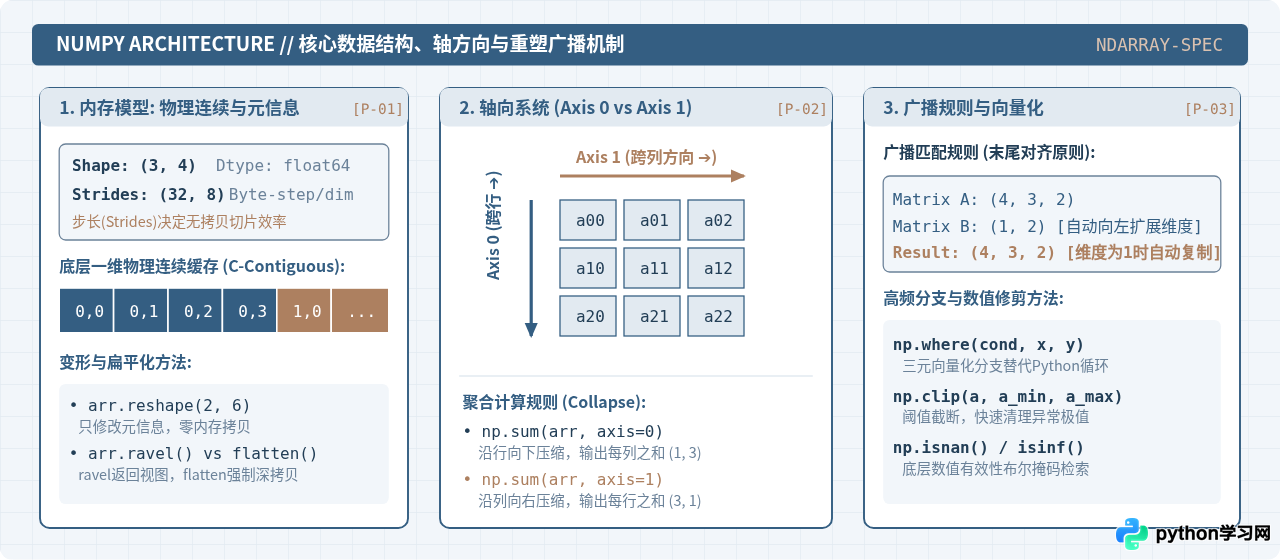
NumPy的核心实体是 ndarray。与Python原生列表存储指针的方式不同,ndarray在物理上分配连续内存块(C-Contiguous或Fortran-Contiguous),通过步长(Strides)与形状(Shape)实现无需复制数据的切片与维度重构,运算效率极高。
1. 数组创建与形状变换
| 函数 / 方法名 | 典型调用格式 | 作用及参数要点 |
|---|---|---|
np.array() |
np.array([1, 2, 3], dtype=float) |
将Python列表或元组转换为ndarray,可显式指定元素数据类型。 |
np.arange() |
np.arange(0, 10, 2) |
生成等差步长数值区间(左闭右开),适合固定步长的整数或浮点数列。 |
np.linspace() |
np.linspace(0.0, 1.0, 50) |
按元素个数在闭区间生成均匀分布点,高频用于绘图坐标轴X序列生成。 |
np.zeros() / np.ones() |
np.zeros((3, 4), dtype=int) |
以全0或全1初始化指定形状的矩阵,常用于预分配缓存数组。 |
reshape() |
arr.reshape(2, -1) |
重组数组维度。参数允许一个维数为 -1(自动推导计算该维大小)。 |
ravel() / flatten() |
arr.ravel() |
将多维数组展平为一维。ravel返回视图(共享内存),flatten返回深拷贝。 |
2. 数学统计与轴(Axis)计算
在调用统计函数时,必须准确理解 axis 参数的折叠含义:对于二维矩阵,axis=0 表示沿着纵向行方向压缩,最终计算结果保留列数(即求“每列的均值”);而 axis=1 表示沿着横向列方向压缩,计算结果保留行数(即求“每行的均值”)。
np.sum(arr, axis=...)/np.mean(arr, axis=...):沿指定轴计算求和或算术平均值。np.std(arr)/np.var(arr):计算标准差与方差,可设置ddof=1切换为样本无偏估计。np.max(arr)/np.min(arr):提取极值;配合np.argmax()/np.argmin()获取极值所在扁平化索引或轴向索引。np.percentile(arr, q=75):计算分位数(如75分位值),在异常值检测与箱线图离群点判定中不可或缺。
3. 逻辑分支与数值修饰
# 避免使用for循环遍历修改数组,使用向量化分支
scores = np.array([58, 72, 95, 43, 88])

# 1. np.where: 条件为真取 'Pass',否则取 'Fail'
result = np.where(scores >= 60, "Pass", "Fail")

# 2. np.clip: 限制数值在 [50, 90] 区间内,低于50置为50,高于90置为90
clipped_scores = np.clip(scores, a_min=50, a_max=90)

# 3. np.isnan: 检索浮点空值掩码
raw_data = np.array([1.2, np.nan, 3.4])
valid_mask = ~np.isnan(raw_data)
clean_arr = raw_data[valid_mask]  # 过滤后为 array([1.2, 3.4])
三、Pandas核心方法:结构化表格清洗与分析
Pandas构建在NumPy之上,提供带索引行标签与列标签的二维表结构 DataFrame 与单列序列 Series。日常数据分析中80%以上的脏数据整理、多表匹配和聚合统计算法由Pandas承担。
1. 数据检视与索引切片定位
df.head(n)/df.tail(n):查看前/后n行数据(默认5行),确认载入格式是否错位。df.info():输出表结构、内存占用、各字段非空计数值及Dtype类型。df.describe():生成数值列的快速统计摘要(count, mean, std, min, 25%, 50%, 75%, max)。df.loc[row_indexer, col_indexer]:基于标签名称切片。注意:标签切片包含两端边界(闭区间)。df.iloc[row_idx, col_idx]:基于整数物理位置切片。符合Python传统左闭右开规则。df.query("expr"):使用字符串表达式过滤行,代码更整洁(例如df.query("age > 25 and status == 'active'"))。
2. 缺失值、重复值与类型清洗
# 统计每列缺失量
missing_counts = df.isna().sum()

# 丢弃特定关键列存在缺失的记录
df_clean = df.dropna(subset=["user_id", "timestamp"])

# 填充缺失值:固定值或使用列统计值
df["city"] = df["city"].fillna("Unknown")
df["salary"] = df["salary"].fillna(df["salary"].median())

# 重复行检查与剔除
df = df.drop_duplicates(subset=["order_id"], keep="first")

# 类型转换:下采样减少内存开销或格式化日期
df["category"] = df["category"].astype("category")
df["order_date"] = pd.to_datetime(df["order_date"], format="%Y-%m-%d")
3. 分组聚合 (Groupby) 与数据透视 (Pivot Table)
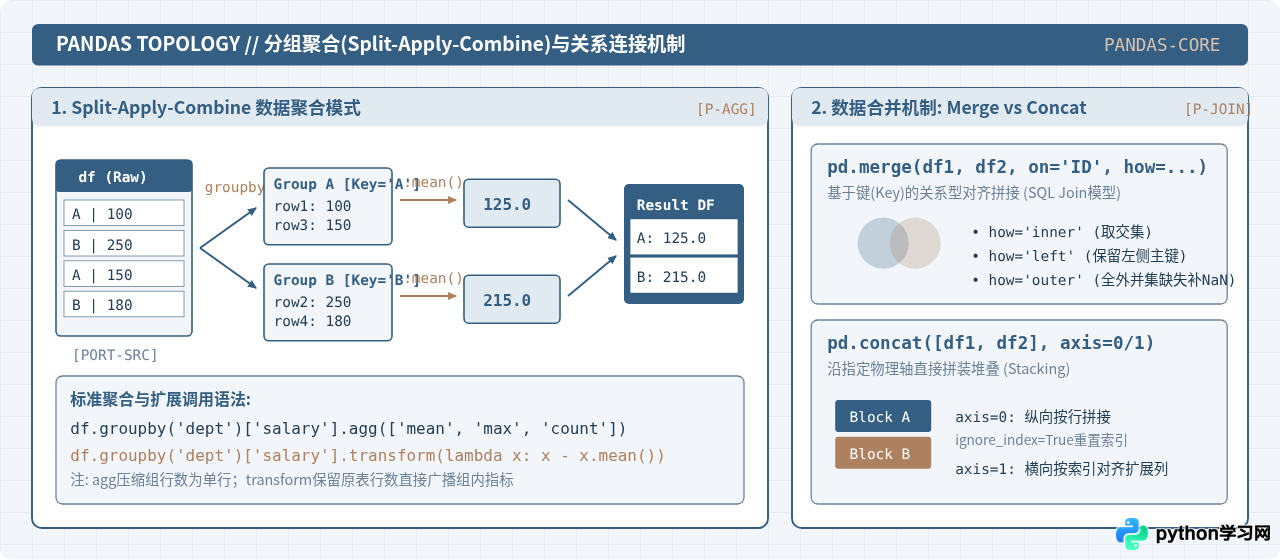
分组遵循“拆分(Split)- 应用(Apply)- 合并(Combine)”模式。使用 agg() 可以对不同字段指定不同的聚合函数,避免多次循环处理:
# 对不同列执行差异化聚合统计
grouped_stats = df.groupby("department").agg(
    avg_salary=("salary", "mean"),
    max_bonus=("bonus", "max"),
    headcount=("user_id", "count")
).reset_index()

# transform: 计算组内比例,计算结果保持与原始表相同长度
df["dept_mean"] = df.groupby("department")["salary"].transform("mean")
df["diff_from_avg"] = df["salary"] - df["dept_mean"]

# pivot_table: 构建多维交叉分析表
pv = df.pivot_table(
    values="salary",
    index="department",
    columns="job_level",
    aggfunc="median",
    fill_value=0
)user_id、sku_id),必须使用 pd.merge(df1, df2, on="ID", how="left") 进行关系型连接对齐;若仅是将格式相同的数据文件按月纵向堆叠拼接,应使用 pd.concat([df_jan, df_feb], axis=0, ignore_index=True)。混用两者容易导致笛卡尔积或索引错位。
四、Matplotlib核心方法:画布架构与图表精细渲染
在生产环境和复杂报表绘制中,应彻底摒弃隐式状态机风格的 plt.plot(),全面采用面向对象(Object-Oriented, OO)API。面向对象接口显式获取顶层画布(Figure)与子图轴对象(Axes),不仅层次结构清晰,而且在多子图排版与复杂注释时不会发生状态污染。
1. 画布初始化与布局控制
plt.subplots(nrows, ncols, figsize=(w, h), dpi=...):标准初始化方法,返回画布实例fig以及子图数组/对象ax。fig.tight_layout():自动调整子图边距、标题和轴标签,避免图元文字被截断。fig.savefig(fname, dpi=300, bbox_inches="tight"):将图表持久化为PNG/PDF/SVG文件,bbox_inches="tight"自动裁去外部白边。plt.close(fig):绘图完成并保存后显式释放内存缓存,防止在批量循环产图脚本中出现内存泄漏。
2. 核心图元绘制与修饰API汇总
| API 方法名 | 典型调用参数 | 适用场景与输出特征 |
|---|---|---|
ax.plot() |
ax.plot(x, y, color="#345E82", lw=2, ls="--") |
折线图:展现时间序列波动、平滑趋势与多模型指标对比。 |
ax.bar() / ax.barh() |
ax.bar(categories, values, width=0.6) |
垂直/水平柱状图:离散分类的绝对量或聚合指标对比。 |
ax.scatter() |
ax.scatter(x, y, c=z, s=size, alpha=0.7) |
散点图:观察双连续变量相关性、聚类分布及多维气泡映射。 |
ax.hist() |
ax.hist(arr, bins=30, density=True) |
直方图:展现单连续特征的频数分布形态与正态偏度。 |
ax.boxplot() |
ax.boxplot(data_list, vert=True) |
箱线图:呈现中位数、四分位距(IQR)及统计离群异常点。 |
ax.set_title() / set_xlabel() |
ax.set_title("Metric Trend", pad=12) |
配置子图标题与横纵坐标轴物理含义名称及字体间距。 |
ax.set_xlim() / set_ylim() |
ax.set_ylim(0, 100) |
强制锁定轴显示范围,防止极值拉伸导致各子图比例不一致。 |
ax.legend() |
ax.legend(loc="upper right", frameon=False) |
激活图例展示,支持控制摆放锚点与外边框显示。 |
ax.annotate() |
ax.annotate("Peak", xy=(x, y), xytext=...) |
在指定数据坐标位置添加指向箭头与工程标注文字。 |
五、三大核心库常用函数全景决策速查
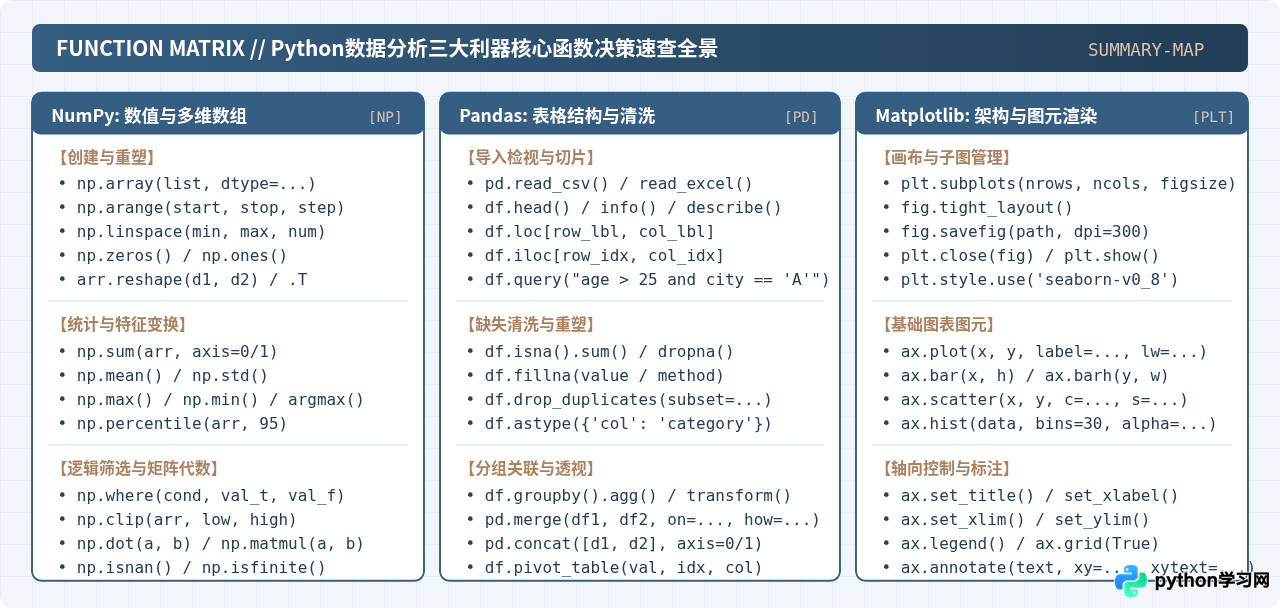
为方便在日常编码与脚本调试时迅速检索定位目标方法,下表及全景速查图将数据分析生命周期各阶段的方法进行了结构化归纳。
工程落地中的性能与实践法则
-
坚决杜绝在DataFrame上使用
iterrows()遍历修改数据: Python行级迭代开销极大。凡是按条件计算新列的逻辑,优先使用Pandas内建向量化表达式;复杂双分支逻辑使用np.where();多区间分支使用np.select([cond1, cond2], [choice1, choice2]),性能通常可提升数十至数百倍。 -
适时下沉至底层NumPy计算核心指标:
Pandas的Series带有索引对齐等开销。在需要执行高频重复的数学公式计算(如欧氏距离、损失函数或蒙特卡洛模拟)时,先通过
df['col'].to_numpy()剥离索引转为纯数值数组,计算完成后再打包赋值回表格。 -
使用紧凑数据类型(Dtype Downcasting)管控内存:
默认导入时Pandas常将整数识别为
int64,浮点识别为float64。对于范围有限的枚举字符串,及时转为category;对于中小型数值,转为int32或float32,可立即节省50%以上的内存空间。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















