


Python str.translate()高效字符映射替换指南
深入解析 Python str.translate() 与 str.maketrans() 的核心工作机制、映射表构建方法、典型实战场景与性能边界,掌握单遍扫描的高性能字符置换与批量过滤方案。
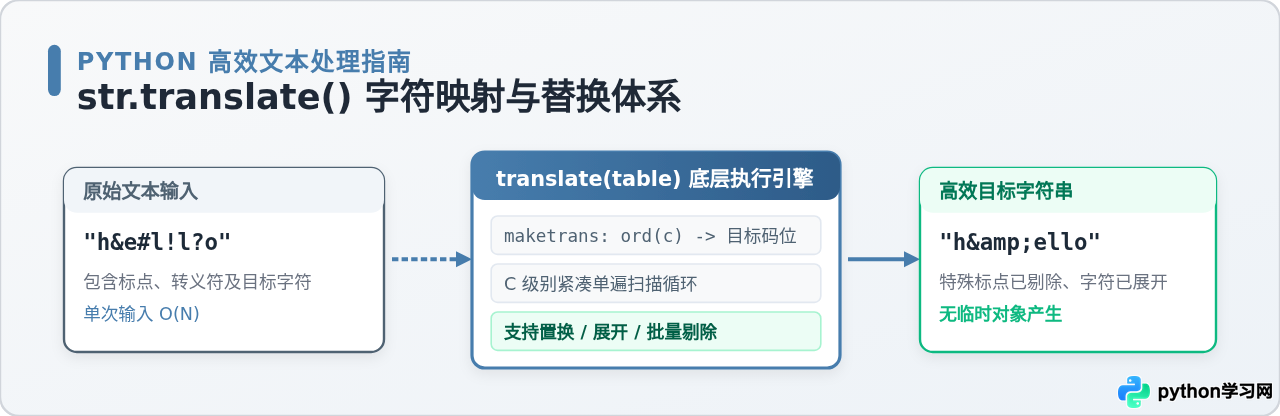
在日常文本清洗、敏感符号过滤或格式标准化任务中,经常需要对大量字符串执行多字符置换或字符剔除操作。如果直接采用连续链式调用 str.replace(),由于 Python 字符串的不可变特性,每次调用都会遍历完整文本并分配新的内存副本,导致性能随替换规则数量增加而线性恶化。Python 原生内置的 str.translate() 结合 str.maketrans(),通过底层的 Unicode 码位映射字典与 C 语言单遍扫描循环,可以在仅遍历一次文本的前提下同时完成成对置换、多字符转义与批量过滤,是处理大规模字符级替换的高性能方案。
一、str.translate() 核心机制与底层运作原理
str.translate() 的方法签名非常简练:text.translate(table)。它的核心逻辑并不直接接收字符字面量,而是依赖一个由整数码位(Unicode Code Point)构建的转换表(通常是字典)。
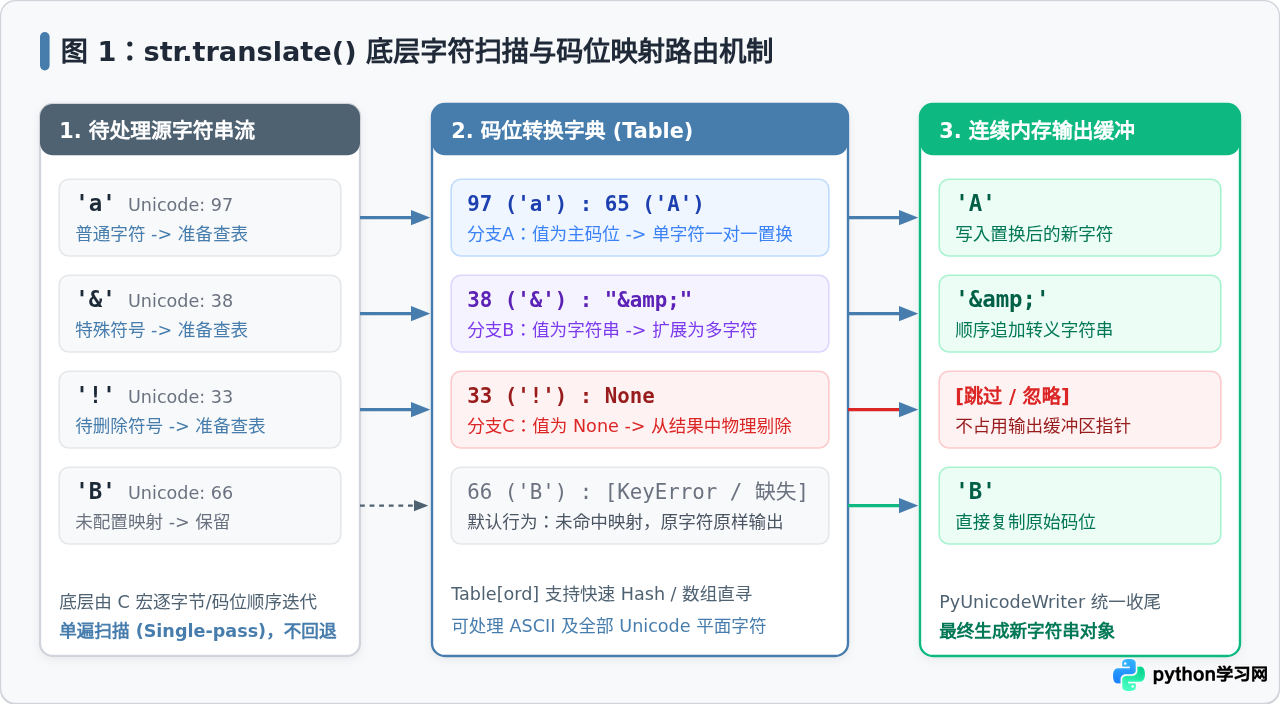
当 Python 调用 str.translate(table) 时,解释器底层在 C 模块(如 unicodeobject.c 中的 PyUnicode_Translate)内开启一个连续内存迭代循环。对于源字符串中的每一个字符,其处理流程如下:
- 获取码位:提取当前字符的 Unicode 整数码位(即
ord(char))。 - 查表分支:在传入的映射表
table中寻找该码位对应的映射值:- 未命中或键缺失:直接将原字符的原码位写入输出缓冲区,保留原样。
- 映射为另一个整数或单字符:将新码位写入输出缓冲区,完成 1:1 置换。
- 映射为长字符串:将该字符串的全部字符按顺序写入缓冲区,完成 1:N 扩展替换。
- 映射为
None:直接跳过当前字符,不向输出缓冲区写入任何内容,实现物理剔除。
- 产出字符串:扫描结束后,由内部缓冲区统一构建并返回全新的
str对象。
二、使用 str.maketrans() 构建映射表的三种方式
因为 translate() 要求映射字典的键必须为 Unicode 码位整数,手动使用 {ord('a'): 'b'} 书写不仅繁琐且容易遗漏。Python 提供了静态辅助方法 str.maketrans(),专门用于将人类可读的字符串规则编译为标准的码位映射表。
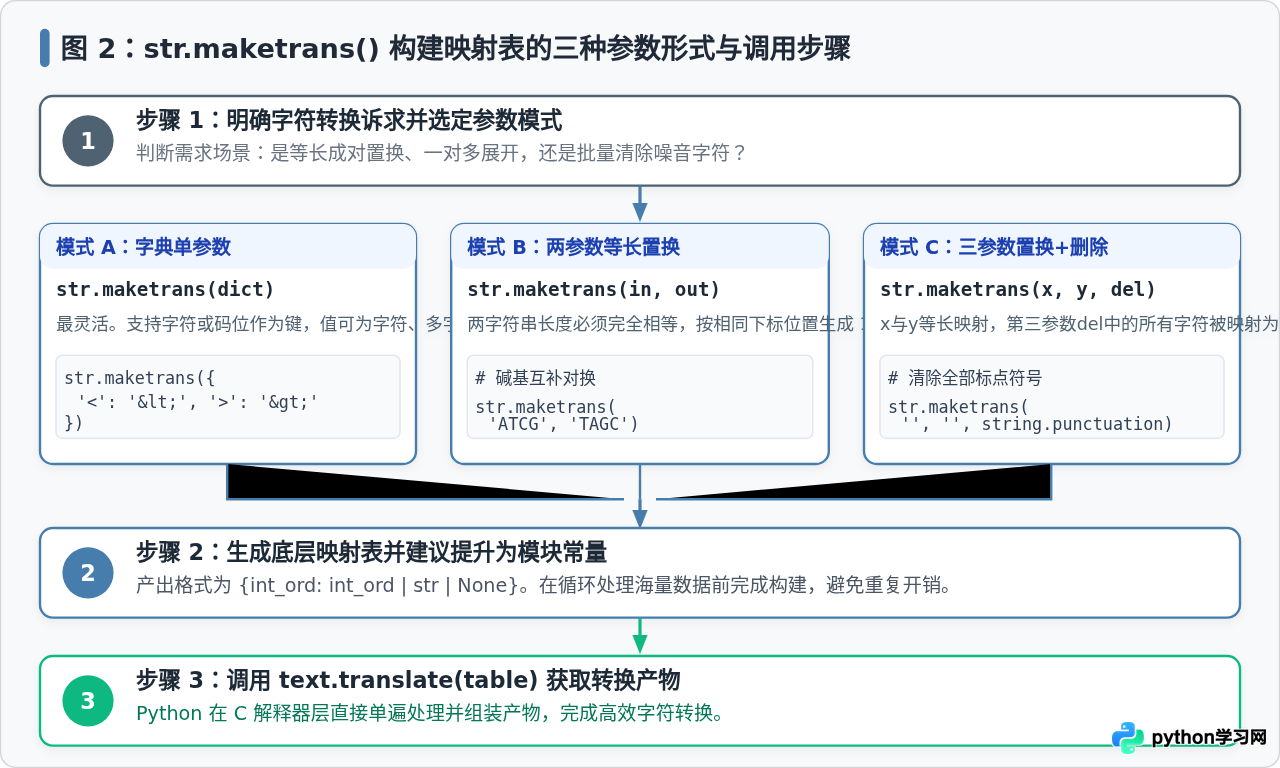
1. 单字典参数形式:str.maketrans(dict)
当需要同时处理字符置换、多字符展开和字符删除时,单字典形式是最灵活的选择。字典中的键可以是单字符字符串,也可以是整数码位;值可以是单字符、多字符字符串、整数码位或 None。str.maketrans() 会自动将键转换为整数码位。
# 示例:字符替换与多字符展开、删除混合定义
custom_map = {
'<': '<', # 单字符展开为多字符
'>': '>',
'&': '&',
'\r': None, # 删除回车符
'\n': ' ' # 换行符替换为空格
}
table = str.maketrans(custom_map)
# 产出转换表示例结构:{60: '<', 62: '>', 38: '&', 13: None, 10: ' '}
text = "<header>Hello&World\r\n</header>"
result = text.translate(table)
print("转换输出示例:", result)
# 示例输出: <header>Hello&World </header>2. 两字符串参数形式:str.maketrans(from_str, to_str)
当进行纯粹的一对一字符置换(例如大小写颠倒、凯撒加密、特殊数字转换)时,直接传入两个长度完全相等的字符串即可。from_str 中位置 i 的字符将被精确映射到 to_str 中位置 i 的字符。
# 示例:DNA 碱基序列互补转换(A<->T, C<->G)
table = str.maketrans("ATCG", "TAGC")

dna_sequence = "GATTACA_ATCG"
complement = dna_sequence.translate(table)
print("互补链输出示例:", complement)
# 示例输出: CTAATGT_TAGCfrom_str 和 to_str 的字符串长度必须完全相等。如果不一致,str.maketrans() 会立即抛出 ValueError: the first two maketrans arguments must have equal length。
3. 三字符串参数形式:str.maketrans(from_str, to_str, delete_str)
这是处理“置换 + 批量过滤”最经典的调用形式。前两个参数定义字符置换规则;第三个参数 delete_str 中的每一个字符,都会被自动映射为 None,在转换过程中直接剔除。如果不需要任何字符置换、仅需要批量剔除字符,前两个参数可以直接传空字符串 ""。
import string

# 需求:将元音字母替换为下划线,同时清除全部 ASCII 标点符号
table = str.maketrans("aeiouAEIOU", "__________", string.punctuation)

raw_data = "User_Name: Alice! Score: 98.5%; Status: OK."
cleaned = raw_data.translate(table)
print("清理输出示例:", cleaned)
# 示例输出: Us_rN_m_ _l_c_ Sc_r_ 985 St_t_s OK
三、高频实战场景与完整代码示例
掌握了 str.translate() 的基本机制后,我们来看四个在实际工程与数据分析中最常见的高效应用场景。
场景 1:极速清除文本中的所有标点符号与特殊空白
在自然语言处理分词或预处理阶段,清洗噪音字符是第一步。使用 string.punctuation 搭配第三参数,是最快且最干净的做法:
import string

def strip_punctuation(content: str) -> str:
    # 构造删除表:包含所有英文标点及指定中文标点
    del_chars = string.punctuation + ",。!?【】()《》“”‘’;:、"
    strip_table = str.maketrans("", "", del_chars)
    return content.translate(strip_table)

sample = "【公告】Python 3.12 已经发布!请各位开发者尽快更新体验,谢谢。"
print("剔除标点输出示例:", strip_punctuation(sample))
# 示例输出: 公告Python 312 已经发布请各位开发者尽快更新体验谢谢
场景 2:全角字符到半角字符的标准化归一化
在中文文本处理中,经常遇到全角数字、全角英文字母和全角空格与半角字符混用的情况。利用全角与半角字符在 Unicode 码位上的固定偏移量(通常差 65248,全角空格 12288 对应半角空格 32),可以一次性生成完整的归一化转换表:
def build_fullwidth_to_halfwidth_table():
    mapping = {}
    # 全角空格 12288 -> 半角空格 32
    mapping[12288] = 32
    # 全角字符(!到~)码位范围 65281 至 65374 对应半角 33 至 126
    for code in range(65281, 65375):
        mapping[code] = code - 65248
    return mapping

# 预先生成映射表并复用
F2H_TABLE = build_fullwidth_to_halfwidth_table()

raw_text = "订单编号:13900281,金额:¥299.00 (全角空格测试)"
normalized = raw_text.translate(F2H_TABLE)
print("半角归一化输出示例:", normalized)
# 示例输出: 订单编号:13900281,金额:¥299.00 (全角空格测试)
场景 3:HTML / XML 特殊字符转义与防注入编码
虽然标准库有 html.escape(),但如果是在特定高性能渲染模块中需要快速转义几个关键字符,str.translate() 依然是极具优势的原生手段:
HTML_ESCAPE_TABLE = str.maketrans({
"&": "&",
"<": "<",
">": ">",
'"': """,
"'": "'"
})
def fast_html_escape(html_chunk: str) -> str:
return html_chunk.translate(HTML_ESCAPE_TABLE)
payload = '<script>alert("XSS & injection");</script>'
print("转义后输出示例:", fast_html_escape(payload))
# 示例输出: <script>alert("XSS & injection");</script>四、性能对比与底层模型:为什么比连续 replace() 快数倍?
为了直观展示其性能差异,我们需要理解连续 str.replace() 与 str.translate() 在内存开销上的本质不同。
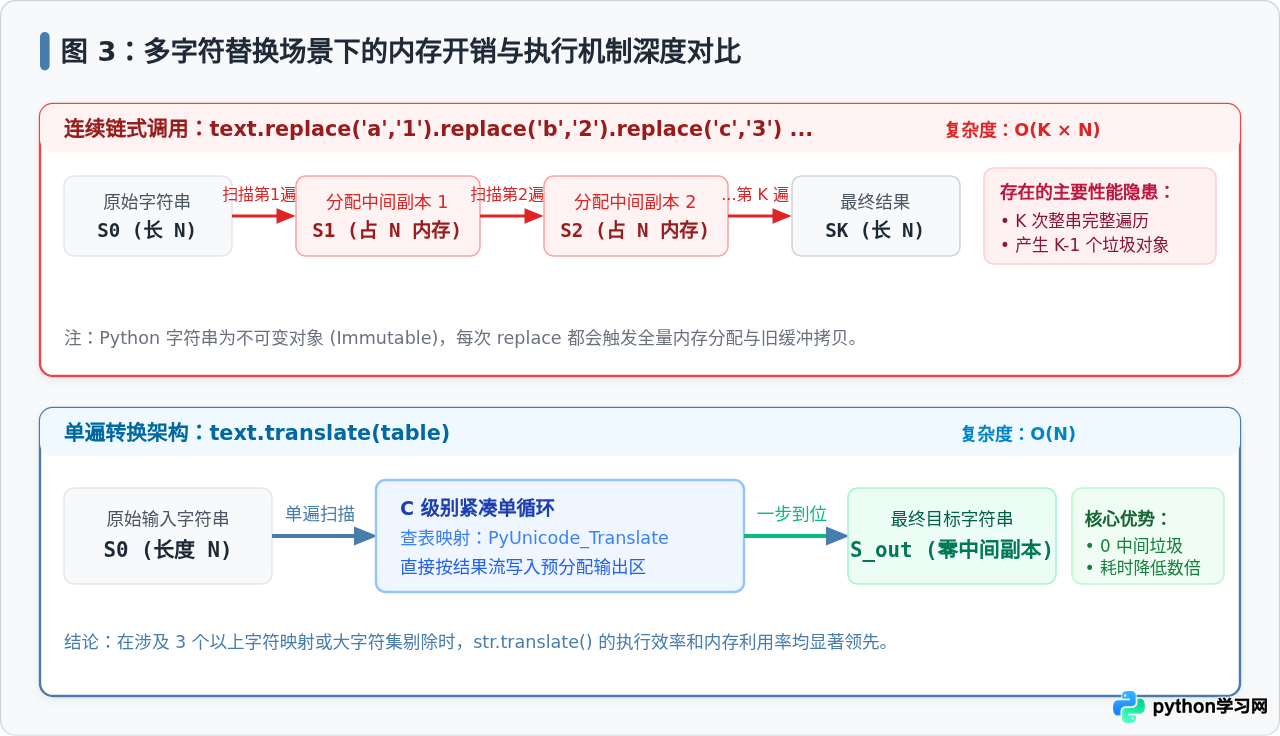
下表展示了三种常见字符替换技术的横向对比与技术特征:
| 方案 | 底层机制 | 时间复杂度 | 内存中间副本 | 最适用场景 |
|---|---|---|---|---|
str.translate() |
C 级单遍扫描 + 码位字典寻址 | O(N)(与规则数无关) | 0 个(直接产出目标串) | 多个单字符置换、批量清除字符集、符号转义 |
链式 str.replace() |
多次全串查找与内存重分 | O(K × N)(K为替换次数) | K - 1 个 中间废弃对象 | 仅替换 1~2 个特定子串(包括长单词) |
re.sub() |
正则有限状态机回溯与匹配 | O(N) ~ O(N²) | 视正则捕获组分配 | 复杂的上下文模式匹配、模糊提取与动态替换 |
在对一段包含 10 万字符的文本进行 10 种标点符号清洗时,链式 replace() 需要经历 10 次完整的遍历和 9 次中间字符串的分配与垃圾回收;而 translate() 从头到尾仅扫描一次,性能提升通常可达到 4 倍到 10 倍以上。
五、技术边界与常见避坑指南
虽然 str.translate() 效率极高,但在使用过程中有几个极其容易混淆的限制条件必须牢记:
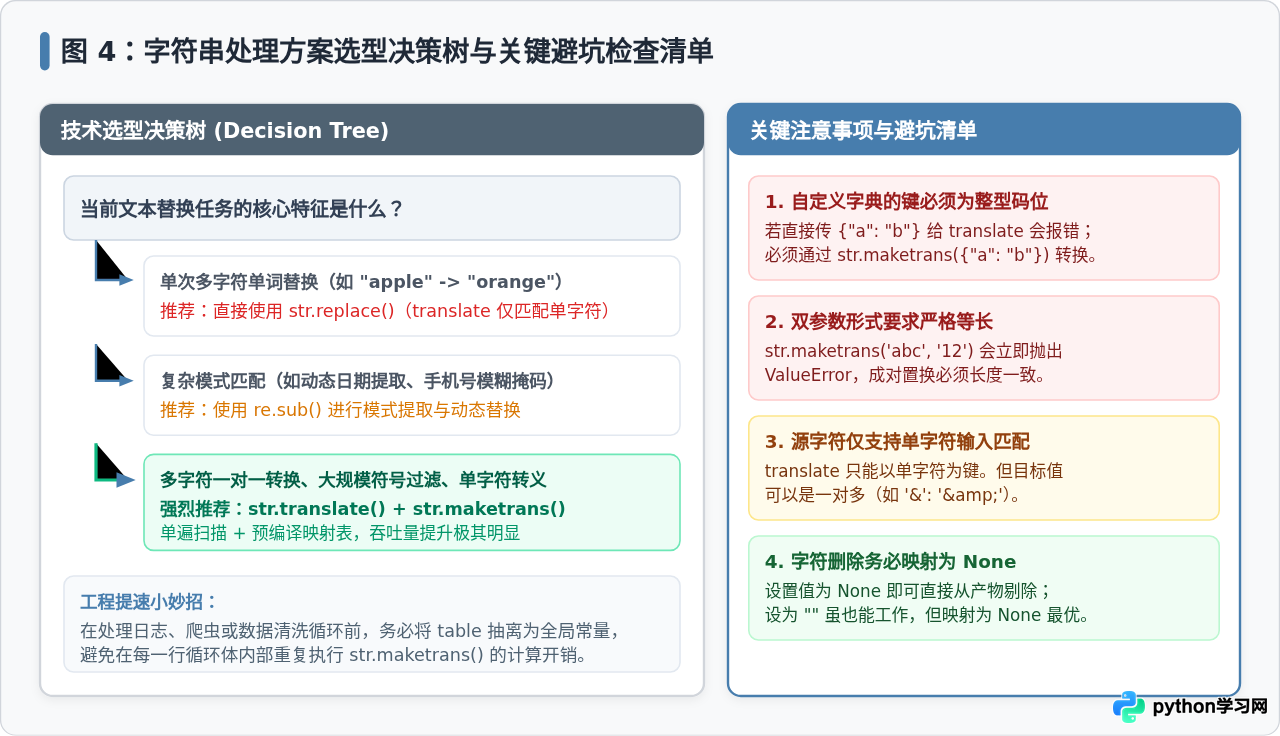
- 输入端仅支持单字符(Single Character):
translate()的输入匹配单元是单个字符的 Unicode 码位。如果你需要将整个词组"apple"替换为"orange",translate()无法做到。试图在str.maketrans()的键中传入多字符字符串会导致异常:# 错误用法示例: try: str.maketrans({"apple": "orange"}) except ValueError as err: print("错误提示示例:", err) # 报: ValueError: string keys in translate table must be of length 1 - 避免在热路径循环内重复执行
maketrans():
在遍历多行文本(如逐行读取数百万行日志)时,如果把table = str.maketrans(...)写在for line in file:循环体内部,就会在每行反复构造字典与码位映射。正确的做法是将table提升为模块级全局常量,只在外部构建一次,在循环体内部直接调用line.translate(table)。 - 必须使用整数码位,不能直接传入字符字典给 translate:
text.translate({'a': 'b'})会抛出TypeError或未定义行为,因为translate()期望键为整数。始终使用str.maketrans()或显式使用ord('a')。 - 剔除字符推荐显式指定为
None:
虽然将字符映射为空字符串""也能在最终结果中“看起来”删除了字符,但映射为None能够让 C 底层直接跳过缓冲区指针推进,逻辑更加明确,执行开销也更低。
总结
str.translate() 与 str.maketrans() 是 Python 文本处理工具箱中兼具简洁与极致性能的组合。当面对“多字符一对一转换”、“单字符展开转义”或“批量清除噪音符号”等需求时,优先选择预编译映射表与 str.translate() 单遍处理,既能保证代码逻辑清晰直观,又能显著释放 Python 解释器底层的文本处理吞吐潜能。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















