


Python写入文件时怎么控制换行符
深入讲解Python在写入文件时如何精准控制换行符。涵盖内置open函数的newline参数工作原理、write与print方法的区别、CSV模块多余空行问题成因与修复方案,以及二进制模式验证方法。
open() 函数的 newline 参数。默认情况下,Python 会在文本模式下自动将换行符
翻译为主机系统的默认换行符(Windows 下为
,Linux 和 macOS 下保持
)。通过显式设置 newline=''、newline='
' 或 newline='
',开发者可以完全脱离操作系统限制,精确决定文件中实际输出的物理换行字节。
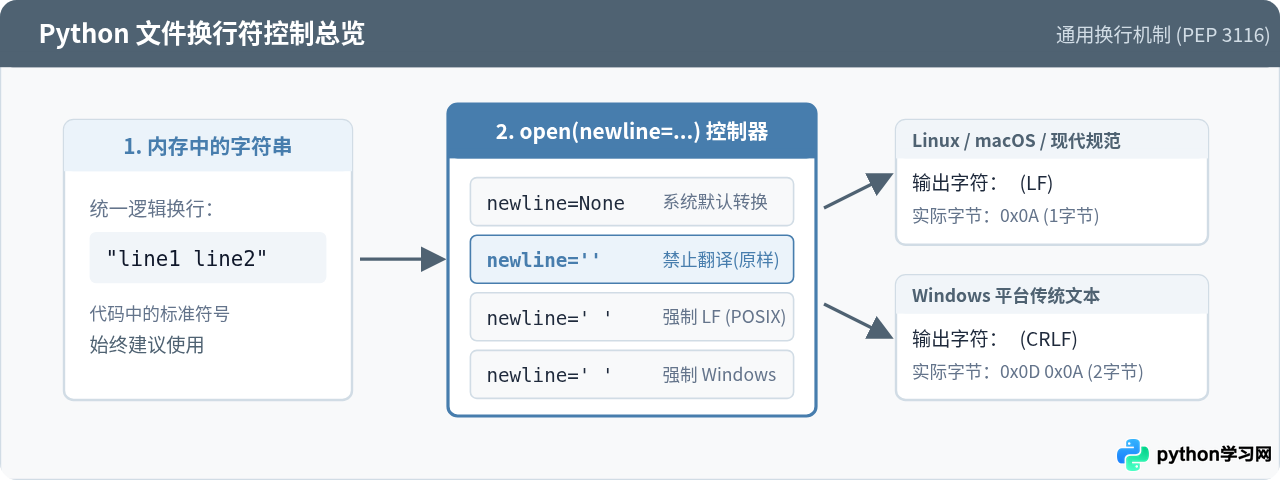
一、open 函数的 newline 参数与转换机制
在 Python 3 中,文本文件的读写默认启用“通用换行符”(Universal Newlines)机制。开发者在 Python 代码中通常约定使用
表示换行,但不同操作系统对于物理磁盘文件的换行标准并不统一:
- Linux / macOS:采用
LF(Line Feed,ASCII 码为0x0A,对应 Python 转义符 - Windows:采用
CRLF(Carriage Return + Line Feed,ASCII 码分别为0x0D 0x0A,对应 Python 转义符 - 早期 Mac OS(9及更早版本):采用
CR(Carriage Return,ASCII 码为0x0D,对应 Python 转义符
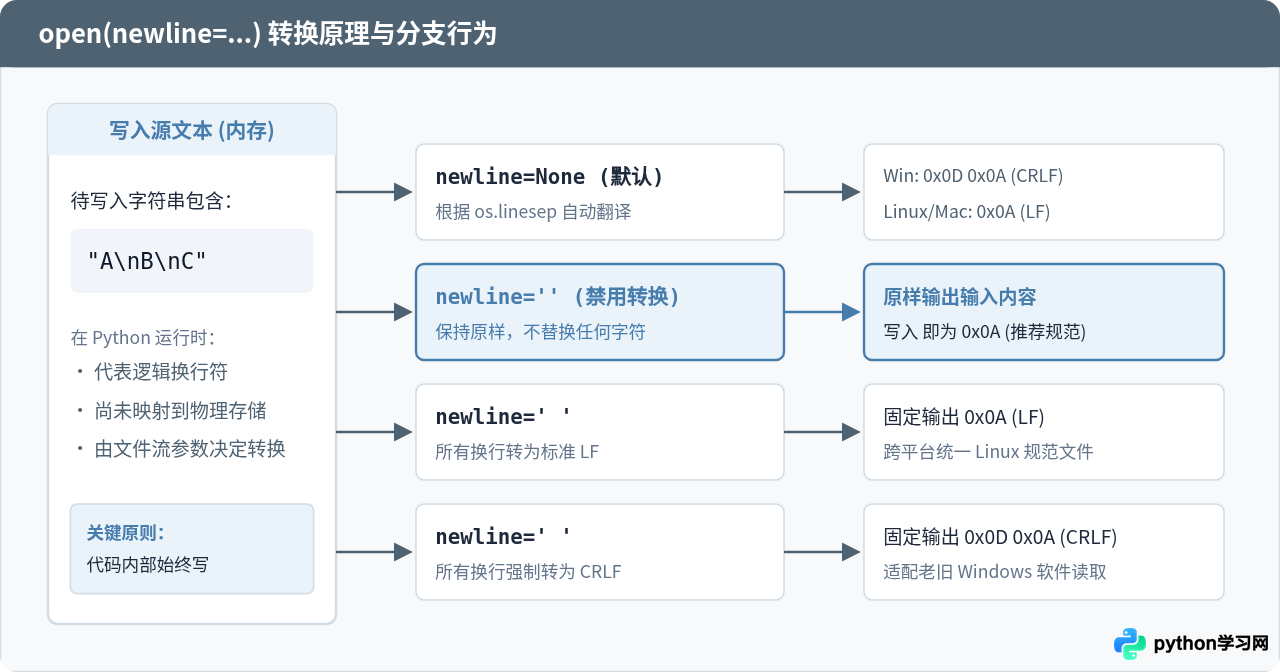
调用内置 open(file, mode='w', encoding='utf-8') 时,如果不显式指定 newline 参数,它的默认值为 None。当 newline=None 时,Python 会在写入时自动将文本中的所有
字符替换为操作系统的默认行分隔符(在 Windows 上是 os.linesep 即
,在 POSIX 系统上则是
)。
如果希望精确控制换行符,可以通过向 open() 传入以下四类有效值:
newline='':关闭换行符自动转换。写入内容包含什么换行符,就直接写入什么字符,不做任何篡改。newline=' ':强制将所有换行符转换为 Unix/Linux 规范的LF,无论程序运行在 Windows 还是 Linux 上。newline=' ':强制将换行符转换为 Windows 规范的CRLF。newline=' ':强制将换行符转换为旧式 Mac 规范的CR。
二、常用写入方式对换行符的处理差异
在 Python 文件操作中,除了 open() 的转换层,具体的写入函数在输入端也有各自不同的换行行为。常见的三种写入接口表现如下:
1. file.write() 方法
file.write(str) 是最底层的文本写入方法。它不会在字符串末尾附加任何额外的换行符。换行符必须由开发者显式写在字符串中:
with open('output_lf.txt', 'w', newline='
', encoding='utf-8') as f:
    f.write("第一行内容
")
    f.write("第二行内容
")
如果字符串末尾没有
,两次 write() 的内容将被连在同一行。
2. print(..., file=f) 函数
print() 函数拥有参数 end,其默认值为 '
'。因此,当使用 print("内容", file=f) 时,它会自动在末尾加上
。随后,这个
会交由 open() 的 newline 参数处理:
with open('output_print.txt', 'w', newline='
', encoding='utf-8') as f:
    # 默认自动追加
,并被 open 转换为 CRLF
    print("第一行内容", file=f)
    # 若不需要额外换行,可以手动显式设置 end=''
    print("第二行内容", end='', file=f)
3. file.writelines(lines) 方法
writelines() 接受一个由字符串组成的可迭代对象(如列表),并将它们依次写入文件。需要特别注意的是,该方法不会在元素之间自动插入换行符。列表中的每个字符串必须预先包含换行符:
lines = ["第一行
", "第二行
", "第三行
"]
with open('output_list.txt', 'w', newline='', encoding='utf-8') as f:
    f.writelines(lines)
三、操作步骤:如何按需输出指定换行符并进行二进制验证
为了确保生成的文件在跨平台或跨系统调用时格式完全一致,建议遵循一套标准的“配置-写入-校验”操作步骤:
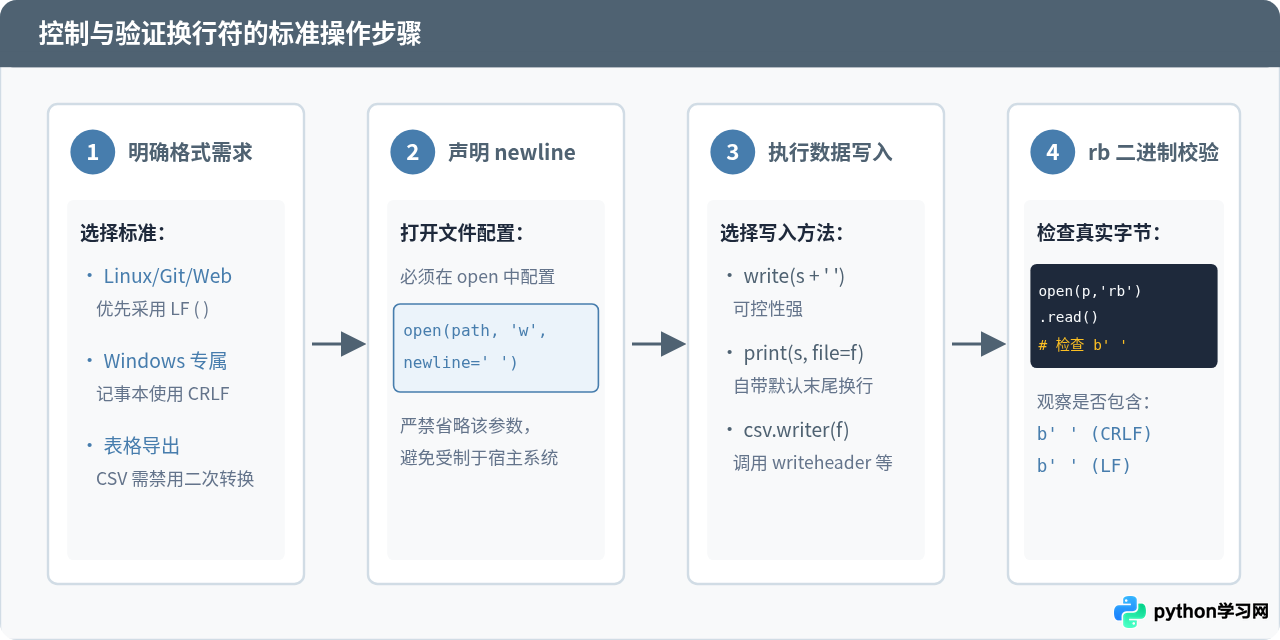
完整操作与校验代码示例
以下示例展示了如何在 Windows 或 Linux 机器上固定生成一个包含 Unix 规范换行符(LF)的文本文件,并通过二进制只读模式进行严格校验:
# 步骤 1 & 2:以明确的 LF 换行规则打开文件
target_file = "standard_unix.txt"
with open(target_file, "w", newline="
", encoding="utf-8") as f:
    # 步骤 3:写入带
 的内容
    f.write("Line A
")
    f.write("Line B
")

# 步骤 4:以二进制模式读取,绕过一切文本转译,验证真实字节
with open(target_file, "rb") as f:
    raw_bytes = f.read()

# 示例验证输出:
# raw_bytes 的结果应为:b'Line A
Line B
'
# 对应十六进制字节:4c 69 6e 65 20 41 0a 4c 69 6e 65 20 42 0a
print("读取到的原始字节:", raw_bytes)
assert b"
" not in raw_bytes, "文件中错误地包含了回车符 CR!"
print("验证通过:文件严格使用 LF 换行符。")
四、常见问题:CSV 模块在 Windows 下的多余空行故障排查
在所有与换行符相关的实际问题中,最常见的是使用标准库 csv 模块写入表格数据时,Windows 用户在 Excel 或记事本中打开文件会发现每行数据之间都凭空夹杂一行空白行。
故障成因分析
根据 RFC 4180 标准,CSV 记录的行终止符严格规定为 CRLF(即
)。因此,Python 的 csv.writer 在生成数据时,默认会在行尾输出
。此时如果开发者使用了默认的 open("data.csv", "w"):
- 在 Windows 操作系统上,
open()的默认newline=None会检测所有写入内容,并将其中的 csv.writer写入open()文本层拦截到末尾的- 最终落入磁盘的字节序列变成了
- 软件读取时,前面的
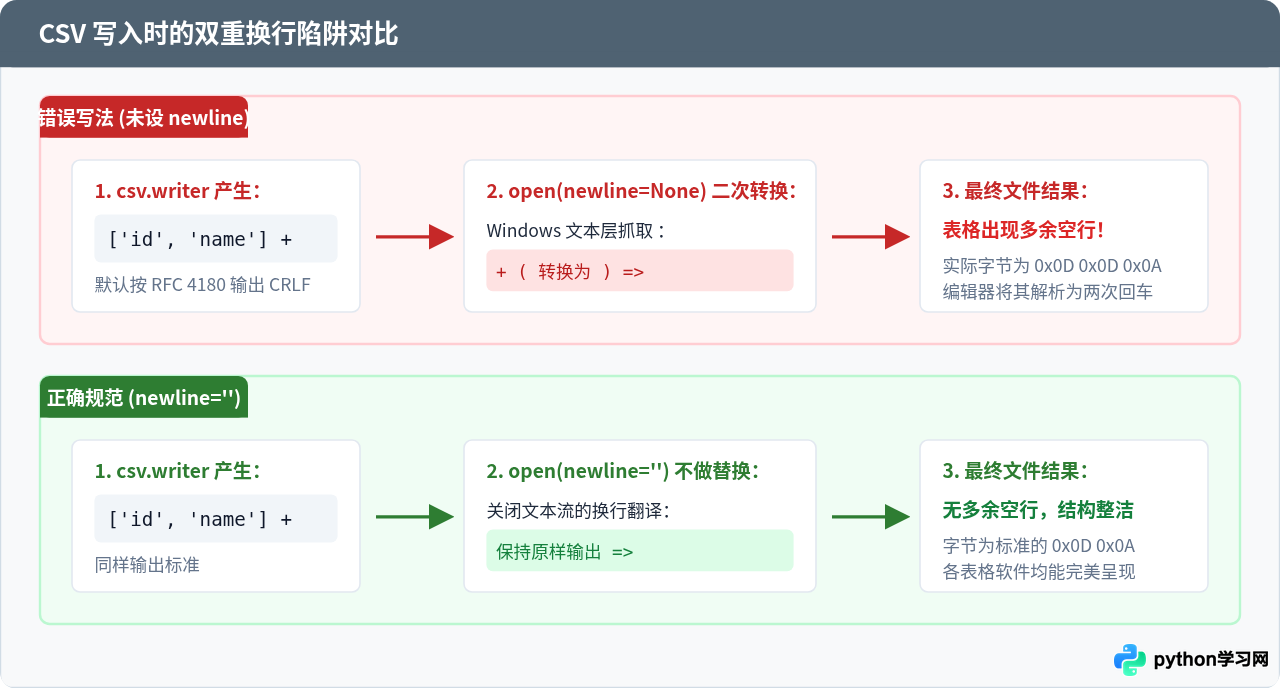
正确写入 CSV 的标准范式
官方文档明确要求,在 Python 3 中使用 csv.writer 或 csv.DictWriter 时,必须为 open() 传入 newline='' 参数:
import csv

data = [
    ["id", "name", "role"],
    ["101", "Alice", "Developer"],
    ["102", "Bob", "Designer"]
]

# 核心:必须显式传入 newline='',同时声明 encoding='utf-8'
with open("users.csv", "w", newline="", encoding="utf-8") as f:
    writer = csv.writer(f)
    writer.writerows(data)
五、二进制模式写入:完全接管字节控制
在网络通信协议、二进制数据包拼装或对十六进制字节有着严格要求的特定场景中,文本模式的任何自动转译都会破坏数据结构。此时应当使用二进制模式 'wb'。
在二进制模式下:
open()函数不支持传入encoding和newline参数(如果传入会抛出ValueError)。- 必须写入
bytes或bytearray对象。 - 开发者直接决定每一个字节的值,换行符完全以字面量字节
b' '或b' '体现。
# 严格的二进制写入场景
with open("protocol_packet.bin", "wb") as f:
    # 明确写入 CRLF 作为协议报文行结束符
    f.write(b"COMMAND_OK
")
    # 写入单个 LF
    f.write(b"PAYLOAD_START
")
六、总结与决策选型
为了在不同项目需求下快速选择正确的配置,可以参考以下场景决策图与对比清单:
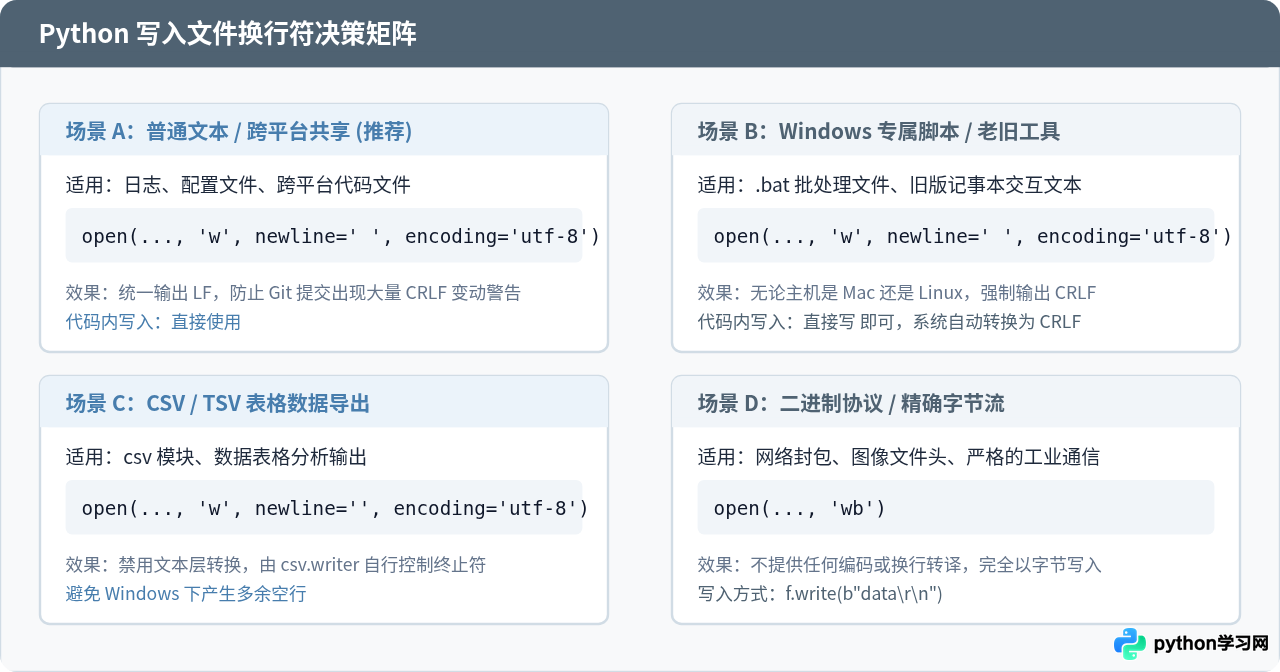
| 业务目标 | 推荐 open() 模式与参数 | 代码内换行写法 | 底层落盘物理字节 |
|---|---|---|---|
| 标准现代文本(推荐规范) | mode='w', newline='
', encoding='utf-8' |
|
0x0A (LF) |
| Windows 专用兼容文本 | mode='w', newline='
', encoding='utf-8' |
(自动转换) |
0x0D 0x0A (CRLF) |
| 导出 CSV 表格 | mode='w', newline='', encoding='utf-8' |
csv.writer.writerow() |
0x0D 0x0A (RFC 4180) |
| 严格保留原样字符 | mode='w', newline='', encoding='utf-8' |
直接写入目标字符 | 与内存字符串完全相同 |
| 二进制与网络报文 | mode='wb'(不传 newline 与 encoding) |
b'...
' |
精准按传入字节写入 |
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















